学习路径
Python 数据基础
28 小时
您可能一辈子都在用 print() 语句调试。也许您尝试过一两次 Python 的 logging 模块,但又因为 print 更简单而回去了。
其实有个更好的方案,同样好用。
Print 语句既不易保存到文件,也不易随时启停。Python 内置 logging 能做到这些,但往往需要比您程序本身还长的初始化代码。
Loguru 的思路不同:日志应该和打印一样简单,但更有用。您可以在终端看到彩色输出、自动时间戳,并且无需写任何配置就能把一切保存到文件。
在本教程中,我会用实用示例让日志记录变得自然而不费力。您会看到一些也许从未留意过的功能,以及真正能让调试更轻松的代码范式。
如果您是 Python 调试新手,或想夯实基础技能, 夯实 Python 基础 将帮助您理解何时以及为何需要日志。
安装 Loguru 只需一条命令:
pip install loguru使用常规的 logging 模块,您需要在看到第一条日志前就设置处理器、格式器,并完成各种配置。
想更深入比较 Python 内置日志方法,请查看这篇 全面日志教程,覆盖了传统方法。
使用 Loguru,您只需导入即可开始记录:
from loguru import logger

# Instead of print("Processing user data...")
logger.info("Processing user data...")

# Instead of print(f"Found {count} records")
logger.info("Found {} records", count)
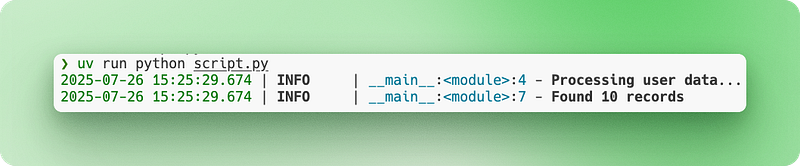
输出会自动带上颜色、时间戳和日志级别,并显示在终端。无需任何配置。
假设您在构建一个简单的网页爬虫。调试方式会这样改变:
import requests
from loguru import logger

def scrape_website(url):
   logger.info("Starting scrape for {}", url)

   response = requests.get(url)
   logger.debug("Response status: {}", response.status_code)

   if response.status_code == 200:
       logger.success("Successfully scraped {} characters", len(response.text))
       return response.text
   else:
       logger.error("Failed to scrape {}: status {}", url, response.status_code)
return None注意不同的日志级别(info、debug、success、error)以及大括号风格的格式化。不需要配置文件或初始化代码,一切即刻生效。
当您用控制台输出调试时,关闭终端的瞬间就丢失了所有记录。您无法检索一小时前发生了什么;如果脚本在夜里崩溃,也没有任何线索可查。向同事求助时也很难共享调试输出。
文件日志通过永久保存一切来解决这个问题。
传统日志需要您写配置代码来设置文件处理器。您要指定路径、创建目录、处理权限。用 Loguru,添加文件日志真的只需一行:
from loguru import logger

# Add file logging alongside console output
logger.add("app.log")

logger.info("This appears in both console and file")
logger.error("So does this error message")
现在所有内容都会保存到 app.log,同时仍会显示在终端。
但日志文件会随着时间暴涨。一个运行数天的 Web 应用可能产生数 GB 日志,最终填满磁盘。文件轮转可以在满足条件时自动创建新日志文件。旧文件会用时间戳重命名,并开始一个全新的文件:
# When app.log reaches 10 MB, it becomes app_2024-07-15_14-30-25.log
# and a new empty app.log starts
logger.add("app.log", rotation="10 MB")

# Or start a new file every day at midnight
logger.add("app.log", rotation="00:00")
默认的时间戳可用,但有时是 UTC 或不易读。Loguru 允许您自定义日期时间格式以满足需要:
# Custom timestamp format that's easier to read
logger.add("app.log",
         format="{time:YYYY-MM-DD HH:mm:ss} | {level} | {message}",
         rotation="1 day")
在生产系统中,您需要更好地管理旧文件。生产日志需要遵循 Python 最佳实践,确保日志可维护且安全。若不加管理,日志会堆积并耗尽存储:
# Keep only the last 10 rotated files, compress the rest
logger.add("production.log",
         rotation="50 MB",     # New file every 50MB
         retention=10,         # Keep only 10 old files
         compression="zip")    # Compress rotated files
让我们看一个更贴近现实的场景。您在构建一个数据管道,每晚处理多个 CSV 文件,在将其加载到数据库前先清洗和校验客户数据。您需要跟踪哪些文件成功处理,并捕捉任何数据质量问题:
import pandas as pd
from loguru import logger

# Production-ready file logging setup
logger.add("data_processing_{time:YYYY-MM-DD}.log",
         rotation="00:00",        # New file daily
         retention="1 week",      # Keep 1 week of logs
         format="{time:YYYY-MM-DD HH:mm:ss} | {level} | {message}")

def process_csv_files(file_list):
   logger.info("Starting batch processing of {} files", len(file_list))

   for filename in file_list:
       try:
           df = pd.read_csv(filename)
           logger.info("Loaded {} with {} rows", filename, len(df))

           # Your processing logic here
           processed_df = df.dropna()

           logger.success("Processed {} - kept {} rows", filename, len(processed_df))

       except Exception as e:
           logger.error("Failed to process {}: {}", filename, str(e))

   logger.info("Batch processing complete")
您的日志会带有可读的时间戳,文件自动轮转,旧日志自动清理。几天后您仍可回溯发生了什么,或在排障时把日志发给同事。
当您运行一个 Web 应用时,日志很快会变成信息大杂烩。用户行为、数据库查询、API 调用和错误混成一片。您很难按具体用户过滤、跟踪单个请求,或让监控系统自动解析日志。
数据驱动应用尤其受益于结构化日志。如果您在做数据管道或分析,发展数据分析师技能 有助于您明确日志应捕捉哪些信息。
传统的字符串日志会让情况更糟。每条日志都是纯文本,想提取有意义的数据就要写复杂的正则或手动搜索。
结构化日志把日志条目视为数据对象,而不仅是文本。每条日志都成为带可搜索字段的结构化记录,更易于以编程方式查询和分析。
Loguru 通过 serialize=True 让结构化日志变得简单:
from loguru import logger

# Enable JSON structured logging
logger.add("api.log", serialize=True)

logger.info("User login", user_id=123, ip_address="192.168.1.1")
logger.error("Payment failed", user_id=123, amount=99.99, error_code="INSUFFICIENT_FUNDS")
serialize=True 参数告诉 Loguru 输出 JSON 而非纯文本。您的日志文件不再是可读句子,而是结构化数据:
{"text": "User login", "record": {"time": "2024-07-15T14:30:25", "level": {"name": "INFO"}, "extra": {"user_id": 123, "ip_address": "192.168.1.1"}}}这种格式非常适合能自动搜索和过滤 JSON 数据的日志分析工具。
但 Web 应用需要的不止是结构化数据。您需要能把相关日志串起来的上下文。在处理用户请求时,您希望所有相关日志共享用户 ID 或会话 ID 等公共信息。
上下文绑定通过使用 logger.bind() 将持久信息附加到记录器上来实现:
from loguru import logger

def process_user_order(user_id, order_data):
   # Create a logger with attached context
   order_logger = logger.bind(user_id=user_id, order_id=order_data['id'])

   order_logger.info("Starting order processing")
   order_logger.debug("Validating payment method", method=order_data['payment'])
   order_logger.info("Order processing complete", total=order_data['total'])
现在来自 order_logger 的每条日志都会自动包含 user_id 和 order_id,便于追踪与特定订单相关的所有日志。
现代应用往往需要为不同目的输出到不同地方。开发时您或许需要可读的控制台日志,而生产环境则需要 JSON 日志用于监控。在 Loguru 中,每个输出目的地称为“sink”——可以把它理解为日志流入的地方。
Loguru 允许您添加多个具有不同格式和规则的 sink:
from loguru import logger
import sys

# Remove the default console output
logger.remove()

# Sink 1: Human-readable console for development
logger.add(sys.stdout,
         level="DEBUG",
         format="<green>{time:HH:mm:ss}</green> | {level} | {message}")

# Sink 2: JSON file for production monitoring
logger.add("app.log",
         serialize=True,
         level="INFO")

# Sink 3: Error-only file for alerts
logger.add("errors.log",
         level="ERROR")
logger.remove() 会移除 Loguru 的默认控制台输出,以便您自定义。每次调用 logger.add() 都会创建一个具有自身记录规则和格式的新 sink。
现在,相同的日志语句会产出不同输出:
logger.debug("Processing started")      # Only appears in console
logger.info("User data loaded")         # Appears in console and app.log
logger.error("Database connection failed") # Appears in all three places我们用一个更简单、也更贴近实际的 Loguru 用例——基础的用户注册系统:
from loguru import logger
import sys

# Set up multiple outputs
logger.remove()
logger.add(sys.stdout, level="INFO", format="{time:HH:mm:ss} | {message}")
logger.add("user_registration.log", serialize=True, level="INFO")
logger.add("errors.log", level="ERROR")

def register_user(email, password):
   # Create logger with user context
   user_logger = logger.bind(email=email)

   user_logger.info("Starting user registration")

   # Validate email
   if "@" not in email:
       user_logger.error("Invalid email format")
       return False

   # Check if user exists
   user_logger.debug("Checking if user already exists")

   # Simulate password hashing
   user_logger.debug("Hashing password")

   # Save to database
   user_logger.info("Saving user to database")
   user_logger.success("User registration completed")

   return True

# Usage
register_user("john@example.com", "secure123")
该设置在开发时提供易读的控制台输出、用于自动化监控的结构化 JSON 日志,以及用于告警的单独错误日志。bind() 方法确保每次用户注册的日志都包含邮箱地址,让调试更轻松。
当代码崩溃时,您通常会得到一个基本的堆栈跟踪,告诉您错误发生的位置,却很少告诉您为何出错。您拿不到崩溃时变量的值,因而难以理解问题所在。传统的异常处理还要求您用 try-catch 包裹各处,并手动记录每个异常。
在生产问题调试时这尤其痛苦。用户报告了错误,但您无法复现,因为没有发生错误时的上下文。
Loguru 通过自动捕获异常并提供增强型回溯,准确展示出错当下代码的状态,从而解决这一问题。
@logger.catch 装饰器会自动捕获函数内发生的任何异常,并带完整上下文记录日志。像 @logger.catch 这样的装饰器是 Python 进阶概念,能改变您在代码库中处理错误的方式:
from loguru import logger

@logger.catch
def divide_numbers(a, b):
   result = a / b
   return result

# This automatically logs the exception with full traceback
result = divide_numbers(10, 0)
相比程序以基础错误消息直接崩溃,Loguru 会捕获异常并记录详细信息,同时程序可继续运行。该装饰器适用于任何函数——类方法、异步函数或普通函数。
Loguru 还能提供带变量值的增强回溯,展示调用栈每一层的变量值。该特性称为“diagnose”,就像把调试器内置进了日志:
from loguru import logger

# Enable enhanced tracebacks
logger.add("debug.log", diagnose=True)

@logger.catch
def process_user_data(users):
   for user in users:
       age = user['age']
       if age > 0:
           years_to_retirement = 65 - age
           print(f"User {user['name']} has {years_to_retirement} years to retirement")

# When this crashes, you'll see the exact values of 'users', 'user', and 'age'
users_data = [
   {"name": "Alice", "age": 30},
   {"name": "Bob", "age": "invalid"},  # This will cause an error
]

process_user_data(users_data)
使用 diagnose=True 时,当函数因尝试用字符串参与减法而崩溃,Loguru 会准确展示每个变量的内容:
TypeError: unsupported operand type(s) for -: 'int' and 'str'

Variables values:
   users = [{"name": "Alice", "age": 30}, {"name": "Bob", "age": "invalid"}]
   user = {"name": "Bob", "age": "invalid"}
   age = "invalid"
这种细节让调试快得多,因为您能一眼看到到底是哪份数据引发了问题。
不过,增强回溯可能会在生产日志中暴露密码或 API 密钥等敏感信息。Loguru 允许您根据环境控制这一行为:
from loguru import logger
import os

# Development: Full diagnostic information
if os.getenv("ENVIRONMENT") == "development":
   logger.add("app.log", diagnose=True, level="DEBUG")
else:
   # Production: Basic logging without variable inspection
   logger.add("app.log", diagnose=False, level="INFO")

@logger.catch
def authenticate_user(username, password, api_key):
   # In development, you'll see all variable values if this crashes
   # In production, sensitive data stays hidden
   if not username or not password:
raise ValueError("Missing credentials")另一个强大功能是延迟求值,可在记录代价较高的操作时提升性能。有时您只想在确实发生错误时才记录复杂信息:
from loguru import logger

@logger.catch
def process_large_dataset(data):
   try:
       # Some complex processing that might fail
       result = complex_calculation(data)
       return result
   except Exception as e:
       # This expensive operation only runs if there's an error
       logger.error("Processing failed with data: {data}",
                   data=lambda: expensive_data_summary(data))
       raise

def expensive_data_summary(data):
   # This function takes time to run, summarizing huge datasets
   return {"row_count": len(data), "columns": list(data.keys()), "memory_usage": data.memory_usage()}
lambda: 语法创建了一个仅在 Loguru 实际写入该日志消息时才会调用的函数。若没有错误发生,expensive_data_summary() 不会运行,从而节省处理时间。
您也可以针对不同类型的错误使用不同的异常处理策略:
from loguru import logger

# Configure multiple outputs for different error severities
logger.add("warnings.log", level="WARNING", filter=lambda record: record["level"].name == "WARNING")
logger.add("critical_errors.log", level="ERROR")

@logger.catch(level="ERROR")
def critical_database_operation(query):
   # Database errors get logged as ERROR level
   execute_database_query(query)

@logger.catch(level="WARNING", reraise=False)
def optional_feature(user_id):
   # Non-critical features log as WARNING and continue execution
   send_optional_notification(user_id)

def process_user_request(user_id, query):
   # Critical operation - if this fails, the whole request fails
   critical_database_operation(query)

   # Optional operation - if this fails, request continues
   optional_feature(user_id)
reraise=False 参数告诉 Loguru 记录异常但不再次抛出,从而让程序继续执行。这对不应破坏主流程的可选功能很有用。
下面是一个完整示例:文件处理系统能优雅地处理不同类型的错误:
from loguru import logger
import os

# Set up environment-aware logging
if os.getenv("DEBUG"):
   logger.add("file_processor.log", diagnose=True, level="DEBUG")
else:
   logger.add("file_processor.log", diagnose=False, level="INFO")

@logger.catch(reraise=False)
def validate_file_format(filename):
   if not filename.endswith(('.csv', '.json', '.xml')):
       raise ValueError(f"Unsupported file format: {filename}")

@logger.catch
def load_file_data(filename):
   logger.info("Loading file: {}", filename)

   # Expensive operation only logged on errors
   logger.debug("File stats: {stats}",
               stats=lambda: {"size": os.path.getsize(filename),
                             "modified": os.path.getmtime(filename)})

   with open(filename, 'r') as f:
       return f.read()

def process_files(file_list):
   results = []

   for filename in file_list:
       # Validation errors are logged but don't stop processing
       validate_file_format(filename)

       try:
           # Loading errors are logged and do stop processing this file
           data = load_file_data(filename)
           results.append(data)
           logger.success("Successfully processed {}", filename)
       except Exception:
           logger.error("Skipping file {} due to loading error", filename)
           continue

   return results
这套配置提供自动异常捕获、在需要时的详细错误上下文,以及针对不同错误类型的不同处理策略。您的日志会在调试中更有价值,同时代码仍然干净易读。
随着应用发展,您会遇到 Loguru 默认行为不完全适配的场景。也许您需要一个用于业务指标的特殊日志级别,想从日志中过滤敏感数据,或在发生错误时把告警发到 Slack。
好消息是,Loguru 天生易于自定义且不失简洁。您可以以传统日志系统需要复杂配置的方式来扩展它,同时保持代码干净可读。
下面看看最有用的自定义方式,解决您在生产应用中会遇到的实际问题。
Loguru 内置了 INFO、DEBUG、ERROR 等标准级别。但有时您需要更贴合应用的级别。比如为性能指标或业务事件设置一个专用级别。
创建自定义日志级别非常直接:
from loguru import logger

# Add a custom level for business metrics
logger.level("METRIC", no=38, color="<yellow>", icon="📊")

# Add a custom level for security events
logger.level("SECURITY", no=45, color="<red><bold>", icon="🔒")

# Now you can use these levels
logger.log("METRIC", "Order completed in {} seconds", 2.5)
logger.log("SECURITY", "Failed login attempt from IP: {}", "192.168.1.100")
no 参数设置级别优先级(数值越大优先级越高)。标准级别为:DEBUG=10、INFO=20、WARNING=30、ERROR=40、CRITICAL=50。
我们在一个机器学习训练场景中看看它的用法:
from loguru import logger

# Set up custom levels for ML tracking
logger.level("EPOCH", no=35, color="<cyan><bold>")
logger.level("CHECKPOINT", no=38, color="<green><bold>")

# Configure output
logger.remove()
logger.add("training_{time:YYYY-MM-DD}.log", level="INFO")

def train_model(model, data_loader, epochs=10):
   logger.info("Starting training with {} epochs", epochs)

   for epoch in range(epochs):
       # Log epoch progress with custom level
       logger.log("EPOCH", "Epoch {}/{} started", epoch + 1, epochs)

       # Training logic here
       loss = 0.523 - (epoch * 0.05)  # Simulated improving loss
       accuracy = 0.72 + (epoch * 0.03)  # Simulated improving accuracy

       logger.info("Loss: {:.4f}, Accuracy: {:.2%}", loss, accuracy)

       # Save checkpoint every 5 epochs
       if (epoch + 1) % 5 == 0:
           logger.log("CHECKPOINT", "Model saved at epoch {}", epoch + 1)

logger.success("Training completed!")有时您需要在写入前修改日志消息。常见场景包括移除敏感数据、添加请求 ID,或为特定工具重格式化消息。
Loguru 允许通过 filter 参数拦截消息:
from loguru import logger
import re

def hide_sensitive_data(record):
   # Hide credit card numbers
   record["message"] = re.sub(r'\b\d{4}[\s-]?\d{4}[\s-]?\d{4}[\s-]?\d{4}\b',
                             'XXXX-XXXX-XXXX-XXXX',
                             record["message"])

   # Hide email addresses
   record["message"] = re.sub(r'\b[\w.-]+@[\w.-]+\.\w+\b',
                             '***@***.***',
                             record["message"])

   # Continue processing the log
   return True

# Add the filter to your logger
logger.add("secure.log", filter=hide_sensitive_data)

# Test it
logger.info("User paid with card 4532-1234-5678-9012")
logger.info("Contact email: john.doe@example.com")
您还可以用过滤器添加上下文信息:
from loguru import logger
import threading

def add_thread_info(record):
   # Add thread name to every log message
   record["extra"]["thread_name"] = threading.current_thread().name
   return True

def add_environment_info(record):
   # Add environment to production logs
   record["extra"]["env"] = "production"
   record["extra"]["region"] = "us-west-2"
   return True

# Apply multiple filters
logger.add(
   "app.log",
   filter=lambda record: add_thread_info(record) and add_environment_info(record),
   format="{time} | {extra[env]} | {extra[thread_name]} | {message}"
)sink 是日志流向的目的地。除了文件和控制台,您经常需要把日志发送到 Slack、邮件或监控系统等外部服务。
下面创建一个把错误发送到 Slack 的自定义 sink:
from loguru import logger
import requests

def send_to_slack(message):
   """Custom sink that sends messages to Slack"""
   # Parse the log record
   record = message.record

   # Only send errors and above
   if record["level"].no < 40:  # ERROR level is 40
       return

   # Format message for Slack
   slack_message = {
       "text": f"🚨 {record['level'].name}: {record['message']}",
       "attachments": [{
           "color": "danger",
           "fields": [
               {"title": "Time", "value": str(record["time"]), "short": True},
               {"title": "Function", "value": record["function"], "short": True},
               {"title": "File", "value": f"{record['file'].name}:{record['line']}", "short": False}
           ]
       }]
   }

   # Send to Slack webhook
   webhook_url = "https://hooks.slack.com/services/YOUR/WEBHOOK/URL"
   requests.post(webhook_url, json=slack_message)

# Add the custom sink
logger.add(send_to_slack, level="ERROR")

# Test it
logger.error("Database connection lost!")
再看一个实用示例——自定义 sink 在应用运行期间收集性能指标并保存用于分析:
from loguru import logger
from collections import defaultdict
import json

class MetricsCollector:
   def __init__(self):
       self.metrics = defaultdict(list)

   def __call__(self, message):
       """This method is called for every log message"""
       record = message.record

       # Only process METRIC level logs
       if record["level"].name != "METRIC":
           return

       # Extract metric data from the 'extra' fields
       extra = record["extra"]
       if "metric_name" in extra and "value" in extra:
           self.metrics[extra["metric_name"]].append({
               "value": extra["value"],
               "timestamp": record["time"].timestamp()
           })

   def save_metrics(self):
       """Save all collected metrics to a JSON file"""
       with open("metrics.json", "w") as f:
           json.dump(dict(self.metrics), f, indent=2)

# Create the collector and add it as a sink
collector = MetricsCollector()
logger.add(collector)

# Create the METRIC level
logger.level("METRIC", no=38)

# Now when you log metrics, they're automatically collected
# The bind() method attaches extra data to the log entry
logger.bind(metric_name="response_time", value=0.234).log("METRIC", "API response")
logger.bind(metric_name="response_time", value=0.189).log("METRIC", "API response")
logger.bind(metric_name="active_users", value=1523).log("METRIC", "User count")

# Later, save all metrics to file
collector.save_metrics()

# The metrics.json file will contain:
# {
#   "response_time": [
#     {"value": 0.234, "timestamp": 1627...},
#     {"value": 0.189, "timestamp": 1627...}
#   ],
#   "active_users": [
#     {"value": 1523, "timestamp": 1627...}
#   ]
# }
这种方式的好处是应用代码保持干净——您只需正常记录指标,收集器 sink 会自动处理存储。您也可以轻松替换为将指标发送到 Prometheus、DataDog 或其他监控服务的 sink。
这些自定义让您在保持 Loguru 简单性的同时,灵活适配特定需求。无论是小脚本还是大型应用,您都能在不需要复杂配置文件或样板代码的前提下扩展 Loguru 以满足独特的日志需求。
Loguru 让 Python 日志变得理应如此的简单。不再需要配置文件、不再需要处理器设置、不再需要样板代码。只需导入即可开始记录,享受颜色、时间戳和自动文件轮转。
您已经看到它如何解决常见痛点:将日志保存到文件、自动轮转、带完整上下文捕获异常、以及把日志发送到外部服务。结构化日志让它具备生产可用性,而自定义级别与 sink 则让它适用于任何用例。
在以下场景使用 Loguru:
想要更深入学习,请结合查阅 官方文档 与这篇 日志教程,全面了解 Python 的日志策略。
从小处开始。把一个 print 语句替换为 logger.info()。您将一去不复返。
Top DataCamp Courses
学习路径
学习路径
课程