
Last chance! 50% off DataCamp Premium
Sale ends in
Je debugt al je hele programmeerleven met print()-statements. Misschien heb je Python's loggingmodule eens geprobeerd, maar ben je teruggegaan naar prints omdat die simpeler zijn.
Er is eigenlijk iets beters dat net zo makkelijk is in gebruik.
Printstatements kun je niet eenvoudig in bestanden opslaan of aan- en uitzetten. Python’s ingebouwde logging kan dat wel, maar vereist opzetcode die langer is dan je daadwerkelijke programma.
Loguru pakt het anders aan: loggen moet net zo makkelijk zijn als printen, maar dan veel nuttiger. Je krijgt kleuren in je terminal, automatische tijdstempels en de mogelijkheid om alles in bestanden op te slaan zonder ook maar één configuratieregel te schrijven.
In deze tutorial laat ik je praktische voorbeelden zien die loggen natuurlijk laten aanvoelen in plaats van belastend. Je ziet features die je waarschijnlijk nog niet kende, met codepatronen die het debuggen écht makkelijker maken.
Als je nieuw bent met debuggen in Python of je basisvaardigheden wilt versterken, een solide Python-basis opbouwen helpt je begrijpen wanneer en waarom logging nodig is.
Loguru installeren kost één commando:
pip install loguruMet de gewone logging-module moet je handlers, formatters en alles configureren voordat je ook maar één logbericht ziet.
Voor een diepere vergelijking van de ingebouwde loggingaanpak in Python, bekijk deze uitgebreide logging-tutorial die de traditionele methoden behandelt.
Met Loguru importeer je simpelweg en begin je met loggen:
from loguru import logger

# Instead of print("Processing user data...")
logger.info("Processing user data...")

# Instead of print(f"Found {count} records")
logger.info("Found {} records", count)
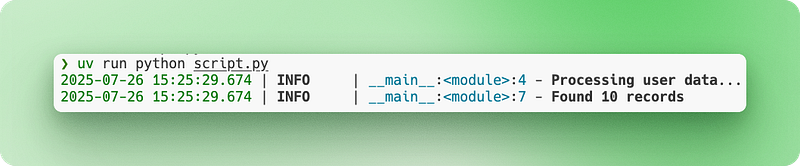
De output verschijnt in je terminal met kleuren, tijdstempels en logniveaus, automatisch. Geen setup nodig.
Stel, je bouwt een simpele webscraper. Zo verandert je debugging:
import requests
from loguru import logger

def scrape_website(url):
   logger.info("Starting scrape for {}", url)

   response = requests.get(url)
   logger.debug("Response status: {}", response.status_code)

   if response.status_code == 200:
       logger.success("Successfully scraped {} characters", len(response.text))
       return response.text
   else:
       logger.error("Failed to scrape {}: status {}", url, response.status_code)
       return None
Let op de verschillende logniveaus (info, debug, success, error) en de brace-stijl voor formattering. Alles werkt direct zonder configuratiebestanden of setupcode.
Als je debugt met consoleoutput, ben je alles kwijt zodra je de terminal sluit. Je kunt niet terugzoeken wat er een uur geleden gebeurde, en als je script ’s nachts crasht, is er geen spoor van wat er misging. Je kunt je debugoutput ook niet makkelijk delen met teamgenoten als je om hulp vraagt.
Bestandsloggen lost dit op door alles permanent op te slaan.
Traditioneel loggen dwingt je configuratiecode te schrijven om file handlers op te zetten. Je moet paden opgeven, mappen aanmaken en permissies regelen. Met Loguru voeg je bestandsloggen letterlijk met één regel toe:
from loguru import logger

# Add file logging alongside console output
logger.add("app.log")

logger.info("This appears in both console and file")
logger.error("So does this error message")
Nu wordt alles opgeslagen in app.log en verschijnt het nog steeds in je terminal.
Maar logbestanden worden op den duur enorm. Een webapplicatie die dagen draait kan gigabytes aan logs produceren die uiteindelijk je schijf vullen. Bestandsrotatie lost dit op door automatisch nieuwe logbestanden aan te maken zodra aan bepaalde voorwaarden is voldaan. Het oude bestand wordt hernoemd met een tijdstempel en een nieuw, leeg bestand start:
# When app.log reaches 10 MB, it becomes app_2024-07-15_14-30-25.log
# and a new empty app.log starts
logger.add("app.log", rotation="10 MB")

# Or start a new file every day at midnight
logger.add("app.log", rotation="00:00")
De standaardtijdstempels werken, maar zijn vaak in UTC of lastig te lezen. Loguru laat je datum- en tijdformaten aanpassen aan jouw wensen:
# Custom timestamp format that's easier to read
logger.add("app.log",
         format="{time:YYYY-MM-DD HH:mm:ss} | {level} | {message}",
         rotation="1 day")
Voor productiesystemen heb je meer controle over oude bestanden nodig. Productielogging vereist het volgen van Python best practices om je logs onderhoudbaar en veilig te houden. Zonder beheer stapelen logbestanden zich op en slurpen ze opslag op:
# Keep only the last 10 rotated files, compress the rest
logger.add("production.log",
         rotation="50 MB",     # New file every 50MB
         retention=10,         # Keep only 10 old files
         compression="zip")    # Compress rotated files
Laten we dit in een realistisch scenario bekijken. Je bouwt een datapijplijn die elke nacht meerdere CSV-bestanden verwerkt, klantdata schoonmaakt en valideert en die daarna in je database laadt. Je moet bijhouden welke bestanden succesvol zijn verwerkt en eventuele datakwaliteitsproblemen opvangen:
import pandas as pd
from loguru import logger

# Production-ready file logging setup
logger.add("data_processing_{time:YYYY-MM-DD}.log",
         rotation="00:00",        # New file daily
         retention="1 week",      # Keep 1 week of logs
         format="{time:YYYY-MM-DD HH:mm:ss} | {level} | {message}")

def process_csv_files(file_list):
   logger.info("Starting batch processing of {} files", len(file_list))

   for filename in file_list:
       try:
           df = pd.read_csv(filename)
           logger.info("Loaded {} with {} rows", filename, len(df))

           # Your processing logic here
           processed_df = df.dropna()

           logger.success("Processed {} - kept {} rows", filename, len(processed_df))

       except Exception as e:
           logger.error("Failed to process {}: {}", filename, str(e))

   logger.info("Batch processing complete")
Je logs worden opgeslagen met leesbare tijdstempels, bestanden roteren automatisch en oude logs worden vanzelf opgeschoond. Je kunt dagen later terugkijken of logbestanden naar collega’s sturen bij het troubleshooten.
Als je een webapplicatie draait, worden je logs al snel een warboel van gemixte informatie. Gebruikersacties, databasequeries, API-calls en fouten lopen door elkaar in een muur van tekst. Je kunt niet eenvoudig filteren op specifieke gebruikers, losse requests traceren of logs automatisch laten parsen door monitoringsystemen.
Datagedreven applicaties profiteren extra van gestructureerd loggen. Werk je met datapijplijnen of analytics, dan helpt het ontwikkelen van data-analistenvaardigheden je begrijpen welke informatie je in je logs wilt vastleggen.
Traditioneel, stringgebaseerd loggen maakt dit erger. Elk logbericht is gewoon tekst, dus betekenisvolle data extraheren vereist complexe regexpatronen of handmatig zoeken.
Gestructureerd loggen verandert dit door logitems als data-objecten te behandelen in plaats van alleen tekst. Elk logitem wordt een gestructureerd record met doorzoekbare velden, zodat je er programmatisch eenvoudig op kunt query’en en analyseren.
Loguru maakt gestructureerd loggen simpel met de optie serialize=True:
from loguru import logger

# Enable JSON structured logging
logger.add("api.log", serialize=True)

logger.info("User login", user_id=123, ip_address="192.168.1.1")
logger.error("Payment failed", user_id=123, amount=99.99, error_code="INSUFFICIENT_FUNDS")
De parameter serialize=True vertelt Loguru om JSON uit te sturen in plaats van platte tekst. In plaats van leesbare zinnen bevat je logbestand nu gestructureerde data:
{"text": "User login", "record": {"time": "2024-07-15T14:30:25", "level": {"name": "INFO"}, "extra": {"user_id": 123, "ip_address": "192.168.1.1"}}}Dit formaat werkt perfect met loganalysetools die JSON-data automatisch kunnen doorzoeken en filteren.
Maar webapplicaties hebben meer nodig dan alleen gestructureerde data. Je hebt context nodig die gerelateerde logitems verbindt. Wanneer je een gebruikersrequest verwerkt, wil je dat alle gerelateerde logs gedeelde informatie hebben zoals user ID of session ID.
Context binden lost dit op door blijvende informatie aan je logger te koppelen met logger.bind():
from loguru import logger

def process_user_order(user_id, order_data):
   # Create a logger with attached context
   order_logger = logger.bind(user_id=user_id, order_id=order_data['id'])

   order_logger.info("Starting order processing")
   order_logger.debug("Validating payment method", method=order_data['payment'])
   order_logger.info("Order processing complete", total=order_data['total'])
Nu bevat elke log van order_logger automatisch user_id en order_id, zodat je eenvoudig alle logs voor een specifieke bestelling kunt traceren.
Moderne applicaties hebben ook verschillende logoutputs voor verschillende doelen nodig. Je wilt misschien leesbare consolelogs tijdens ontwikkeling, maar JSON-logs voor productie-monitoring. In Loguru heet elke outputbestemming een “sink” — zie het als een plek waar logberichten naartoe stromen.
Loguru laat je meerdere sinks toevoegen met verschillende formaten en regels:
from loguru import logger
import sys

# Remove the default console output
logger.remove()

# Sink 1: Human-readable console for development
logger.add(sys.stdout,
         level="DEBUG",
         format="<green>{time:HH:mm:ss}</green> | {level} | {message}")

# Sink 2: JSON file for production monitoring
logger.add("app.log",
         serialize=True,
         level="INFO")

# Sink 3: Error-only file for alerts
logger.add("errors.log",
         level="ERROR")
De aanroep logger.remove() verwijdert de standaard consoleoutput van Loguru zodat je je eigen setup kunt maken. Elke logger.add() maakt een nieuwe sink met eigen regels over wat er wordt gelogd en hoe het wordt geformatteerd.
Nu produceren dezelfde logstatements verschillende outputs:
logger.debug("Processing started")      # Only appears in console
logger.info("User data loaded")         # Appears in console and app.log
logger.error("Database connection failed") # Appears in all three placesLaten we dit bekijken in een eenvoudiger, realistischer voorbeeld van Loguru gebruiken — een basisgebruikersregistratiesysteem:
from loguru import logger
import sys

# Set up multiple outputs
logger.remove()
logger.add(sys.stdout, level="INFO", format="{time:HH:mm:ss} | {message}")
logger.add("user_registration.log", serialize=True, level="INFO")
logger.add("errors.log", level="ERROR")

def register_user(email, password):
   # Create logger with user context
   user_logger = logger.bind(email=email)

   user_logger.info("Starting user registration")

   # Validate email
   if "@" not in email:
       user_logger.error("Invalid email format")
       return False

   # Check if user exists
   user_logger.debug("Checking if user already exists")

   # Simulate password hashing
   user_logger.debug("Hashing password")

   # Save to database
   user_logger.info("Saving user to database")
   user_logger.success("User registration completed")

   return True

# Usage
register_user("john@example.com", "secure123")
Deze setup geeft je leesbare consoleoutput tijdens ontwikkeling, gestructureerde JSON-logs voor geautomatiseerde monitoring en aparte errorlogs voor alerts. De methode bind() zorgt ervoor dat alle logs voor elke gebruikersregistratie het e-mailadres bevatten, wat debuggen veel makkelijker maakt.
Wanneer je code crasht, krijg je meestal een basis-stacktrace die vertelt waar de fout gebeurde, maar niet veel over waarom. Je verliest de waarden van variabelen op het moment van de crash, wat het lastig maakt te begrijpen wat er misging. Traditionele foutafhandeling vereist ook dat je alles in try-catch-blokken wikkelt en elke uitzondering handmatig logt.
Dit wordt extra pijnlijk bij het debuggen van productie-issues. Gebruikers melden fouten, maar jij kunt ze niet reproduceren omdat je de context mist die aanwezig was toen de fout optrad.
Loguru lost dit op met automatische uitzonderingenvangst en verbeterde tracebacks die precies laten zien wat er in je code gebeurde toen het misging.
De decorator @logger.catch vangt automatisch elke uitzondering die in een functie optreedt en logt die met volledige context. Decorators zoals @logger.catch zijn een intermediate Python-concept dat je foutafhandeling door je hele codebase kan transformeren:
from loguru import logger

@logger.catch
def divide_numbers(a, b):
   result = a / b
   return result

# This automatically logs the exception with full traceback
result = divide_numbers(10, 0)
In plaats van dat je programma crasht met een basismelding, vangt Loguru de uitzondering en logt die met gedetailleerde informatie, terwijl je programma blijft draaien. De decorator werkt op elke functie — classmethods, async functies of gewone functies.
Maar Loguru gaat verder met verbeterde tracebacks die variabelewaarden op elk niveau van de call stack tonen. Deze feature heet “diagnose” en het is alsof je een debugger in je logs hebt ingebouwd:
from loguru import logger

# Enable enhanced tracebacks
logger.add("debug.log", diagnose=True)

@logger.catch
def process_user_data(users):
   for user in users:
       age = user['age']
       if age > 0:
           years_to_retirement = 65 - age
           print(f"User {user['name']} has {years_to_retirement} years to retirement")

# When this crashes, you'll see the exact values of 'users', 'user', and 'age'
users_data = [
   {"name": "Alice", "age": 30},
   {"name": "Bob", "age": "invalid"},  # This will cause an error
]

process_user_data(users_data)
Met diagnose=True laat Loguru, wanneer de functie crasht doordat een string van een getal wordt afgetrokken, precies zien wat er in elke variabele stond:
TypeError: unsupported operand type(s) for -: 'int' and 'str'

Variables values:
   users = [{"name": "Alice", "age": 30}, {"name": "Bob", "age": "invalid"}]
   user = {"name": "Bob", "age": "invalid"}
   age = "invalid"
Dit detailniveau maakt debuggen veel sneller, omdat je exact ziet welke data het probleem veroorzaakte.
Verbeterde tracebacks kunnen echter gevoelige informatie zoals wachtwoorden of API-sleutels in productielogs prijsgeven. Loguru laat je dit gedrag per omgeving sturen:
from loguru import logger
import os

# Development: Full diagnostic information
if os.getenv("ENVIRONMENT") == "development":
   logger.add("app.log", diagnose=True, level="DEBUG")
else:
   # Production: Basic logging without variable inspection
   logger.add("app.log", diagnose=False, level="INFO")

@logger.catch
def authenticate_user(username, password, api_key):
   # In development, you'll see all variable values if this crashes
   # In production, sensitive data stays hidden
   if not username or not password:
raise ValueError("Missing credentials")Een andere krachtige feature is luie evaluatie, die de performance verbetert bij het loggen van dure operaties. Soms wil je complexe informatie loggen, maar alleen als er daadwerkelijk een fout optreedt:
from loguru import logger

@logger.catch
def process_large_dataset(data):
   try:
       # Some complex processing that might fail
       result = complex_calculation(data)
       return result
   except Exception as e:
       # This expensive operation only runs if there's an error
       logger.error("Processing failed with data: {data}",
                   data=lambda: expensive_data_summary(data))
       raise

def expensive_data_summary(data):
   # This function takes time to run, summarizing huge datasets
   return {"row_count": len(data), "columns": list(data.keys()), "memory_usage": data.memory_usage()}
De lambda:-syntaxis maakt een functie die alleen wordt aangeroepen wanneer Loguru het logbericht daadwerkelijk wegschrijft. Als er geen fout optreedt, wordt expensive_data_summary() nooit uitgevoerd, wat rekentijd bespaart.
Je kunt ook verschillende strategieën voor foutafhandeling gebruiken voor verschillende soorten fouten:
from loguru import logger

# Configure multiple outputs for different error severities
logger.add("warnings.log", level="WARNING", filter=lambda record: record["level"].name == "WARNING")
logger.add("critical_errors.log", level="ERROR")

@logger.catch(level="ERROR")
def critical_database_operation(query):
   # Database errors get logged as ERROR level
   execute_database_query(query)

@logger.catch(level="WARNING", reraise=False)
def optional_feature(user_id):
   # Non-critical features log as WARNING and continue execution
   send_optional_notification(user_id)

def process_user_request(user_id, query):
   # Critical operation - if this fails, the whole request fails
   critical_database_operation(query)

   # Optional operation - if this fails, request continues
   optional_feature(user_id)
De parameter reraise=False vertelt Loguru om de uitzondering te loggen maar niet opnieuw te gooien, zodat je programma kan doorgaan. Dit is handig voor optionele features die je hoofdworkflow niet mogen breken.
Laten we een compleet voorbeeld bekijken met een bestandverwerkingssysteem dat verschillende soorten fouten netjes afhandelt:
from loguru import logger
import os

# Set up environment-aware logging
if os.getenv("DEBUG"):
   logger.add("file_processor.log", diagnose=True, level="DEBUG")
else:
   logger.add("file_processor.log", diagnose=False, level="INFO")

@logger.catch(reraise=False)
def validate_file_format(filename):
   if not filename.endswith(('.csv', '.json', '.xml')):
       raise ValueError(f"Unsupported file format: {filename}")

@logger.catch
def load_file_data(filename):
   logger.info("Loading file: {}", filename)

   # Expensive operation only logged on errors
   logger.debug("File stats: {stats}",
               stats=lambda: {"size": os.path.getsize(filename),
                             "modified": os.path.getmtime(filename)})

   with open(filename, 'r') as f:
       return f.read()

def process_files(file_list):
   results = []

   for filename in file_list:
       # Validation errors are logged but don't stop processing
       validate_file_format(filename)

       try:
           # Loading errors are logged and do stop processing this file
           data = load_file_data(filename)
           results.append(data)
           logger.success("Successfully processed {}", filename)
       except Exception:
           logger.error("Skipping file {} due to loading error", filename)
           continue

   return results
Deze setup geeft je automatische uitzonderingenvangst, gedetailleerde foutcontext waar nodig en verschillende afhandelingsstrategieën voor verschillende fouttypes. Je logs worden veel bruikbaarder voor debuggen, terwijl je code schoon en leesbaar blijft.
Naarmate je applicaties groeien, kom je scenario’s tegen waar de defaults van Loguru net niet passen. Misschien heb je een speciaal logniveau nodig voor businessmetrics, wil je gevoelige data uit logs filteren of moeten er alerts naar Slack bij fouten.
Het goede nieuws: Loguru is gebouwd om aan te passen zonder zijn eenvoud te verliezen. Je kunt het uitbreiden op manieren die in traditionele loggingsystemen complexe configuratie vereisen, terwijl je code toch schoon en leesbaar blijft.
Laten we kijken naar de meest nuttige aanpassingen die echte problemen oplossen die je in productie-applicaties tegenkomt.
Loguru wordt geleverd met standaardniveaus zoals INFO, DEBUG en ERROR. Maar soms heb je iets specifieks voor jouw applicatie nodig. Misschien wil je een speciaal niveau voor performancemetrics of business events.
Aangepaste logniveaus maken is eenvoudig:
from loguru import logger

# Add a custom level for business metrics
logger.level("METRIC", no=38, color="<yellow>", icon="📊")

# Add a custom level for security events
logger.level("SECURITY", no=45, color="<red><bold>", icon="🔒")

# Now you can use these levels
logger.log("METRIC", "Order completed in {} seconds", 2.5)
logger.log("SECURITY", "Failed login attempt from IP: {}", "192.168.1.100")
De parameter no bepaalt de prioriteit van het niveau (hogere nummers = hogere prioriteit). Standaardniveaus gebruiken: DEBUG=10, INFO=20, WARNING=30, ERROR=40, CRITICAL=50.
Laten we dit zien in een machinelearning-trainingsscenario:
from loguru import logger

# Set up custom levels for ML tracking
logger.level("EPOCH", no=35, color="<cyan><bold>")
logger.level("CHECKPOINT", no=38, color="<green><bold>")

# Configure output
logger.remove()
logger.add("training_{time:YYYY-MM-DD}.log", level="INFO")

def train_model(model, data_loader, epochs=10):
   logger.info("Starting training with {} epochs", epochs)

   for epoch in range(epochs):
       # Log epoch progress with custom level
       logger.log("EPOCH", "Epoch {}/{} started", epoch + 1, epochs)

       # Training logic here
       loss = 0.523 - (epoch * 0.05)  # Simulated improving loss
       accuracy = 0.72 + (epoch * 0.03)  # Simulated improving accuracy

       logger.info("Loss: {:.4f}, Accuracy: {:.2%}", loss, accuracy)

       # Save checkpoint every 5 epochs
       if (epoch + 1) % 5 == 0:
           logger.log("CHECKPOINT", "Model saved at epoch {}", epoch + 1)

logger.success("Training completed!")Soms moet je logberichten aanpassen voordat ze worden weggeschreven. Veelvoorkomende use-cases zijn het verwijderen van gevoelige data, request-ID’s toevoegen of berichten herformatteren voor specifieke tools.
Loguru laat je berichten onderscheppen met de parameter filter:
from loguru import logger
import re

def hide_sensitive_data(record):
   # Hide credit card numbers
   record["message"] = re.sub(r'\b\d{4}[\s-]?\d{4}[\s-]?\d{4}[\s-]?\d{4}\b',
                             'XXXX-XXXX-XXXX-XXXX',
                             record["message"])

   # Hide email addresses
   record["message"] = re.sub(r'\b[\w.-]+@[\w.-]+\.\w+\b',
                             '***@***.***',
                             record["message"])

   # Continue processing the log
   return True

# Add the filter to your logger
logger.add("secure.log", filter=hide_sensitive_data)

# Test it
logger.info("User paid with card 4532-1234-5678-9012")
logger.info("Contact email: john.doe@example.com")
Je kunt filters ook gebruiken om contextuele informatie toe te voegen:
from loguru import logger
import threading

def add_thread_info(record):
   # Add thread name to every log message
   record["extra"]["thread_name"] = threading.current_thread().name
   return True

def add_environment_info(record):
   # Add environment to production logs
   record["extra"]["env"] = "production"
   record["extra"]["region"] = "us-west-2"
   return True

# Apply multiple filters
logger.add(
   "app.log",
   filter=lambda record: add_thread_info(record) and add_environment_info(record),
   format="{time} | {extra[env]} | {extra[thread_name]} | {message}"
)Een sink is waar je logs naartoe stromen. Hoewel bestanden en console gebruikelijk zijn, moet je vaak logs naar externe services sturen zoals Slack, e-mail of monitoringsystemen.
Zo maak je een custom sink die errors naar Slack stuurt:
from loguru import logger
import requests

def send_to_slack(message):
   """Custom sink that sends messages to Slack"""
   # Parse the log record
   record = message.record

   # Only send errors and above
   if record["level"].no < 40:  # ERROR level is 40
       return

   # Format message for Slack
   slack_message = {
       "text": f"🚨 {record['level'].name}: {record['message']}",
       "attachments": [{
           "color": "danger",
           "fields": [
               {"title": "Time", "value": str(record["time"]), "short": True},
               {"title": "Function", "value": record["function"], "short": True},
               {"title": "File", "value": f"{record['file'].name}:{record['line']}", "short": False}
           ]
       }]
   }

   # Send to Slack webhook
   webhook_url = "https://hooks.slack.com/services/YOUR/WEBHOOK/URL"
   requests.post(webhook_url, json=slack_message)

# Add the custom sink
logger.add(send_to_slack, level="ERROR")

# Test it
logger.error("Database connection lost!")
Hier is nog een praktisch voorbeeld — een custom sink die performancemetrics verzamelt tijdens de run van je applicatie en ze opslaat voor analyse:
from loguru import logger
from collections import defaultdict
import json

class MetricsCollector:
   def __init__(self):
       self.metrics = defaultdict(list)

   def __call__(self, message):
       """This method is called for every log message"""
       record = message.record

       # Only process METRIC level logs
       if record["level"].name != "METRIC":
           return

       # Extract metric data from the 'extra' fields
       extra = record["extra"]
       if "metric_name" in extra and "value" in extra:
           self.metrics[extra["metric_name"]].append({
               "value": extra["value"],
               "timestamp": record["time"].timestamp()
           })

   def save_metrics(self):
       """Save all collected metrics to a JSON file"""
       with open("metrics.json", "w") as f:
           json.dump(dict(self.metrics), f, indent=2)

# Create the collector and add it as a sink
collector = MetricsCollector()
logger.add(collector)

# Create the METRIC level
logger.level("METRIC", no=38)

# Now when you log metrics, they're automatically collected
# The bind() method attaches extra data to the log entry
logger.bind(metric_name="response_time", value=0.234).log("METRIC", "API response")
logger.bind(metric_name="response_time", value=0.189).log("METRIC", "API response")
logger.bind(metric_name="active_users", value=1523).log("METRIC", "User count")

# Later, save all metrics to file
collector.save_metrics()

# The metrics.json file will contain:
# {
#   "response_time": [
#     {"value": 0.234, "timestamp": 1627...},
#     {"value": 0.189, "timestamp": 1627...}
#   ],
#   "active_users": [
#     {"value": 1523, "timestamp": 1627...}
#   ]
# }
Het mooie van deze aanpak is dat je applicatiecode schoon blijft — je logt metrics gewoon normaal, en de collector-sink regelt de opslag automatisch. Je kunt dit eenvoudig vervangen door een sink die metrics naar Prometheus, DataDog of een andere monitoringsdienst stuurt.
Deze aanpassingen geven je de flexibiliteit om Loguru aan je specifieke behoeften aan te passen, terwijl je de eenvoud behoudt die het zo prettig maakt. Of je nu een klein script of een grote applicatie bouwt, je kunt Loguru uitbreiden om je unieke loggingvereisten aan te kunnen zonder complexe configuratiebestanden of boilerplatecode.
Loguru maakt loggen in Python zo simpel als het zou moeten zijn. Geen configuratiebestanden meer, geen handler-setup, geen boilerplatecode. Gewoon importeren en beginnen met loggen met kleuren, tijdstempels en automatische bestandsrotatie.
Je hebt gezien hoe het de veelvoorkomende pijnpunten aanpakt: logs opslaan in bestanden, ze automatisch roteren, uitzonderingen vangen met volledige context en logs naar externe services sturen. De gestructureerde loggingfeatures maken het klaar voor productie, terwijl aangepaste niveaus en sinks je laten inspelen op elke use-case.
Gebruik Loguru wanneer:
Voor verdere verdieping: bekijk de officiële documentatie naast deze logging-tutorial voor een volledige dekking van loggingstrategieën in Python.
Begin klein. Vervang één printstatement door logger.info(). Je wilt nooit meer terug.
Top DataCamp Courses
Leerpad
Leerpad
Cursus
blog
Adel Nehme
15 min


