लर्निंग पाथ
Python डेटा मूलभूत बातें
28 घंटा
आपने अपनी पूरी कोडिंग लाइफ़ print() स्टेटमेंट्स से डिबग किया है। शायद आपने Python के लॉगिंग मॉड्यूल को एक-दो बार आज़माया होगा, लेकिन सरल होने के कारण फिर से प्रिंट्स पर लौट आए।
असल में इससे बेहतर एक विकल्प है जो इस्तेमाल में उतना ही आसान है।
प्रिंट स्टेटमेंट्स न तो फ़ाइलों में सेव हो सकते हैं और न ही उन्हें आसानी से ऑन-ऑफ किया जा सकता है। Python का बिल्ट-इन लॉगिंग यह कर सकता है, लेकिन इसके लिए ऐसा सेटअप कोड लिखना पड़ता है जो अक्सर आपके असल प्रोग्राम से लंबा हो जाता है।
Loguru अलग तरीका अपनाता है: लॉगिंग प्रिंटिंग जितनी आसान होनी चाहिए, लेकिन कहीं ज़्यादा उपयोगी। आपको टर्मिनल में रंग, ऑटोमेटिक टाइमस्टैम्प, और बिना एक भी कॉन्फ़िगरेशन लाइन लिखे सब कुछ फ़ाइलों में सेव करने की क्षमता मिलती है।
इस ट्यूटोरियल में, मैं आपको प्रैक्टिकल उदाहरण दिखाऊंगा जो लॉगिंग को बोझ नहीं, बल्कि स्वाभाविक महसूस कराते हैं। आप ऐसे फ़ीचर्स देखेंगे जिनके बारे में शायद आपको पता भी नहीं था, और ऐसे कोड पैटर्न जो सचमुच डिबगिंग को आसान बनाते हैं।
यदि आप Python डिबगिंग में नए हैं या अपनी बुनियादी कौशल मज़बूत करना चाहते हैं, मज़बूत Python फ़ंडामेंटल्स बनाना आपको यह समझने में मदद करता है कि लॉगिंग कब और क्यों ज़रूरी हो जाती है।
Loguru इंस्टॉल करने के लिए बस एक कमांड चाहिए:
pip install loguruरेगुलर logging मॉड्यूल के साथ, एक लॉग मैसेज देखने से पहले आपको हैंडलर, फ़ॉर्मैटर सेट करने और सब कुछ कॉन्फ़िगर करने की ज़रूरत पड़ती है।
Python के बिल्ट-इन लॉगिंग तरीकों की गहरी तुलना के लिए यह व्यापक लॉगिंग ट्यूटोरियल देखें जो पारंपरिक तरीकों को कवर करता है।
Loguru के साथ, आप बस इम्पोर्ट करें और लॉगिंग शुरू करें:
from loguru import logger

# Instead of print("Processing user data...")
logger.info("Processing user data...")

# Instead of print(f"Found {count} records")
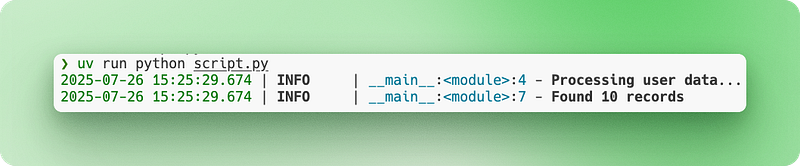
logger.info("Found {} records", count)
आउटपुट आपके टर्मिनल में रंगों, टाइमस्टैम्प और लॉग लेवल्स के साथ अपने-आप आता है। कोई सेटअप नहीं चाहिए।
मान लीजिए आप एक साधारण वेब स्क्रेपर बना रहे हैं। आपका डिबगिंग इस तरह बदलता है:
import requests
from loguru import logger

def scrape_website(url):
   logger.info("Starting scrape for {}", url)

   response = requests.get(url)
   logger.debug("Response status: {}", response.status_code)

   if response.status_code == 200:
       logger.success("Successfully scraped {} characters", len(response.text))
       return response.text
   else:
       logger.error("Failed to scrape {}: status {}", url, response.status_code)
       return None
यहाँ अलग-अलग लॉग लेवल्स (info, debug, success, error) और ब्रेसेज़-स्टाइल फ़ॉर्मैटिंग पर ध्यान दें। बिना किसी कॉन्फ़िगरेशन फ़ाइल या सेटअप कोड के सब कुछ तुरंत काम करता है।
जब आप कंसोल आउटपुट से डिबग करते हैं, तो टर्मिनल बंद करते ही सब कुछ खो जाता है। एक घंटे पहले क्या हुआ, आप खोज नहीं सकते, और अगर आपकी स्क्रिप्ट रात में क्रैश हो जाए, तो क्या गलत हुआ इसका कोई सुराग नहीं मिलता। जब आप मदद मांगते हैं, तो टीम के साथ डिबगिंग आउटपुट साझा करना भी आसान नहीं होता।
फ़ाइल लॉगिंग इसे सब कुछ स्थायी रूप से सेव करके हल करता है।
पारंपरिक लॉगिंग आपको फ़ाइल हैंडलर सेट करने के लिए कॉन्फ़िगरेशन कोड लिखवाती है। आपको फ़ाइल पथ बताने, डायरेक्टरी बनाने और परमिशन हैंडल करने पड़ते हैं। Loguru के साथ, फ़ाइल लॉगिंग जोड़ना सचमुच एक लाइन है:
from loguru import logger

# Add file logging alongside console output
logger.add("app.log")

logger.info("This appears in both console and file")
logger.error("So does this error message")
अब सब कुछ app.log में सेव भी होगा और आपके टर्मिनल में भी दिखेगा।
लेकिन लॉग फ़ाइलें समय के साथ बहुत बड़ी हो जाती हैं। कई दिनों तक चलने वाला वेब ऐप गीगाबाइट्स में लॉग बना सकता है जो अंततः डिस्क भर देता है। फ़ाइल रोटेशन शर्तें पूरी होने पर अपने-आप नई लॉग फ़ाइलें बनाकर इसे हल करता है। पुरानी फ़ाइल टाइमस्टैम्प के साथ रीनेम हो जाती है, और नई फ़ाइल शुरू होती है:
# When app.log reaches 10 MB, it becomes app_2024-07-15_14-30-25.log
# and a new empty app.log starts
logger.add("app.log", rotation="10 MB")

# Or start a new file every day at midnight
logger.add("app.log", rotation="00:00")
डिफ़ॉल्ट टाइमस्टैम्प काम करते हैं, लेकिन वे अक्सर UTC में होते हैं या पढ़ने में कठिन। Loguru आपको अपनी ज़रूरत के अनुसार डेटटाइम फ़ॉर्मैट कस्टमाइज़ करने देता है:
# Custom timestamp format that's easier to read
logger.add("app.log",
         format="{time:YYYY-MM-DD HH:mm:ss} | {level} | {message}",
         rotation="1 day")
प्रोडक्शन सिस्टम के लिए, आपको पुरानी फ़ाइलों पर ज़्यादा नियंत्रण चाहिए। प्रोडक्शन लॉगिंग में आपके लॉग्स को मेंटेनबल और सुरक्षित रखने के लिए Python के बेस्ट प्रैक्टिसेज़ का पालन करना ज़रूरी है। मैनेजमेंट के बिना, लॉग फ़ाइलें जमा होकर स्टोरेज खा जाती हैं:
# Keep only the last 10 rotated files, compress the rest
logger.add("production.log",
         rotation="50 MB",     # New file every 50MB
         retention=10,         # Keep only 10 old files
         compression="zip")    # Compress rotated files
इसे एक वास्तविक परिदृश्य में देखते हैं। आप एक डेटा पाइपलाइन बना रहे हैं जो हर रात कई CSV फ़ाइलें प्रोसेस करती है, ग्राहक डेटा को साफ़ और वैलिडेट करके आपके डेटाबेस में लोड करती है। आपको यह ट्रैक करना है कि कौन-सी फ़ाइलें सफलतापूर्वक प्रोसेस हुईं और कोई डेटा क्वालिटी इश्यूज़ पकड़ने हैं:
import pandas as pd
from loguru import logger

# Production-ready file logging setup
logger.add("data_processing_{time:YYYY-MM-DD}.log",
         rotation="00:00",        # New file daily
         retention="1 week",      # Keep 1 week of logs
         format="{time:YYYY-MM-DD HH:mm:ss} | {level} | {message}")

def process_csv_files(file_list):
   logger.info("Starting batch processing of {} files", len(file_list))

   for filename in file_list:
       try:
           df = pd.read_csv(filename)
           logger.info("Loaded {} with {} rows", filename, len(df))

           # Your processing logic here
           processed_df = df.dropna()

           logger.success("Processed {} - kept {} rows", filename, len(processed_df))

       except Exception as e:
           logger.error("Failed to process {}: {}", filename, str(e))

   logger.info("Batch processing complete")
आपके लॉग पढ़ने योग्य टाइमस्टैम्प के साथ सेव होते हैं, फ़ाइलें अपने-आप रोटेट होती हैं, और पुराने लॉग खुद साफ़ हो जाते हैं। आप कई दिनों बाद भी देख सकते हैं कि क्या हुआ था या ट्रबलशूटिंग के दौरान लॉग फ़ाइलें सहकर्मियों को भेज सकते हैं।
जब आप वेब ऐप चलाते हैं, तो लॉग जल्दी ही मिली-जुली जानकारी के जंजाल में बदल जाते हैं। यूज़र एक्शन, डेटाबेस क्वेरी, API कॉल्स और एरर्स सब एक दीवार-सी टेक्स्ट में घुल-मिल जाते हैं। आप किसी विशेष यूज़र के लिए फ़िल्टर करना, व्यक्तिगत रिक्वेस्ट्स को ट्रेस करना, या मॉनिटरिंग सिस्टम के लिए लॉग्स को अपने-आप पार्स करना आसानी से नहीं कर पाते।
डेटा-ड्रिवन ऐप्लिकेशन विशेष रूप से स्ट्रक्चर्ड लॉगिंग से लाभ उठाते हैं। यदि आप डेटा पाइपलाइंस या एनालिटिक्स के साथ काम कर रहे हैं, तो डेटा एनालिस्ट स्किल्स विकसित करना आपको यह समझने में मदद करता है कि लॉग्स में कौन-सी जानकारी कैप्चर करनी है।
पारंपरिक स्ट्रिंग-आधारित लॉगिंग इसे और बदतर बनाती है। हर लॉग मैसेज सिर्फ टेक्स्ट होता है, इसलिए अर्थपूर्ण डेटा निकालने के लिए जटिल regex पैटर्न या मैनुअल सर्चिंग करनी पड़ती है।
स्ट्रक्चर्ड लॉगिंग इसे बदल देती है—लॉग एंट्रीज़ को सिर्फ टेक्स्ट नहीं, बल्कि डेटा ऑब्जेक्ट्स की तरह ट्रीट करके। हर लॉग एंट्री सर्चेबल फ़ील्ड्स के साथ एक स्ट्रक्चर्ड रिकॉर्ड बन जाती है, जिसे प्रोग्रामेटिक तरीक़े से क्वेरी और विश्लेषित करना आसान हो जाता है।
Loguru serialize=True विकल्प के साथ स्ट्रक्चर्ड लॉगिंग को सरल बनाता है:
from loguru import logger

# Enable JSON structured logging
logger.add("api.log", serialize=True)

logger.info("User login", user_id=123, ip_address="192.168.1.1")
logger.error("Payment failed", user_id=123, amount=99.99, error_code="INSUFFICIENT_FUNDS")
serialize=True पैरामीटर Loguru को सादा टेक्स्ट के बजाय JSON आउटपुट देने को कहता है। पढ़ने योग्य वाक्यों के बजाय, अब आपकी लॉग फ़ाइल में स्ट्रक्चर्ड डेटा होता है:
{"text": "User login", "record": {"time": "2024-07-15T14:30:25", "level": {"name": "INFO"}, "extra": {"user_id": 123, "ip_address": "192.168.1.1"}}}यह फ़ॉर्मैट उन लॉग विश्लेषण टूल्स के साथ बेहतरीन काम करता है जो अपने-आप JSON डेटा को खोज और फ़िल्टर कर सकते हैं।
लेकिन वेब ऐप्लिकेशन्स को सिर्फ स्ट्रक्चर्ड डेटा से ज़्यादा चाहिए। आपको ऐसा संदर्भ चाहिए जो संबंधित लॉग एंट्रीज़ को जोड़ता हो। किसी यूज़र रिक्वेस्ट को प्रोसेस करते समय, आप चाहते हैं कि सभी संबंधित लॉग्स में यूज़र ID या सेशन ID जैसी कॉमन जानकारी हो।
कॉन्टेक्स्ट बाइंडिंग इसे logger.bind() का उपयोग करके आपके लॉगर में स्थायी जानकारी जोड़कर हल करता है:
from loguru import logger

def process_user_order(user_id, order_data):
   # Create a logger with attached context
   order_logger = logger.bind(user_id=user_id, order_id=order_data['id'])

   order_logger.info("Starting order processing")
   order_logger.debug("Validating payment method", method=order_data['payment'])
   order_logger.info("Order processing complete", total=order_data['total'])
अब order_logger से आने वाला हर लॉग अपने-आप user_id और order_id शामिल करता है, जिससे किसी विशेष ऑर्डर से संबंधित सभी लॉग्स को ट्रेस करना आसान हो जाता है।
आधुनिक ऐप्लिकेशन्स को अलग-अलग उद्देश्यों के लिए अलग लॉग आउटपुट्स चाहिए होते हैं। डेवलपमेंट के दौरान आपको पढ़ने योग्य कंसोल लॉग चाहिए हो सकते हैं, लेकिन प्रोडक्शन मॉनिटरिंग के लिए JSON लॉग। Loguru में हर आउटपुट डेस्टिनेशन को “sink” कहा जाता है—इसे उस जगह की तरह समझें जहाँ लॉग मैसेजेज़ बहते हैं।
Loguru आपको अलग फ़ॉर्मैट्स और नियमों के साथ मल्टीपल सिंक जोड़ने देता है:
from loguru import logger
import sys

# Remove the default console output
logger.remove()

# Sink 1: Human-readable console for development
logger.add(sys.stdout,
         level="DEBUG",
         format="<green>{time:HH:mm:ss}</green> | {level} | {message}")

# Sink 2: JSON file for production monitoring
logger.add("app.log",
         serialize=True,
         level="INFO")

# Sink 3: Error-only file for alerts
logger.add("errors.log",
         level="ERROR")
logger.remove() कॉल Loguru के डिफ़ॉल्ट कंसोल आउटपुट को हटा देता है ताकि आप अपना सेटअप कर सकें। हर logger.add() एक नया सिंक बनाता है जिसके अपने नियम होते हैं कि क्या लॉग होगा और कैसे फ़ॉर्मैट होगा।
अब वही लॉग स्टेटमेंट्स अलग-अलग आउटपुट पैदा करते हैं:
logger.debug("Processing started")      # Only appears in console
logger.info("User data loaded")         # Appears in console and app.log
logger.error("Database connection failed") # Appears in all three placesइसे एक और सरल, वास्तविक उदाहरण में देखते हैं—Loguru का उपयोग करते हुए एक बेसिक यूज़र रजिस्ट्रेशन सिस्टम:
from loguru import logger
import sys

# Set up multiple outputs
logger.remove()
logger.add(sys.stdout, level="INFO", format="{time:HH:mm:ss} | {message}")
logger.add("user_registration.log", serialize=True, level="INFO")
logger.add("errors.log", level="ERROR")

def register_user(email, password):
   # Create logger with user context
   user_logger = logger.bind(email=email)

   user_logger.info("Starting user registration")

   # Validate email
   if "@" not in email:
       user_logger.error("Invalid email format")
       return False

   # Check if user exists
   user_logger.debug("Checking if user already exists")

   # Simulate password hashing
   user_logger.debug("Hashing password")

   # Save to database
   user_logger.info("Saving user to database")
   user_logger.success("User registration completed")

   return True

# Usage
register_user("john@example.com", "secure123")
यह सेटअप आपको डेवलपमेंट के दौरान पढ़ने योग्य कंसोल आउटपुट, ऑटोमेटेड मॉनिटरिंग के लिए स्ट्रक्चर्ड JSON लॉग, और अलर्ट्स के लिए अलग एरर लॉग देता है। bind() मेथड यह सुनिश्चित करता है कि हर यूज़र रजिस्ट्रेशन के सभी लॉग्स में ईमेल पता शामिल हो, जिससे डिबगिंग बहुत आसान हो जाती है।
जब आपका कोड क्रैश होता है, तो आम तौर पर एक बुनियादी स्टैक ट्रेस मिलता है जो बताता है कि एरर कहाँ हुआ, लेकिन यह नहीं कि क्यों। क्रैश के समय वेरिएबल्स के मान खो जाते हैं, जिससे समझना मुश्किल हो जाता है कि क्या गलत हुआ। पारंपरिक एक्सेप्शन हैंडलिंग में हर जगह try-catch ब्लॉक्स लगाने और हर एक्सेप्शन को मैन्युअली लॉग करने की ज़रूरत पड़ती है।
यह खासकर प्रोडक्शन इश्यूज़ को डिबग करते समय तकलीफ़देह हो जाता है। यूज़र एरर रिपोर्ट करते हैं, लेकिन आप उन्हें दोहरा नहीं पाते क्योंकि आपके पास वह संदर्भ नहीं होता जो एरर के समय मौजूद था।
Loguru इसे ऑटोमेटिक एक्सेप्शन कैप्चर और ऐसे एन्हांस्ड ट्रेसबैक्स से हल करता है जो आपको ठीक-ठीक दिखाते हैं कि आपके कोड में गड़बड़ी के समय क्या हो रहा था।
@logger.catch डेकोरेटर किसी फ़ंक्शन में होने वाले हर एक्सेप्शन को अपने-आप कैप्चर कर लेता है और उसे फुल कॉन्टेक्स्ट के साथ लॉग करता है। @logger.catch जैसे डेकोरेटर्स एक इंटरमीडिएट Python कॉन्सेप्ट हैं जो आपकी पूरी कोडबेस में एरर हैंडलिंग का तरीका बदल सकते हैं:
from loguru import logger

@logger.catch
def divide_numbers(a, b):
   result = a / b
   return result

# This automatically logs the exception with full traceback
result = divide_numbers(10, 0)
आपका प्रोग्राम किसी बेसिक एरर मैसेज के साथ क्रैश होने के बजाय, Loguru एक्सेप्शन को कैप्चर कर विस्तृत जानकारी के साथ लॉग करता है, और आपका प्रोग्राम चलना जारी रखता है। यह डेकोरेटर किसी भी फ़ंक्शन—क्लास मेथड्स, async फ़ंक्शन्स, या रेगुलर फ़ंक्शन्स—पर काम करता है।
लेकिन Loguru इससे आगे जाकर एन्हांस्ड ट्रेसबैक्स देता है जो कॉल स्टैक के हर स्तर पर वेरिएबल्स के मान दिखाते हैं। इस फीचर को “diagnose” कहा जाता है और यह ऐसा है जैसे आपके लॉग्स में ही डिबगर लगा हो:
from loguru import logger

# Enable enhanced tracebacks
logger.add("debug.log", diagnose=True)

@logger.catch
def process_user_data(users):
   for user in users:
       age = user['age']
       if age > 0:
           years_to_retirement = 65 - age
           print(f"User {user['name']} has {years_to_retirement} years to retirement")

# When this crashes, you'll see the exact values of 'users', 'user', and 'age'
users_data = [
   {"name": "Alice", "age": 30},
   {"name": "Bob", "age": "invalid"},  # This will cause an error
]

process_user_data(users_data)
diagnose=True के साथ, जब फ़ंक्शन किसी स्ट्रिंग को नंबर से घटाने की कोशिश में क्रैश होता है, Loguru आपको हर वेरिएबल में क्या था, ठीक-ठीक दिखाता है:
TypeError: unsupported operand type(s) for -: 'int' and 'str'

Variables values:
   users = [{"name": "Alice", "age": 30}, {"name": "Bob", "age": "invalid"}]
   user = {"name": "Bob", "age": "invalid"}
   age = "invalid"
यह स्तर का विवरण डिबगिंग को बहुत तेज़ बना देता है क्योंकि आप ठीक देख सकते हैं कि समस्या किस डेटा ने पैदा की।
हालाँकि, एन्हांस्ड ट्रेसबैक्स प्रोडक्शन लॉग्स में पासवर्ड या API कीज़ जैसी संवेदनशील जानकारी उजागर कर सकते हैं। Loguru आपको अलग-अलग वातावरणों के लिए इस व्यवहार को नियंत्रित करने देता है:
from loguru import logger
import os

# Development: Full diagnostic information
if os.getenv("ENVIRONMENT") == "development":
   logger.add("app.log", diagnose=True, level="DEBUG")
else:
   # Production: Basic logging without variable inspection
   logger.add("app.log", diagnose=False, level="INFO")

@logger.catch
def authenticate_user(username, password, api_key):
   # In development, you'll see all variable values if this crashes
   # In production, sensitive data stays hidden
   if not username or not password:
raise ValueError("Missing credentials")एक और शक्तिशाली फ़ीचर है लेज़ी इवैल्यूएशन, जो महंगे ऑपरेशन्स को लॉग करते समय परफ़ॉर्मेंस बेहतर करता है। कभी-कभी आप जटिल जानकारी लॉग करना चाहते हैं, लेकिन केवल तब जब सचमुच एरर हो:
from loguru import logger

@logger.catch
def process_large_dataset(data):
   try:
       # Some complex processing that might fail
       result = complex_calculation(data)
       return result
   except Exception as e:
       # This expensive operation only runs if there's an error
       logger.error("Processing failed with data: {data}",
                   data=lambda: expensive_data_summary(data))
       raise

def expensive_data_summary(data):
   # This function takes time to run, summarizing huge datasets
   return {"row_count": len(data), "columns": list(data.keys()), "memory_usage": data.memory_usage()}
lambda: सिन्टैक्स एक फ़ंक्शन बनाता है जो केवल तब कॉल होता है जब Loguru वास्तव में लॉग मैसेज लिखता है। यदि कोई एरर नहीं होता, तो expensive_data_summary() कभी नहीं चलता, जिससे प्रोसेसिंग समय बचता है।
आप अलग-अलग प्रकार के एरर्स के लिए अलग एक्सेप्शन हैंडलिंग रणनीतियाँ भी अपना सकते हैं:
from loguru import logger

# Configure multiple outputs for different error severities
logger.add("warnings.log", level="WARNING", filter=lambda record: record["level"].name == "WARNING")
logger.add("critical_errors.log", level="ERROR")

@logger.catch(level="ERROR")
def critical_database_operation(query):
   # Database errors get logged as ERROR level
   execute_database_query(query)

@logger.catch(level="WARNING", reraise=False)
def optional_feature(user_id):
   # Non-critical features log as WARNING and continue execution
   send_optional_notification(user_id)

def process_user_request(user_id, query):
   # Critical operation - if this fails, the whole request fails
   critical_database_operation(query)

   # Optional operation - if this fails, request continues
   optional_feature(user_id)
reraise=False पैरामीटर Loguru को एक्सेप्शन लॉग करने लेकिन उसे फिर से न उछालने को कहता है, जिससे आपका प्रोग्राम चलना जारी रखता है। यह उन वैकल्पिक फ़ीचर्स के लिए उपयोगी है जिन्हें आपकी मुख्य वर्कफ़्लो को नहीं तोड़ना चाहिए।
आइए एक पूरा उदाहरण देखें जिसमें फ़ाइल प्रोसेसिंग सिस्टम अलग-अलग प्रकार के एरर्स को सलीके से हैंडल करता है:
from loguru import logger
import os

# Set up environment-aware logging
if os.getenv("DEBUG"):
   logger.add("file_processor.log", diagnose=True, level="DEBUG")
else:
   logger.add("file_processor.log", diagnose=False, level="INFO")

@logger.catch(reraise=False)
def validate_file_format(filename):
   if not filename.endswith(('.csv', '.json', '.xml')):
       raise ValueError(f"Unsupported file format: {filename}")

@logger.catch
def load_file_data(filename):
   logger.info("Loading file: {}", filename)

   # Expensive operation only logged on errors
   logger.debug("File stats: {stats}",
               stats=lambda: {"size": os.path.getsize(filename),
                             "modified": os.path.getmtime(filename)})

   with open(filename, 'r') as f:
       return f.read()

def process_files(file_list):
   results = []

   for filename in file_list:
       # Validation errors are logged but don't stop processing
       validate_file_format(filename)

       try:
           # Loading errors are logged and do stop processing this file
           data = load_file_data(filename)
           results.append(data)
           logger.success("Successfully processed {}", filename)
       except Exception:
           logger.error("Skipping file {} due to loading error", filename)
           continue

   return results
यह सेटअप आपको ऑटोमेटिक एक्सेप्शन कैप्चर, ज़रूरत पड़ने पर विस्तृत एरर कॉन्टेक्स्ट, और अलग-अलग प्रकार के एरर्स के लिए अलग हैंडलिंग रणनीतियाँ देता है। आपके लॉग डिबगिंग के लिए कहीं ज़्यादा उपयोगी बनते हैं, जबकि आपका कोड साफ़ और पढ़ने योग्य रहता है।
जैसे-जैसे आपके ऐप्लिकेशन्स बढ़ते हैं, आपको ऐसे परिदृश्य मिलेंगे जहाँ Loguru के डिफ़ॉल्ट बिल्कुल फिट नहीं बैठते। हो सकता है आपको बिज़नेस मेट्रिक्स के लिए कोई विशेष लॉग लेवल चाहिए, लॉग्स से संवेदनशील डेटा फ़िल्टर करना हो, या एरर्स पर Slack को अलर्ट भेजने की ज़रूरत हो।
अच्छी बात यह है कि Loguru को उसकी सादगी खोए बिना कस्टमाइज़ किया जा सकता है। आप इसे ऐसे तरीक़ों से बढ़ा सकते हैं जिनके लिए पारंपरिक लॉगिंग सिस्टम में जटिल कॉन्फ़िगरेशन चाहिए होता, और फिर भी आपका कोड साफ़ और पढ़ने योग्य रहता है।
आइए उन सबसे उपयोगी कस्टमाइज़ेशन्स पर नज़र डालें जो प्रोडक्शन ऐप्लिकेशन्स में आने वाली वास्तविक समस्याओं को हल करते हैं।
Loguru INFO, DEBUG, और ERROR जैसे स्टैंडर्ड लेवल्स के साथ आता है। लेकिन कभी-कभी आपको अपने ऐप्लिकेशन के लिए कुछ विशिष्ट चाहिए। शायद आप परफ़ॉर्मेंस मेट्रिक्स या बिज़नेस इवेंट्स के लिए विशेष लेवल चाहते हैं।
कस्टम लॉग लेवल्स बनाना सरल है:
from loguru import logger

# Add a custom level for business metrics
logger.level("METRIC", no=38, color="<yellow>", icon="📊")

# Add a custom level for security events
logger.level("SECURITY", no=45, color="<red><bold>", icon="🔒")

# Now you can use these levels
logger.log("METRIC", "Order completed in {} seconds", 2.5)
logger.log("SECURITY", "Failed login attempt from IP: {}", "192.168.1.100")
no पैरामीटर लेवल की प्राथमिकता सेट करता है (बड़ा नंबर = अधिक प्राथमिकता)। स्टैंडर्ड लेवल्स: DEBUG=10, INFO=20, WARNING=30, ERROR=40, CRITICAL=50।
इसे मशीन लर्निंग ट्रेनिंग के परिदृश्य में देखते हैं:
from loguru import logger

# Set up custom levels for ML tracking
logger.level("EPOCH", no=35, color="<cyan><bold>")
logger.level("CHECKPOINT", no=38, color="<green><bold>")

# Configure output
logger.remove()
logger.add("training_{time:YYYY-MM-DD}.log", level="INFO")

def train_model(model, data_loader, epochs=10):
   logger.info("Starting training with {} epochs", epochs)

   for epoch in range(epochs):
       # Log epoch progress with custom level
       logger.log("EPOCH", "Epoch {}/{} started", epoch + 1, epochs)

       # Training logic here
       loss = 0.523 - (epoch * 0.05)  # Simulated improving loss
       accuracy = 0.72 + (epoch * 0.03)  # Simulated improving accuracy

       logger.info("Loss: {:.4f}, Accuracy: {:.2%}", loss, accuracy)

       # Save checkpoint every 5 epochs
       if (epoch + 1) % 5 == 0:
           logger.log("CHECKPOINT", "Model saved at epoch {}", epoch + 1)

logger.success("Training completed!")कभी-कभी आपको लॉग मैसेजेज़ को लिखे जाने से पहले संशोधित करने की ज़रूरत होती है। सामान्य उपयोग मामलों में संवेदनशील डेटा हटाना, रिक्वेस्ट IDs जोड़ना, या किसी विशेष टूल के लिए मैसेजेज़ को रीफ़ॉर्मैट करना शामिल है।
Loguru आपको filter पैरामीटर का उपयोग करके मैसेजेज़ इंटरसेप्ट करने देता है:
from loguru import logger
import re

def hide_sensitive_data(record):
   # Hide credit card numbers
   record["message"] = re.sub(r'\b\d{4}[\s-]?\d{4}[\s-]?\d{4}[\s-]?\d{4}\b',
                             'XXXX-XXXX-XXXX-XXXX',
                             record["message"])

   # Hide email addresses
   record["message"] = re.sub(r'\b[\w.-]+@[\w.-]+\.\w+\b',
                             '***@***.***',
                             record["message"])

   # Continue processing the log
   return True

# Add the filter to your logger
logger.add("secure.log", filter=hide_sensitive_data)

# Test it
logger.info("User paid with card 4532-1234-5678-9012")
logger.info("Contact email: john.doe@example.com")
आप फ़िल्टर्स का उपयोग संदर्भात्मक जानकारी जोड़ने के लिए भी कर सकते हैं:
from loguru import logger
import threading

def add_thread_info(record):
   # Add thread name to every log message
   record["extra"]["thread_name"] = threading.current_thread().name
   return True

def add_environment_info(record):
   # Add environment to production logs
   record["extra"]["env"] = "production"
   record["extra"]["region"] = "us-west-2"
   return True

# Apply multiple filters
logger.add(
   "app.log",
   filter=lambda record: add_thread_info(record) and add_environment_info(record),
   format="{time} | {extra[env]} | {extra[thread_name]} | {message}"
)सिंक वह जगह है जहाँ आपके लॉग्स बहते हैं। जबकि फ़ाइलें और कंसोल आम हैं, आपको अक्सर लॉग्स को Slack, ईमेल या मॉनिटरिंग सिस्टम जैसी बाहरी सेवाओं पर भेजने की ज़रूरत पड़ती है।
यहाँ दिखाया गया है कि एरर्स को Slack पर भेजने वाला कस्टम सिंक कैसे बनाया जाए:
from loguru import logger
import requests

def send_to_slack(message):
   """Custom sink that sends messages to Slack"""
   # Parse the log record
   record = message.record

   # Only send errors and above
   if record["level"].no < 40:  # ERROR level is 40
       return

   # Format message for Slack
   slack_message = {
       "text": f"🚨 {record['level'].name}: {record['message']}",
       "attachments": [{
           "color": "danger",
           "fields": [
               {"title": "Time", "value": str(record["time"]), "short": True},
               {"title": "Function", "value": record["function"], "short": True},
               {"title": "File", "value": f"{record['file'].name}:{record['line']}", "short": False}
           ]
       }]
   }

   # Send to Slack webhook
   webhook_url = "https://hooks.slack.com/services/YOUR/WEBHOOK/URL"
   requests.post(webhook_url, json=slack_message)

# Add the custom sink
logger.add(send_to_slack, level="ERROR")

# Test it
logger.error("Database connection lost!")
यहाँ एक और व्यावहारिक उदाहरण है—एक कस्टम सिंक जो आपके ऐप्लिकेशन रन के दौरान परफ़ॉर्मेंस मेट्रिक्स इकट्ठा करता है और उन्हें विश्लेषण के लिए सेव कर देता है:
from loguru import logger
from collections import defaultdict
import json

class MetricsCollector:
   def __init__(self):
       self.metrics = defaultdict(list)

   def __call__(self, message):
       """This method is called for every log message"""
       record = message.record

       # Only process METRIC level logs
       if record["level"].name != "METRIC":
           return

       # Extract metric data from the 'extra' fields
       extra = record["extra"]
       if "metric_name" in extra and "value" in extra:
           self.metrics[extra["metric_name"]].append({
               "value": extra["value"],
               "timestamp": record["time"].timestamp()
           })

   def save_metrics(self):
       """Save all collected metrics to a JSON file"""
       with open("metrics.json", "w") as f:
           json.dump(dict(self.metrics), f, indent=2)

# Create the collector and add it as a sink
collector = MetricsCollector()
logger.add(collector)

# Create the METRIC level
logger.level("METRIC", no=38)

# Now when you log metrics, they're automatically collected
# The bind() method attaches extra data to the log entry
logger.bind(metric_name="response_time", value=0.234).log("METRIC", "API response")
logger.bind(metric_name="response_time", value=0.189).log("METRIC", "API response")
logger.bind(metric_name="active_users", value=1523).log("METRIC", "User count")

# Later, save all metrics to file
collector.save_metrics()

# The metrics.json file will contain:
# {
#   "response_time": [
#     {"value": 0.234, "timestamp": 1627...},
#     {"value": 0.189, "timestamp": 1627...}
#   ],
#   "active_users": [
#     {"value": 1523, "timestamp": 1627...}
#   ]
# }
इस तरीक़े की खूबी यह है कि आपका ऐप्लिकेशन कोड साफ़ रहता है—आप बस सामान्य रूप से मेट्रिक्स लॉग करते हैं, और कलेक्टर सिंक अपने-आप स्टोरेज संभाल लेता है। आप इसे आसानी से ऐसे सिंक से बदल सकते हैं जो मेट्रिक्स को Prometheus, DataDog, या किसी अन्य मॉनिटरिंग सेवा पर भेजे।
ये कस्टमाइज़ेशन्स आपको अपनी विशिष्ट ज़रूरतों के अनुसार Loguru को ढालने की लचीलापन देते हैं, जबकि इसकी सादगी बरक़रार रहती है। चाहे आप छोटा स्क्रिप्ट बना रहे हों या बड़ा ऐप्लिकेशन, आप बिना जटिल कॉन्फ़िगरेशन फ़ाइलों या बोइलरप्लेट कोड के, Loguru को अपनी यूनिक लॉगिंग आवश्यकताओं के लिए बढ़ा सकते हैं।
Loguru Python में लॉगिंग को उतना ही सरल बना देता है जितना होना चाहिए। न कोई कॉन्फ़िगरेशन फ़ाइलें, न हैंडलर सेटअप, न बोइलरप्लेट कोड। बस इम्पोर्ट करें और रंगों, टाइमस्टैम्प और ऑटोमेटिक फ़ाइल रोटेशन के साथ लॉगिंग शुरू करें।
आपने देखा कि यह आम समस्याओं को कैसे संभालता है: लॉग्स को फ़ाइलों में सेव करना, उन्हें अपने-आप रोटेट करना, फुल कॉन्टेक्स्ट के साथ एक्सेप्शन कैप्चर करना, और लॉग्स को बाहरी सेवाओं पर भेजना। स्ट्रक्चर्ड लॉगिंग फ़ीचर्स इसे प्रोडक्शन-रेडी बनाते हैं, जबकि कस्टम लेवल्स और सिंक इसे किसी भी उपयोग केस के लिए अनुकूल बना देते हैं।
Loguru का उपयोग करें जब:
गहन सीखने के लिए, आधिकारिक डोक्युमेंटेशन के साथ-साथ यह लॉगिंग ट्यूटोरियल देखें, जो Python लॉगिंग रणनीतियों का व्यापक कवरेज देता है।
छोटे से शुरू करें। एक प्रिंट स्टेटमेंट को logger.info() से बदल दें। आप फिर पीछे नहीं मुड़ेंगे।
शीर्ष DataCamp कोर्स
लर्निंग पाथ
लर्निंग पाथ
कोर्स