
Last chance! 50% off DataCamp Premium
Sale ends in
微软的 MAI 模型家族由 Microsoft AI Superintelligence 团队打造。这些模型完全由微软内部研发,基于微软自有基础设施训练、为微软的服务栈优化,并通过 Azure 直接部署。MAI-Transcribe-1 和 MAI-Voice-1 运行在同一套已经为企业客户大规模服务的 Azure Speech 基础设施上;而 MAI-Image-2 采用与 Stable Diffusion 3 相同训练目标的 flow-matching diffusion 架构,非嵌入参数规模在 100 亿至 500 亿之间。
以下是三者的快速概览:
|
模型 |
任务 |
关键指标 |
价格 |
|
MAI-Transcribe-1 |
语音转文本 |
FLEURS 上平均 WER 3.88% |
$0.36/小时 |
|
MAI-Voice-1 |
文本转语音 |
1 秒生成 60 秒音频 |
$22/100 万字符 |
|
MAI-Image-2 |
文本转图像 |
总体 Elo 1190 |
$5/100 万文本 tokens + $33/100 万图像 tokens |
在开始构建之前,让我们逐一深入了解。
MAI-Transcribe-1 是支持 25 种语言的语音转文本模型。其核心指标是在 FLEURS 基准上的平均词错误率(WER)为 3.88%(越低越好),领先于 GPT-Transcribe(4.17%)、Scribe v2(4.32%)、Gemini 3.1 Flash-Lite(4.89%)和 Whisper-large-v3(7.60%)。
该模型专为嘈杂现实环境音频而构建,适应噪声场景、混合口音和自然说话风格。微软还称,MAI-Transcribe-1 在保持良好准确率的同时,其 GPU 成本约为领先替代方案的 50%,这对大规模转写的企业尤具意义。
不过,它仍不支持实时转写、说话人分离和上下文偏置,这些功能均标注为“即将推出”。
MAI-Voice-1 是微软的高保真 TTS 模型。其关键能力是语音提示:您提供 10 秒的音频样本,模型即可在无需微调的情况下克隆该声音。不过,语音克隆需要通过微软的门控审批,但经过筛选的声音库(如 en-us-Jasper:MAI-Voice-1、en-us-June:MAI-Voice-1 等)可立即使用。
该模型能在单块 GPU 上用 1 秒时间生成 60 秒音频,支持通过 SSML 进行逐轮情感控制,并面向有声书、播客等长内容而设计。它已经为微软自家产品中的 Copilot Audio Expressions 和播客功能提供支持。
该模型的一个不足在于目前“仅支持英语”,其他 10 多种语言即将推出。
MAI-Image-2 采用 flow-matching diffusion 架构,参数规模为 100–500 亿。它在 Arena.ai 的图像榜单中位列前三,且在生产中比 MAI-Image-1 快两倍。该模型与摄影师、设计师和视觉叙事者协作开发,已部署于 Copilot、Bing Image Creator 和 PowerPoint 中,特别侧重于照片级真实感、准确的肤色以及清晰可辨的图中字幕。
其按类别的 Elo 分数包括真实照片(1201)和人像(1201),表现尤为突出;而文本渲染(1186)虽然较先前提升,但仍是相对薄弱的类别。
三款 MAI 模型均可在 Microsoft Azure 上获取。MAI-Transcribe-1 和 MAI-Voice-1 共用同一Azure Speech 资源,而 MAI-Image-2 通过Microsoft Foundry 运行。我们分别进行设置。
MAI-Transcribe-1 与 MAI-Voice-1 通过 Azure AI Speech 服务访问,因此一个资源即可覆盖两者。
在搜索栏中输入 Speech 并选择 Speech services
点击 + Create
填写表单:
资源组:创建新资源组并命名为 mai-demo-rg
区域: 选择 East US,因为 MAI 模型当前仅支持 East US 和 West US
名称: mai-speech-demo
定价层: Standard S0
注意: 免费的 F0 有速率限制,可能影响演示
最后点击 Review and create,等待加载后点击 Create。
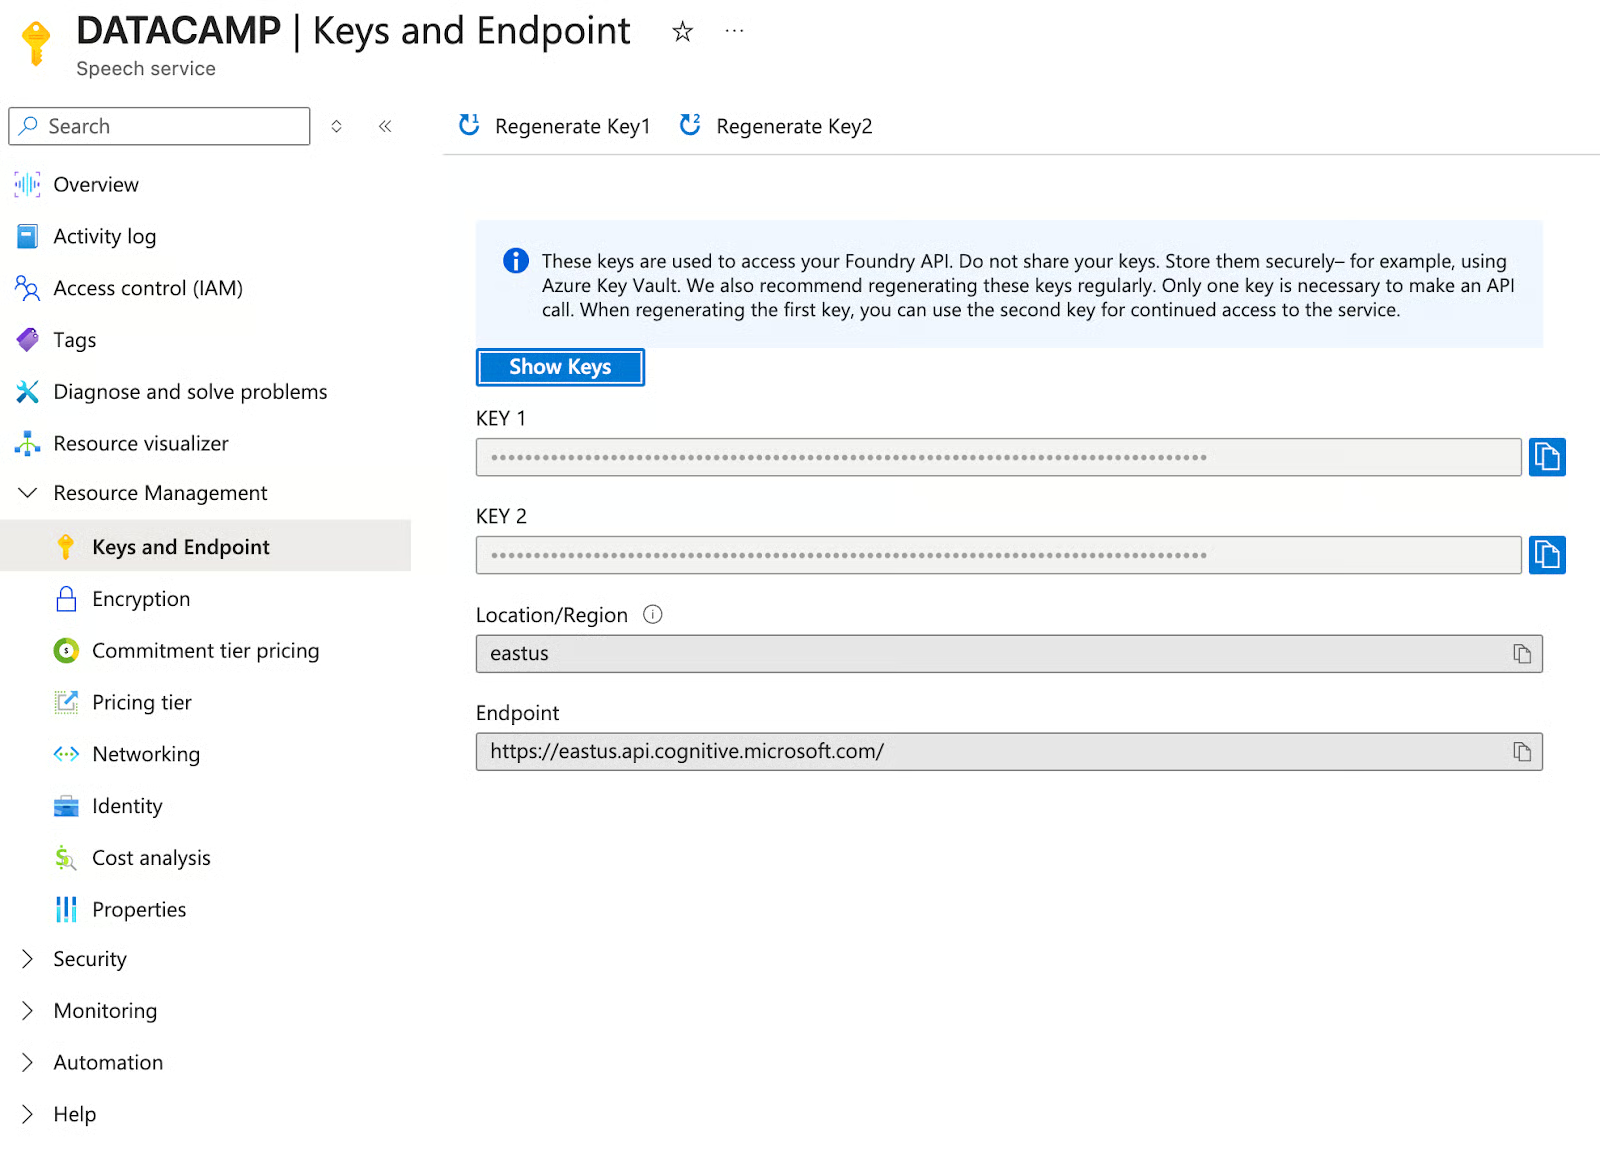
部署完成后,前往左侧边栏的 Keys and Endpoint,复制 Key 1 并记录 Region 值(eastus)。
MAI-Image-2 通过Microsoft Foundry 访问,与常规 Azure 门户分离。
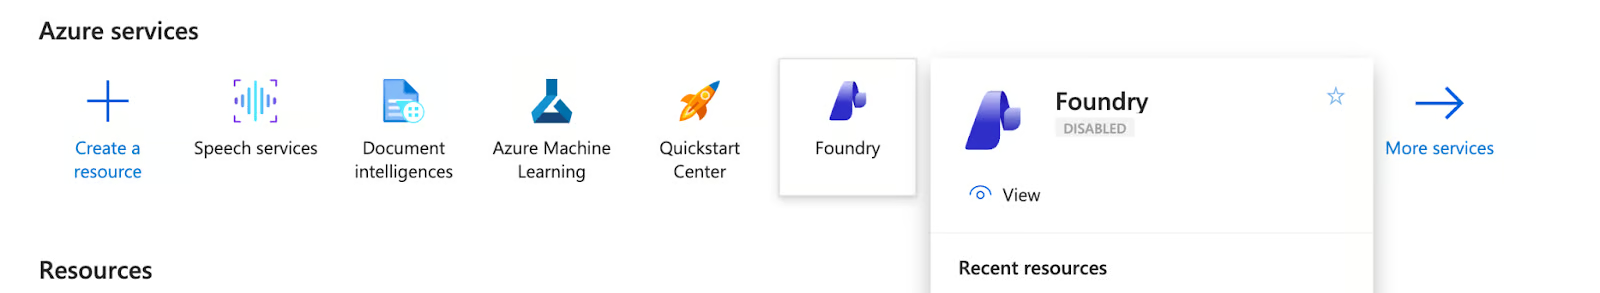
在 Azure 门户首页,点击顶部服务行中的 Foundry
点击 Create a resource
然后填写如下信息:
资源组:选择步骤 1 中的同一 mai-demo-rg
区域:East US
名称:mai-image-demo
默认项目名称: proj-default
随后点击 Review and create,然后点击 Create
资源创建完成后,点击 Go to Foundry portal。
接着在 Foundry 界面,点击左侧边栏的 Model catalog
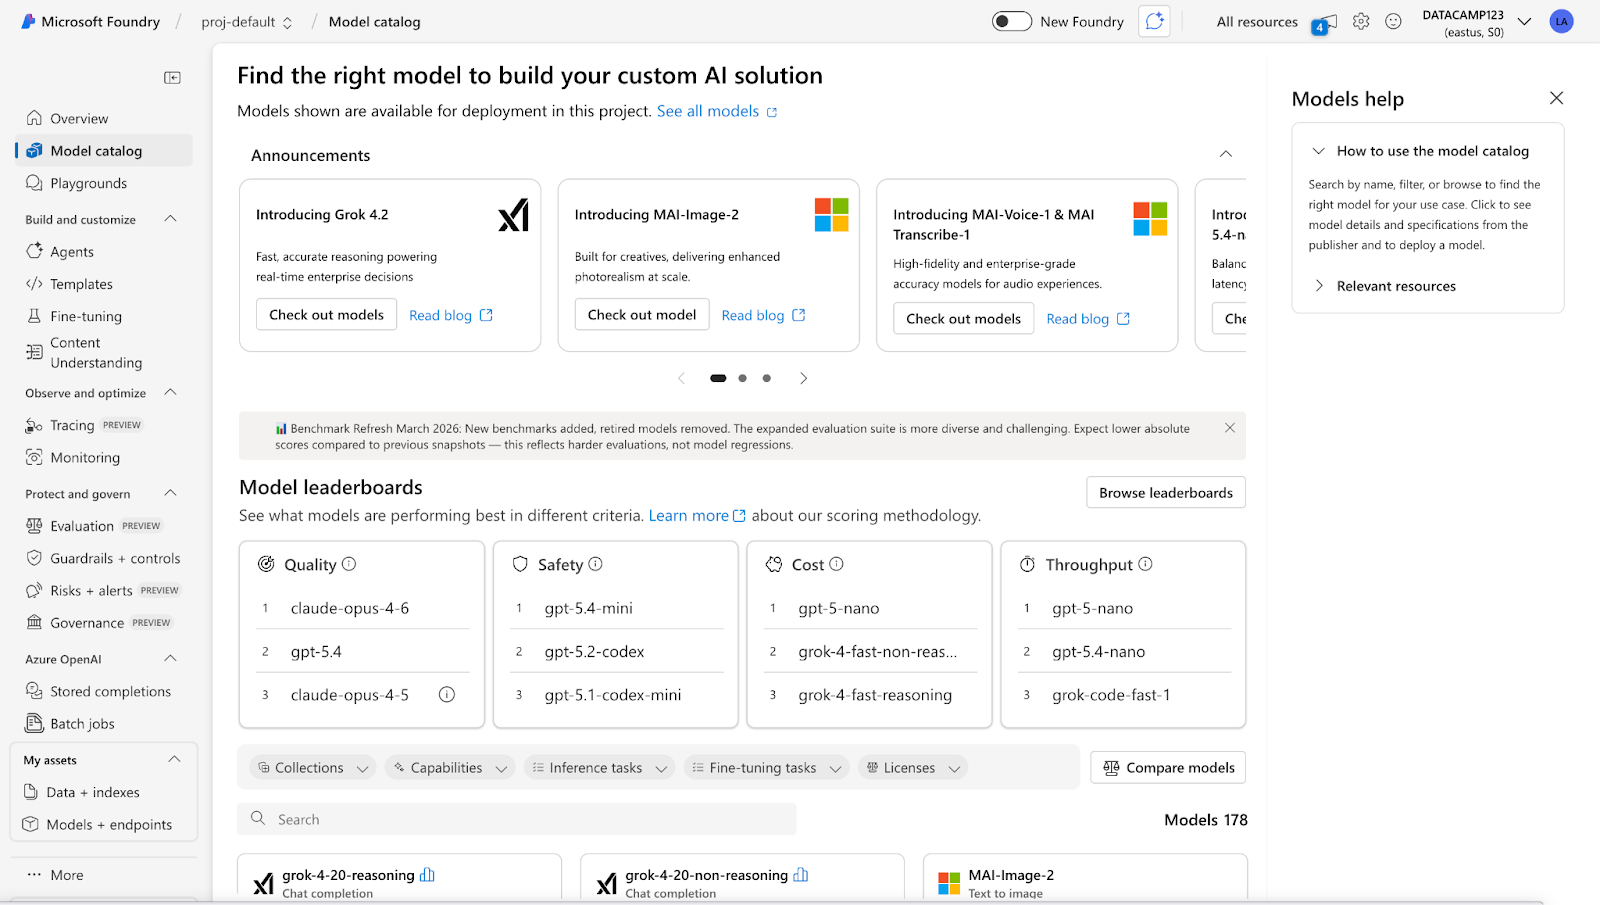
MAI,您将看到四款 MAI 模型的列表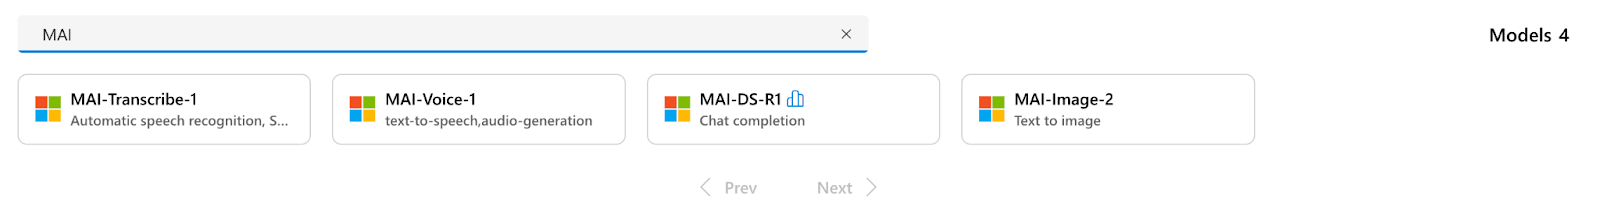
选择 MAI-Image-2 并点击 Use this model
在部署对话框中设置:
部署名称:MAI-Image-2
部署类型:Global Standard
最后点击deploy
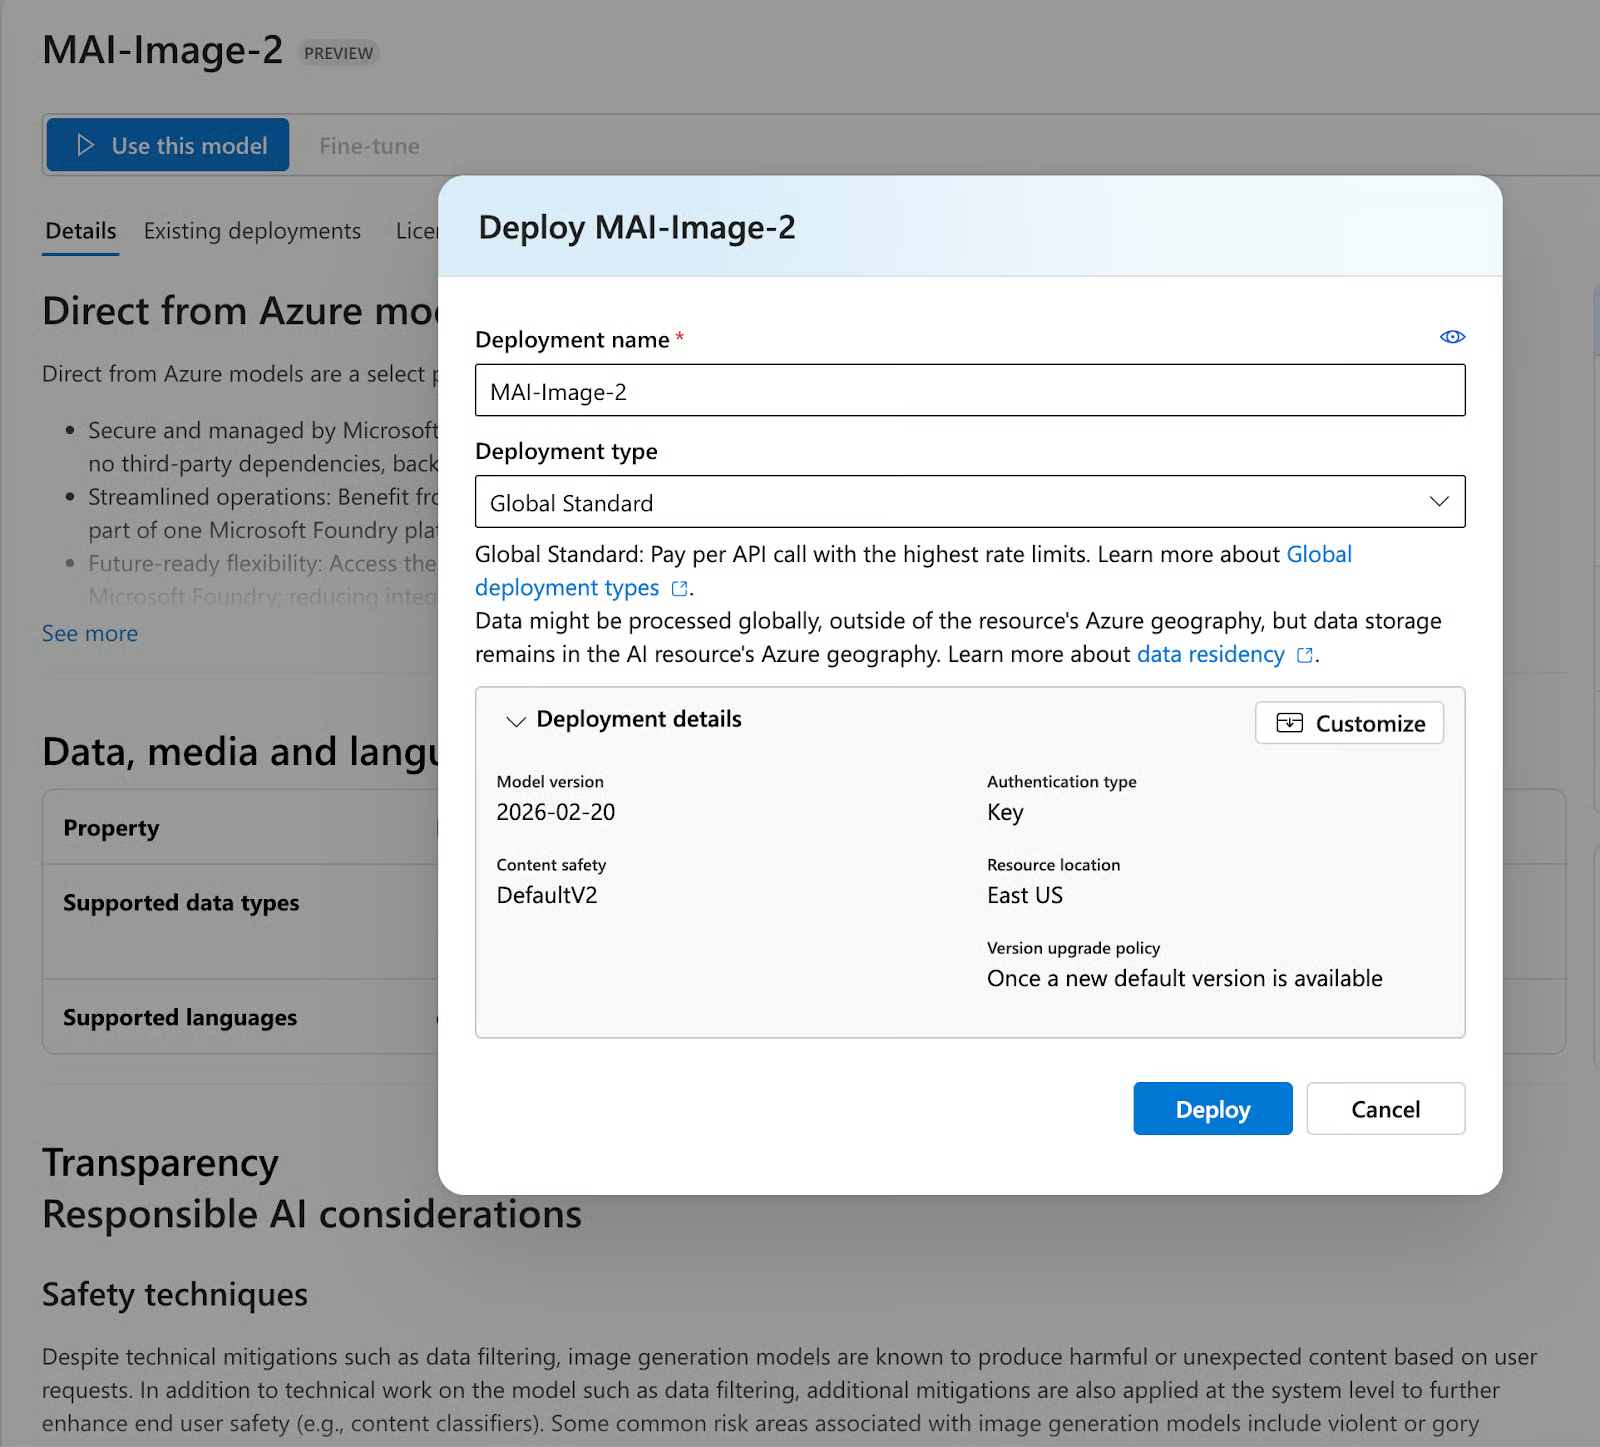
部署完成后,您将进入部署详情页。复制 Target URI(类似 https://mai-image-demo.services.ai.azure.com/models)和 Key。
在本地项目目录中创建 .env 文件,并加入前两步获取的内容:
AZURE_SPEECH_KEY=your_speech_key_1_here
AZURE_SPEECH_REGION=eastus
AZURE_IMAGE_ENDPOINT=https://your-resource-name.services.ai.azure.com/models
AZURE_IMAGE_KEY=your_foundry_key_here
AZURE_IMAGE_DEPLOYMENT=MAI-Image-2重要提示:AZURE_IMAGE_DEPLOYMENT 区分大小写。请与 Foundry 中显示的 MAI-Image-2 完全一致,使用小写 mai-image-2 将返回 unknown_model 错误。
本节我们将构建一个包含三个标签页的 Streamlit 应用,通过实时 Azure API 调用三款 MAI 模型。应用的高层逻辑如下:
文件结构如下:
mai_demo/
├── app.py            # Streamlit UI
├── mai_clients.py    # Azure API wrappers
├── requirements.txt
└── .env应用分为两个文件:mai_clients.py 负责所有 Azure API 调用并返回结构化结果字典,app.py 负责 Streamlit 界面。让我们按步骤构建。
不同于本地模型设置,本应用连接实时 Azure 云 API,因此依赖列表既包含 Azure Speech SDK,也包含 HTTP 与图像处理库。
pip install -r requirements.txtrequirements.txt 文件内容:
.txt
streamlit>=1.35.0
azure-cognitiveservices-speech>=1.38.0
requests>=2.31.0
pillow>=10.0.0
python-dotenv>=1.0.0
openai>=1.30.0
本项目将使用:
streamlit 用于三标签页 UI、文件上传、音频播放与内联图像渲染
azure-cognitiveservices-speech 提供 Azure Speech SDK,用于与 MAI-Transcribe-1 和 MAI-Voice-1 通信
requests 向三个 Azure 端点发起直接 REST API 调用
pillow 解码并显示 MAI-Image-2 返回的图像字节
python-dotenv 在运行时从 .env 文件加载 Azure 密钥与端点 URL
openai 用作兼容 Azure OpenAI 的 SDK,支持 Foundry 图像生成端点
安装完成后,请确保 .env 文件与 app.py 位于同一目录。所有凭据会在启动时通过 python-dotenv 自动加载。
所有 Azure API 调用均在 mai_clients. py ' 中实现,每个函数返回一个简洁的 {"success": bool, ...}` 字典,以避免 UI 层在出错时崩溃。
MAI-Transcribe-1 通过 Azure Speech REST API 的 LLM Speech 端点访问。关键点在于它接收 multipart 表单请求,包含音频文件与一个 JSON 定义对象。
def transcribe_audio(audio_bytes: bytes, filename: str = "audio.wav") -> dict:
    url = (
        f"https://{speech_region}.api.cognitive.microsoft.com"
        f"/speechtotext/transcriptions:transcribe?api-version=2024-11-15"
    )
    headers = {"Ocp-Apim-Subscription-Key": speech_key}
    definition = '{"locales":["en-US"],"profanityFilterMode":"None"}'
    files = {
        "audio": (filename, audio_bytes, _mime_type(filename)),
        "definition": (None, definition, "application/json"),
    }
    resp = requests.post(url, headers=headers, files=files, timeout=60)
    data = resp.json()
    combined = " ".join(
        p.get("text", "") for p in data.get("combinedPhrases", [])
    ).strip()
    return {"success": True, "transcript": combined, "raw": data, ...}
上述代码返回的响应是一个包含 combinedPhrases 的 JSON 对象,该字段为文本片段数组。我们将其拼接为单一的转写字符串。支持的音频格式包括 WAV、MP3 和 FLAC。该 API 目前仅限 East US 与 West US 区域。
MAI-Voice-1 使用标准的 Azure Speech TTS(通过 SSML)。关键在于构造 <mstts:express-as> 块以控制情感,并引用正确的发音人名称格式(en-us-Jasper:MAI-Voice-1)。
def _build_ssml(text: str, emotion: str, voice_name: str) -> str:
    style_map = {
        "neutral": None,
        "joy": "joy",
        "excitement": "excitement",
        "empathy": "empathy",
    }
    style = style_map.get(emotion)
    text_block = (
        text if style is None
        else f"<mstts:express-as style='{style}'>{text}</mstts:express-as>"
    )
    return f"""<speak version='1.0' xml:lang='en-US'
        xmlns='http://www.w3.org/2001/10/synthesis'
        xmlns:mstts='http://www.w3.org/2001/mstts'>
      <voice name='{voice_name}'>
        {text_block}
      </voice>
    </speak>"""
MAI-Voice-1 可用的发音人名称遵循 en-us-{Name}:MAI-Voice-1 格式。目前包含 Jasper、June、Grant、Iris、Reed 和 Joy。
MAI-Image-2 使用 Foundry 专用端点,而不是标准的 Azure OpenAI /openai/deployments/ 路径。正确的端点格式为:
url = f"{base_endpoint}/mai/v1/images/generations"这里 base_endpoint 是 Foundry 资源 URL 的根(例如 https://your-resource.services.ai.azure.com),构造请求前需要去掉末尾的 /models。请求体有两点要求:首先,必须显式传入 model 字段并设置为部署名称,这与标准 OpenAI 端点不同(后者通常从 URL 路径推断模型):
payload = { "model": deployment, # "MAI-Image-2" "prompt": prompt, "width": width, "height": height, }其次,图像尺寸有硬性约束:width 与 height 至少为 768 像素,且两者乘积不得超过 1,048,576;对于正方形图像,最大为 1024×1024。传入 512×512 或省略尺寸将返回 400 Bad Request。
响应遵循标准的 OpenAI 图像生成结构。data 数组中的每一项包含一个指向已托管图像的 url,或包含原始 base64 编码字节的 b64_json 字段。客户端需同时兼容两种返回:
image_url = row.get("url")
b64 = row.get("b64_json")
if b64:
    img_bytes = base64.b64decode(b64)
elif image_url:
    img_resp = requests.get(image_url, timeout=30)
img_bytes = img_resp.content注意:url 响应具有时效性,因此需要立即拉取并缓存字节数据,而不是仅保存 URL 供后续使用。
应用按模型划分为三个标签页。结构如下:
import streamlit as st
from mai_clients import transcribe_audio, synthesize_speech, generate_image
tab1, tab2, tab3 = st.tabs([
    "🎙 MAI-Transcribe-1",
    "🔊 MAI-Voice-1",
    "🖼 MAI-Image-2",
])
每个标签页遵循相同模式:输入 → 按钮 → 加载动画 → 结果展示 → 成本指标。
第一个标签页用于音频上传与转写。它接受 WAV、MP3 和 FLAC 文件,支持内联播放以便核对测试内容,并在点击按钮后将字节直接传给 transcribe_audio()。
with tab1:
    audio_file = st.file_uploader("Upload audio file", type=["wav", "mp3", "flac"])
    if audio_file:
        st.audio(audio_file)
        if st.button("Transcribe", type="primary"):
            with st.spinner("Calling MAI-Transcribe-1..."):
                result = transcribe_audio(audio_file.read(), audio_file.name)
            if result["success"]:
                st.text_area("Transcript", value=result["transcript"], height=140)
                m1, m2, m3 = st.columns(3)
                m1.metric("Latency", f"{result['latency_s']}s")
                m2.metric("Audio duration", f"{result['duration_ms']/1000:.1f}s")
                m3.metric("Est. cost", f"${result['duration_ms']/3_600_000 * 0.36:.5f}")
调用成功后,转写文本将显示在可编辑文本区域,随后展示三项指标:API 延迟(秒)、从响应的 durationMilliseconds 字段提取的音频时长,以及按 duration_in_hours × $0.36 计算的预估成本。
一个 7 秒音频的成本约为 $0.0000007,足以让您多次测试而几乎不消耗 Azure 额度。
第二个标签页负责文本转语音合成。它提供三项最关键的测试控件:文本输入、情感风格与发音人选择,这些都会直接传入 synthesize_speech() 函数。
with tab2:
    text_input = st.text_area("Text to synthesize", value="The quarterly results exceeded...")
    emotion = st.selectbox("Emotion / style", ["neutral", "joy", "excitement", "empathy"])
    voice_name = st.selectbox("Voice", ["en-us-Jasper:MAI-Voice-1", "en-us-June:MAI-Voice-1", ...])
    if st.button("Synthesize", type="primary"):
        with st.spinner("Calling MAI-Voice-1..."):
            result = synthesize_speech(text_input, emotion=emotion, voice_name=voice_name)
        if result["success"]:
            st.audio(result["audio_bytes"], format="audio/mp3")
情感选择器在底层映射为 SSML 的 <mstts:express-as> 样式;neutral 将完全省略该标签以获得干净的基线输出,而 joy、excitement 与 empathy 会呈现明显差异的语速与音高曲线。发音人下拉框覆盖当前的六种 MAI-Voice-1 声音:Jasper、June、Grant、Iris、Reed 和 Joy。
成功后,返回的 MP3 字节会直接传给 st.audio() 内联播放。以 113 个字符为例,预估成本约 $0.000002,足以多次测试而不明显消耗额度。
第三个标签页用于文本转图像。MAI-Image-2 当前 API 暴露两个输入参数:提示词与分辨率。没有质量档位或风格控制,模型会在内部处理。
with tab3:
    prompt = st.text_area("Image prompt", value="A worn paperback book on a café table...")
    size = st.selectbox("Resolution", ["1024x1024", "1365x768", "768x1365"])
    if st.button("Generate", type="primary"):
        with st.spinner("Calling MAI-Image-2..."):
            result = generate_image(prompt, size=size)
        if result["success"]:
            img = Image.open(io.BytesIO(result["image_bytes"]))
            st.image(img, use_container_width=True)
这三种分辨率覆盖主要纵横比:正方形(1024×1024)、横向(1365×768)与纵向(768×1365)。大小字符串会被解析为宽高整数再传给 API,因为 Foundry 端点要求分别提供宽与高字段,而非合并字符串。
成功后,将 API 响应中的原始图像字节包装为 BytesIO 缓冲区,用 Pillow 打开,并以容器全宽内联渲染。图像生成通常需 2–4 秒,显著快于同环境下的 MAI-Image-1。
配置好 .env 且安装依赖后,即可运行应用。
streamlit run app.pyStreamlit 将启动本地服务器并自动在浏览器打开应用,地址为 http://localhost:8501。您应能看到三个标签页的界面,默认激活 MAI-Transcribe-1。
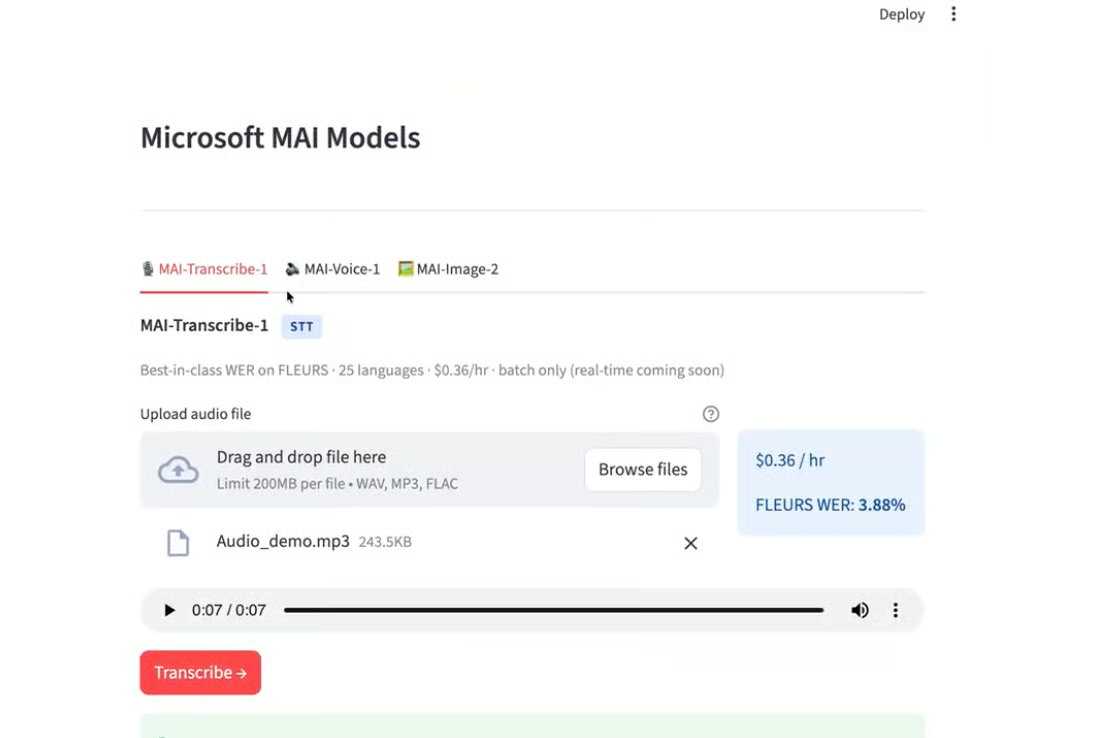
以下为我们实际运行模型时的产出。
我用一段 7 秒音频测试了 MAI-Transcribe-1,录制环境为有意制造的噪声场景,口音为印度口音。模型在 2 秒内返回了干净且准确的转写。
结论:在带口音的语音上表现稳健,而这恰是 Whisper-large-v3 往往最吃力的场景。不过,分语言的数据表现不同,例如阿拉伯语为 10.1%,丹麦语为 13.2%,均显著高于头部平均值。如果您的用例涉及特定语言或地区口音分布,请务必用真实音频进行测试,再决定是否在生产中采用该模型。
我使用 en-us-Jasper:MAI-Voice-1 发音人,以 excitement 风格合成了一句 113 个字符的句子,模型在 1 秒内返回了 6 秒的 MP3。输出中的情感明显更强,语速更有活力,音高变化更大。
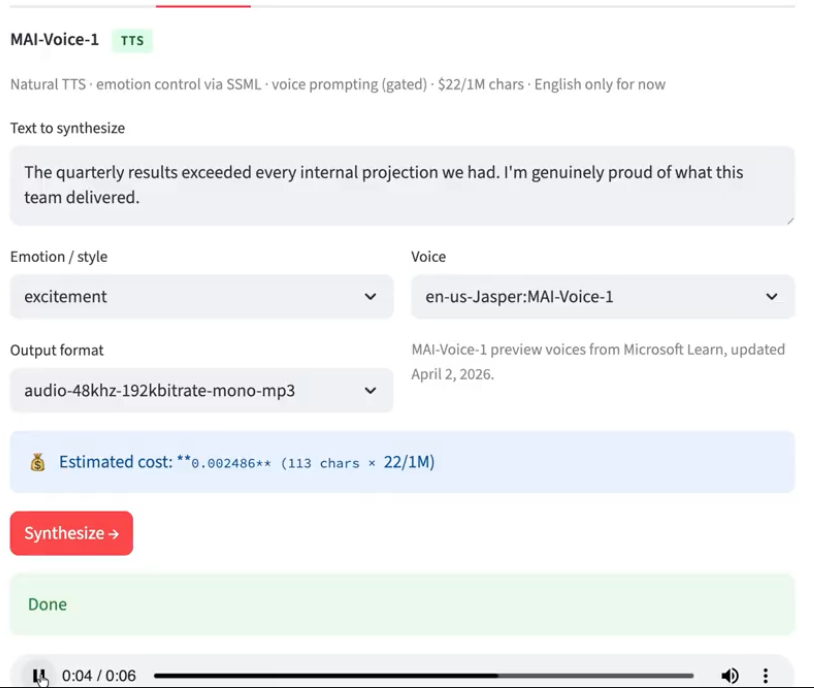
结论:在 1 秒内生成 6 秒音频相当亮眼。SSML 情感控制有效,但仅限四种风格:neutral、joy、excitement 和 empathy。因此不要指望能达到 ElevenLabs 风格库那样的丰富表达。
这是最有意思的测试,因为我有意选择了一个同时包含两项挑战的提示词:照片级场景构图与图中可读文字。多数扩散模型至少会在其中一项上失手。
提示词: "A worn paperback book on a café table, natural window light, steam rising from an espresso cup beside it. The book cover reads: INFERENCE AT SCALE — text clearly legible, not warped."
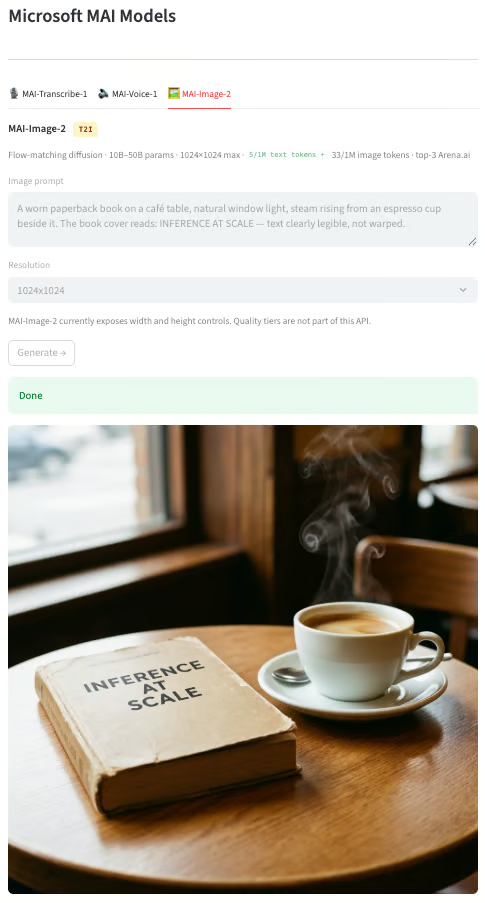
结论:照片级真实感确实很强,自然的窗光、逼真的蒸汽,以及书本与咖啡杯的可信质感都表现出色。文本 "INFERENCE AT SCALE" 也被正确、清晰地渲染了出来。
不过,文本渲染在不同次生成间仍不稳定。在多次使用相似提示的测试中,模型偶尔会拼写错误或出现乱码。这是所有现有扩散模型的已知失效模式;MAI-Image-2 表现优于多数同类,但并非免疫。此外,当前最大分辨率为 1024×1024 像素,对于大多数 Web 与内容场景已足够,但若不经放大步骤,将无法直接用于印刷或大幅面创意输出。若您生成的图像中文本准确性至关重要,请务必增加人工审阅环节。
微软的 MAI 模型家族整体表现出色,其中 MAI-Transcribe-1 在 FLEURS 上的指标最具可验证性:平均 WER 3.88% 截至撰文时属于同类最佳。
MAI-Voice-1 在速度与音质上令人印象深刻,但受限于仅支持英语与有限的情感样式。MAI-Image-2 能产出强烈的照片级真实感,但需注意文本幻觉仍会发生,上线时应配成人工审核。
本教程的完整代码已发布在 GitHub。
