

Các mô hình MAI của Microsoft là gì?
Họ mô hình MAI của Microsoft được xây dựng bởi đội Microsoft AI Superintelligence. Đây là các mô hình nội bộ hoàn toàn, được huấn luyện trên hạ tầng của Microsoft, tối ưu cho ngăn xếp phục vụ của Microsoft và triển khai trực tiếp qua Azure. MAI-Transcribe-1 và MAI-Voice-1 chạy trên cùng hạ tầng Azure Speech vốn đã phục vụ khách hàng doanh nghiệp ở quy mô lớn, trong khi MAI-Image-2 sử dụng kiến trúc khuếch tán flow-matching với cùng mục tiêu huấn luyện như phía sau Stable Diffusion 3, có từ 10 đến 50 tỷ tham số không tính embedding.
Dưới đây là tóm tắt nhanh về cả ba mô hình:
|
Mô hình |
Nhiệm vụ |
Chỉ số chính |
Giá |
|
MAI-Transcribe-1 |
Giọng nói thành Văn bản |
WER trung bình 3,88% trên FLEURS |
$0,36/giờ |
|
MAI-Voice-1 |
Văn bản thành Giọng nói |
60 giây âm thanh trong 1 giây |
$22/1M ký tự |
|
MAI-Image-2 |
Văn bản thành Ảnh |
Elo 1190 tổng thể |
$5/1M token văn bản + $33/1M token ảnh |
Hãy tìm hiểu sâu hơn về từng mô hình trước khi chúng ta xây dựng.
MAI-Transcribe-1
MAI-Transcribe-1 là mô hình chuyển giọng nói thành văn bản hỗ trợ 25 ngôn ngữ. Điểm nổi bật là Tỷ lệ Lỗi Từ (WER) trung bình 3,88% trên benchmark FLEURS, chỉ số này càng thấp càng tốt, và nó vượt qua GPT-Transcribe (4,17%), Scribe v2 (4,32%), Gemini 3.1 Flash-Lite (4,89%) và Whisper-large-v3 (7,60%).
Mô hình được xây dựng đặc biệt cho âm thanh thực tế lộn xộn, bao gồm môi trường ồn, giọng pha trộn và phong cách nói tự nhiên. Microsoft cũng cho biết MAI-Transcribe-1 đạt độ chính xác tốt với chi phí GPU thấp hơn khoảng 50% so với các lựa chọn hàng đầu, mang lại lợi thế đáng kể cho doanh nghiệp chuyển lời nói thành văn bản ở quy mô lớn.
Tuy nhiên, hiện vẫn thiếu chuyển lời nói thời gian thực, phân tách người nói và ưu tiên ngữ cảnh, tất cả đều được ghi chú là "sắp ra mắt."
MAI-Voice-1
MAI-Voice-1 là mô hình TTS độ trung thực cao của Microsoft. Năng lực chủ đạo là voice prompting: bạn cung cấp một mẫu âm thanh 10 giây và mô hình sẽ nhân bản giọng nói đó mà không cần tinh chỉnh. Tuy nhiên, nhân bản giọng nói cần được Microsoft phê duyệt có kiểm soát, còn thư viện giọng nói chọn sẵn (các tên như en-us-Jasper:MAI-Voice-1, en-us-June:MAI-Voice-1) thì có ngay lập tức.
Mô hình tạo ra 60 giây âm thanh chỉ trong 1 giây trên một GPU, hỗ trợ điều khiển cảm xúc theo lượt qua SSML, và được xây dựng cho nội dung dài như sách nói và podcast. Nó đã vận hành các tính năng Audio Expressions và podcast của Copilot trong sản phẩm của Microsoft.
Một điểm hạn chế là mô hình hiện chỉ hỗ trợ tiếng Anh, với hơn 10 ngôn ngữ khác sẽ sớm có mặt.
MAI-Image-2
MAI-Image-2 sử dụng kiến trúc khuếch tán flow-matching với 10–50 tỷ tham số. Đây là một trong top 3 trên bảng xếp hạng hình ảnh của Arena.ai và nhanh gấp 2 lần MAI-Image-1 trong môi trường sản xuất. Mô hình được phát triển cùng các nhiếp ảnh gia, nhà thiết kế và người kể chuyện bằng hình ảnh, và đã được triển khai trong Copilot, Bing Image Creator và PowerPoint. Nó đặc biệt mạnh ở ảnh chân thực, tông da chính xác và văn bản trong ảnh dễ đọc.
Điểm Elo theo danh mục gồm photorealistic (1201) và chân dung (1201), là thế mạnh; trong khi hiển thị văn bản (1186) đã tốt hơn trước nhưng vẫn là hạng mục yếu nhất.
Thiết lập Azure cho tất cả mô hình
Cả ba mô hình MAI đều có trên Microsoft Azure. MAI-Transcribe-1 và MAI-Voice-1 dùng chung tài nguyên Azure Speech, còn MAI-Image-2 chạy qua Microsoft Foundry. Hãy thiết lập từng cái một.
Yêu cầu tiên quyết
- Đăng ký hoặc đăng nhập tài khoản Azure để nhận $200 tín dụng miễn phí
- Python 3.9+
Bước 1: Tạo tài nguyên Azure Speech
Cả MAI-Transcribe-1 và MAI-Voice-1 đều truy cập qua dịch vụ Azure AI Speech, nên một tài nguyên là đủ cho cả hai.
-
Vào portal.azure.com
-
Trong thanh tìm kiếm, gõ Speech và chọn Speech services
-
Nhấp + Create
-
Điền biểu mẫu:
-
Nhóm tài nguyên: Tạo nhóm mới và đặt tên
mai-demo-rg -
Khu vực: Chọn
East USvì các mô hình MAI hiện chỉ hỗ trợ East US và West US -
Tên:
mai-speech-demo -
Bậc giá:
Standard S0 -
Lưu ý: Miễn phí F0 có giới hạn tốc độ có thể làm gián đoạn demo
-
Cuối cùng, nhấp Review and create, và sau khi tải xong, nhấp Create.
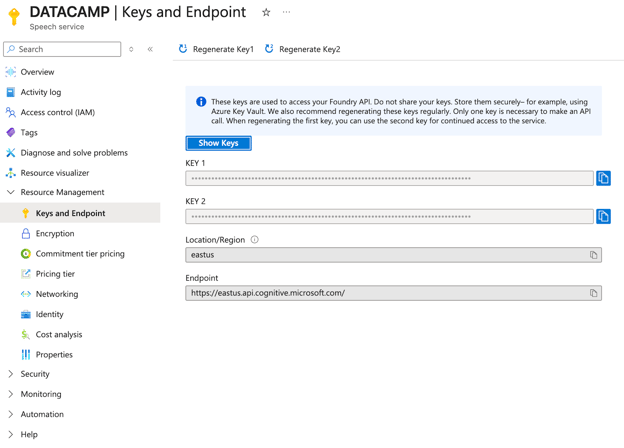
Khi triển khai xong, vào Keys and Endpoint ở thanh bên trái, sao chép Key 1 và ghi lại giá trị Region (eastus).
Bước 2: Tạo tài nguyên Foundry và triển khai MAI-Image-2
MAI-Image-2 được truy cập qua Microsoft Foundry, tách biệt với cổng Azure thông thường.
-
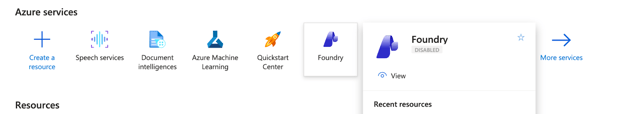
Từ trang chủ cổng Azure, nhấp Foundry ở hàng dịch vụ trên cùng
-
Nhấp Create a resource
-
Tiếp theo, điền các thông tin sau:
-
Nhóm tài nguyên: Chọn cùng
mai-demo-rgở Bước 1 -
Khu vực: East US
-
Tên:
mai-image-demo -
Tên dự án mặc định:
proj-default -
Sau đó, nhấp Review and create, rồi nhấn Create
-
Khi tài nguyên hoạt động, nhấp Go to Foundry portal.
-
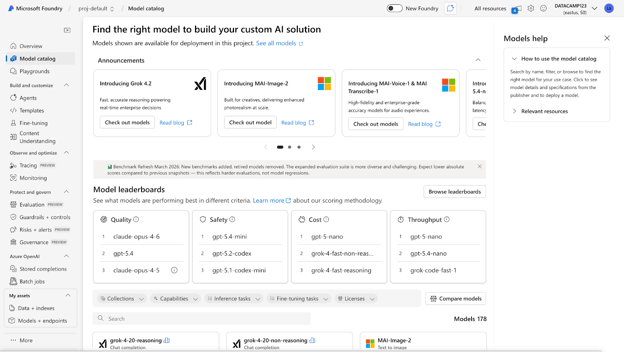
Tiếp theo, trong giao diện Foundry, nhấp Model catalog ở thanh bên trái
- Tìm
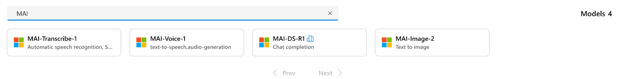
MAItrong thanh tìm kiếm, bạn sẽ thấy cả bốn mô hình MAI được liệt kê
-
Chọn MAI-Image-2 và nhấp Use this model
-
Trong hộp thoại triển khai, đặt:
-
Tên triển khai:
MAI-Image-2 -
Kiểu triển khai:
Global Standard -
Cuối cùng, nhấp deploy
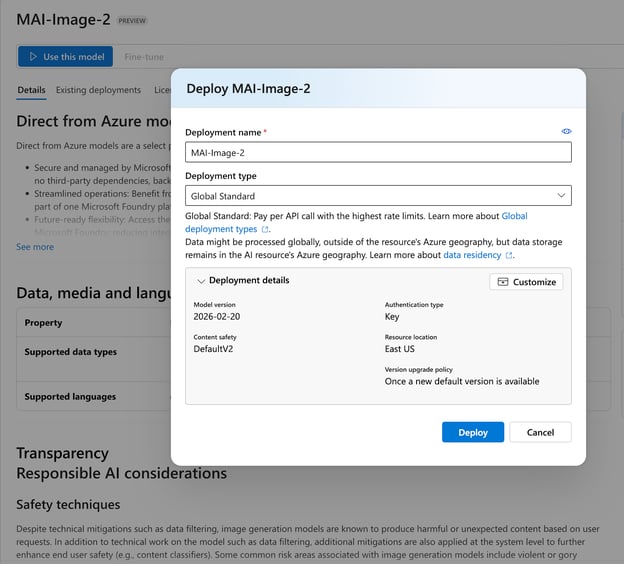
Sau khi triển khai, bạn sẽ vào trang chi tiết triển khai. Sao chép Target URI (dạng như https://mai-image-demo.services.ai.azure.com/models) và Key.
Bước 3: Cấu hình tệp .env
Tạo tệp .env trong thư mục dự án local và thêm các thông tin chúng ta đã lấy ở hai bước trước:
AZURE_SPEECH_KEY=your_speech_key_1_here
AZURE_SPEECH_REGION=eastus
AZURE_IMAGE_ENDPOINT=https://your-resource-name.services.ai.azure.com/models
AZURE_IMAGE_KEY=your_foundry_key_here
AZURE_IMAGE_DEPLOYMENT=MAI-Image-2Lưu ý quan trọng: AZURE_IMAGE_DEPLOYMENT phân biệt chữ hoa thường. Hãy dùng đúng MAI-Image-2 như hiển thị trong Foundry, vì dùng chữ thường mai-image-2 sẽ trả về lỗi unknown_model.
Demo mô hình MAI: Xây dựng ứng dụng Giọng nói, Voice và Ảnh với Streamlit
Trong phần này, chúng ta sẽ xây dựng một ứng dụng Streamlit ba tab gọi cả ba mô hình MAI qua các lệnh gọi API Azure trực tiếp. Ở mức khái quát, ứng dụng làm những việc sau:
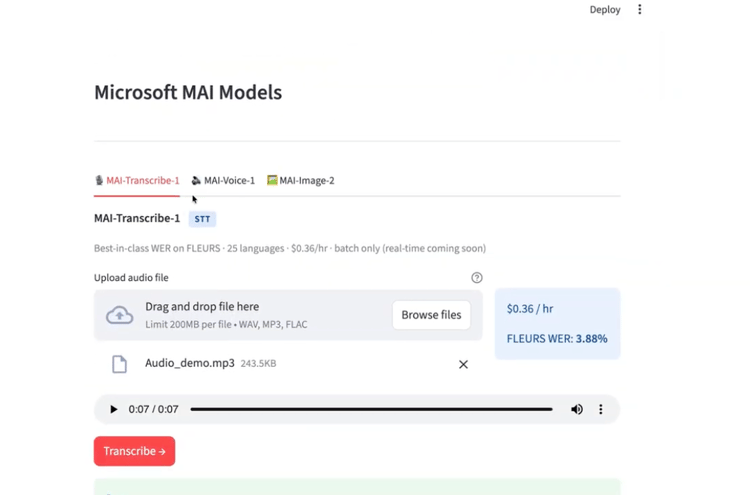
- Tab 1: Nhận tệp WAV, MP3 hoặc bất kỳ tệp âm thanh nào và gửi tới MAI-Transcribe-1 qua Azure Speech REST API, trả về bản lời đầy đủ kèm độ trễ và ước tính chi phí
- Tab 2: Nhận đầu vào văn bản với lựa chọn giọng và kiểu cảm xúc, dựng yêu cầu SSML và gọi MAI-Voice-1 để trả về tệp âm thanh MP3 có thể phát
- Tab 3: Nhận prompt văn bản và thiết lập độ phân giải, gọi MAI-Image-2 qua endpoint Azure Foundry, và hiển thị ảnh sinh ra ngay trong giao diện kèm tùy chọn tải xuống
- Ứng dụng cũng hiển thị ước tính chi phí theo thời gian thực cho từng mô hình khi bạn cấu hình đầu vào
Cấu trúc tệp như sau:
mai_demo/
├── app.py # Streamlit UI
├── mai_clients.py # Azure API wrappers
├── requirements.txt
└── .envỨng dụng được tách thành hai tệp: mai_clients.py xử lý mọi lệnh gọi API Azure và trả về dict kết quả có cấu trúc, và app.py xử lý giao diện Streamlit. Hãy xây dựng từng bước.
Bước 1: Cài đặt phụ thuộc
Khác với thiết lập mô hình cục bộ, ứng dụng này kết nối tới API đám mây Azure thực, nên danh sách phụ thuộc gồm cả Azure Speech SDK và các thư viện HTTP, xử lý ảnh hỗ trợ.
pip install -r requirements.txtTệp requirements.txt chứa:
.txt
streamlit>=1.35.0
azure-cognitiveservices-speech>=1.38.0
requests>=2.31.0
pillow>=10.0.0
python-dotenv>=1.0.0
openai>=1.30.0Trong dự án này, chúng ta sẽ dùng:
-
streamlitcho UI ba tab, bộ tải tệp, trình phát âm thanh và hiển thị ảnh nội tuyến -
azure-cognitiveservices-speechcho Azure Speech SDK, dùng giao tiếp với MAI-Transcribe-1 và MAI-Voice-1 -
requestsđể gọi trực tiếp REST API tới cả ba endpoint Azure -
pillowđể giải mã và hiển thị byte ảnh trả về từ MAI-Image-2 -
python-dotenvđể nạp khóa Azure và URL endpoint từ tệp.envkhi chạy -
openaicho SDK tương thích Azure OpenAI, hỗ trợ endpoint sinh ảnh của Foundry
Sau khi cài đặt, đảm bảo tệp .env nằm cùng thư mục với app.py trước khi chạy ứng dụng. Mọi nạp thông tin xác thực diễn ra tự động khi khởi động qua python-dotenv.
Bước 2: Xây lớp client API (mai_clients.py)
Mọi lệnh gọi API Azure nằm trong mai_clients. py ', where each function returns a simple {"success": bool, ...}` dictionary để tầng UI không bao giờ bị sập khi có lỗi.
MAI-Transcribe-1: Giọng nói thành Văn bản
MAI-Transcribe-1 được truy cập qua endpoint LLM Speech của Azure Speech REST API. Chi tiết quan trọng là nó nhận yêu cầu multipart form gồm tệp âm thanh và đối tượng định nghĩa JSON.
def transcribe_audio(audio_bytes: bytes, filename: str = "audio.wav") -> dict:
url = (
f"https://{speech_region}.api.cognitive.microsoft.com"
f"/speechtotext/transcriptions:transcribe?api-version=2024-11-15"
)
headers = {"Ocp-Apim-Subscription-Key": speech_key}
definition = '{"locales":["en-US"],"profanityFilterMode":"None"}'
files = {
"audio": (filename, audio_bytes, _mime_type(filename)),
"definition": (None, definition, "application/json"),
}
resp = requests.post(url, headers=headers, files=files, timeout=60)
data = resp.json()
combined = " ".join(
p.get("text", "") for p in data.get("combinedPhrases", [])
).strip()
return {"success": True, "transcript": combined, "raw": data, ...}Phản hồi từ đoạn mã trên trả về đối tượng JSON với combinedPhrases, là mảng các đoạn văn bản. Ta nối lại thành một chuỗi bản lời. Định dạng âm thanh hỗ trợ gồm WAV, MP3 và FLAC. API hiện bị giới hạn vùng ở East US và West US.
MAI-Voice-1: Văn bản thành Giọng nói
MAI-Voice-1 dùng Azure Speech TTS chuẩn thông qua SSML. Mấu chốt là dựng khối <mstts:express-as> để điều khiển cảm xúc và tham chiếu đúng định dạng tên giọng (en-us-Jasper:MAI-Voice-1).
def _build_ssml(text: str, emotion: str, voice_name: str) -> str:
style_map = {
"neutral": None,
"joy": "joy",
"excitement": "excitement",
"empathy": "empathy",
}
style = style_map.get(emotion)
text_block = (
text if style is None
else f"<mstts:express-as style='{style}'>{text}</mstts:express-as>"
)
return f"""<speak version='1.0' xml:lang='en-US'
xmlns='http://www.w3.org/2001/10/synthesis'
xmlns:mstts='http://www.w3.org/2001/mstts'>
<voice name='{voice_name}'>
{text_block}
</voice>
</speak>"""Các tên giọng khả dụng cho MAI-Voice-1 theo mẫu en-us-{Name}:MAI-Voice-1. Danh sách hiện có Jasper, June, Grant, Iris, Reed và Joy.
MAI-Image-2: Văn bản thành Ảnh
MAI-Image-2 dùng endpoint đặc thù của Foundry, không phải đường dẫn /openai/deployments/ tiêu chuẩn của Azure OpenAI. Định dạng endpoint đúng là:
url = f"{base_endpoint}/mai/v1/images/generations"Ở đây, base_endpoint là gốc URL tài nguyên Foundry của bạn (ví dụ https://your-resource.services.ai.azure.com), bỏ phần /models nếu có trước khi dựng yêu cầu. Phần thân yêu cầu có hai yêu cầu: thứ nhất, bạn phải truyền rõ trường model đặt theo tên triển khai, khác với endpoint OpenAI chuẩn vốn suy ra mô hình từ đường dẫn URL:
payload = { "model": deployment, # "MAI-Image-2" "prompt": prompt, "width": width, "height": height, }Thứ hai, kích thước ảnh có ràng buộc cứng: cả width và height phải tối thiểu 768 px, và tích của chúng không vượt 1.048.576, tương đương tối đa 1024×1024 cho ảnh vuông. Truyền 512×512 hoặc bỏ qua kích thước sẽ trả về 400 Bad Request.
Phản hồi theo dạng chuẩn sinh ảnh của OpenAI. Mỗi phần tử trong mảng data sẽ chứa hoặc một url trỏ tới ảnh được lưu trữ hoặc trường b64_json với byte base64 thô. Client xử lý cả hai:
image_url = row.get("url")
b64 = row.get("b64_json")
if b64:
img_bytes = base64.b64decode(b64)
elif image_url:
img_resp = requests.get(image_url, timeout=30)
img_bytes = img_resp.contentLưu ý phản hồi dạng url có giới hạn thời gian, nghĩa là chúng ta cần tải và lưu byte ngay lập tức thay vì giữ URL dùng sau.
Bước 3: Xây dựng giao diện Streamlit (app.py)
Ứng dụng được tổ chức thành ba tab, mỗi tab cho một mô hình. Cấu trúc như sau:
import streamlit as st
from mai_clients import transcribe_audio, synthesize_speech, generate_image
tab1, tab2, tab3 = st.tabs([
"🎙 MAI-Transcribe-1",
"🔊 MAI-Voice-1",
"🖼 MAI-Image-2",
])Mỗi tab theo cùng mô thức: đầu vào → nút bấm → spinner → hiển thị kết quả → chỉ số chi phí.
Tab 1: MAI-Transcribe-1
Tab đầu xử lý tải lên và phiên âm âm thanh. Hỗ trợ tệp WAV, MP3, FLAC, phát lại âm thanh ngay trong ứng dụng để bạn xác nhận nội dung thử, và gửi byte trực tiếp tới transcribe_audio() khi nhấn nút.
with tab1:
audio_file = st.file_uploader("Upload audio file", type=["wav", "mp3", "flac"])
if audio_file:
st.audio(audio_file)
if st.button("Transcribe", type="primary"):
with st.spinner("Calling MAI-Transcribe-1..."):
result = transcribe_audio(audio_file.read(), audio_file.name)
if result["success"]:
st.text_area("Transcript", value=result["transcript"], height=140)
m1, m2, m3 = st.columns(3)
m1.metric("Latency", f"{result['latency_s']}s")
m2.metric("Audio duration", f"{result['duration_ms']/1000:.1f}s")
m3.metric("Est. cost", f"${result['duration_ms']/3_600_000 * 0.36:.5f}")Khi phản hồi thành công, bản lời xuất hiện trong vùng văn bản có thể chỉnh sửa, theo sau là ba chỉ số: độ trễ API tính bằng giây, thời lượng âm thanh lấy từ trường durationMilliseconds của phản hồi, và ước tính chi phí tính bằng duration_in_hours × $0,36.
Một đoạn 7 giây có chi phí khoảng $0,0000007, nên bạn có thể chạy hàng chục tệp thử mà hầu như không ảnh hưởng tín dụng Azure.
Tab 2: MAI-Voice-1
Tab thứ hai xử lý tổng hợp văn bản thành giọng nói. Nó cung cấp ba điều khiển quan trọng nhất để thử MAI-Voice-1: văn bản đầu vào, kiểu cảm xúc và lựa chọn giọng, tất cả được truyền trực tiếp vào hàm synthesize_speech().
with tab2:
text_input = st.text_area("Text to synthesize", value="The quarterly results exceeded...")
emotion = st.selectbox("Emotion / style", ["neutral", "joy", "excitement", "empathy"])
voice_name = st.selectbox("Voice", ["en-us-Jasper:MAI-Voice-1", "en-us-June:MAI-Voice-1", ...])
if st.button("Synthesize", type="primary"):
with st.spinner("Calling MAI-Voice-1..."):
result = synthesize_speech(text_input, emotion=emotion, voice_name=voice_name)
if result["success"]:
st.audio(result["audio_bytes"], format="audio/mp3")Tùy chọn cảm xúc ánh xạ tới các style SSML <mstts:express-as>; neutral bỏ qua thẻ để cho đầu ra chuẩn, trong khi joy, excitement và empathy tạo nhịp điệu và cao độ khác biệt rõ rệt. Danh sách giọng bao phủ sáu giọng MAI-Voice-1 hiện có: Jasper, June, Grant, Iris, Reed và Joy.
Khi thành công, byte MP3 trả về được truyền thẳng vào st.audio() để phát nội tuyến. Với 113 ký tự, chi phí ước tính là $0,000002, nên bạn có thể thử nhiều lần mà không tốn quá nhiều tín dụng.
Tab 3: MAI-Image-2
Tab thứ ba xử lý sinh ảnh từ văn bản. API hiện tại của MAI-Image-2 lộ hai tham số đầu vào: prompt và độ phân giải. Không có tầng chất lượng hay điều khiển phong cách; mô hình tự xử lý nội bộ.
with tab3:
prompt = st.text_area("Image prompt", value="A worn paperback book on a café table...")
size = st.selectbox("Resolution", ["1024x1024", "1365x768", "768x1365"])
if st.button("Generate", type="primary"):
with st.spinner("Calling MAI-Image-2..."):
result = generate_image(prompt, size=size)
if result["success"]:
img = Image.open(io.BytesIO(result["image_bytes"]))
st.image(img, use_container_width=True)Ba tùy chọn độ phân giải bao phủ các tỷ lệ chính: vuông (1024×1024), ngang (1365×768) và dọc (768×1365). Chuỗi kích thước được phân tách thành số nguyên width và height trước khi gửi tới API, vì endpoint Foundry nhận từng trường riêng lẻ thay vì chuỗi gộp.
Khi thành công, byte ảnh thô từ phản hồi API được bọc trong bộ đệm BytesIO, mở bằng Pillow và hiển thị toàn bộ chiều rộng vùng chứa. Thời gian sinh ảnh thường 2–4 giây, nhanh hơn đáng kể so với MAI-Image-1 trong cùng môi trường.
Bước 4: Chạy ứng dụng
Với tệp .env đã cấu hình và phụ thuộc đã cài đặt, bạn sẵn sàng chạy ứng dụng.
streamlit run app.pyStreamlit sẽ khởi động máy chủ local và tự động mở ứng dụng trong trình duyệt tại http://localhost:8501. Bạn sẽ thấy giao diện ba tab với MAI-Transcribe-1 được kích hoạt mặc định.
Kiểm thử các mô hình
Đây là những gì các mô hình thực sự tạo ra khi chúng tôi chạy thử.
Bài test 1: Phiên âm âm thanh ồn
Tôi đã thử MAI-Transcribe-1 với một đoạn âm thanh 7 giây ghi trong môi trường ồn một cách có chủ đích, với giọng Ấn Độ. Mô hình trả về bản lời sạch, chính xác trong chưa đầy 2 giây.
Kết luận: Kết quả xử lý tốt giọng có âm sắc, vốn là điểm Whisper-large-v3 thường gặp khó. Tuy vậy, số liệu theo ngôn ngữ kể câu chuyện khác: tiếng Ả Rập ở mức 10,1% và tiếng Đan Mạch 13,2%, đều cao hơn đáng kể so với con số tiêu đề. Nếu bài toán của bạn gắn với một ngôn ngữ hay phân bố giọng vùng miền cụ thể, hãy thử với âm thanh thực tế của bạn trước khi đưa mô hình vào sản xuất.
Bài test 2: Điều khiển cảm xúc
Tôi tổng hợp một câu 113 ký tự với kiểu excitement bằng giọng en-us-Jasper:MAI-Voice-1, và nhận lại tệp MP3 dài 6 giây trong chưa đầy 1 giây. Cảm xúc thể hiện rõ với nhịp độ năng động hơn và biến thiên cao độ lớn hơn.
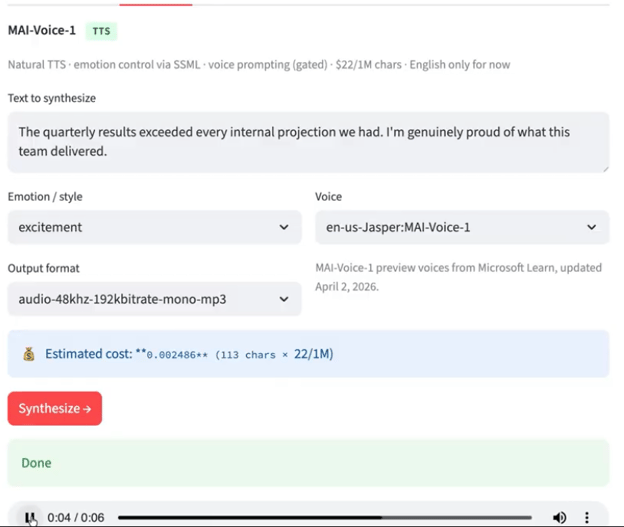
Kết luận: Tạo 6 giây âm thanh trong chưa đầy 1 giây là ấn tượng. Điều khiển cảm xúc bằng SSML hoạt động nhưng giới hạn ở bốn kiểu: neutral, joy, excitement và empathy. Vì vậy, đừng kỳ vọng dải biểu đạt đầy đủ như thư viện style của ElevenLabs.
Bài test 3: Ảnh chân thực và hiển thị văn bản
Đây là bài thử thú vị nhất vì tôi cố tình chọn prompt kết hợp hai yếu tố: bố cục cảnh chân thực và văn bản trong ảnh. Hầu hết mô hình khuếch tán đều trượt ở ít nhất một trong hai.
Prompt: "Một cuốn sách bìa mềm đã sờn trên bàn cà phê, ánh sáng cửa sổ tự nhiên, hơi nước bốc lên từ tách espresso bên cạnh. Bìa sách ghi: INFERENCE AT SCALE — chữ rõ ràng, không méo."
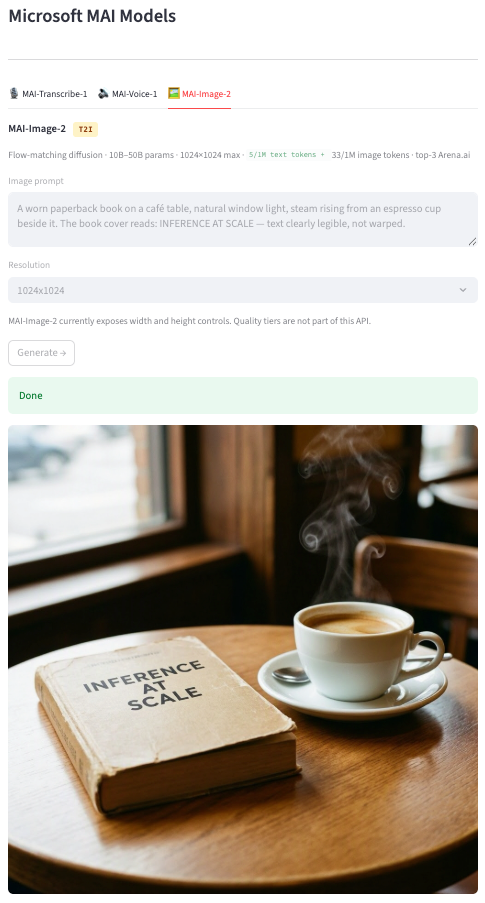
Kết luận: Tính chân thực rất tốt với ánh sáng cửa sổ tự nhiên, hơi nước thuyết phục và kết cấu đáng tin trên cuốn sách và tách. Dòng chữ "INFERENCE AT SCALE" cũng được hiển thị đúng và rõ ràng.
Tuy nhiên, hiển thị văn bản không ổn định giữa các lần chạy. Trong nhiều lần sinh ảnh với prompt tương tự, mô hình đôi khi tạo chữ sai chính tả hoặc méo mó. Đây là hạn chế đã biết của mọi mô hình khuếch tán hiện nay; MAI-Image-2 tốt hơn phần lớn nhưng không miễn nhiễm. Ngoài ra, độ phân giải tối đa hiện là 1024×1024 pixel, đủ cho đa số trường hợp web và nội dung, nhưng loại trừ đầu ra chất lượng in hoặc sáng tạo khổ lớn nếu không qua bước nâng cấp độ phân giải. Nếu bạn sinh ảnh mà độ chính xác văn bản là then chốt, hãy luôn thêm bước kiểm duyệt thủ công.
Kết luận
Họ mô hình MAI của Microsoft thực sự ấn tượng, trong đó các con số FLEURS của MAI-Transcribe-1 là kiểm chứng khách quan nhất: WER trung bình 3,88%, thuộc nhóm tốt nhất vào thời điểm viết bài.
MAI-Voice-1 gây ấn tượng về tốc độ và chất lượng giọng nhưng bị giới hạn ở tiếng Anh và bảng cảm xúc còn ít. MAI-Image-2 cho ra ảnh chân thực mạnh, nhưng cần lưu ý hiện tượng "ảo giác" văn bản vẫn xảy ra và cần rà soát thủ công khi đưa vào sản xuất.
Toàn bộ mã nguồn cho hướng dẫn này có trên GitHub.

Tôi là Chuyên gia Google Developers trong lĩnh vực ML (Gen AI), Chuyên gia Kaggle 3x và Đại sứ Women Techmakers với hơn 3 năm kinh nghiệm trong ngành công nghệ. Tôi đồng sáng lập một startup công nghệ y tế vào năm 2020 và hiện đang theo học thạc sĩ khoa học máy tính tại Georgia Tech, chuyên sâu về học máy.
Câu hỏi thường gặp
Tôi có cần tài khoản Azure trả phí để dùng các mô hình MAI không?
Tài khoản Azure mới có $200 tín dụng miễn phí, và Azure for Students có $100. Vì một phiên demo đầy đủ với cả ba mô hình tốn ít hơn $0,01 rất nhiều, lượng tín dụng miễn phí là quá đủ để bắt đầu. Bạn sẽ cần nâng cấp lên tài khoản trả phí nếu dự định dùng mô hình ở quy mô sản xuất.
Tôi có thể dùng MAI-Transcribe-1 để phiên âm thời gian thực trong trợ lý thoại không?
Chưa. MAI-Transcribe-1 chỉ hỗ trợ xử lý theo lô, nên bạn gửi một tệp âm thanh hoàn chỉnh và nhận lại bản chép lời. Nếu yêu cầu thời gian thực là bắt buộc, hãy giữ Whisper hoặc dịch vụ thời gian thực sẵn có của Azure Speech làm phương án dự phòng trong lúc chờ đợi.
Vì sao MAI-Image-2 đôi khi viết sai chữ trong ảnh sinh ra?
Đây là hạn chế đã biết của các mô hình sinh ảnh dựa trên khuếch tán, không riêng MAI-Image-2. Mô hình tạo ảnh bằng cách biến đổi nhiễu thành pixel, nên không có hiểu biết tường minh về chính tả hay chuỗi ký tự như mô hình ngôn ngữ. MAI-Image-2 xử lý hiển thị văn bản tốt hơn đáng kể so với phiên bản trước (Elo 1186 so với 1069), nhưng sự không nhất quán vẫn xảy ra giữa các lần chạy, đặc biệt với từ dài hoặc phông chữ cách điệu. Có người rà soát văn bản được sinh ra là lựa chọn tốt trước khi dùng ảnh trong sản xuất.
Tôi có thể nhân bản bất kỳ giọng nói nào với MAI-Voice-1 không?
Nhân bản giọng nói qua tính năng Personal Voice yêu cầu mẫu âm thanh 10 giây từ người sở hữu giọng và sự đồng ý ghi âm rõ ràng của họ. Quyền truy cập có kiểm soát, nên bạn cần gửi yêu cầu phê duyệt qua quy trình Limited Access Review của Microsoft.


Microsoft đã ra mắt ba mô hình sẵn sàng cho sản xuất thuộc bộ MAI (Microsoft AI), gồm MAI-Transcribe-1 cho chuyển giọng nói thành văn bản, MAI-Voice-1 cho chuyển văn bản thành giọng nói, và MAI-Image-2 cho sinh ảnh từ văn bản. Cả ba đều khả dụng qua Microsoft Foundry, với quyền truy cập API thực
Trong hướng dẫn này, chúng ta sẽ làm hai việc. Trước hết, đi qua chính xác cách cung cấp và kết nối tới từng mô hình qua Azure. Sau đó, chúng ta sẽ xây dựng một ứng dụng Streamlit để kiểm thử cả ba mô hình bằng prompt thực và các lệnh gọi API thực.
Kết thúc hướng dẫn, bạn sẽ có thể:
Toàn bộ mã nguồn có trong kho GitHub.