
Program
Yazılım Mühendisliği için Yapay Zeka
7 sa
Microsoft'un MAI model ailesi, Microsoft AI Superintelligence ekibi tarafından geliştirildi. Bunlar tamamen şirket içi modeller; Microsoft'un kendi altyapısında eğitildi, Microsoft'un servis yığını için optimize edildi ve doğrudan Azure üzerinden dağıtıldı. MAI-Transcribe-1 ve MAI-Voice-1 modelleri, hâlihazırda ölçekli olarak kurumsal müşterilere hizmet veren aynı Azure Speech altyapısı üzerinde çalışırken, MAI-Image-2, Stable Diffusion 3'ün arkasındakiyle aynı eğitim hedefini kullanan flow-matching difüzyon mimarisini ve 10 ile 50 milyar arasında gömülü olmayan parametreyi kullanır.
Üçüne dair hızlı özeti şudur:
|
Model |
Görev |
Önemli sayı |
Fiyat |
|
MAI-Transcribe-1 |
Konuşmadan Metne |
FLEURS'ta ort. %3,88 WER |
$0,36/saat |
|
MAI-Voice-1 |
Metinden Konuşmaya |
1 saniyede 60 sn ses |
$22/1M karakter |
|
MAI-Image-2 |
Metinden Görsele |
Genel Elo 1190 |
$5/1M metin + $33/1M görsel belirteç |
Şimdi uygulama geliştirmeden önce her birine daha derin bakalım.
MAI-Transcribe-1, 25 dili destekleyen bir konuşmadan metne modelidir. En önemli iddiası, FLEURS kıyaslamasında ortalama %3,88 Kelime Hata Oranı (WER). Düşük olması daha iyidir ve bu değer modeli GPT-Transcribe (%4,17), Scribe v2 (%4,32), Gemini 3.1 Flash-Lite (%4,89) ve Whisper-large-v3 (%7,60)'un önüne yerleştirir.
Model, gürültülü ortamlar, karışık aksanlar ve doğal konuşma tarzları dahil olmak üzere dağınık gerçek dünya sesleri için özel olarak tasarlanmıştır. Microsoft ayrıca MAI-Transcribe-1'in, başlıca alternatiflere kıyasla yaklaşık %50 daha düşük GPU maliyetiyle iyi doğruluk sağladığını belirtiyor; bu da ölçekli deşifre işleten işletmeler için anlamlı bir avantaj.
Bununla birlikte, gerçek zamanlı deşifre, konuşmacı ayrıştırma ve bağlam önyargılama gibi özellikler hâlâ eksik; hepsi "yakında" olarak listelenmiş.
MAI-Voice-1, Microsoft'un yüksek sadakatli TTS modelidir. Temel yeteneği, 10 saniyelik bir ses örneği verdiğinizde herhangi bir ince ayar olmadan sesi klonlayan ses istemidir. Ancak, ses klonlama Microsoft'tan onay gerektirir; buna karşılık küratörlü ses kütüphanesi (en-us-Jasper:MAI-Voice-1, en-us-June:MAI-Voice-1 gibi adlarla) hemen kullanılabilir.
Model, tek bir GPU’da 1 saniyede 60 saniyelik ses üretir, SSML ile dönüş başına duygu kontrolünü destekler ve sesli kitaplar ile podcast’ler gibi uzun biçimli içerikler için tasarlanmıştır. Halihazırda Microsoft’un kendi ürünlerinde Copilot’un Audio Expressions ve podcast özelliklerini beslemektedir.
Bu modelin bir dezavantajı, “yalnızca İngilizce” olmasıdır; 10+ dil yakında gelecek.
MAI-Image-2, 10–50 milyar parametreli bir flow-matching difüzyon mimarisi kullanır. Arena.ai’nin görsel liderlik tablosunda ilk 3 model arasındadır ve üretimde MAI-Image-1’den 2 kat daha hızlıdır. Model, fotoğrafçılar, tasarımcılar ve görsel hikâye anlatıcılarıyla iş birliği içinde geliştirildi ve Copilot, Bing Image Creator ve PowerPoint’te hâlihazırda kullanımdadır. Özellikle fotogerçekçilik, doğru ten tonları ve görsel içi okunabilir metin için tasarlanmıştır.
Kategori bazında Elo puanları arasında parladığı fotogerçekçilik (1201) ve portreler (1201) bulunur; metin oluşturma (1186) önceye göre daha iyi olsa da hâlâ en zayıf kategoridir.
Üç MAI modelinin tamamı Microsoft Azure üzerinde mevcuttur. MAI-Transcribe-1 ve MAI-Voice-1 aynı Azure Speech kaynağını paylaşırken, MAI-Image-2 Microsoft Foundry üzerinden çalışır. İkisini de tek tek kuracağız.
Hem MAI-Transcribe-1 hem de MAI-Voice-1 modellere Azure AI Speech hizmeti üzerinden erişilir; dolayısıyla tek kaynak ikisini de kapsar.
portal.azure.com adresine gidin
Arama çubuğuna Speech yazın ve Speech services'ı seçin
+ Create butonuna tıklayın
Formu doldurun:
Kaynak grubu: Yeni bir kaynak grubu oluşturun ve adını mai-demo-rg koyun
Bölge: East US seçin; çünkü MAI modelleri şu anda yalnızca East US ve West US için destekleniyor
Ad: mai-speech-demo
Fiyatlandırma katmanı: Standard S0
Not: Ücretsiz F0, demoyu kesintiye uğratabilecek hız limitlerine sahiptir
Son olarak Review and create’e tıklayın ve biraz yüklemenin ardından Create’e tıklayın.
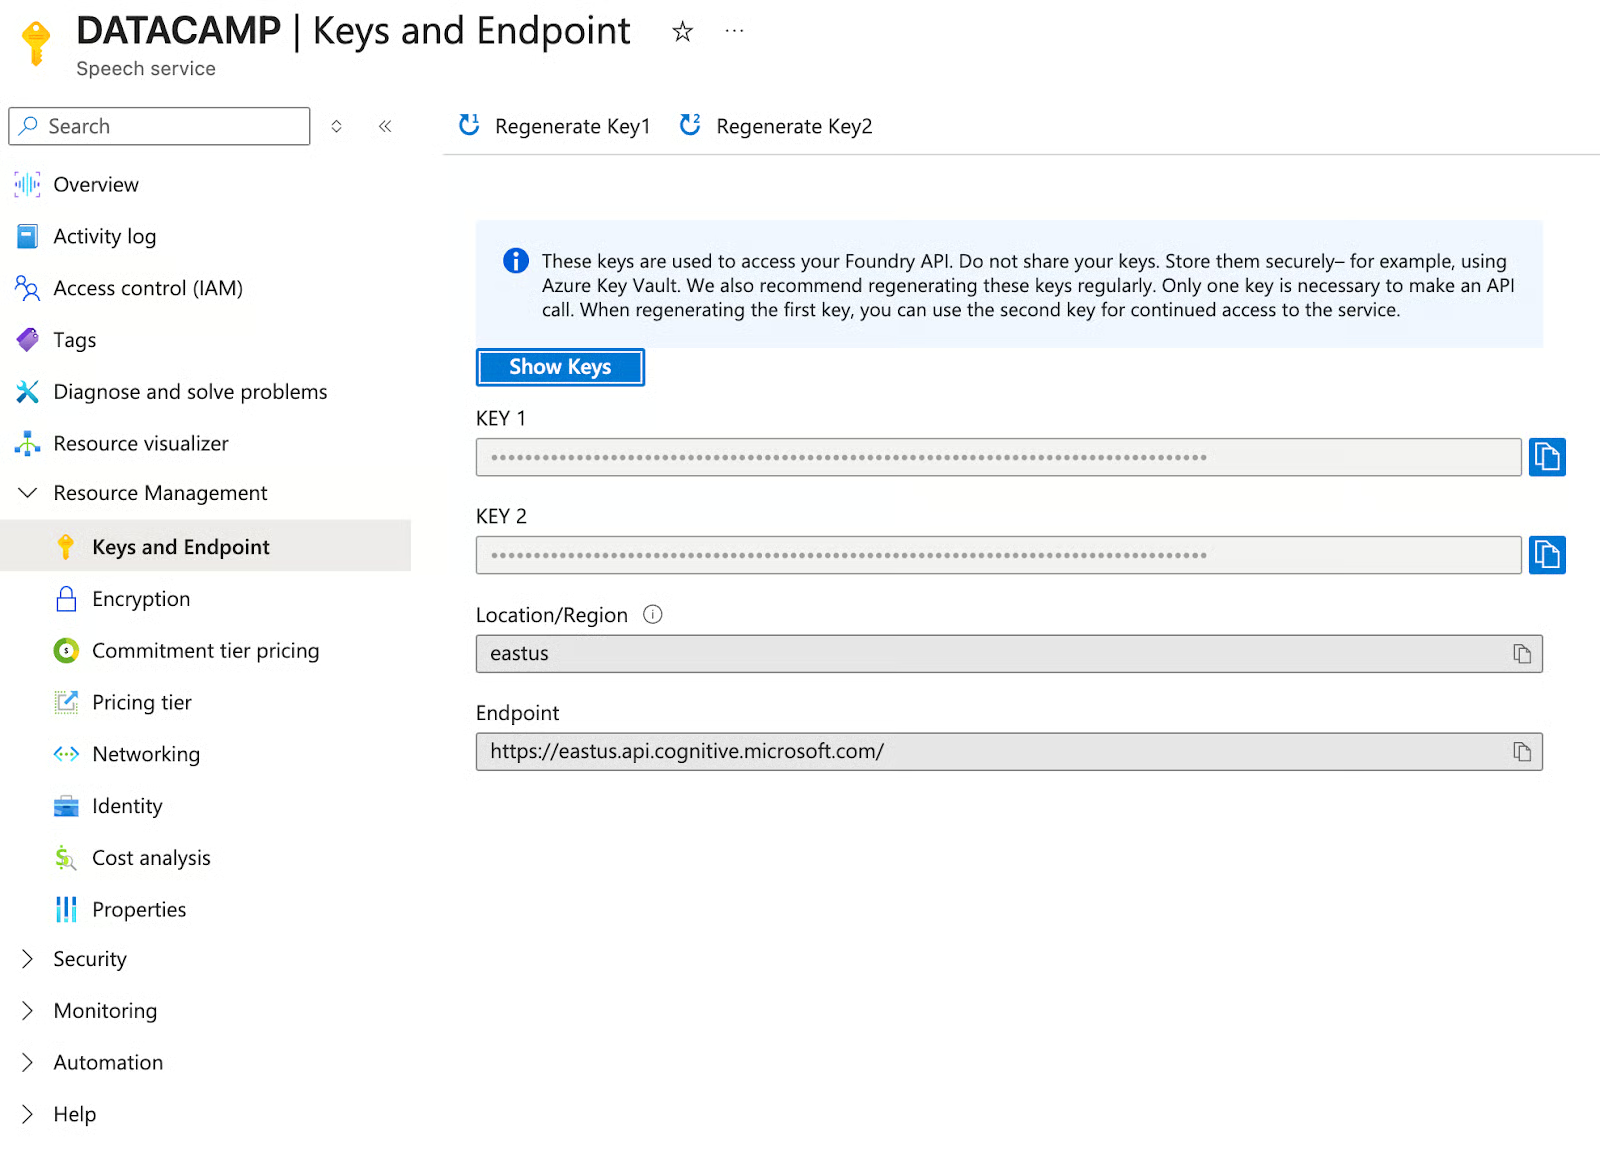
Dağıtım tamamlandığında, sol kenar çubuğundaki Keys and Endpoint bölümüne gidin; Key 1'i kopyalayın ve Region değerini (eastus) not alın.
MAI-Image-2’ye Microsoft Foundry üzerinden erişilir; bu, normal Azure portalından ayrıdır.
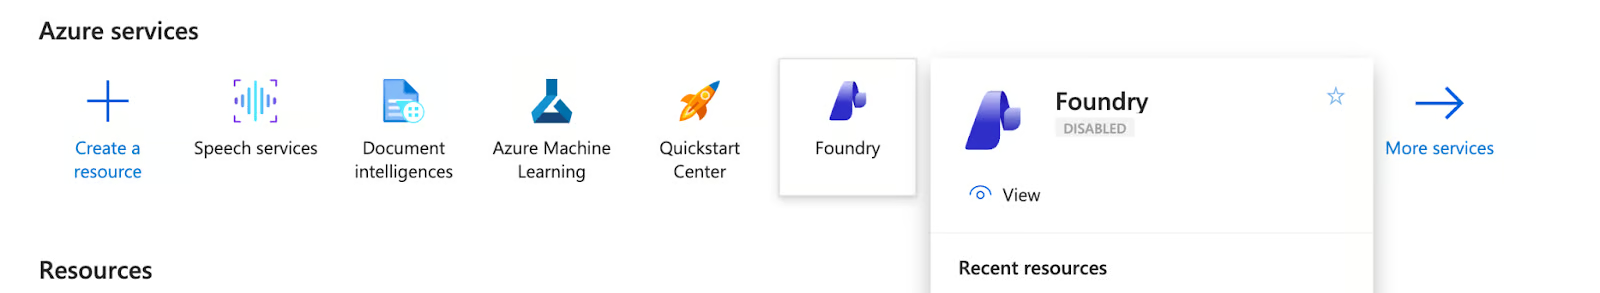
Azure portal ana sayfasından, üstteki hizmetler satırında Foundry’ye tıklayın
Create a resource’a tıklayın
Sonraki adımda aşağıdaki ayrıntıları doldurun:
Kaynak grubu: Adım 1’deki aynı mai-demo-rg’yi seçin
Bölge: East US
Ad: mai-image-demo
Varsayılan proje adı: proj-default
Ardından Review and create’e tıklayın ve Create’e basın
Kaynak aktif olduğunda Go to Foundry portal’a tıklayın.
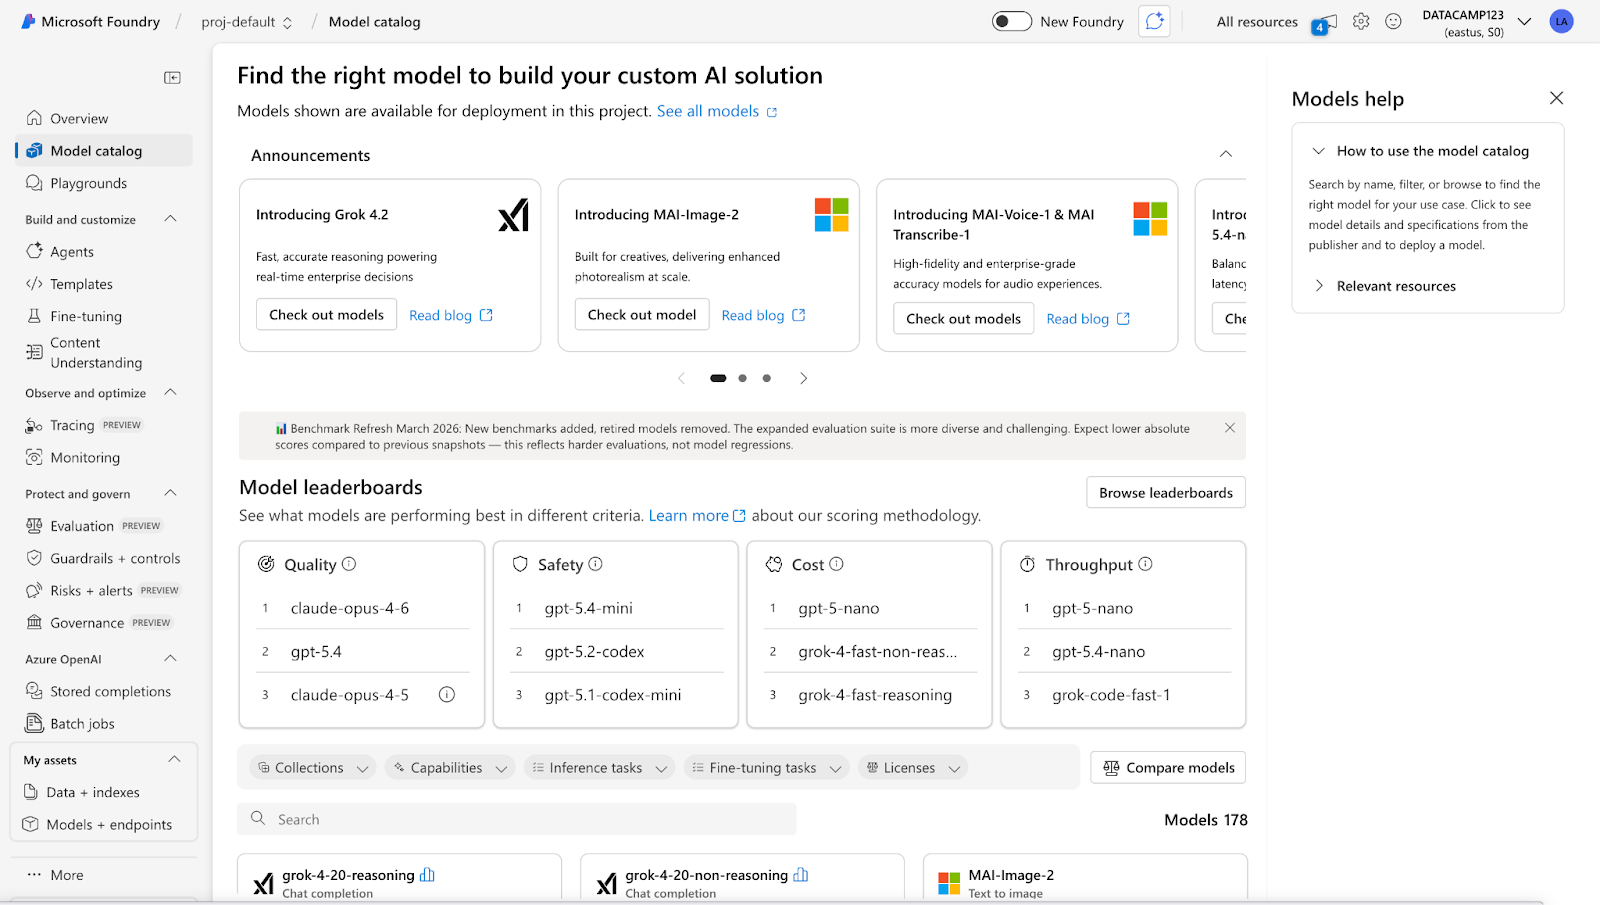
Sonrasında Foundry arayüzünde sol kenar çubuğundan Model catalog’a tıklayın
MAI arayın; dört MAI modelinin de listelendiğini göreceksiniz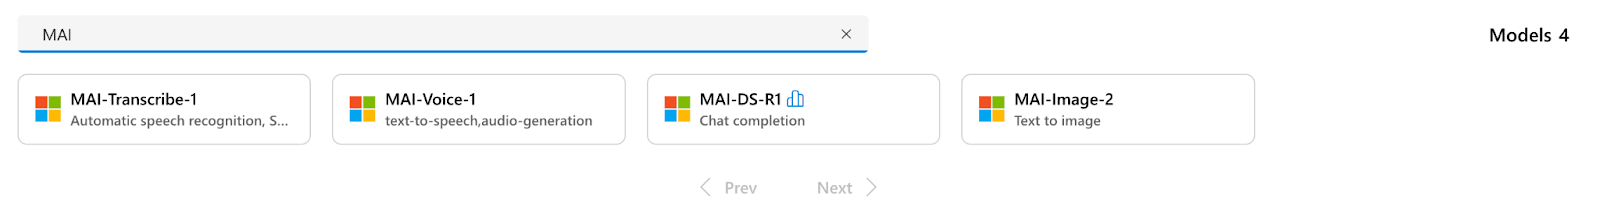
MAI-Image-2’yi seçin ve Use this model’a tıklayın
Dağıtım iletişim kutusunda şunları ayarlayın:
Dağıtım adı: MAI-Image-2
Dağıtım türü: Global Standard
Son olarak deploy’a tıklayın
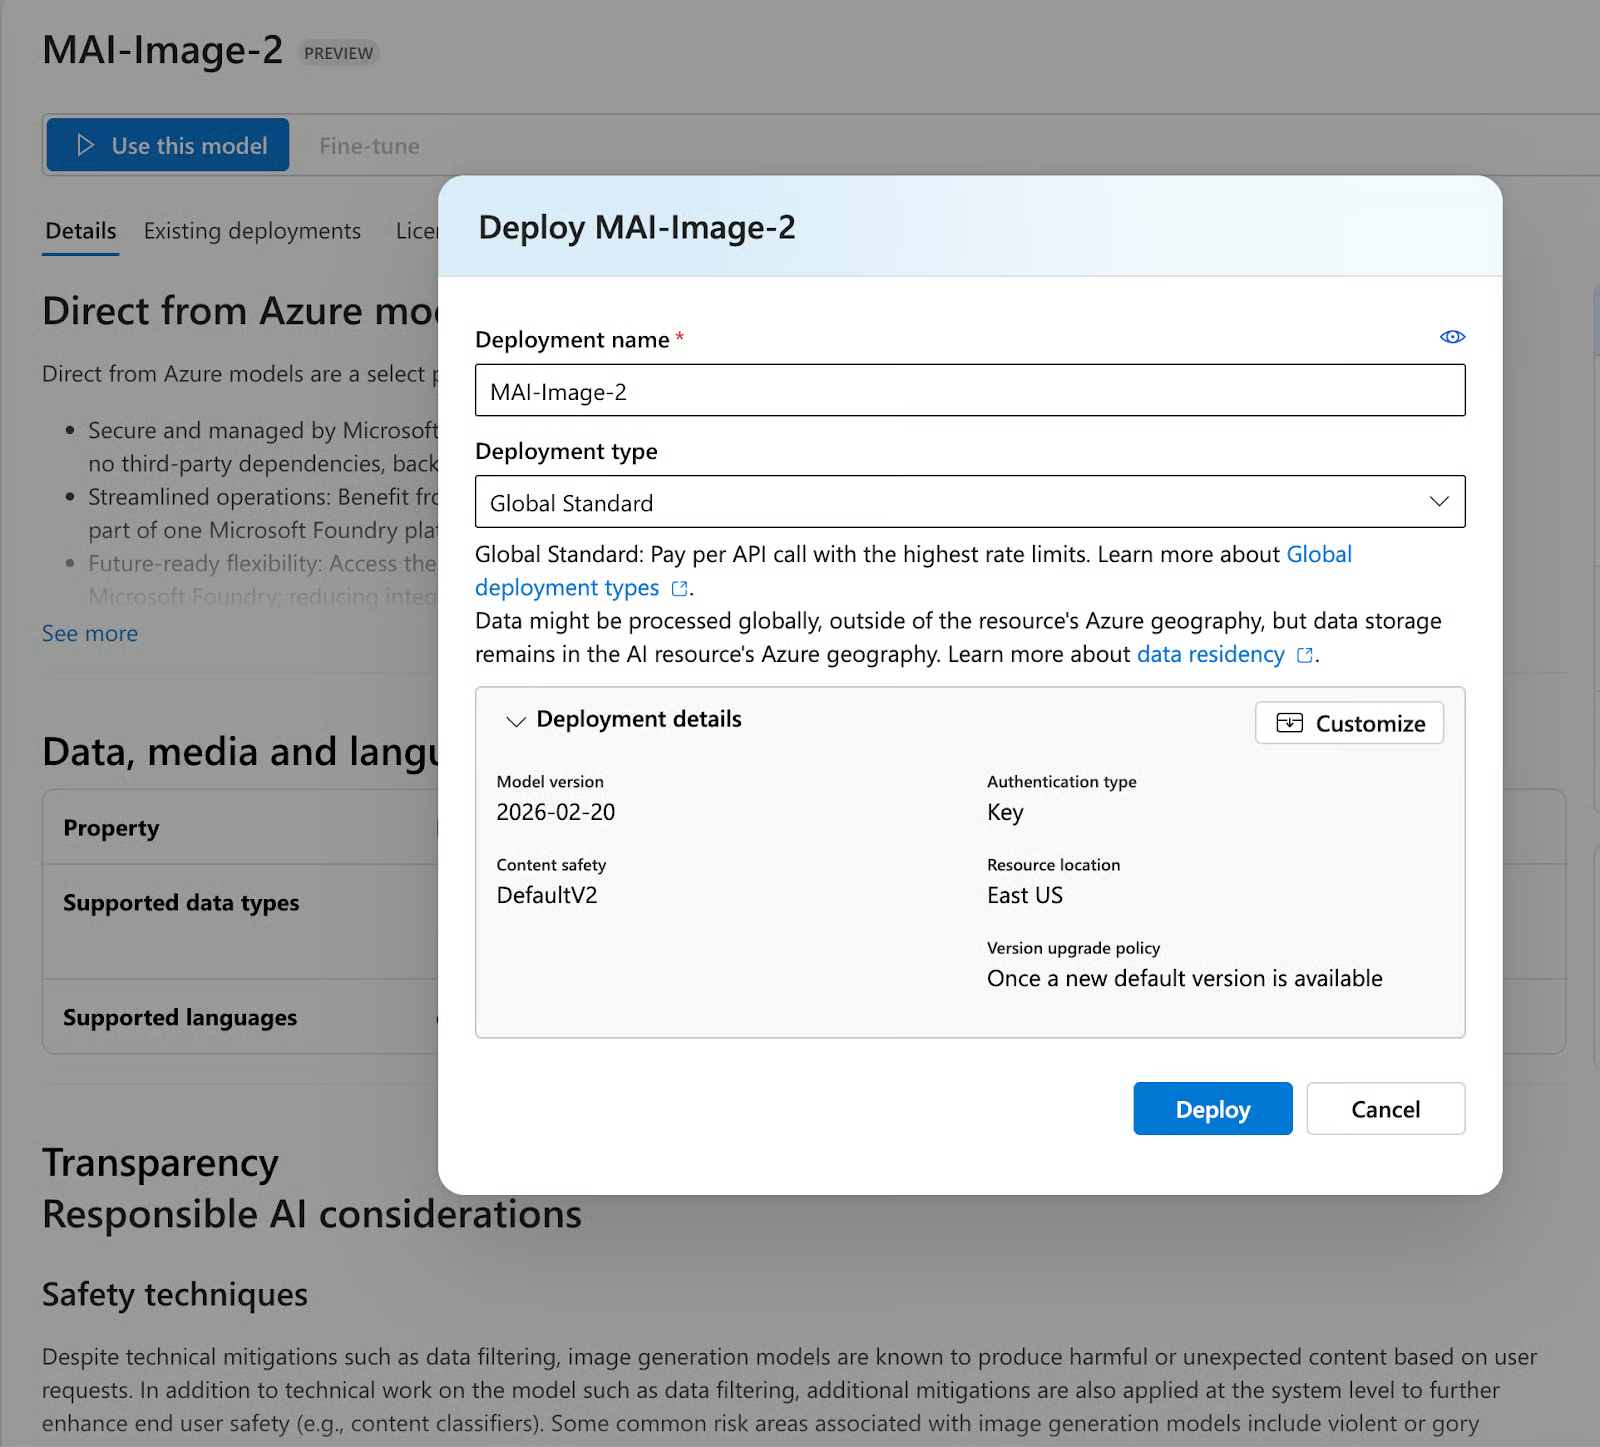
Dağıtımdan sonra, dağıtım ayrıntıları sayfasına yönlendirilirsiniz. Target URI'yi (https://mai-image-demo.services.ai.azure.com/models gibi) ve Key'i kopyalayın.
Yerel proje dizininizde bir .env dosyası oluşturun ve önceki iki adımdan aldığımız ayrıntıları ekleyin:
AZURE_SPEECH_KEY=your_speech_key_1_here
AZURE_SPEECH_REGION=eastus
AZURE_IMAGE_ENDPOINT=https://your-resource-name.services.ai.azure.com/models
AZURE_IMAGE_KEY=your_foundry_key_here
AZURE_IMAGE_DEPLOYMENT=MAI-Image-2
Önemli Not: AZURE_IMAGE_DEPLOYMENT büyük/küçük harfe duyarlıdır. Foundry’de göründüğü haliyle tam olarak MAI-Image-2 kullanın; küçük harfli mai-image-2 unknown_model hatası döndürür.
Bu bölümde, canlı Azure API çağrılarıyla üç MAI modelinin tamamını çağıran, üç sekmeli bir Streamlit uygulaması oluşturacağız. Genel hatlarıyla uygulama şunları yapar:
Dosya kurulumu şöyledir:
mai_demo/
├── app.py            # Streamlit UI
├── mai_clients.py    # Azure API wrappers
├── requirements.txt
└── .env
Uygulama iki dosyaya bölünmüştür: tüm Azure API çağrılarını yapan ve yapılandırılmış sonuç sözlükleri döndüren mai_clients.py ve Streamlit arayüzünü yöneten app.py. Adım adım oluşturalım.
Yerel model kurulumunun aksine, bu uygulama canlı Azure bulut API’lerine bağlanır; bu nedenle bağımlılık listesi hem Azure Speech SDK’yı hem de destekleyici HTTP ve görsel kütüphanelerini içerir.
pip install -r requirements.txtrequirements.txt dosyası şunları içerir:
.txt
streamlit>=1.35.0
azure-cognitiveservices-speech>=1.38.0
requests>=2.31.0
pillow>=10.0.0
python-dotenv>=1.0.0
openai>=1.30.0
Bu projede şunları kullanacağız:
streamlit: üç sekmeli UI, dosya yükleyiciler, ses oynatıcılar ve satır içi görsel gösterimi için
azure-cognitiveservices-speech: MAI-Transcribe-1 ve MAI-Voice-1 ile iletişimde kullanılan Azure Speech SDK için
requests: üç Azure uç noktasına doğrudan REST API çağrıları yapmak için
pillow: MAI-Image-2’nin döndürdüğü görsel baytlarını çözmek ve göstermek için
python-dotenv: çalışma zamanında .env dosyasından Azure anahtarlarını ve uç nokta URL’lerini yüklemek için
openai: Foundry görsel üretim uç noktalarını destekleyen Azure OpenAI uyumlu SDK için
Kurulumdan sonra, uygulamayı çalıştırmadan önce .env dosyasının app.py ile aynı dizinde olduğundan emin olun. Tüm kimlik bilgileri python-dotenv aracılığıyla başlangıçta otomatik olarak yüklenir.
Tüm Azure API çağrıları mai_clients. py dosyasında yer alır; her fonksiyon, UI katmanının bir hatada asla çökmesini önlemek için basit bir {"success": bool, ...} sözlüğü döndürür.
MAI-Transcribe-1, Azure Speech REST API’nin LLM Speech uç noktası üzerinden erişilir. Önemli ayrıntı, bir ses dosyası ve bir JSON tanım nesnesinden oluşan çok parçalı form isteği almasıdır.
def transcribe_audio(audio_bytes: bytes, filename: str = "audio.wav") -> dict:
    url = (
        f"https://{speech_region}.api.cognitive.microsoft.com"
        f"/speechtotext/transcriptions:transcribe?api-version=2024-11-15"
    )
    headers = {"Ocp-Apim-Subscription-Key": speech_key}
    definition = '{"locales":["en-US"],"profanityFilterMode":"None"}'
    files = {
        "audio": (filename, audio_bytes, _mime_type(filename)),
        "definition": (None, definition, "application/json"),
    }
    resp = requests.post(url, headers=headers, files=files, timeout=60)
    data = resp.json()
    combined = " ".join(
        p.get("text", "") for p in data.get("combinedPhrases", [])
    ).strip()
    return {"success": True, "transcript": combined, "raw": data, ...}
Yukarıdaki kod parçasının yanıtı, combinedPhrases adlı bir dizi metin bölümünden oluşan bir JSON nesnesi olarak döner. Bunları tek bir deşifre metni halinde birleştiriyoruz. Desteklenen ses formatları arasında WAV, MP3 ve FLAC bulunur. API şimdilik East US ve West US bölgelerine kilitlidir.
MAI-Voice-1, SSML üzerinden standart Azure Speech TTS kullanır. Anahtar nokta, duygu kontrolü için <mstts:express-as> bloğunu oluşturmak ve doğru ses adı formatına (en-us-Jasper:MAI-Voice-1) referans vermektir.
def _build_ssml(text: str, emotion: str, voice_name: str) -> str:
    style_map = {
        "neutral": None,
        "joy": "joy",
        "excitement": "excitement",
        "empathy": "empathy",
    }
    style = style_map.get(emotion)
    text_block = (
        text if style is None
        else f"<mstts:express-as style='{style}'>{text}</mstts:express-as>"
    )
    return f"""<speak version='1.0' xml:lang='en-US'
        xmlns='http://www.w3.org/2001/10/synthesis'
        xmlns:mstts='http://www.w3.org/2001/mstts'>
      <voice name='{voice_name}'>
        {text_block}
      </voice>
    </speak>"""
MAI-Voice-1 için mevcut ses adları en-us-{Name}:MAI-Voice-1 kalıbını izler. Mevcut listede Jasper, June, Grant, Iris, Reed ve Joy bulunur.
MAI-Image-2, standart Azure OpenAI /openai/deployments/ yolundan farklı, Foundry’ye özgü bir uç nokta kullanır. Doğru uç nokta formatı şöyledir:
url = f"{base_endpoint}/mai/v1/images/generations"Burada base_endpoint, Foundry kaynağımızın kök URL’sidir (örn. https://your-resource.services.ai.azure.com); isteği oluşturmadan önce sonda varsa /models yolu çıkarılmalıdır. İstek gövdesinin iki gereksinimi vardır: Birincisi, standart OpenAI uç noktalarının tersine, model URL yolundan çıkarılmadığı için model alanını dağıtım adınızla açıkça iletmelisiniz:
payload = { "model": deployment, # "MAI-Image-2" "prompt": prompt, "width": width, "height": height, }İkincisi, görsel boyutlarında katı kısıtlar vardır: Hem width hem height en az 768 piksel olmalıdır ve çarpımları 1.048.576’yı aşamaz; bu da kare görseller için en fazla 1024×1024 anlamına gelir. 512×512 vermek veya boyutları hiç iletmemek 400 Bad Request döndürür.
Yanıt, standart OpenAI görsel üretim yapısını izler. Veri dizisindeki her öğe, barındırılan bir görsele işaret eden bir url ya da ham base64 kodlu baytları içeren bir b64_json alanına sahip olur. İstemci her ikisini de işler:
image_url = row.get("url")
b64 = row.get("b64_json")
if b64:
    img_bytes = base64.b64decode(b64)
elif image_url:
    img_resp = requests.get(image_url, timeout=30)
    img_bytes = img_resp.content
url yanıtlarının süre sınırlı olduğunu unutmayın; bu, daha sonra kullanmak üzere URL’yi saklamak yerine baytları hemen alıp önbelleğe almamız gerektiği anlamına gelir.
Uygulama, her model için birer tane olmak üzere üç sekmeye ayrılmıştır. Yapı şöyledir:
import streamlit as st
from mai_clients import transcribe_audio, synthesize_speech, generate_image
tab1, tab2, tab3 = st.tabs([
    "🎙 MAI-Transcribe-1",
    "🔊 MAI-Voice-1",
    "🖼 MAI-Image-2",
])
Her sekme aynı deseni izler: girişler → buton → döndürücü → sonuç gösterimi → maliyet metrikleri.
İlk sekme ses yükleme ve deşifrelemeyi ele alır. WAV, MP3 ve FLAC dosyalarını kabul eder; test ettiğiniz şeyi doğrulayabilmeniz için sesi satır içinde çalar ve baytları butona tıklandığında doğrudan transcribe_audio()’ya gönderir.
with tab1:
    audio_file = st.file_uploader("Upload audio file", type=["wav", "mp3", "flac"])
    if audio_file:
        st.audio(audio_file)
        if st.button("Transcribe", type="primary"):
            with st.spinner("Calling MAI-Transcribe-1..."):
                result = transcribe_audio(audio_file.read(), audio_file.name)
            if result["success"]:
                st.text_area("Transcript", value=result["transcript"], height=140)
                m1, m2, m3 = st.columns(3)
                m1.metric("Latency", f"{result['latency_s']}s")
                m2.metric("Audio duration", f"{result['duration_ms']/1000:.1f}s")
                m3.metric("Est. cost", f"${result['duration_ms']/3_600_000 * 0.36:.5f}")
Başarılı bir yanıtta, deşifre metni düzenlenebilir bir metin alanında görünür; ardından üç metrik gelir: saniye cinsinden API gecikmesi, yanıttaki durationMilliseconds alanından çıkarılan ses süresi ve saat cinsinden süre × $0,36 olarak hesaplanan tahmini maliyet.
7 saniyelik bir parça yaklaşık $0,0000007 tutar; bu nedenle Azure kredinize anlamlı bir etkisi olmadan onlarca test dosyası çalıştırabilirsiniz.
İkinci sekme metinden konuşma sentezini ele alır. MAI-Voice-1’i test etmek için en önemli üç denetimi sunar: metin girdisi, duygu stili ve ses seçimi; bunların tümü doğrudan synthesize_speech() fonksiyonuna aktarılır.
with tab2:
    text_input = st.text_area("Text to synthesize", value="The quarterly results exceeded...")
    emotion = st.selectbox("Emotion / style", ["neutral", "joy", "excitement", "empathy"])
    voice_name = st.selectbox("Voice", ["en-us-Jasper:MAI-Voice-1", "en-us-June:MAI-Voice-1", ...])
    if st.button("Synthesize", type="primary"):
        with st.spinner("Calling MAI-Voice-1..."):
            result = synthesize_speech(text_input, emotion=emotion, voice_name=voice_name)
        if result["success"]:
            st.audio(result["audio_bytes"], format="audio/mp3")
Duygu seçimcisi, arka planda SSML <mstts:express-as> stillerine eşlenir; neutral, temiz temel çıktı için etiketi tamamen atlar; joy, excitement ve empathy ise fark edilir ölçüde farklı tempo ve perde profilleri üretir. Ses açılır listesi, şu anda mevcut altı MAI-Voice-1 sesini kapsar: Jasper, June, Grant, Iris, Reed ve Joy.
Başarı durumunda, döndürülen MP3 baytları satır içi oynatma için doğrudan st.audio()'ya verilir. 113 karakterde tahmini maliyet $0,000002’dir; bu da çok sayıda testi fazla kredi tüketmeden çalıştırabileceğiniz anlamına gelir.
Üçüncü sekme metinden görsele üretimi ele alır. MAI-Image-2’nin mevcut API’si iki girdi parametresi sunar: istem ve çözünürlük. Kalite katmanları veya stil denetimleri yoktur; model bunları dahili olarak yönetir.
with tab3:
    prompt = st.text_area("Image prompt", value="A worn paperback book on a café table...")
    size = st.selectbox("Resolution", ["1024x1024", "1365x768", "768x1365"])
    if st.button("Generate", type="primary"):
        with st.spinner("Calling MAI-Image-2..."):
            result = generate_image(prompt, size=size)
        if result["success"]:
            img = Image.open(io.BytesIO(result["image_bytes"]))
            st.image(img, use_container_width=True)
Üç çözünürlük seçeneği ana en-boy oranlarını kapsar: kare (1024×1024), yatay (1365×768) ve dikey (768×1365). Boyut dizesi, Foundry uç noktası bunları birleştirilmiş bir dize yerine ayrı alanlar olarak aldığı için API’ye gönderilmeden önce ayrı genişlik ve yükseklik tamsayılarına ayrılır.
Başarı durumunda, API yanıtından gelen ham görsel baytları bir BytesIO arabelleğine sarılır, Pillow ile açılır ve tam kap genişliğinde satır içinde gösterilir. Görsel üretimi tipik olarak 2–4 saniye sürer; bu, aynı ortamda MAI-Image-1’e kıyasla belirgin biçimde daha hızlıdır.
.env dosyanız yapılandırılmış ve bağımlılıklar kuruluysa, uygulamayı çalıştırmaya hazırsınız.
streamlit run app.pyStreamlit yerel bir sunucu başlatacak ve uygulamayı tarayıcınızda otomatik olarak http://localhost:8501 adresinde açacaktır. Varsayılan olarak etkin olan MAI-Transcribe-1 ile üç sekmeli arayüzü görmelisiniz.
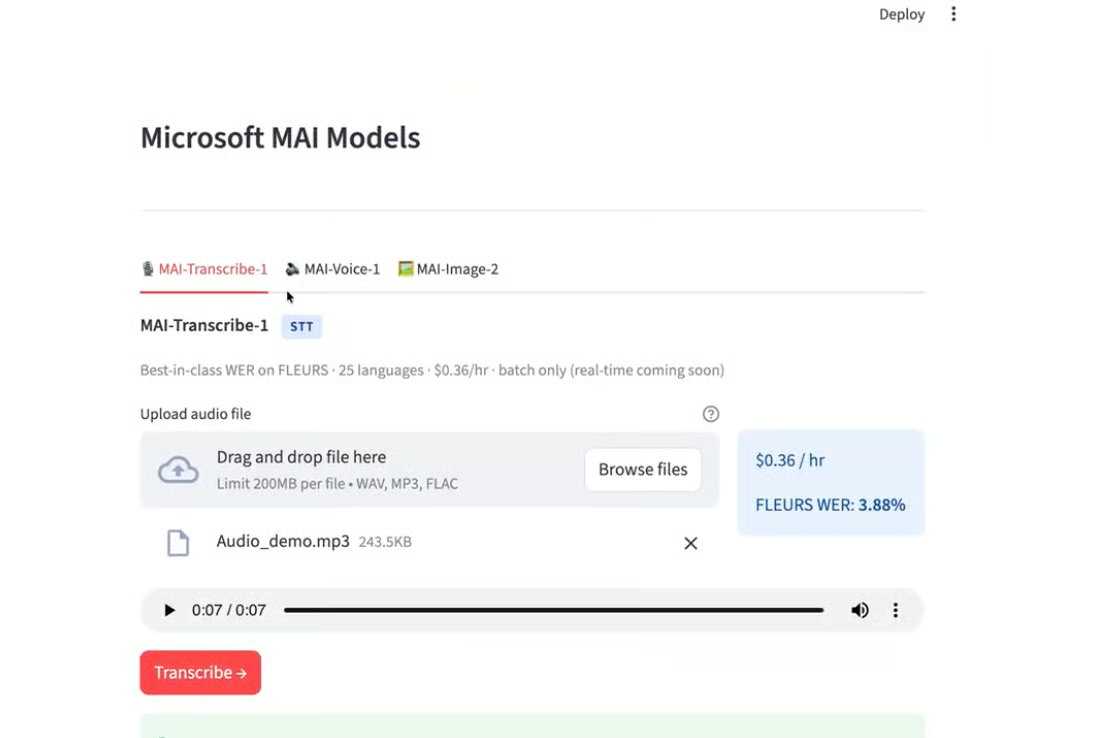
Çalıştırdığımızda modellerin gerçekte ürettiği çıktılar şunlardı.
MAI-Transcribe-1’i, gürültülü ama iyi kaydedilmiş bir ortamda ve Hint aksanıyla kaydedilmiş 7 saniyelik bir ses parçasıyla test ettim. Model, 2 saniyeden kısa sürede temiz ve doğru bir deşifre döndürdü.
Özet: Sonuç, Whisper-large-v3’ün genellikle en çok zorlandığı aksanlı konuşmalarda da iyi performans gösterdi. Bununla birlikte, dil başına sayılar farklı bir tablo sunuyor; örneğin Arapça %10,1 ve Danca %13,2 ile manşet değerin epey üzerinde. Kullanım senaryonuz belirli bir dil veya bölgesel aksan dağılımı içeriyorsa, üretimde bu modele bağlanmadan önce gerçek ses kayıtlarınızla test edin.
en-us-Jasper:MAI-Voice-1 ses modeliyle, heyecan (excitement) stili kullanarak 113 karakterlik bir cümle sentezledim ve model 1 saniyeden kısa sürede 6 saniyelik bir MP3 döndürdü. Çıkışta daha enerjik tempo ve daha yüksek perde varyansı ile duygu açıkça mevcuttu.
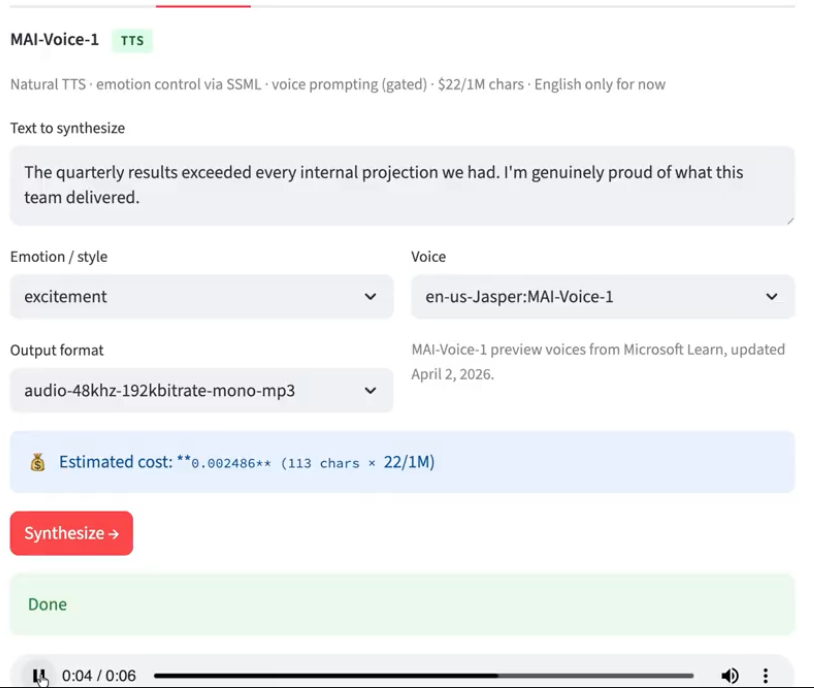
Özet: 1 saniyeden kısa sürede üretilen 6 saniyelik bir parça etkileyici. SSML duygu kontrolü çalışıyor, ancak dört stille sınırlı: neutral, joy, excitement ve empathy. Dolayısıyla, ElevenLabs’in stil kitaplığında bulabileceğiniz tam ifade yelpazesini beklemeyin.
Bu, bilerek iki unsuru birleştiren bir istem seçtiğim için en ilginç test: fotogerçekçi sahne kompozisyonu ve görsel içi metin. Çoğu difüzyon modeli bunlardan en az birinde başarısız olur.
İstem: "Bir kafe masasında yıpranmış bir ciltsiz kitap, doğal pencere ışığı, yanında yükselen espresso buharı. Kitap kapağında şu yazıyor: INFERENCE AT SCALE — metin net okunur, bozulmamış."
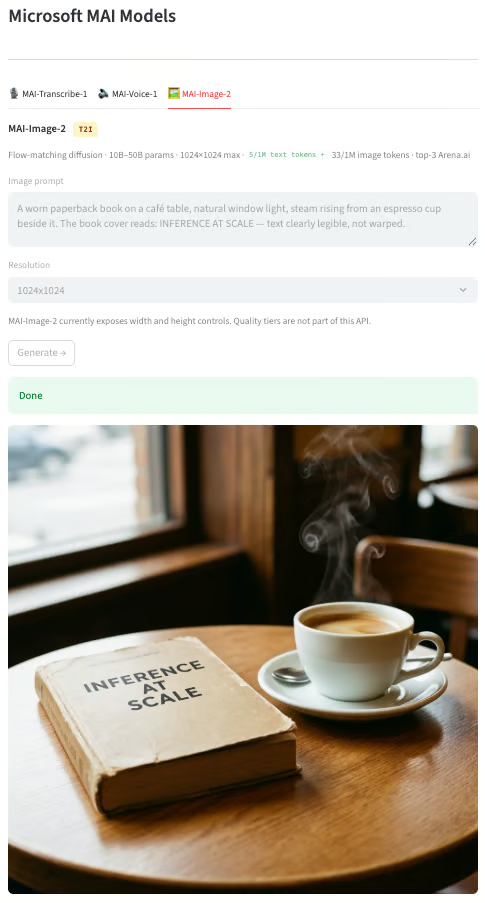
Özet: Doğal pencere aydınlatması, ikna edici buhar ve kitap ile fincandaki inandırıcı doku ile fotogerçekçilik gerçekten güçlü. "INFERENCE AT SCALE" metni de doğru ve okunaklı biçimde oluşturuldu.
Ancak metin oluşturma, çalıştırmalar arasında tutarsız. Benzer istemlerle yapılan çoklu denemelerde modelin zaman zaman yanlış yazılmış veya bozulmuş metin ürettiği görüldü. Bu, tüm güncel difüzyon modelleri için bilinen bir başarısızlık türüdür; MAI-Image-2 çoğundan daha iyi olsa da bağışık değildir. Ayrıca, mevcut maksimum çözünürlük 1024×1024 pikseldir; bu, çoğu web ve içerik kullanım senaryosu için yeterli olsa da, bir yükseltme adımı olmadan baskı kalitesini veya büyük formatlı yaratıcı çalışmaları dışlar. Metin doğruluğunun kritik olduğu görseller üretiyorsanız, mutlaka insan denetimi ekleyin.
Microsoft’un MAI model ailesi gerçekten etkileyici; MAI-Transcribe-1’in FLEURS sayıları üçü arasında en nesnel olarak doğrulanabilir olanı ve şu an itibarıyla sınıfının en iyisi olan %3,88 ortalama WER ile bunu destekliyor.
MAI-Voice-1 hız ve ses kalitesi açısından etkileyici, ancak yalnızca İngilizce desteği ve sınırlı duygu paletiyle kısıtlı. MAI-Image-2 güçlü fotogerçekçi çıktılar üretiyor; ancak metin halüsinasyonlarının hâlâ gerçekleştiği ve üretimde insan denetimi gerektirdiği önemli notuyla birlikte.
Bu öğreticinin tüm kodu GitHub’da mevcuttur.
DataCamp ile öğrenin
Program
Program
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



