
Leerpad
AI voor softwareontwikkeling
7 uur
Microsofts MAI-modelreeks is gebouwd door het Microsoft AI Superintelligence-team. Het zijn volledig interne modellen, getraind op Microsofts eigen infrastructuur, geoptimaliseerd voor Microsofts serving-stack en rechtstreeks via Azure ingezet. MAI-Transcribe-1 en MAI-Voice-1 draaien op dezelfde Azure Speech-infrastructuur die al op schaal enterprise-klanten bedient, terwijl MAI-Image-2 een flow-matching diffusiemodel gebruikt met hetzelfde trainingsdoel als achter Stable Diffusion 3, met tussen de 10 en 50 miljard non-embedding parameters.
Hier is de korte samenvatting van alle drie:
|
Model |
Taak |
Kerngetal |
Prijs |
|
MAI-Transcribe-1 |
Spraak naar tekst |
3,88% gem. WER op FLEURS |
$0,36/uur |
|
MAI-Voice-1 |
Tekst naar spraak |
60s audio in 1s |
$22/1M tekens |
|
MAI-Image-2 |
Tekst naar afbeelding |
Elo 1190 totaal |
$5/1M tekst + $33/1M afbeeldings-tokens |
Laten we dieper ingaan op elk model voordat we gaan bouwen.
MAI-Transcribe-1 is een spraak-naar-tekstmodel dat 25 talen ondersteunt. De headlineclaim is een gemiddelde Word Error Rate (WER) van 3,88% op de FLEURS-benchmark; lager is beter. Daarmee staat het voor GPT-Transcribe (4,17%), Scribe v2 (4,32%), Gemini 3.1 Flash-Lite (4,89%) en Whisper-large-v3 (7,60%).
Het model is specifiek gebouwd voor rommelige real-world audio, inclusief lawaaierige omgevingen, gemengde accenten en natuurlijke spreekstijlen. Microsoft claimt ook dat MAI-Transcribe-1 goede nauwkeurigheid levert tegen ongeveer 50% lagere GPU-kosten dan toonaangevende alternatieven, wat een wezenlijk voordeel is voor enterprises die op schaal transcriberen.
Het mist echter nog steeds real-time transcriptie, speaker diarization en contextbiasing; allemaal vermeld als "binnenkort beschikbaar."
MAI-Voice-1 is Microsofts high-fidelity TTS-model. De kernfunctie is voice prompting: je levert een audiofragment van 10 seconden aan en het model kloont die stem zonder fine-tuning. Voice cloning vereist echter goedkeuring via een toegangspoort bij Microsoft, maar de gecureerde stemmenbibliotheek (namen zoals en-us-Jasper:MAI-Voice-1, en-us-June:MAI-Voice-1) is direct beschikbaar.
Het model genereert 60 seconden audio in één seconde op één GPU, ondersteunt per-beurt emotiecontrole via SSML en is gebouwd voor long-form content zoals audioboeken en podcasts. Het ligt al onder de motorkap van Copilot's Audio Expressions en podcastfeatures in Microsofts eigen producten.
Een nadeel is dat het model "alleen Engels" ondersteunt, met binnenkort 10+ talen in aantocht.
MAI-Image-2 gebruikt een flow-matching diffusiemodel met 10–50 miljard parameters. Het staat in de top-3 op de afbeeldingsranglijst van Arena.ai en is 2× sneller dan MAI-Image-1 in productie. Het model is ontwikkeld in samenwerking met fotografen, ontwerpers en visuele vertellers, en draait al in Copilot, Bing Image Creator en PowerPoint. Het is met name gebouwd voor fotorealisme, nauwkeurige huidtinten en leesbare tekst in de afbeelding.
De Elo-scores per categorie omvatten photorealistic (1201) en portraits (1201), waar het uitblinkt, terwijl text rendering (1186) beter is dan voorheen maar nog steeds de zwakste categorie blijft.
Alle drie de MAI-modellen zijn beschikbaar op Microsoft Azure. MAI-Transcribe-1 en MAI-Voice-1 delen dezelfde Azure Speech-resource, terwijl MAI-Image-2 via Microsoft Foundry loopt. Laten we ze één voor één instellen.
Zowel MAI-Transcribe-1 als MAI-Voice-1 zijn toegankelijk via de Azure AI Speech-service, dus één resource dekt beide.
Ga naar portal.azure.com
Typ in de zoekbalk Speech en selecteer Speech services
Klik op + Create
Vul het formulier in:
Resourcegroep: Maak een nieuwe resourcegroep en noem die mai-demo-rg
Regio: Kies East US omdat MAI-modellen momenteel alleen in East US en West US worden ondersteund
Naam: mai-speech-demo
Prijscategorie: Standard S0
Opmerking: Free F0 heeft rate limits die de demo kunnen onderbreken
Klik tot slot op Review and create, en na even laden op Create.
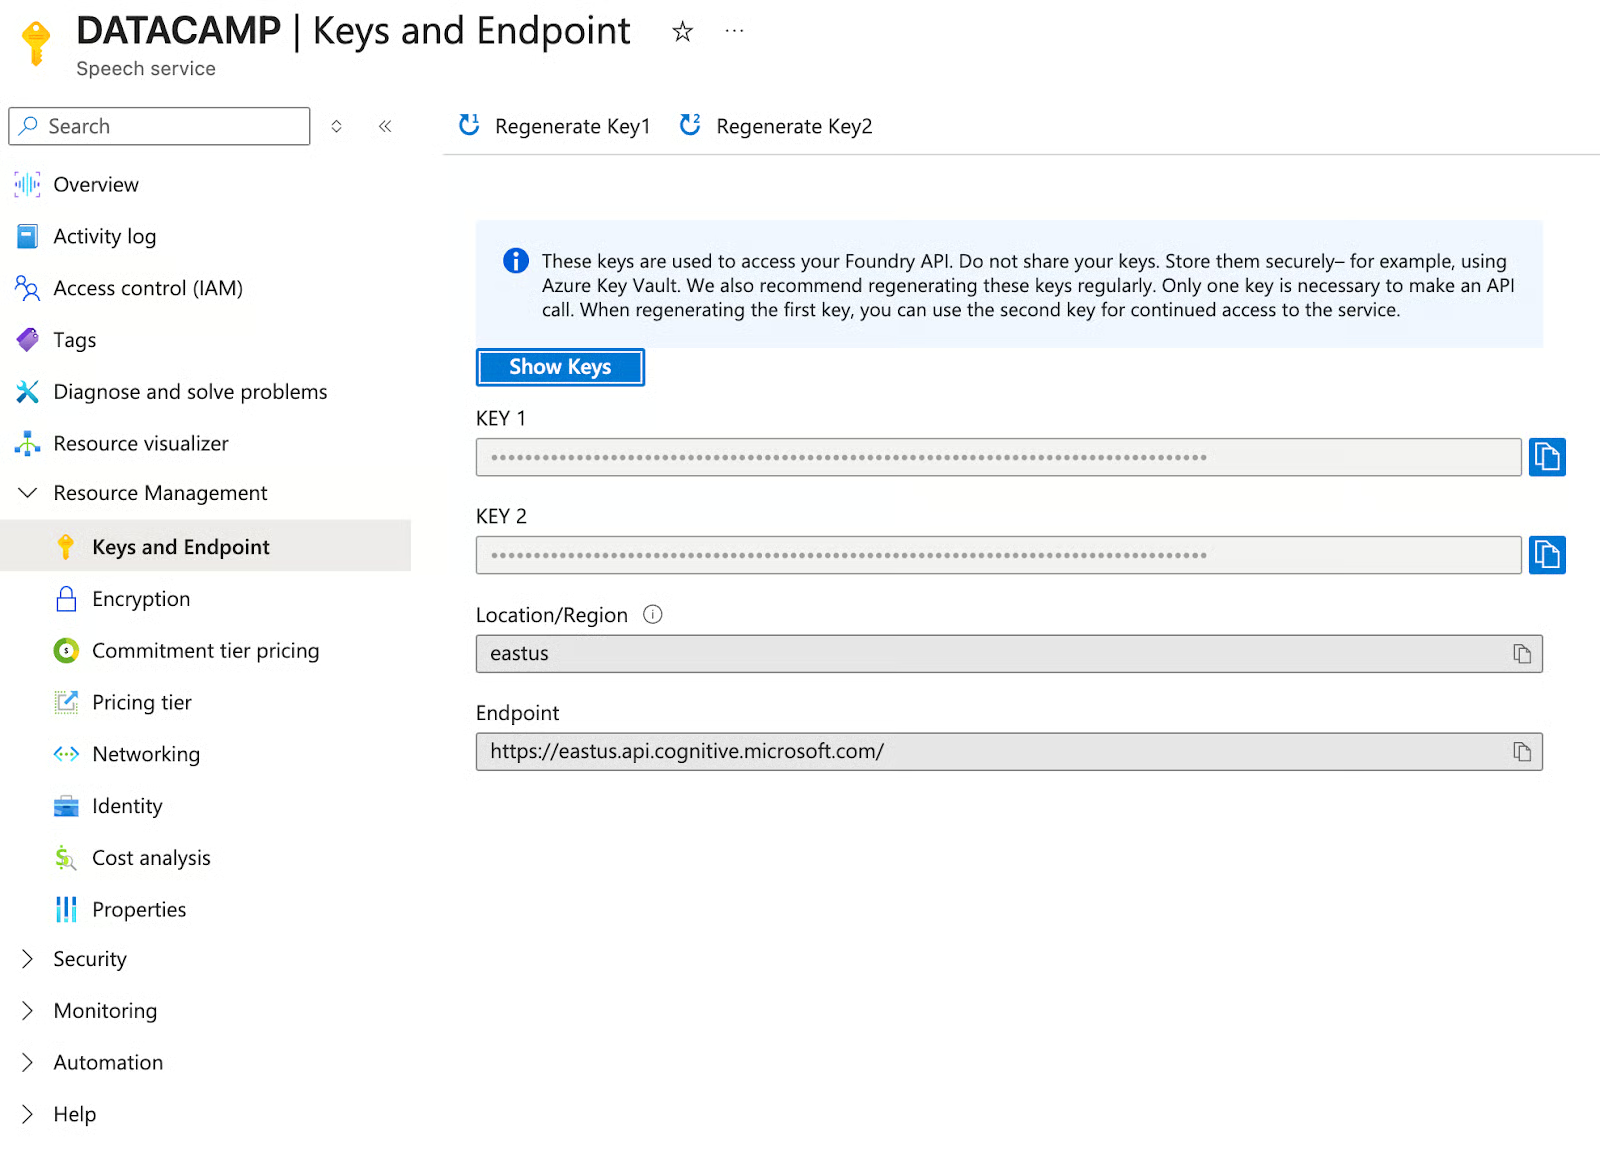
Zodra de deployment klaar is, ga je naar Keys and Endpoint in de linkerzijbalk en kopieer je Key 1 en noteer je de Region-waarde (eastus).
MAI-Image-2 is toegankelijk via Microsoft Foundry, los van de reguliere Azure-portal.
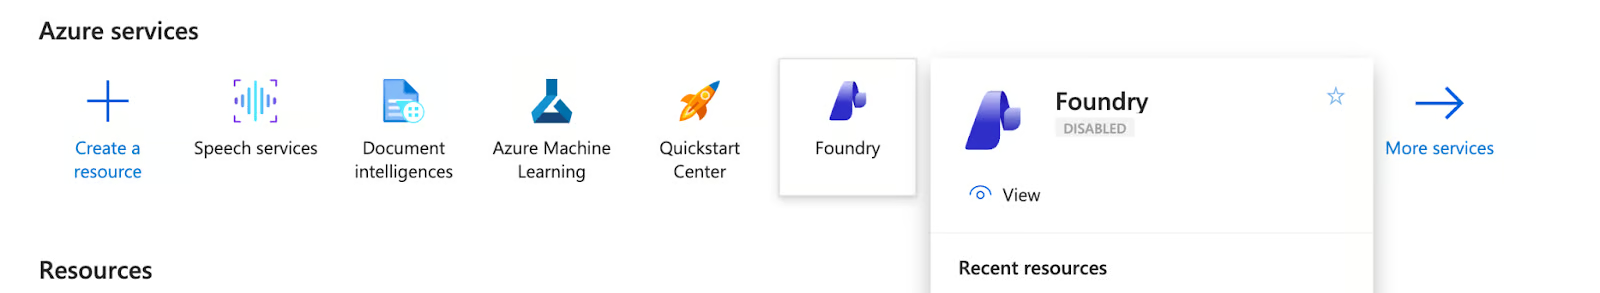
Klik vanaf de homepage van de Azure-portal op Foundry in de rij met topservices
Klik op Create a resource
Vul vervolgens het volgende in:
Resourcegroep: Selecteer dezelfde mai-demo-rg uit Stap 1
Regio: East US
Naam: mai-image-demo
Standaard projectnaam: proj-default
Klik daarna op Review and create, en druk op Create
Zodra de resource live is, klik je op Go to Foundry portal.
Klik vervolgens in de Foundry-interface op Model catalog in de linkerzijbalk
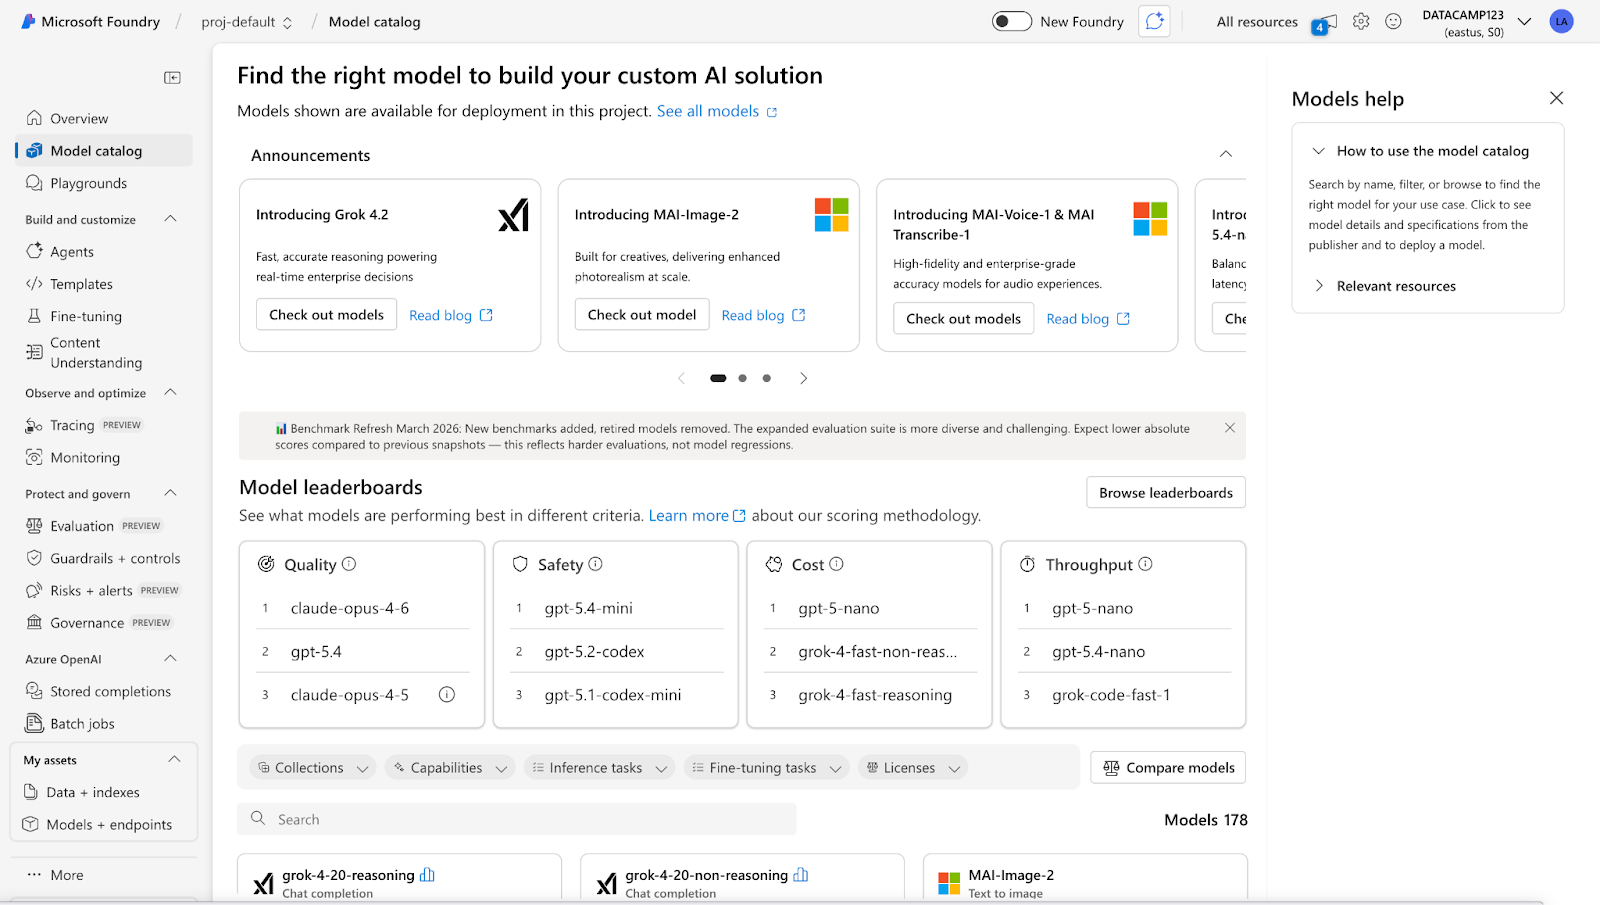
MAI in de zoekbalk en je ziet alle vier de MAI-modellen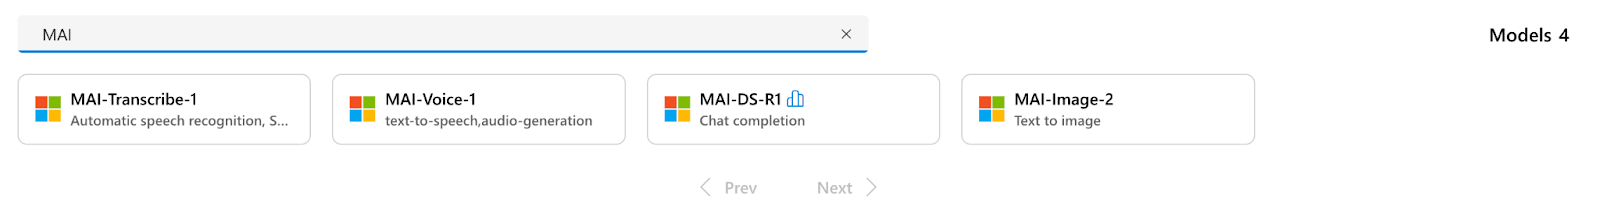
Selecteer MAI-Image-2 en klik op Use this model
Stel in het deploy-dialoogvenster het volgende in:
Deploymentnaam: MAI-Image-2
Deploymenttype: Global Standard
Klik ten slotte op deploy
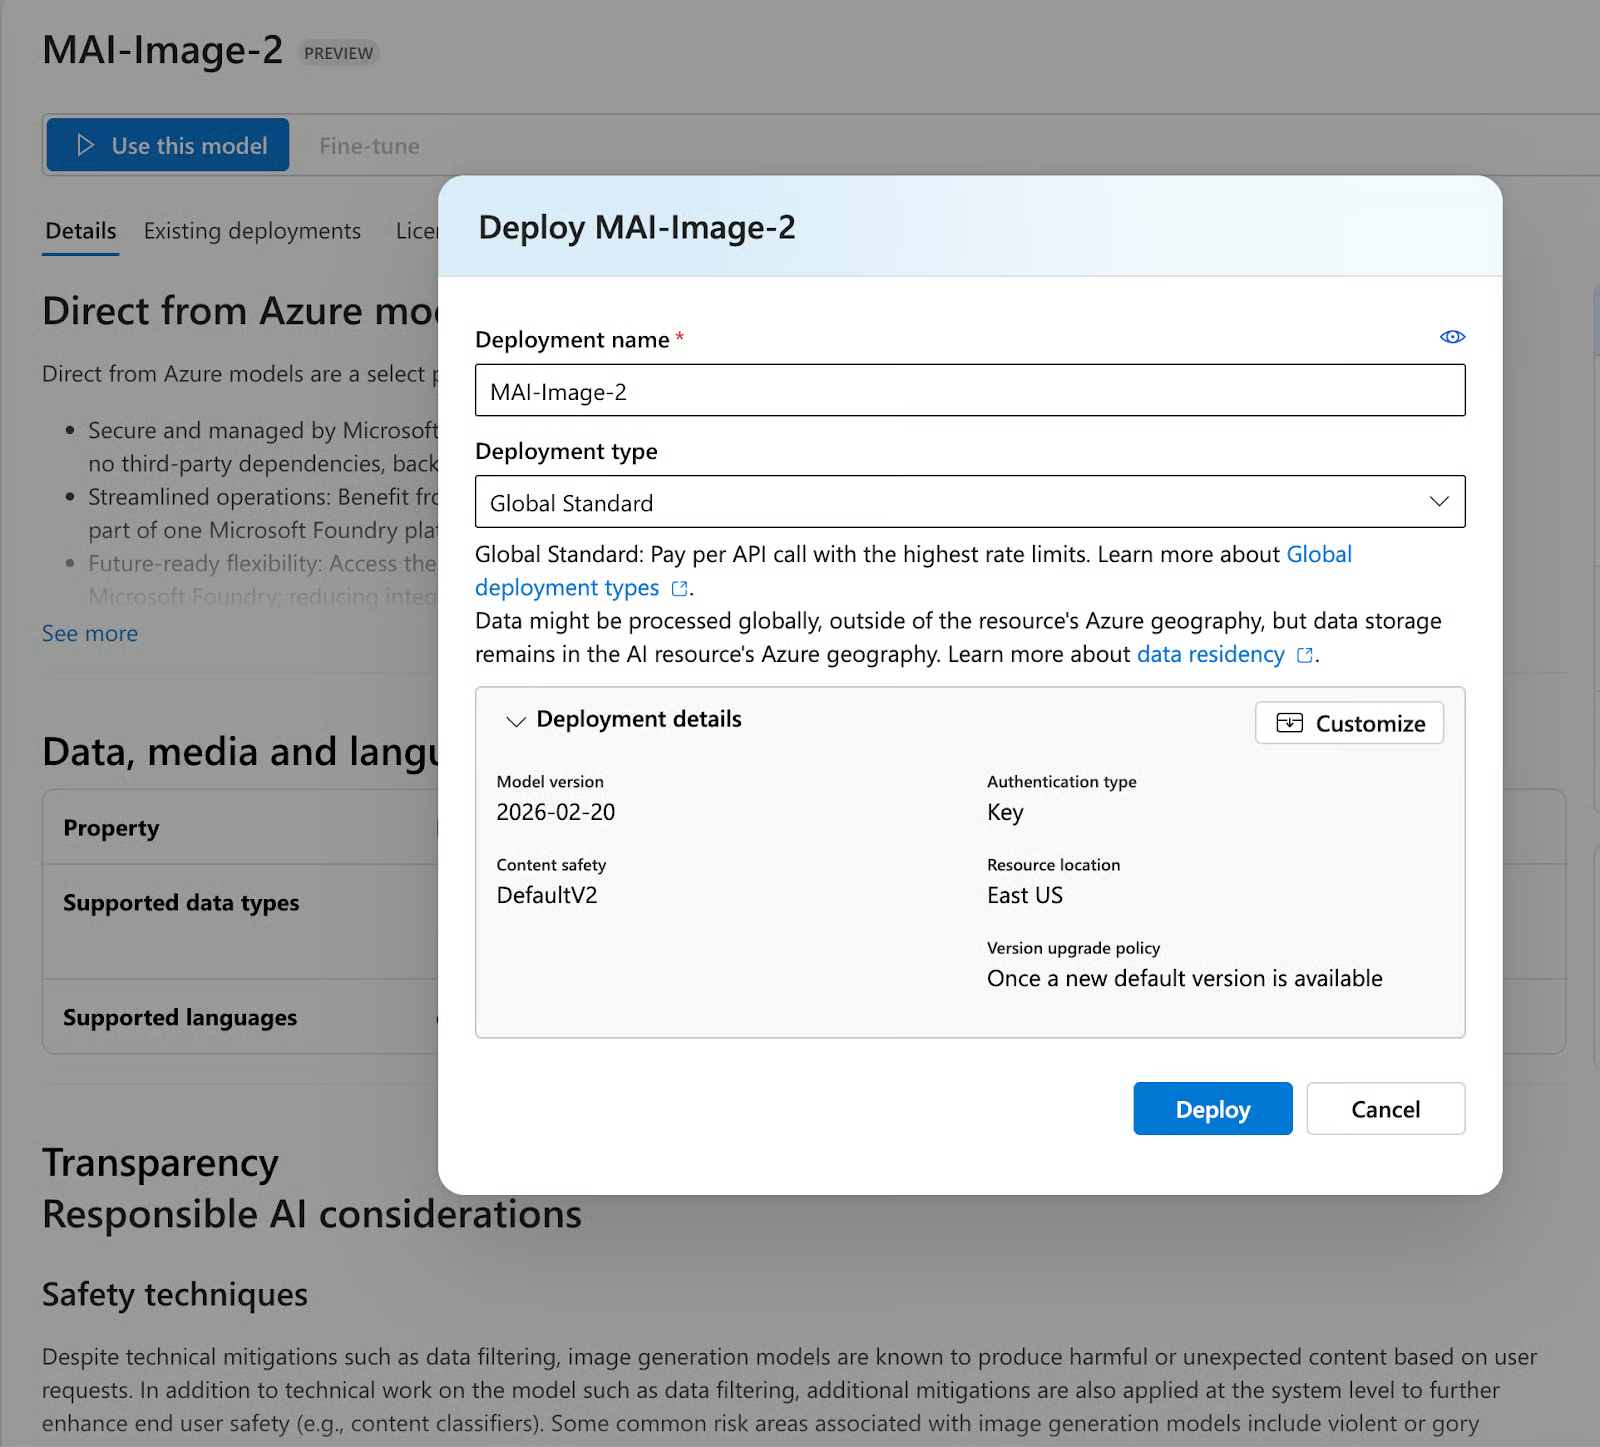
Na de deployment kom je op de deploydetails-pagina. Kopieer de Target URI (iets als https://mai-image-demo.services.ai.azure.com/models) en de Key.
Maak een .env-bestand in je lokale projectmap en voeg de gegevens toe die we in de vorige twee stappen hebben opgehaald:
AZURE_SPEECH_KEY=your_speech_key_1_here
AZURE_SPEECH_REGION=eastus
AZURE_IMAGE_ENDPOINT=https://your-resource-name.services.ai.azure.com/models
AZURE_IMAGE_KEY=your_foundry_key_here
AZURE_IMAGE_DEPLOYMENT=MAI-Image-2
Belangrijke opmerking: AZURE_IMAGE_DEPLOYMENT is hoofdlettergevoelig. Gebruik MAI-Image-2 precies zoals het in Foundry staat; kleine letters mai-image-2 geeft een unknown_model-fout.
In deze sectie bouwen we een Streamlit-app met drie tabbladen die alle drie de MAI-modellen aanroept via live Azure API-calls. Op hoofdlijnen doet de app het volgende:
Zo ziet de bestandensetup eruit:
mai_demo/
├── app.py            # Streamlit UI
├── mai_clients.py    # Azure API wrappers
├── requirements.txt
└── .env
De app is opgesplitst in twee files: mai_clients.py, dat alle Azure API-calls afhandelt en gestructureerde resultaatdicts teruggeeft, en app.py, dat de Streamlit-UI afhandelt. Laten we het stap voor stap bouwen.
In tegenstelling tot een lokale modelsetup, verbindt deze app met live Azure-cloud-API’s, dus de afhankelijkheden bevatten zowel de Azure Speech SDK als ondersteunende HTTP- en afbeeldingsbibliotheken.
pip install -r requirements.txtHet requirements.txt-bestand bevat:
.txt
streamlit>=1.35.0
azure-cognitiveservices-speech>=1.38.0
requests>=2.31.0
pillow>=10.0.0
python-dotenv>=1.0.0
openai>=1.30.0
In dit project gebruiken we:
streamlit voor de UI met drie tabbladen, file uploaders, audioplayers en inline weergave van afbeeldingen
azure-cognitiveservices-speech voor de Azure Speech SDK, gebruikt om te communiceren met MAI-Transcribe-1 en MAI-Voice-1
requests om directe REST API-calls te doen naar alle drie Azure-endpoints
pillow om de door MAI-Image-2 teruggestuurde afbeeldingsbytes te decoderen en weer te geven
python-dotenv om Azure-sleutels en endpoint-URL’s uit het .env-bestand te laden tijdens runtime
openai voor de Azure OpenAI-compatibele SDK, die Foundry-endpoints voor afbeeldingsgeneratie ondersteunt
Zodra alles is geïnstalleerd, zorg je dat het .env-bestand in dezelfde map staat als app.py voordat je de app draait. Het laden van credentials gebeurt automatisch bij het opstarten via python-dotenv.
Alle Azure API-calls staan in mai_clients. py ', where each function returns a simple {"success": bool, ...}`-dictionary zodat de UI-laag nooit crasht bij een fout.
MAI-Transcribe-1 is toegankelijk via het LLM Speech-endpoint van de Azure Speech REST API. Belangrijk detail: het accepteert een multipart form-request in de vorm van een audiobestand en een JSON-definitieobject.
def transcribe_audio(audio_bytes: bytes, filename: str = "audio.wav") -> dict:
    url = (
        f"https://{speech_region}.api.cognitive.microsoft.com"
        f"/speechtotext/transcriptions:transcribe?api-version=2024-11-15"
    )
    headers = {"Ocp-Apim-Subscription-Key": speech_key}
    definition = '{"locales":["en-US"],"profanityFilterMode":"None"}'
    files = {
        "audio": (filename, audio_bytes, _mime_type(filename)),
        "definition": (None, definition, "application/json"),
    }
    resp = requests.post(url, headers=headers, files=files, timeout=60)
    data = resp.json()
    combined = " ".join(
        p.get("text", "") for p in data.get("combinedPhrases", [])
    ).strip()
    return {"success": True, "transcript": combined, "raw": data, ...}
De response van bovenstaande code komt terug als een JSON-object met combinedPhrases, een array van tekstsegmenten. We voegen die samen tot één transcriptiestring. Ondersteunde audioformaten zijn onder meer WAV, MP3 en FLAC. De API is voorlopig regiogebonden aan East US en West US.
MAI-Voice-1 gebruikt standaard Azure Speech TTS via SSML. De kern is het opbouwen van het <mstts:express-as>-blok voor emotiecontrole en de juiste stemnaamreferentie (en-us-Jasper:MAI-Voice-1).
def _build_ssml(text: str, emotion: str, voice_name: str) -> str:
    style_map = {
        "neutral": None,
        "joy": "joy",
        "excitement": "excitement",
        "empathy": "empathy",
    }
    style = style_map.get(emotion)
    text_block = (
        text if style is None
        else f"<mstts:express-as style='{style}'>{text}</mstts:express-as>"
    )
    return f"""<speak version='1.0' xml:lang='en-US'
        xmlns='http://www.w3.org/2001/10/synthesis'
        xmlns:mstts='http://www.w3.org/2001/mstts'>
      <voice name='{voice_name}'>
        {text_block}
      </voice>
    </speak>"""
De beschikbare stemnamen voor MAI-Voice-1 volgen het patroon en-us-{Name}:MAI-Voice-1. De huidige lijst omvat Jasper, June, Grant, Iris, Reed en Joy.
MAI-Image-2 gebruikt een Foundry-specifiek endpoint, niet het standaard Azure OpenAI-pad /openai/deployments/. De juiste endpointvorm is:
url = f"{base_endpoint}/mai/v1/images/generations"Hier is de base_endpoint de root van onze Foundry-resource-URL (bijv. https://your-resource.services.ai.azure.com), waarbij een eventuele trailing /models-path wordt verwijderd voordat je de request opbouwt. De requestbody heeft twee vereisten: je moet expliciet het veld model meesturen met je deploymentnaam, in tegenstelling tot standaard OpenAI-endpoints waar het model uit het pad wordt afgeleid:
payload = { "model": deployment, # "MAI-Image-2" "prompt": prompt, "width": width, "height": height, }Ten tweede hebben de afmetingen harde beperkingen: zowel width als height moeten minimaal 768 pixels zijn, en hun product mag niet groter zijn dan 1.048.576, wat neerkomt op maximaal 1024×1024 voor vierkant. 512×512 meegeven of afmetingen weglaten resulteert in 400 Bad Request.
De response volgt de standaard OpenAI-structuur voor afbeeldingsgeneratie. Elk item in de data-array bevat ofwel een url naar een gehoste afbeelding of een b64_json-veld met rauwe base64-gecodeerde bytes. De client kan beide aan:
image_url = row.get("url")
b64 = row.get("b64_json")
if b64:
    img_bytes = base64.b64decode(b64)
elif image_url:
    img_resp = requests.get(image_url, timeout=30)
    img_bytes = img_resp.content
Let op dat url-responses tijdgebonden zijn; je moet de bytes dus direct ophalen en cachen in plaats van de URL te bewaren voor later.
De app is georganiseerd in drie tabbladen, één per model. Dit is de structuur:
import streamlit as st
from mai_clients import transcribe_audio, synthesize_speech, generate_image
tab1, tab2, tab3 = st.tabs([
    "🎙 MAI-Transcribe-1",
    "🔊 MAI-Voice-1",
    "🖼 MAI-Image-2",
])
Elk tabblad volgt hetzelfde patroon: invoer → knop → spinner → resultaatweergave → kostenmetrics.
Het eerste tabblad handelt het uploaden en transcriberen van audio af. Het accepteert WAV-, MP3- en FLAC-bestanden, speelt de audio inline af zodat je kunt verifiëren wat je test, en stuurt de bytes direct naar transcribe_audio() bij een button click.
with tab1:
    audio_file = st.file_uploader("Upload audio file", type=["wav", "mp3", "flac"])
    if audio_file:
        st.audio(audio_file)
        if st.button("Transcribe", type="primary"):
            with st.spinner("Calling MAI-Transcribe-1..."):
                result = transcribe_audio(audio_file.read(), audio_file.name)
            if result["success"]:
                st.text_area("Transcript", value=result["transcript"], height=140)
                m1, m2, m3 = st.columns(3)
                m1.metric("Latency", f"{result['latency_s']}s")
                m2.metric("Audio duration", f"{result['duration_ms']/1000:.1f}s")
                m3.metric("Est. cost", f"${result['duration_ms']/3_600_000 * 0.36:.5f}")
Bij een succesvolle response verschijnt de transcriptie in een bewerkbaar tekstvak, gevolgd door drie metrics: API-latency in seconden, de audioduur uit het veld durationMilliseconds, en een geschatte kostprijs berekend als duration_in_hours × $0,36.
Een fragment van 7 seconden kost ruwweg $0,0000007, dus je kunt tientallen testbestanden draaien zonder je Azure-tegoed noemenswaardig te belasten.
Het tweede tabblad behandelt tekst-naar-spraak. Het biedt de drie belangrijkste regelaars voor het testen van MAI-Voice-1: de tekstinvoer, de emotionele stijl en de stemselectie; die gaan allemaal rechtstreeks naar de functie synthesize_speech().
with tab2:
    text_input = st.text_area("Text to synthesize", value="The quarterly results exceeded...")
    emotion = st.selectbox("Emotion / style", ["neutral", "joy", "excitement", "empathy"])
    voice_name = st.selectbox("Voice", ["en-us-Jasper:MAI-Voice-1", "en-us-June:MAI-Voice-1", ...])
    if st.button("Synthesize", type="primary"):
        with st.spinner("Calling MAI-Voice-1..."):
            result = synthesize_speech(text_input, emotion=emotion, voice_name=voice_name)
        if result["success"]:
st.audio(result["audio_bytes"], format="audio/mp3")De emotieselector wordt onder water gemapt naar SSML-stijlen in <mstts:express-as>; neutral laat de tag weg voor een schone baseline-output, terwijl joy, excitement en empathy duidelijk verschillende timing- en toonprofielen opleveren. De stemdropdown omvat de zes momenteel beschikbare MAI-Voice-1-stemmen: Jasper, June, Grant, Iris, Reed en Joy.
Bij succes worden de teruggestuurde MP3-bytes rechtstreeks doorgegeven aan st.audio() voor inline afspelen. Bij 113 tekens is de geschatte kost $0,000002, dus je kunt meerdere tests uitvoeren zonder veel tegoed te verbruiken.
Het derde tabblad behandelt tekst-naar-afbeelding. De huidige API van MAI-Image-2 biedt twee inputparameters: prompt en resolutie. Er zijn geen kwaliteitsniveaus of stijlregelaars; het model handelt dat intern af.
with tab3:
    prompt = st.text_area("Image prompt", value="A worn paperback book on a café table...")
    size = st.selectbox("Resolution", ["1024x1024", "1365x768", "768x1365"])
    if st.button("Generate", type="primary"):
        with st.spinner("Calling MAI-Image-2..."):
            result = generate_image(prompt, size=size)
        if result["success"]:
            img = Image.open(io.BytesIO(result["image_bytes"]))
            st.image(img, use_container_width=True)
De drie resolutieopties dekken de belangrijkste beeldverhoudingen: vierkant (1024×1024), liggend (1365×768) en staand (768×1365). De formatenstring wordt geparseerd naar aparte integers voor breedte en hoogte voordat deze naar de API gaat, omdat het Foundry-endpoint ze als afzonderlijke velden verwacht.
Bij succes worden de ruwe afbeeldingsbytes uit de API-response in een BytesIO-buffer gewikkeld, met Pillow geopend en inline op volledige containerbreedte weergegeven. Afbeeldingsgeneratie duurt meestal 2–4 seconden, merkbaar sneller dan MAI-Image-1 in dezelfde omgeving.
Met je .env-bestand geconfigureerd en de afhankelijkheden geïnstalleerd, ben je klaar om de app te starten.
streamlit run app.pyStreamlit start een lokale server en opent de app automatisch in je browser op http://localhost:8501. Je zou de interface met drie tabbladen moeten zien, waarbij MAI-Transcribe-1 standaard actief is.
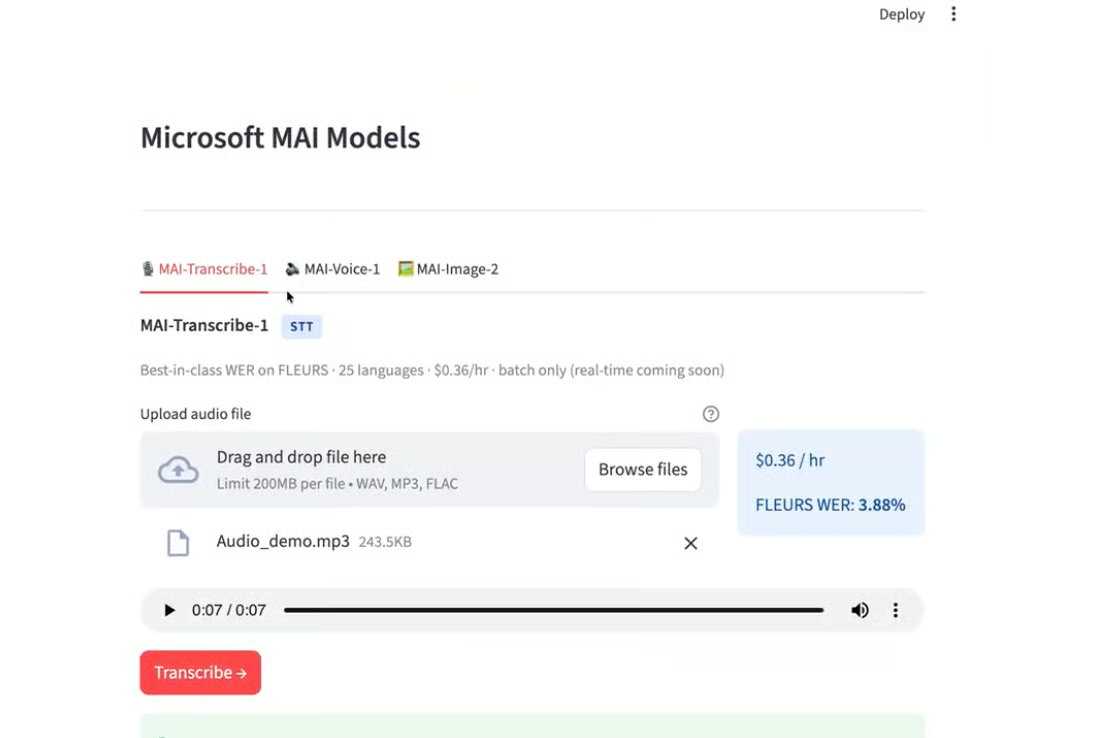
Dit is wat de modellen daadwerkelijk opleverden toen we ze draaiden.
Ik testte MAI-Transcribe-1 met een audiofragment van 7 seconden, opgenomen in een optimaal ruisachtige omgeving met een Indiaas accent. Het model gaf binnen 2 seconden een schone, nauwkeurige transcriptie terug.
Conclusie: Het resultaat hield goed stand bij geaccentueerde spraak, waar Whisper-large-v3 doorgaans het meest worstelt. Dat gezegd hebbende, per-taalresultaten vertellen een ander verhaal; Arabisch zit op 10,1% en Deens op 13,2%, beide ruim boven het headlinecijfer. Als je use case een specifieke taal of accentverdeling omvat, test dan met je eigen audio voordat je het model in productie inzet.
Ik synthetiseerde een zin van 113 tekens met de stijl "excitement" met de stem en-us-Jasper:MAI-Voice-1, en kreeg een MP3 van 6 seconden terug in minder dan 1 seconde. De emotie was duidelijk aanwezig, met energieker tempo en grotere toonhoogtevariatie.
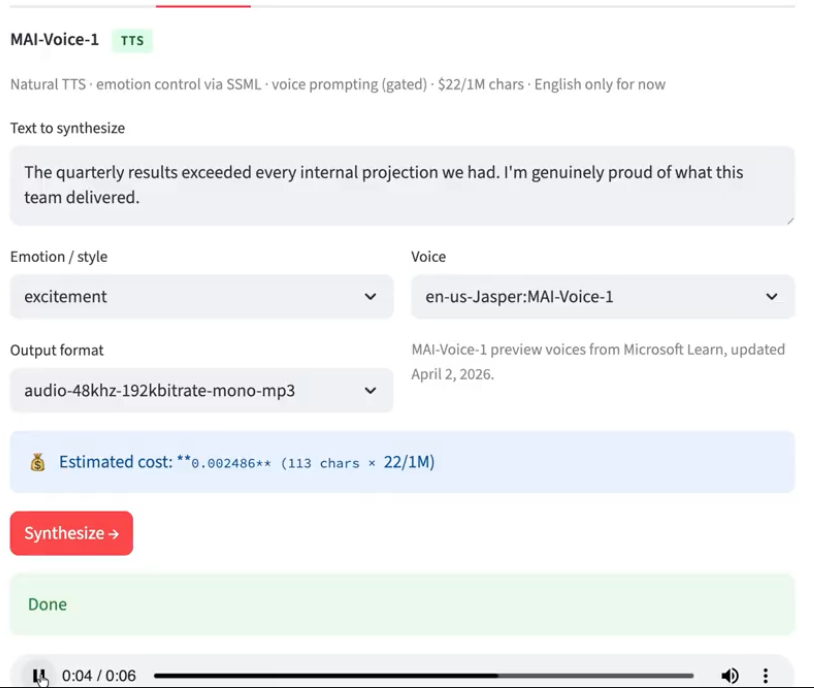
Conclusie: Een clip van 6 seconden die in minder dan 1 seconde wordt gegenereerd is indrukwekkend. De SSML-emotiecontrole werkt, maar is beperkt tot vier stijlen: neutral, joy, excitement en empathy. Verwacht dus niet het volledige expressiebereik zoals in de stijlenbibliotheek van ElevenLabs.
Dit is de interessantste test omdat ik bewust een prompt koos die twee dingen combineert: fotorealistische scènecompositie en tekst in de afbeelding. De meeste diffusiemodellen falen in elk geval op één van deze twee.
Prompt: "A worn paperback book on a café table, natural window light, steam rising from an espresso cup beside it. The book cover reads: INFERENCE AT SCALE — text clearly legible, not warped."
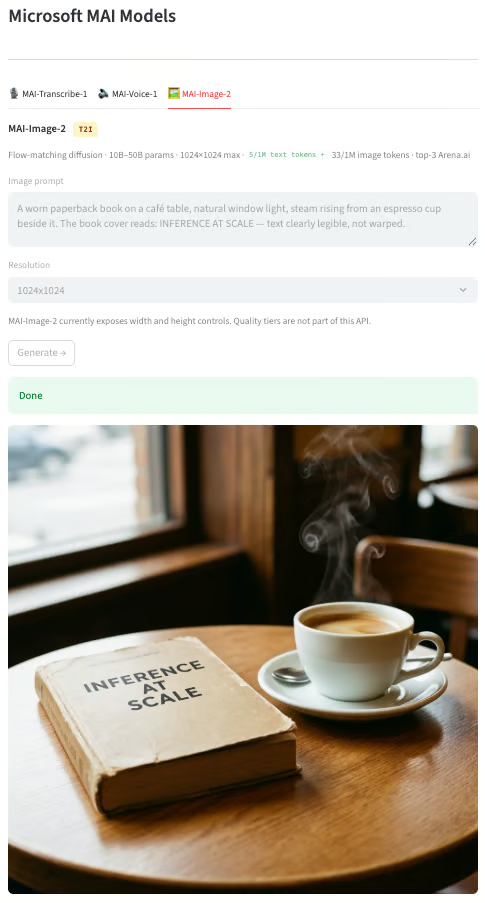
Conclusie: Het fotorealisme is echt sterk met natuurlijk raamlicht, overtuigende stoom en geloofwaardige textuur op het boek en het kopje. De tekst "INFERENCE AT SCALE" werd ook correct en leesbaar weergegeven.
De tekstweergave is echter inconsistent over runs. In meerdere testgeneraties met vergelijkbare prompts produceerde het model af en toe verkeerd gespelde of vervormde tekst. Dit is een bekende faalmodus voor alle huidige diffusiemodellen; MAI-Image-2 is beter dan de meeste, maar niet immuun. Ook is de huidige maximale resolutie 1024×1024 pixels, wat voor de meeste web- en contenttoepassingen voldoende is, maar printkwaliteit of grootformaat creatief werk uitsluit zonder upscalingstap. Als je afbeeldingen genereert waar tekstnauwkeurigheid cruciaal is, zorg dan altijd voor een menselijke reviewstap.
Microsofts MAI-modelfamilie is oprecht indrukwekkend; de FLEURS-cijfers van MAI-Transcribe-1 zijn het meest objectief verifieerbaar van de drie, met een gemiddelde WER van 3,88%, best-in-class op het moment van schrijven.
MAI-Voice-1 is indrukwekkend qua snelheid en geluidskwaliteit maar beperkt door alleen-Engels-ondersteuning en een beperkte emotieset. MAI-Image-2 levert sterk fotorealistisch werk, met de belangrijke kanttekening dat teksthallucinaties nog steeds voorkomen en in productie een menselijke review vragen.
De volledige code voor deze tutorial staat op GitHub.
Leer met DataCamp
Leerpad
Leerpad
Cursus
blog
Adel Nehme
15 min

