
लर्निंग पाथ
सॉफ़्टवेयर इंजीनियरिंग के लिए AI
7 घंटा
Microsoft की MAI मॉडल फैमिली Microsoft AI Superintelligence टीम द्वारा बनाई गई है। ये पूरी तरह इन-हाउस मॉडल हैं, जिन्हें Microsoft के अपने इंफ्रास्ट्रक्चर पर प्रशिक्षित किया गया है, Microsoft के सर्विंग स्टैक के लिए ऑप्टिमाइज़ किए गए हैं, और सीधे Azure के जरिए डिप्लॉय किए गए हैं। MAI-Transcribe-1 और MAI-Voice-1 मॉडल वही Azure Speech इंफ्रास्ट्रक्चर पर चलते हैं जो एंटरप्राइज ग्राहकों को स्केल पर सर्व करता है, जबकि MAI-Image-2 फ्लो-मैचिंग डिफ्यूजन आर्किटेक्चर का उपयोग करता है, जिसका ट्रेनिंग ऑब्जेक्टिव Stable Diffusion 3 के समान है, और इसमें 10 से 50 बिलियन नॉन-एंबेडिंग पैरामीटर्स हैं।
यहाँ तीनों का त्वरित सारांश है:
|
मॉडल |
कार्य |
मुख्य संख्या |
मूल्य |
|
MAI-Transcribe-1 |
स्पीच से टेक्स्ट |
FLEURS पर 3.88% औसत WER |
$0.36/घंटा |
|
MAI-Voice-1 |
टेक्स्ट से स्पीच |
1 सेकंड में 60 सेकंड ऑडियो |
$22/1M अक्षर |
|
MAI-Image-2 |
टेक्स्ट से इमेज |
कुल Elo 1190 |
$5/1M टेक्स्ट + $33/1M इमेज टोकन |
आइए बनाना शुरू करने से पहले हर एक पर थोड़ा और गहराई से नज़र डालें।
MAI-Transcribe-1 एक स्पीच-टू-टेक्स्ट मॉडल है जो 25 भाषाओं को सपोर्ट करता है। इसका मुख्य दाव़ा FLEURS बेंचमार्क पर 3.88% औसत Word Error Rate (WER) का है—जितना कम उतना बेहतर—जो GPT-Transcribe (4.17%), Scribe v2 (4.32%), Gemini 3.1 Flash-Lite (4.89%), और Whisper-large-v3 (7.60%) से आगे है।
यह मॉडल विशेष रूप से वास्तविक दुनिया के अस्त-व्यस्त ऑडियो—शोरगुल वाले परिवेश, मिश्रित ऐक्सेंट्स और प्राकृतिक बोलने की शैली—के लिए बनाया गया है। Microsoft का यह भी दावा है कि MAI-Transcribe-1 अग्रणी विकल्पों की तुलना में लगभग 50% कम GPU लागत पर अच्छी सटीकता देता है, जो बड़े पैमाने पर ट्रांसक्रिप्शन चलाने वाले एंटरप्राइज़ के लिए महत्वपूर्ण लाभ है।
हालाँकि, इसमें अभी रियल-टाइम ट्रांसक्रिप्शन, स्पीकर डायरीज़ेशन, और कॉन्टेक्स्ट बायसिंग नहीं है—ये सभी "जल्द आ रहा है" के रूप में सूचीबद्ध हैं।
MAI-Voice-1 Microsoft का उच्च-निष्ठा TTS मॉडल है। इसकी प्रमुख क्षमता वॉइस प्रॉम्प्टिंग है, जहाँ आप 10-सेकंड का ऑडियो सैंपल देते हैं और मॉडल बिना किसी फाइन-ट्यूनिंग के उस आवाज़ को क्लोन कर देता है। हालाँकि, वॉइस क्लोनिंग के लिए Microsoft की अनुमति आवश्यक है, लेकिन क्यूरेटेड वॉइस लाइब्रेरी (जैसे en-us-Jasper:MAI-Voice-1, en-us-June:MAI-Voice-1) तुरंत उपलब्ध है।
मॉडल एक GPU पर 1 सेकंड में 60 सेकंड का ऑडियो जनरेट करता है, SSML के जरिए प्रति-टर्न इमोशन कंट्रोल सपोर्ट करता है, और ऑडियोबुक्स व पॉडकास्ट जैसे लंबी सामग्री के लिए बनाया गया है। यह पहले से ही Microsoft के अपने प्रोडक्ट्स में Copilot के Audio Expressions और पॉडकास्ट फीचर्स को पावर देता है।
इस मॉडल की एक कमी यह है कि यह अभी “केवल अंग्रेज़ी” तक सीमित है; 10+ भाषाएँ जल्द आने वाली हैं।
MAI-Image-2 10–50 बिलियन पैरामीटर्स के साथ फ्लो-मैचिंग डिफ्यूजन आर्किटेक्चर का उपयोग करता है। यह Arena.ai की इमेज लीडरबोर्ड पर टॉप-3 मॉडल है और प्रोडक्शन में MAI-Image-1 से 2 गुना तेज है। यह मॉडल फ़ोटोग्राफ़र्स, डिज़ाइनर्स और विज़ुअल स्टोरीटेलर्स के साथ मिलकर विकसित किया गया है, और Copilot, Bing Image Creator, और PowerPoint में पहले से डिप्लॉय है। इसे खास तौर पर फोटोरीयलिज़्म, सटीक स्किन टोन, और इमेज के भीतर पठनीय टेक्स्ट के लिए बनाया गया है।
श्रेणीवार इसके Elo स्कोर में फोटोरीयलिस्टिक (1201) और पोर्ट्रेट्स (1201) सबसे बेहतर हैं, जबकि टेक्स्ट रेंडरिंग (1186) पहले से बेहतर होने के बावजूद अब भी सबसे कमजोर श्रेणी है।
तीनों MAI मॉडल Microsoft Azure पर उपलब्ध हैं। MAI-Transcribe-1 और MAI-Voice-1 एक ही Azure Speech संसाधन साझा करते हैं, जबकि MAI-Image-2 Microsoft Foundry के जरिए चलता है। आइए दोनों को एक-एक करके सेटअप करें।
MAI-Transcribe-1 और MAI-Voice-1 दोनों Azure AI Speech सर्विस से एक्सेस किए जाते हैं, इसलिए एक ही संसाधन दोनों को कवर करता है।
portal.azure.com पर जाएँ
सर्च बार में Speech टाइप करें और Speech services चुनें
+ Create पर क्लिक करें
फॉर्म भरें:
Resource group: नया रिसोर्स ग्रुप बनाएँ और इसका नाम mai-demo-rg रखें
Region: East US चुनें, क्योंकि वर्तमान में MAI मॉडल केवल East US और West US के लिए सपोर्टेड हैं
Name: mai-speech-demo
Pricing tier: Standard S0
Note: Free F0 में रेट लिमिट्स हैं जो डेमो में बाधा डाल सकते हैं
अंत में, Review and create पर क्लिक करें, और थोड़ी लोडिंग के बाद Create पर क्लिक करें।
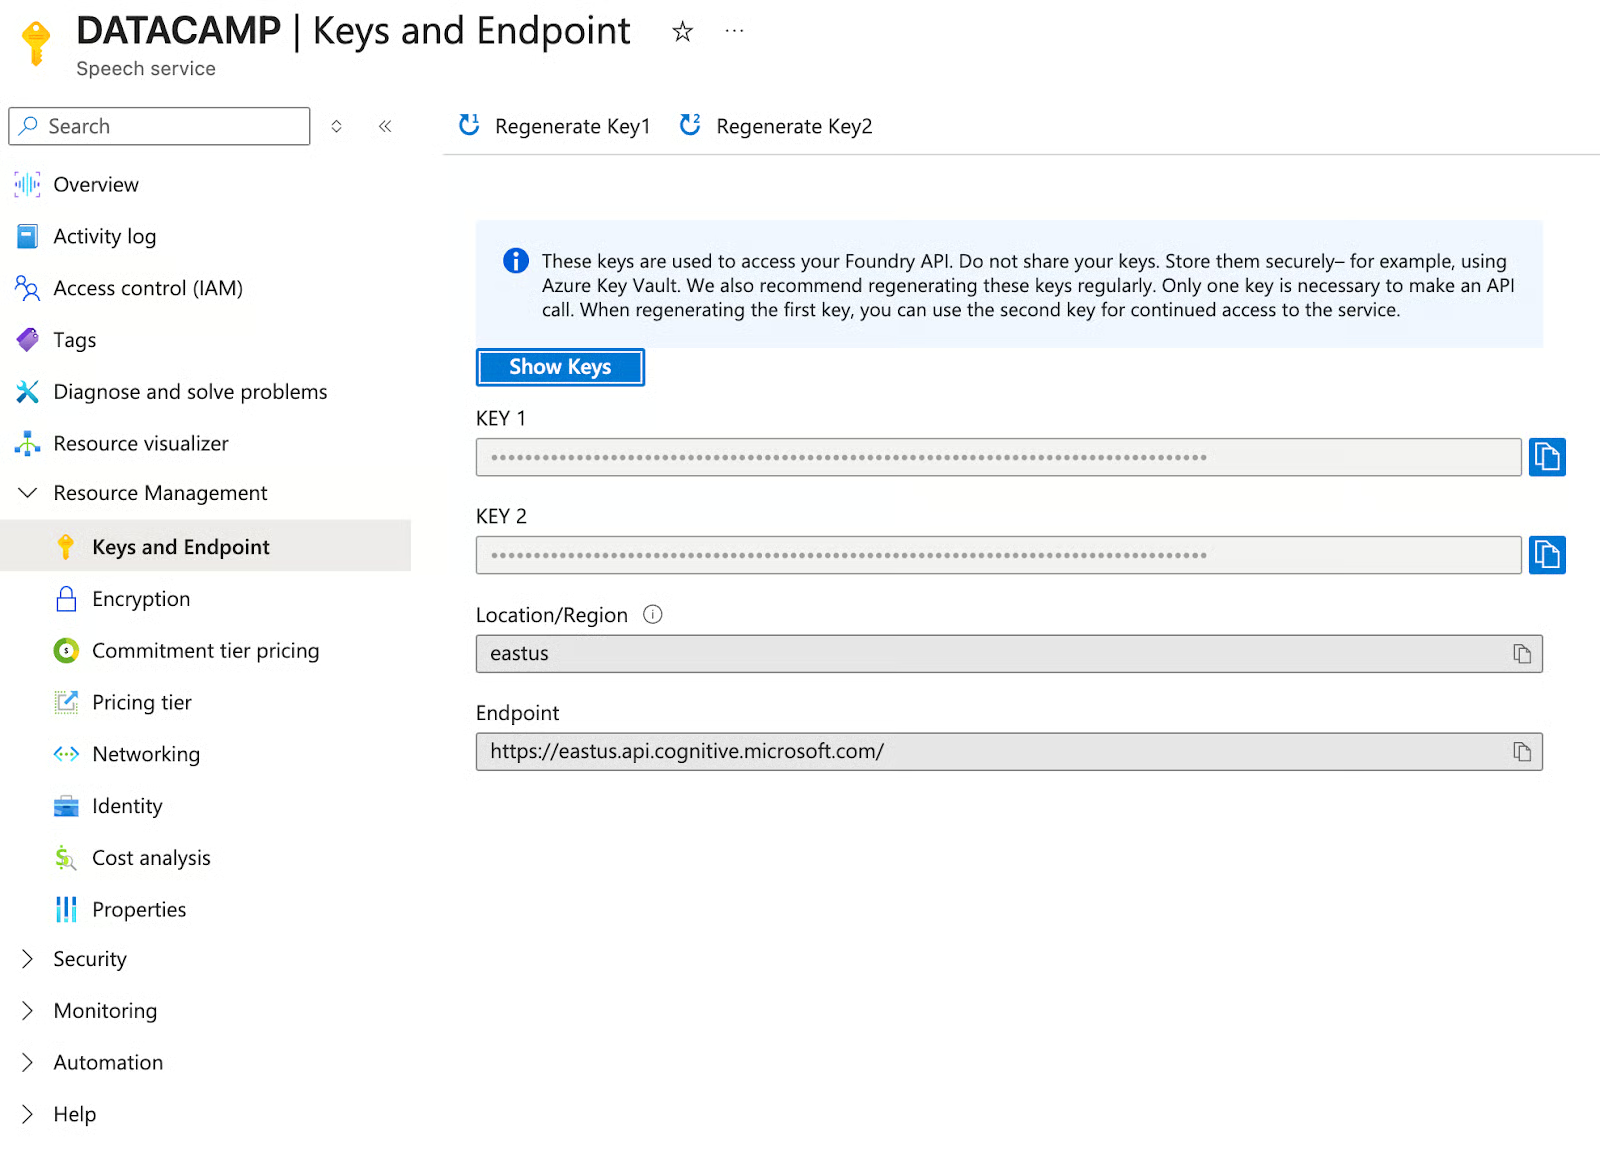
डिप्लॉयमेंट पूरा होने पर, बाएँ साइडबार में Keys and Endpoint पर जाएँ और Key 1 कॉपी करें तथा Region मान (eastus) नोट कर लें।
MAI-Image-2 Microsoft Foundry के जरिए एक्सेस किया जाता है, जो नियमित Azure पोर्टल से अलग है।
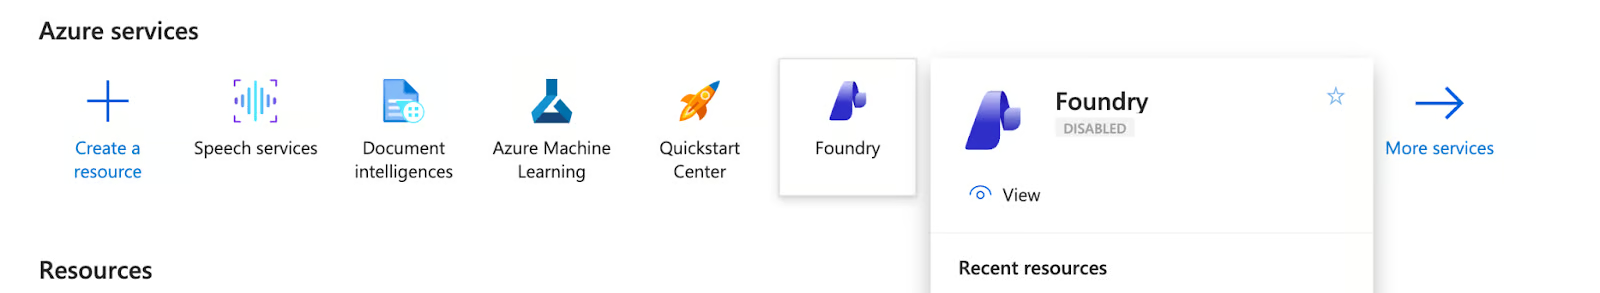
Azure पोर्टल होमपेज से, ऊपर सेवाओं की पंक्ति में Foundry पर क्लिक करें
Create a resource पर क्लिक करें
अगला, निम्न विवरण भरें:
Resource group: चरण 1 से वही mai-demo-rg चुनें
Region: East US
Name: mai-image-demo
Default project name: proj-default
फिर Review and create पर क्लिक करें, और Create दबाएँ
रिसोर्स लाइव होने पर Go to Foundry portal पर क्लिक करें।
इसके बाद Foundry इंटरफेस में, बाएँ साइडबार में Model catalog पर क्लिक करें
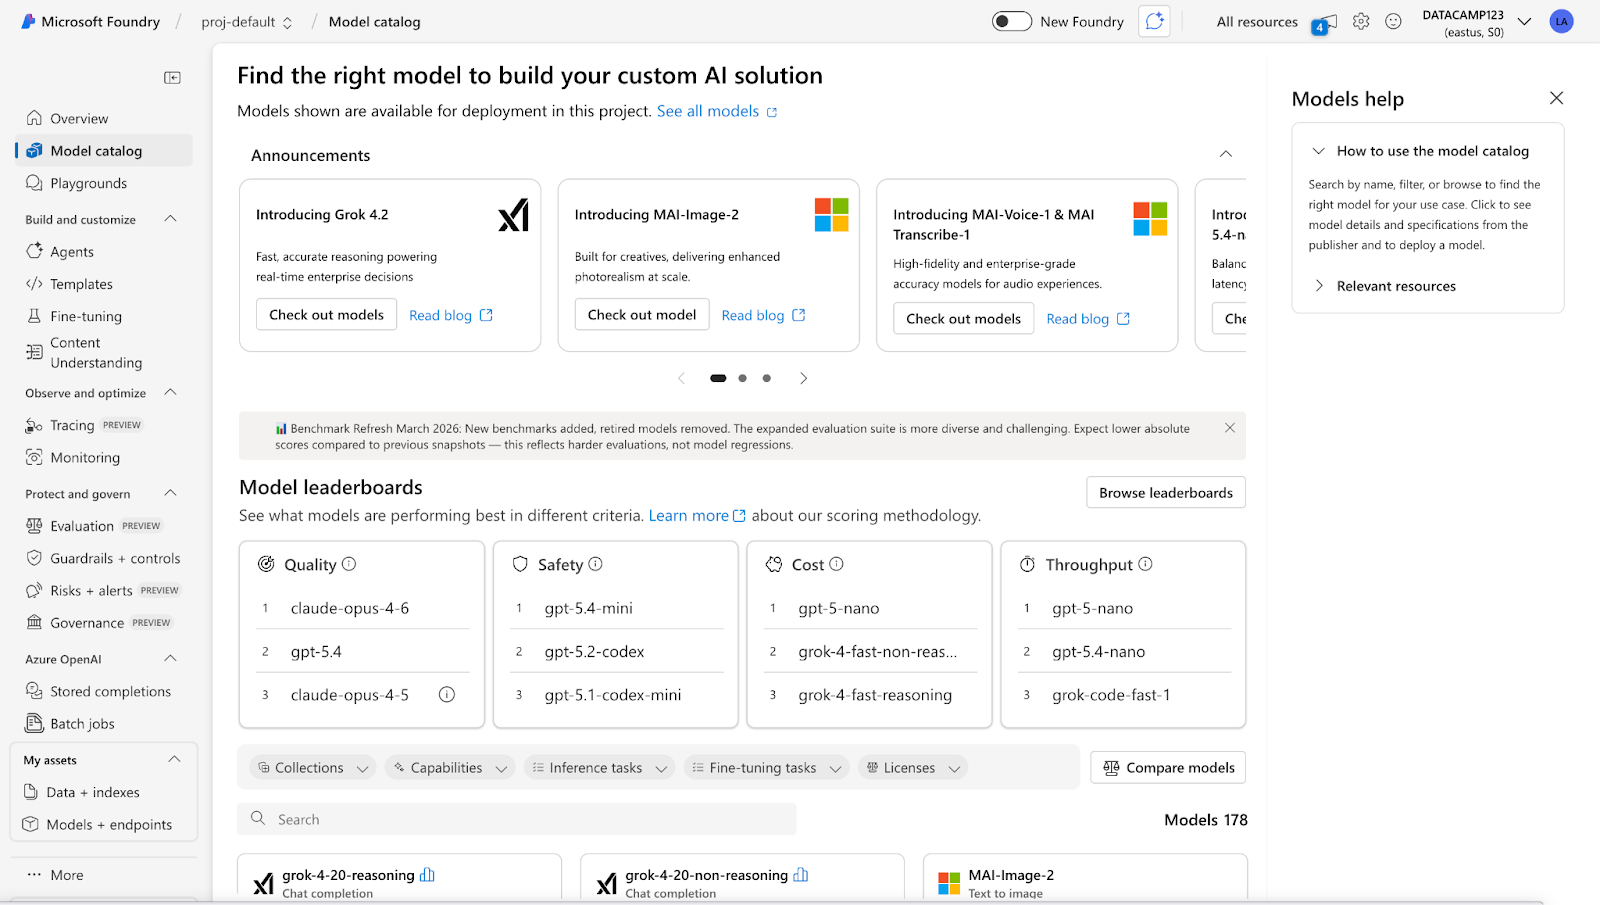
MAI खोजें, और आपको सभी चार MAI मॉडल सूचीबद्ध दिखेंगे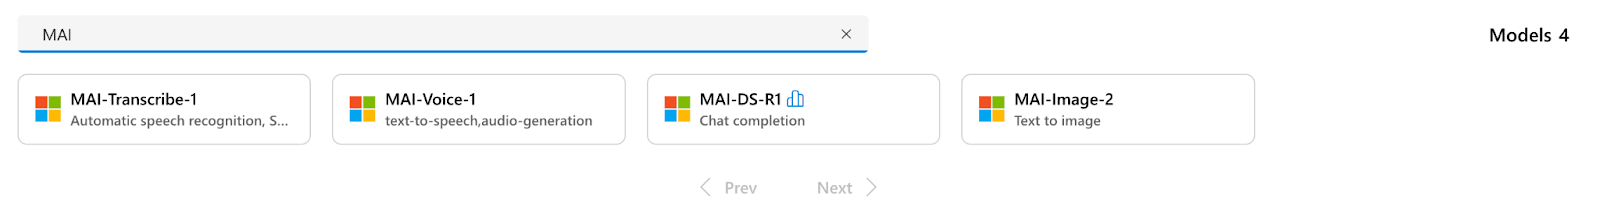
MAI-Image-2 चुनें और Use this model पर क्लिक करें
डिप्लॉय डायलॉग में ये सेट करें:
Deployment name: MAI-Image-2
Deployment type: Global Standard
अंत में, deploy पर क्लिक करें
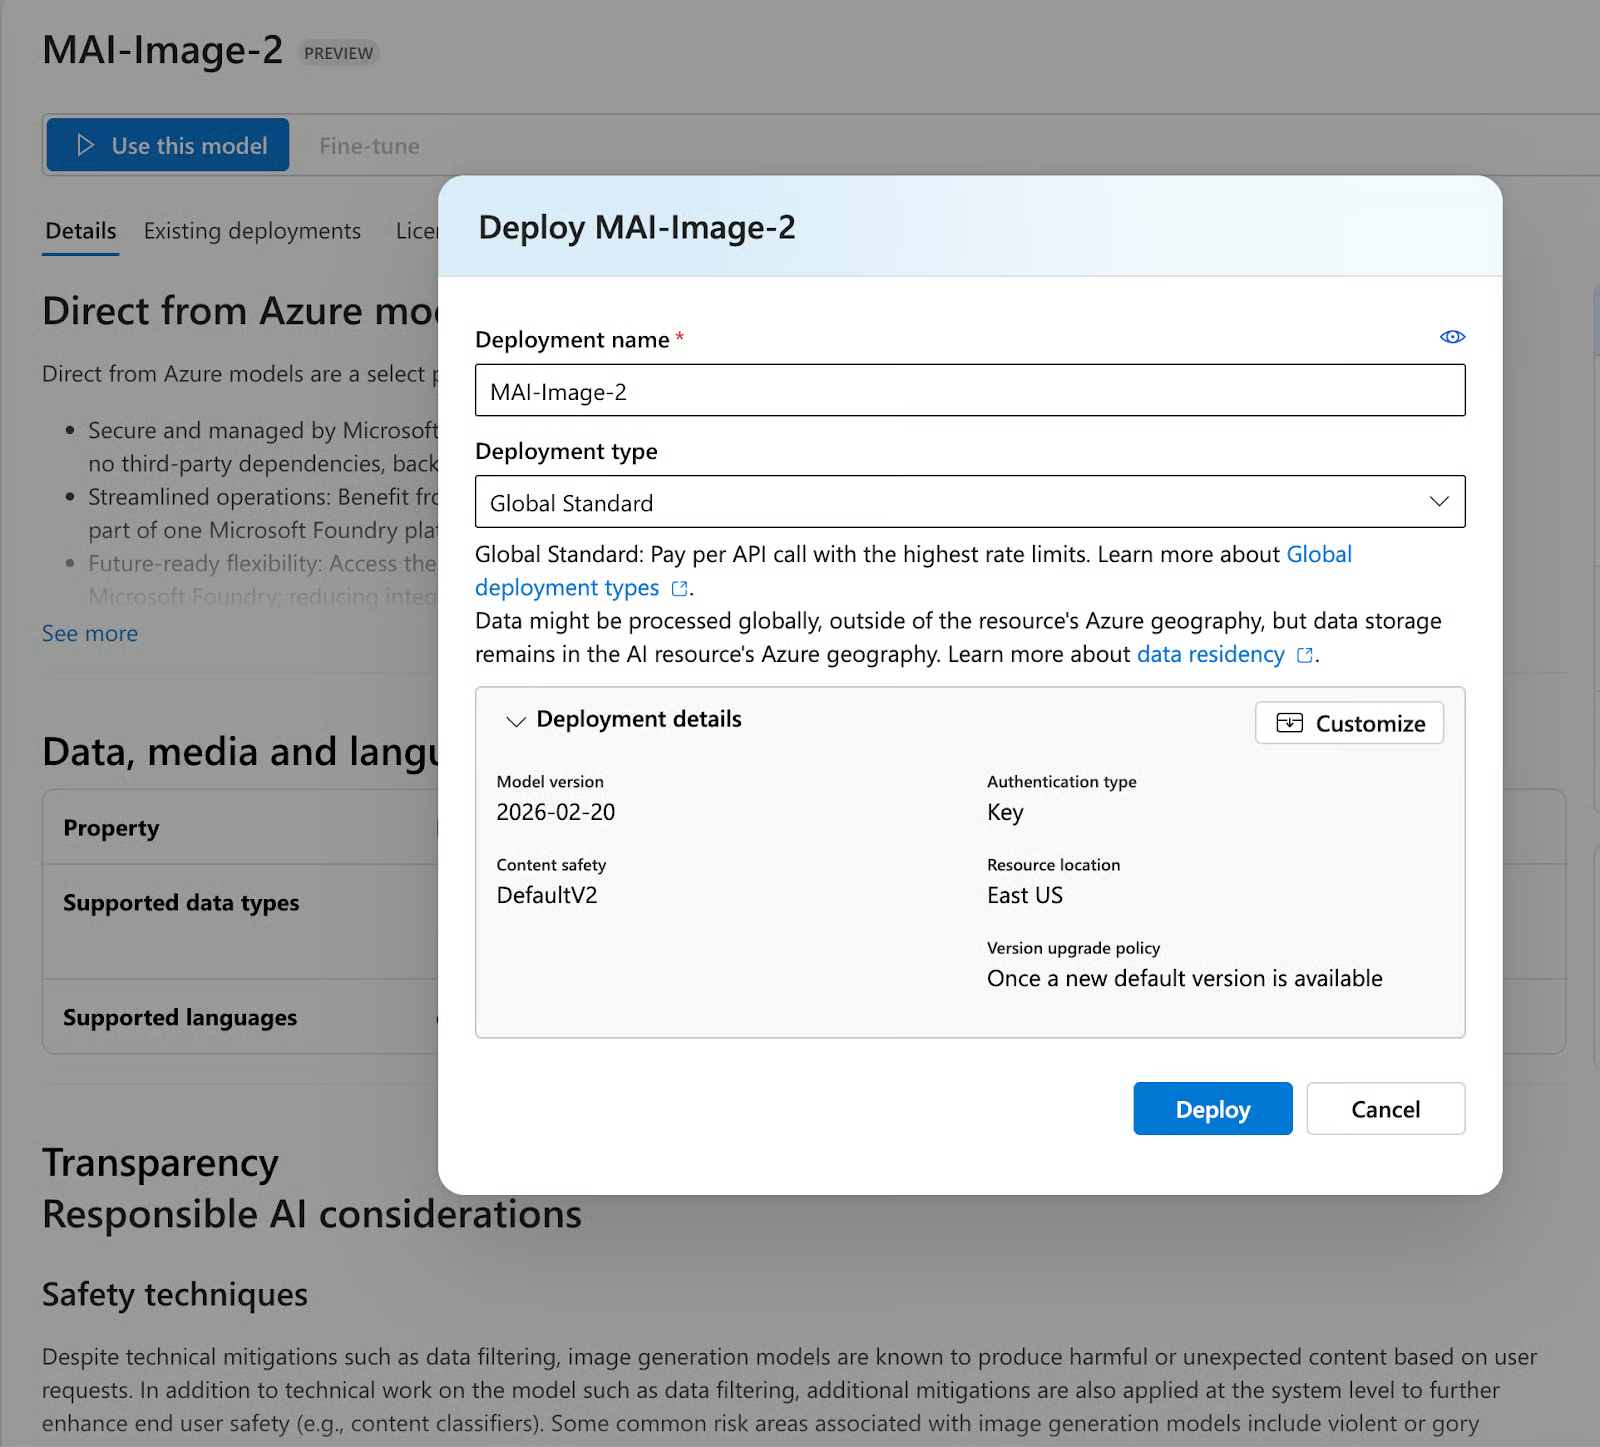
डिप्लॉयमेंट के बाद, आप डिप्लॉयमेंट डीटेल्स पेज पर पहुँचेंगे। Target URI (जैसे https://mai-image-demo.services.ai.azure.com/models) और Key कॉपी करें।
अपने लोकल प्रोजेक्ट डायरेक्टरी में .env फ़ाइल बनाएँ और पिछले दो चरणों से मिले विवरण जोड़ें:
AZURE_SPEECH_KEY=your_speech_key_1_here
AZURE_SPEECH_REGION=eastus
AZURE_IMAGE_ENDPOINT=https://your-resource-name.services.ai.azure.com/models
AZURE_IMAGE_KEY=your_foundry_key_here
AZURE_IMAGE_DEPLOYMENT=MAI-Image-2
महत्वपूर्ण नोट: AZURE_IMAGE_DEPLOYMENT केस-सेंसिटिव है। Foundry में जैसा है वैसा ही MAI-Image-2 उपयोग करें; लोअरकेस mai-image-2 देने पर unknown_model त्रुटि आती है।
इस सेक्शन में हम तीन-टैब वाला Streamlit ऐप बनाएँगे जो लाइव Azure API कॉल्स के जरिए तीनों MAI मॉडलों को कॉल करता है। उच्च स्तर पर, ऐप यह करता है:
यह है फ़ाइल सेटअप:
mai_demo/
├── app.py            # Streamlit UI
├── mai_clients.py    # Azure API wrappers
├── requirements.txt
└── .env
ऐप दो फ़ाइलों में बाँटा गया है: mai_clients.py, जो सभी Azure API कॉल्स हैंडल करता है और स्ट्रक्चर्ड रिजल्ट डिक्ट्स लौटाता है, और app.py, जो Streamlit UI हैंडल करता है। आइए इसे चरण-दर-चरण बनाते हैं।
लोकल मॉडल सेटअप के विपरीत, यह ऐप लाइव Azure क्लाउड APIs से कनेक्ट करता है, इसलिए डिपेंडेंसी सूची में Azure Speech SDK के साथ सपोर्टिंग HTTP और इमेज लाइब्रेरीज़ भी शामिल हैं।
pip install -r requirements.txtrequirements.txt फ़ाइल में यह है:
.txt
streamlit>=1.35.0
azure-cognitiveservices-speech>=1.38.0
requests>=2.31.0
pillow>=10.0.0
python-dotenv>=1.0.0
openai>=1.30.0
इस प्रोजेक्ट में हम उपयोग करेंगे:
streamlit तीन-टैब UI, फ़ाइल अपलोडर, ऑडियो प्लेयर, और इनलाइन इमेज रेंडरिंग के लिए
azure-cognitiveservices-speech Azure Speech SDK के लिए, जिसका उपयोग MAI-Transcribe-1 और MAI-Voice-1 से संवाद के लिए होगा
requests तीनों Azure एन्डपॉइंट्स पर डायरेक्ट REST API कॉल्स के लिए
pillow MAI-Image-2 द्वारा लौटाए गए इमेज बाइट्स को डिकोड और डिस्प्ले करने के लिए
python-dotenv रनटाइम पर .env फ़ाइल से Azure कीज़ और एन्डपॉइंट URLs लोड करने के लिए
openai Azure OpenAI-कम्पैटिबल SDK के लिए, जो Foundry इमेज जनरेशन एन्डपॉइंट्स को सपोर्ट करता है
इंस्टॉल होने के बाद, ऐप चलाने से पहले सुनिश्चित करें कि .env फ़ाइल app.py के साथ वाली डायरेक्टरी में हो। सभी क्रेडेंशियल लोडिंग python-dotenv के जरिए स्टार्टअप पर स्वतः होती है।
सभी Azure API कॉल्स mai_clients. py ' में हैं, जहाँ प्रत्येक फ़ंक्शन एक सरल {"success": bool, ...} डिक्शनरी लौटाता है ताकि UI लेयर त्रुटि पर कभी क्रैश न हो।
MAI-Transcribe-1: स्पीच-टू-टेक्स्ट
MAI-Transcribe-1 Azure Speech REST API के LLM Speech एन्डपॉइंट के जरिए एक्सेस किया जाता है। प्रमुख बात यह है कि यह मल्टीपार्ट फॉर्म रिक्वेस्ट लेता है—एक ऑडियो फ़ाइल और एक JSON डेफिनिशन ऑब्जेक्ट के रूप में।
def transcribe_audio(audio_bytes: bytes, filename: str = "audio.wav") -> dict:
url = (
f"https://{speech_region}.api.cognitive.microsoft.com"
f"/speechtotext/transcriptions:transcribe?api-version=2024-11-15"
)
headers = {"Ocp-Apim-Subscription-Key": speech_key}
definition = '{"locales":["en-US"],"profanityFilterMode":"None"}'
files = {
"audio": (filename, audio_bytes, _mime_type(filename)),
"definition": (None, definition, "application/json"),
}
resp = requests.post(url, headers=headers, files=files, timeout=60)
data = resp.json()
combined = " ".join(
p.get("text", "") for p in data.get("combinedPhrases", [])
).strip()
return {"success": True, "transcript": combined, "raw": data, ...}
ऊपर दिए गए कोड स्निपेट का रिस्पॉन्स combinedPhrases नामक JSON ऑब्जेक्ट के रूप में आता है, जो टेक्स्ट सेगमेंट्स की एक ऐरे है। हम उन्हें जोड़कर एक सिंगल ट्रांस्क्रिप्ट स्ट्रिंग बनाते हैं। सपोर्टेड ऑडियो फ़ॉर्मैट्स में WAV, MP3 और FLAC शामिल हैं। API फिलहाल East US और West US के लिए रीजन-लॉक्ड है।
MAI-Voice-1: टेक्स्ट-टू-स्पीच
MAI-Voice-1 मानक Azure Speech TTS को SSML के जरिए उपयोग करता है। कुंजी है <mstts:express-as> ब्लॉक बनाना (इमोशन कंट्रोल हेतु) और सही वॉइस नाम फ़ॉर्मेट (en-us-Jasper:MAI-Voice-1) का संदर्भ देना।
def _build_ssml(text: str, emotion: str, voice_name: str) -> str:
style_map = {
"neutral": None,
"joy": "joy",
"excitement": "excitement",
"empathy": "empathy",
}
style = style_map.get(emotion)
text_block = (
text if style is None
else f"<mstts:express-as style='{style}'>{text}</mstts:express-as>"
)
return f"""<speak version='1.0' xml:lang='en-US'
xmlns='http://www.w3.org/2001/10/synthesis'
xmlns:mstts='http://www.w3.org/2001/mstts'>
<voice name='{voice_name}'>
{text_block}
</voice>
</speak>"""
MAI-Voice-1 के उपलब्ध वॉइस नाम en-us-{Name}:MAI-Voice-1 पैटर्न का पालन करते हैं। मौजूदा सूची में Jasper, June, Grant, Iris, Reed, और Joy शामिल हैं।
MAI-Image-2: टेक्स्ट-टू-इमेज
MAI-Image-2 Foundry-विशिष्ट एन्डपॉइंट का उपयोग करता है, जो मानक Azure OpenAI /openai/deployments/ पथ नहीं है। सही एन्डपॉइंट फ़ॉर्मेट यह है:
url = f"{base_endpoint}/mai/v1/images/generations"
यहाँ base_endpoint हमारे Foundry संसाधन URL का रूट है (उदा. https://your-resource.services.ai.azure.com), जिसमें रिक्वेस्ट बनाने से पहले किसी भी ट्रेलिंग /models पाथ को हटा दिया जाता है। रिक्वेस्ट बॉडी की दो शर्तें हैं: पहला, आपको model फ़ील्ड को अपने डिप्लॉयमेंट नाम पर स्पष्ट रूप से सेट करना होगा—मानक OpenAI एन्डपॉइंट्स के विपरीत, जहाँ मॉडल URL पाथ से इन्फर होता है:
payload = { "model": deployment, # "MAI-Image-2" "prompt": prompt, "width": width, "height": height, }
दूसरा, इमेज डाइमेंशन्स पर सख्त सीमाएँ हैं: width और height दोनों कम-से-कम 768 पिक्सेल होने चाहिए, और उनका गुणनफल 1,048,576 से अधिक नहीं हो सकता—स्क्वेयर इमेज के लिए अधिकतम 1024×1024। 512×512 पास करना या डाइमेंशन्स छोड़ देना 400 Bad Request देगा।
रिस्पॉन्स मानक OpenAI इमेज जनरेशन शेप का अनुसरण करता है। data ऐरे की प्रत्येक आइटम में या तो होस्टेड इमेज की ओर इशारा करता हुआ url होगा या रॉ base64-एन्कोडेड बाइट्स वाला b64_json फ़ील्ड होगा। क्लाइंट दोनों को हैंडल करता है:
image_url = row.get("url")
b64 = row.get("b64_json")
if b64:
img_bytes = base64.b64decode(b64)
elif image_url:
img_resp = requests.get(image_url, timeout=30)
img_bytes = img_resp.content
ध्यान दें कि url रिस्पॉन्स समय-सीमित होते हैं, यानी हमें बाइट्स तुरंत फ़ेच कर कैश करने चाहिए, न कि बाद में उपयोग के लिए URL स्टोर करना चाहिए।
चरण 3: Streamlit UI बनाना (app.py)
ऐप तीन टैब में व्यवस्थित है, हर मॉडल के लिए एक। संरचना इस प्रकार है:
import streamlit as st
from mai_clients import transcribe_audio, synthesize_speech, generate_image
tab1, tab2, tab3 = st.tabs([
"🎙 MAI-Transcribe-1",
"🔊 MAI-Voice-1",
"🖼 MAI-Image-2",
])
हर टैब एक ही पैटर्न फॉलो करता है: इनपुट्स → बटन → स्पिनर → परिणाम प्रदर्शन → लागत मैट्रिक्स।
टैब 1: MAI-Transcribe-1
पहला टैब ऑडियो अपलोड और ट्रांसक्रिप्शन हैंडल करता है। यह WAV, MP3, और FLAC फ़ाइलें स्वीकार करता है, ऑडियो को इनलाइन प्लेबैक करता है ताकि आप परीक्षण सामग्री सत्यापित कर सकें, और बटन क्लिक पर बाइट्स सीधे transcribe_audio() को भेज देता है।
with tab1:
audio_file = st.file_uploader("Upload audio file", type=["wav", "mp3", "flac"])
if audio_file:
st.audio(audio_file)
if st.button("Transcribe", type="primary"):
with st.spinner("Calling MAI-Transcribe-1..."):
result = transcribe_audio(audio_file.read(), audio_file.name)
if result["success"]:
st.text_area("Transcript", value=result["transcript"], height=140)
m1, m2, m3 = st.columns(3)
m1.metric("Latency", f"{result['latency_s']}s")
m2.metric("Audio duration", f"{result['duration_ms']/1000:.1f}s")
m3.metric("Est. cost", f"${result['duration_ms']/3_600_000 * 0.36:.5f}")
सफल रिस्पॉन्स पर, ट्रांस्क्रिप्ट एक एडिटेबल टेक्स्ट एरिया में दिखता है, जिसके बाद तीन मैट्रिक्स आते हैं: सेकंड में API लेटेंसी, रिस्पॉन्स के durationMilliseconds फ़ील्ड से निकाली गई ऑडियो अवधि, और duration_in_hours × $0.36 के रूप में अनुमानित लागत।
7-सेकंड की क्लिप की लागत लगभग $0.0000007 आती है, इसलिए आप अपने Azure क्रेडिट पर बिना असर के कई टेस्ट फ़ाइलें चला सकते हैं।
टैब 2: MAI-Voice-1
दूसरा टैब टेक्स्ट-टू-स्पीच सिंथेसिस हैंडल करता है। यह MAI-Voice-1 को टेस्ट करने के लिए तीन सबसे महत्त्वपूर्ण कंट्रोल्स प्रदर्शित करता है: टेक्स्ट इनपुट, इमोशन स्टाइल, और वॉइस चयन—जो सभी सीधे synthesize_speech() फ़ंक्शन में पास होते हैं।
with tab2:
text_input = st.text_area("Text to synthesize", value="The quarterly results exceeded...")
emotion = st.selectbox("Emotion / style", ["neutral", "joy", "excitement", "empathy"])
voice_name = st.selectbox("Voice", ["en-us-Jasper:MAI-Voice-1", "en-us-June:MAI-Voice-1", ...])
if st.button("Synthesize", type="primary"):
with st.spinner("Calling MAI-Voice-1..."):
result = synthesize_speech(text_input, emotion=emotion, voice_name=voice_name)
if result["success"]:
st.audio(result["audio_bytes"], format="audio/mp3")
इमोशन सेलेक्टर आंतरिक रूप से SSML <mstts:express-as> स्टाइल्स पर मैप होता है; neutral साफ़ बेसलाइन आउटपुट के लिए टैग को पूरी तरह छोड़ देता है, जबकि joy, excitement, और empathy स्पष्ट रूप से अलग पेसिंग और पिच प्रोफ़ाइल पैदा करते हैं। वॉइस ड्रॉपडाउन में वर्तमान में उपलब्ध छह MAI-Voice-1 वॉइस शामिल हैं: Jasper, June, Grant, Iris, Reed, और Joy।
सफलता पर, लौटाए गए MP3 बाइट्स सीधे st.audio() में इनलाइन प्लेबैक के लिए पास कर दिए जाते हैं। 113 अक्षरों पर अनुमानित लागत $0.000002 आती है, यानी आप कई टेस्ट बिना अधिक क्रेडिट खर्च किए चला सकते हैं।
टैब 3: MAI-Image-2
तीसरा टैब टेक्स्ट-टू-इमेज जनरेशन हैंडल करता है। MAI-Image-2 का मौजूदा API दो इनपुट पैरामीटर्स एक्सपोज़ करता है—प्रॉम्प्ट और रेज़ोल्यूशन। कोई क्वालिटी टियर या स्टाइल कंट्रोल नहीं हैं; मॉडल उन्हें आंतरिक रूप से हैंडल करता है।
with tab3:
prompt = st.text_area("Image prompt", value="A worn paperback book on a café table...")
size = st.selectbox("Resolution", ["1024x1024", "1365x768", "768x1365"])
if st.button("Generate", type="primary"):
with st.spinner("Calling MAI-Image-2..."):
result = generate_image(prompt, size=size)
if result["success"]:
img = Image.open(io.BytesIO(result["image_bytes"]))
st.image(img, use_container_width=True)
तीन रेज़ोल्यूशन विकल्प मुख्य आस्पेक्ट रेशियो कवर करते हैं: स्क्वेयर (1024×1024), लैंडस्केप (1365×768), और पोर्ट्रेट (768×1365)। साइज स्ट्रिंग को API को भेजने से पहले अलग-अलग चौड़ाई और ऊँचाई इंटेजर्स में पार्स किया जाता है, क्योंकि Foundry एन्डपॉइंट उन्हें संयुक्त स्ट्रिंग के बजाय व्यक्तिगत फ़ील्ड्स के रूप में लेता है।
सफलता पर, API रिस्पॉन्स से प्राप्त रॉ इमेज बाइट्स को BytesIO बफर में लपेटा जाता है, Pillow से खोला जाता है, और फुल कंटेनर चौड़ाई पर इनलाइन रेंडर किया जाता है। इमेज जनरेशन सामान्यतः 2–4 सेकंड लेता है, जो उसी वातावरण में MAI-Image-1 से स्पष्ट रूप से तेज है।
चरण 4: ऐप चलाना
अपनी .env फ़ाइल कॉन्फ़िगर करने और डिपेंडेंसी इंस्टॉल करने के साथ, आप ऐप चलाने के लिए तैयार हैं।
streamlit run app.py
Streamlit एक लोकल सर्वर शुरू करेगा और अपने आप आपके ब्राउज़र में http://localhost:8501 पर ऐप खोलेगा। डिफ़ॉल्ट रूप से MAI-Transcribe-1 सक्रिय के साथ आपको तीन-टैब इंटरफेस दिखना चाहिए।
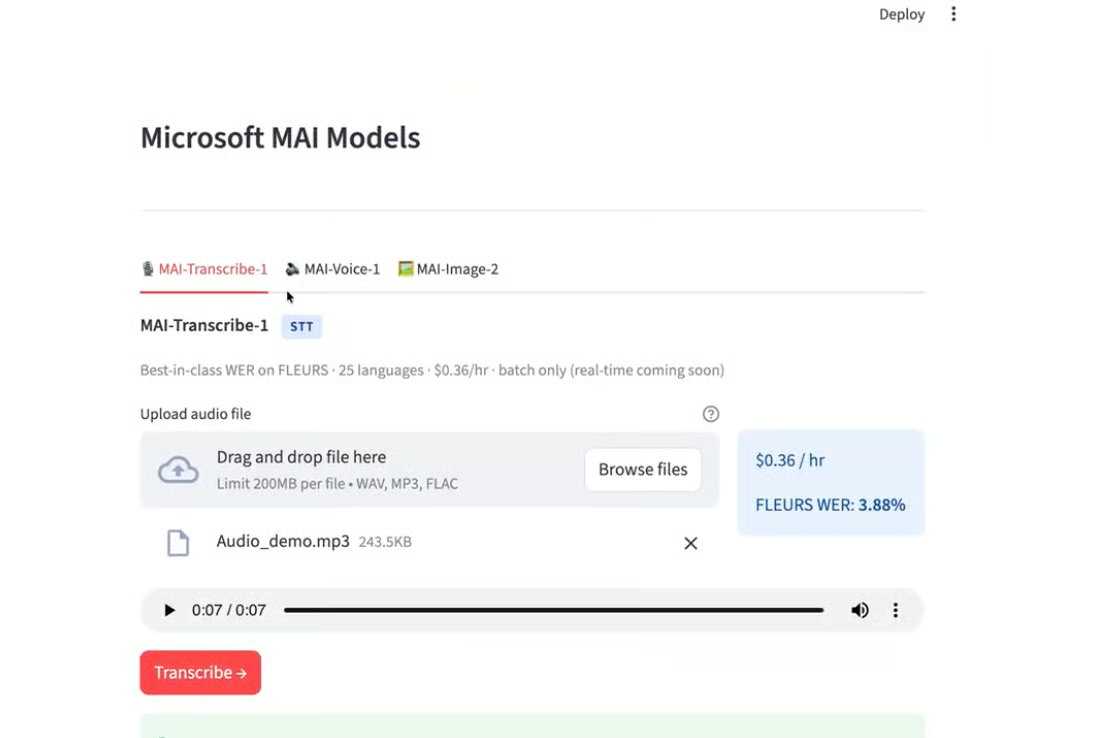
मॉडलों का परीक्षण
जब हमने इन्हें चलाया तो मॉडलों ने वास्तव में क्या उत्पन्न किया—यहाँ देखें।
टेस्ट 1: शोरगुल वाले ऑडियो का ट्रांसक्रिप्शन
मैंने MAI-Transcribe-1 को 7-सेकंड की ऑडियो क्लिप पर टेस्ट किया, जो शोरगुल वाले लेकिन नियंत्रित वातावरण में भारतीय ऐक्सेंट के साथ रिकॉर्ड की गई थी। मॉडल ने 2 सेकंड से कम समय में एक साफ़, सटीक ट्रांस्क्रिप्ट दिया।
निष्कर्ष: ऐक्सेंटेड स्पीच पर परिणाम अच्छे रहे, जहाँ Whisper-large-v3 आमतौर पर सबसे ज़्यादा जूझता है। फिर भी, भाषा-विशिष्ट आँकड़े अलग कहानी बताते हैं—जैसे अरबी 10.1% और डेनिश 13.2% पर हैं—जो हेडलाइन फ़िगर से काफ़ी ऊपर हैं। अगर आपका उपयोग-केस किसी विशिष्ट भाषा या क्षेत्रीय ऐक्सेंट वितरण से जुड़ा है, तो प्रोडक्शन में मॉडल अपनाने से पहले अपने वास्तविक ऑडियो पर परीक्षण ज़रूर करें।
टेस्ट 2: इमोशन कंट्रोल
मैंने en-us-Jasper:MAI-Voice-1 वॉइस मॉडल के साथ excitement स्टाइल में 113-अक्षरों वाला वाक्य सिंथेसाइज़ किया, और 1 सेकंड से कम में 6-सेकंड का MP3 मिला। आउटपुट में इमोशन स्पष्ट था—ज़्यादा ऊर्जावान पेसिंग और उच्च पिच वैरिएंस के साथ।
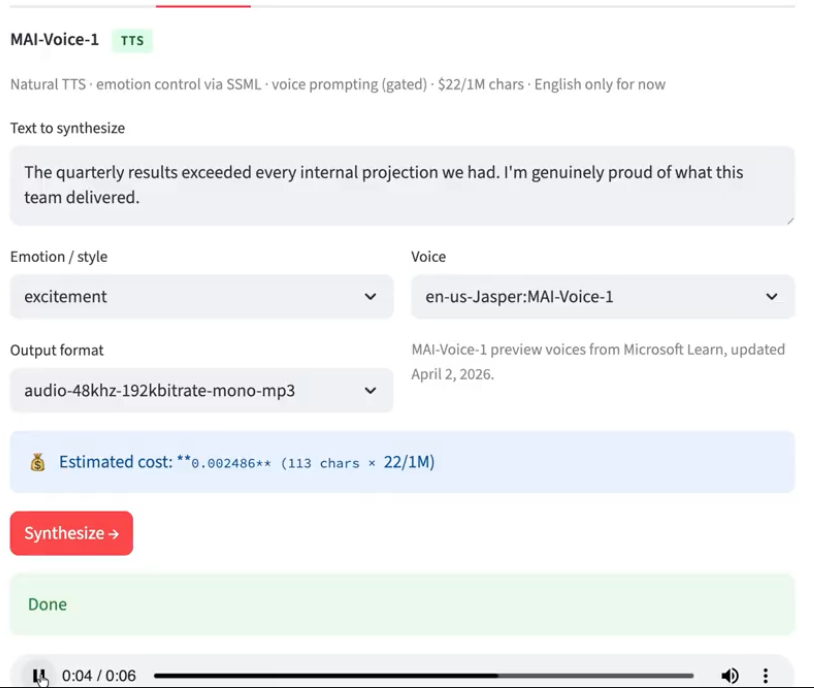
निष्कर्ष: 1 सेकंड से कम में 6-सेकंड की क्लिप बनना प्रभावशाली है। SSML इमोशन कंट्रोल काम करता है लेकिन चार स्टाइल्स तक सीमित है: neutral, joy, excitement, और empathy। इसलिए ElevenLabs की स्टाइल लाइब्रेरी जितनी व्यापक अभिव्यक्ति की उम्मीद न करें।
टेस्ट 3: फोटोरीयलिज़्म और टेक्स्ट रेंडरिंग
यह सबसे दिलचस्प टेस्ट है क्योंकि मैंने जानबूझकर ऐसा प्रॉम्प्ट चुना जो दो चीज़ों को जोड़ता है: फोटोरीयलिस्टिक सीन कंपोज़िशन और इमेज में टेक्स्ट। ज़्यादातर डिफ्यूजन मॉडल इनमें से कम-से-कम एक में असफल रहते हैं।
प्रॉम्प्ट: "A worn paperback book on a café table, natural window light, steam rising from an espresso cup beside it. The book cover reads: INFERENCE AT SCALE — text clearly legible, not warped."
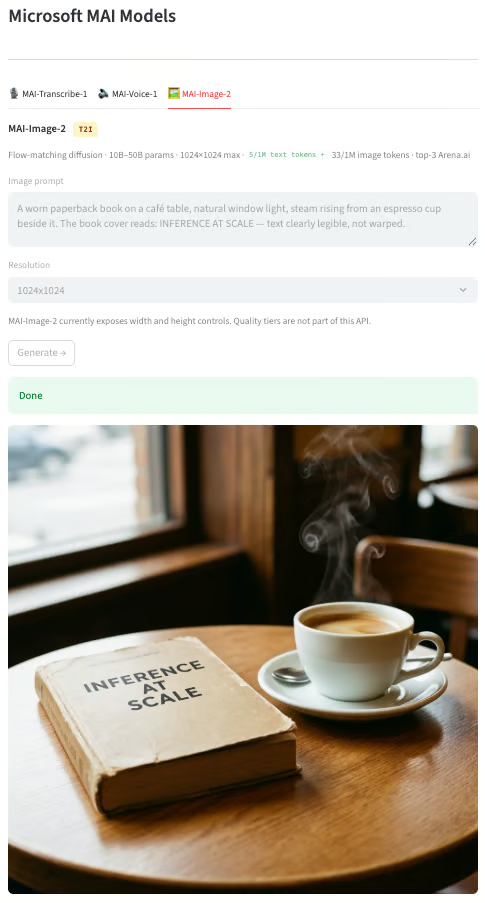
निष्कर्ष: फोटोरीयलिज़्म वास्तव में मज़बूत है—प्राकृतिक विंडो लाइटिंग, विश्वसनीय भाप, और किताब व कप पर यथार्थपरक टेक्सचर के साथ। "INFERENCE AT SCALE" टेक्स्ट भी सही और पठनीय रूप से रेंडर हुआ।
हालाँकि, टेक्स्ट रेंडरिंग अलग-अलग रन में असंगत है। समान प्रॉम्प्ट्स के साथ कई परीक्षण जेनरेशन में, मॉडल ने कभी-कभी गलत वर्तनी या गड़बड़ टेक्स्ट उत्पन्न किया। यह सभी मौजूदा डिफ्यूजन मॉडलों की ज्ञात कमी है—MAI-Image-2 ज़्यादातर से बेहतर है, पर इससे मुक्त नहीं। साथ ही, वर्तमान अधिकतम रेज़ोल्यूशन 1024×1024 पिक्सेल है—जो अधिकांश वेब और कंटेंट उपयोग के लिए पर्याप्त है, लेकिन बिना अपस्केलिंग स्टेप के प्रिंट-क्वालिटी आउटपुट या बड़े-फ़ॉर्मैट क्रिएटिव कार्य को सीमित करता है। यदि आप ऐसे इमेज बना रहे हैं जहाँ टेक्स्ट सटीकता महत्वपूर्ण है, तो हमेशा मानव समीक्षा चरण जोड़ें।
निष्कर्ष
Microsoft की MAI मॉडल फैमिली वास्तव में प्रभावशाली है, जहाँ MAI-Transcribe-1 के FLEURS आँकड़े तीनों में सबसे अधिक वस्तुनिष्ठ रूप से सत्यापनीय हैं—3.88% औसत WER, जो इस लेखन के समय बेस्ट-इन-क्लास है।
MAI-Voice-1 गति और वॉइस क्वालिटी के लिए प्रभावशाली है, लेकिन केवल- अंग्रेज़ी सपोर्ट और सीमित इमोशन पैलेट से बाधित है। MAI-Image-2 मज़बूत फोटोरीयलिस्टिक आउटपुट देता है, पर एक महत्वपूर्ण चेतावनी के साथ—टेक्स्ट हेल्यूसिनेशन अब भी होते हैं और प्रोडक्शन में मानव समीक्षा आवश्यक है।
इस ट्यूटोरियल का पूरा कोड GitHub पर उपलब्ध है।
DataCamp के साथ सीखें
लर्निंग पाथ
लर्निंग पाथ
कोर्स