进入数据科学领域的最佳途径之一,是打造一个能有效展示您技术能力的数据科学项目作品集。随着 ChatGPT 的兴起,向招聘方证明您能解决 NLP 问题比以往任何时候都更重要。
本文将为您展示适合各个水平的七个 NLP 项目示例,从立志成为数据科学家的新手到经验丰富的专业人士。我们开始吧!
想提升您的 NLP 技能?立即开始我们的 Python 自然语言处理学习路径。
为什么要做一个 NLP 项目?
尝试解决 NLP 任务的理由很多。首先是市场需求。像 ChatGPT 这样的大型语言模型(LLM)吸引了各类组织的关注,这意味着他们希望投资这些新工具,并需要能够展示自然语言处理理解能力的人才。
此外,NLP 项目还能帮助您:
- 学习并在简历中新增一项技能。
- 构建项目作品集,展示您的技能以及解决各类任务的能力。
- 表明您持续关注最新进展。
NLP 入门项目
这些 NLP 项目适合刚开始数据科学之旅的人。在这些项目中,您可以掌握 NLP 的基础概念,如文本处理技术、词袋模型和 tf-idf。
如果您需要回顾 NLP 基础,可以查看我们的 Python 自然语言处理入门课程。学习解决监督学习问题的机器学习技术,参加我们的 scikit-learn 监督学习课程也很有帮助。
1. 从新闻标题中提取股票情绪
情感分析是最流行的 NLP 项目之一。它旨在预测一段文本是正面、负面还是中性。理解情感有助于企业洞察用户对产品的满意/不满情况。
在 从新闻标题中提取股票情绪项目中,您将基于 Finviz 的财经新闻标题训练一个情感分析模型。首先清洗文本,然后应用机器学习技术来判断该股票是否受到正面情绪的影响。
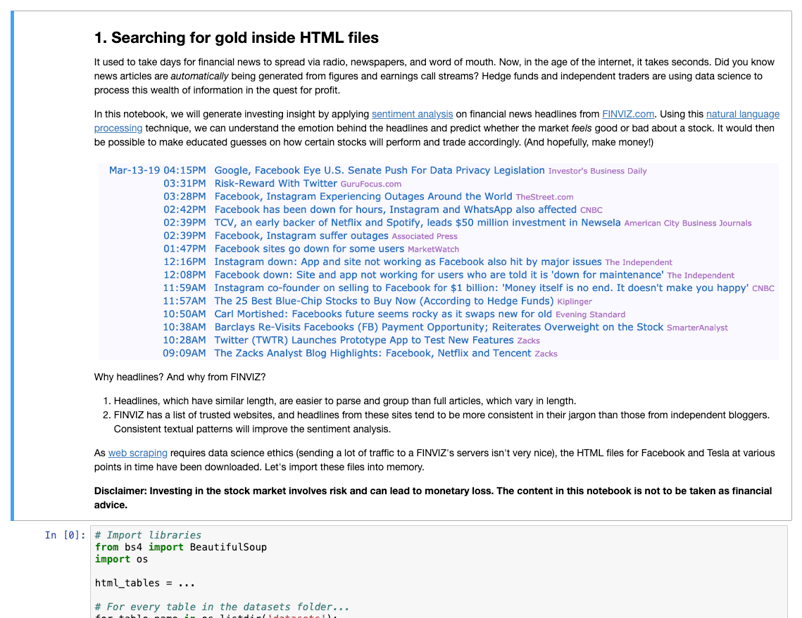
该 NLP 项目的一个示例
2. 谁在发推?特朗普还是特鲁多?
另一个热门项目是推文数据分析,因为 Twitter 提供了健全的 API 以下载数据。
在 谁在发推?特朗普还是特鲁多项目中,您将对推文进行分类,判断其作者是唐纳德·特朗普还是贾斯廷·特鲁多。相比上一个项目,从推文中提取信息更具挑战性,因为其文本更短且充满提及、表情符号和话题标签。
NLP 进阶项目
在学习了文本清洗、处理、可视化以及将机器学习模型应用于分类任务之后,就该迈向下一个层次了。在以下项目中,您将学习自然语言处理的三种不同应用:主题建模、命名实体识别,以及推荐系统。
3. 机器学习领域的最热主题
NLP 技术不仅适用于带标签的数据集;它们也能解决无监督问题。主题建模是一大典型应用,能够从文档集合(如产品评论)中提取最具代表性的主题。
在 机器学习领域的最热主题项目中,您将从 NIPS 的研究论文中发现主题。NIPS 是每年举办的知名机器学习与计算神经科学会议。该项目可分为两部分:预处理步骤,以及使用潜在狄利克雷分配(LDA)识别主题。
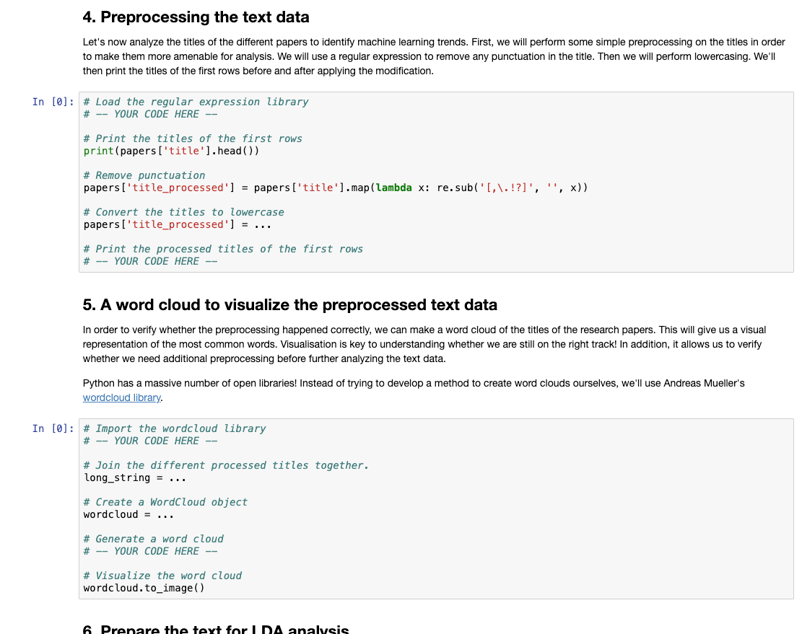
“机器学习领域的最热主题”NLP 项目示例
4. 使用 Spacy 的简历分析
命名实体识别是自然语言处理中的一项任务,旨在将文本中的命名实体识别并分类到预定义类别,如人物、组织、地点和日期。
在 使用 Spacy 的简历分析项目中,您将构建一个系统,帮助招聘人员根据岗位所需技能有效管理候选人的简历。数据集是一组来自 livecareer.com 的简历。在该项目中,将使用 spaCy 模型来识别简历中的实体。
5. 查尔斯·达尔文的图书推荐
我们每天都会受到推荐系统的影响。当您在亚马逊购买商品时,会看到基于您喜好的商品推荐。观看 Netflix 影片时,也会根据过往选择生成影片列表。
在 查尔斯·达尔文的图书推荐项目中,您将基于图书内容构建一个图书推荐系统。数据来自古登堡计划(Project Gutenberg)。将利用查尔斯·达尔文的书目来识别可能引起您兴趣的书籍。
NLP 高阶项目
这些数据科学项目聚焦于解决更高级的问题,如语言翻译和问答系统。您将训练基于 Transformer 的模型来完成各项任务。
6. 使用 Hugging Face 模型的英/意翻译器
每年,机器翻译的效果都在变得更好、更准确。这一进步得益于复杂翻译技术的发展。
在 使用 Hugging Face 模型的英/意翻译器项目中,您将使用 Hugging Face 构建自己的翻译应用。Hugging Face 是一个 AI 平台,托管了大量专注于不同任务(包括机器翻译)的大型语言模型。在该项目中,您将选择这个模型将文本从意大利语翻译成英语。该应用使用 Streamlit 实现。
7. 使用微调 BERT 的问答系统
像 ChatGPT 这样的大型语言模型,为解决各类 NLP 任务(包括问答)带来了极大热情。向大型语言模型提问并快速获得答案,能够显著加快人们的工作进度,从而将精力投入到其他更具挑战性的任务上。
在 使用微调 BERT 的问答系统项目中,您将基于 CoQA 数据集微调 BERT。该数据集由斯坦福于 2019 年发布,包含 12.7 万个带答案的问题。目标是使用 BERT 模型,基于给定数据集来回答问题。
结语
就是这些!通过这些项目,您将习得新技能,并用 NLP 项目充实您的作品集,从而在寻找新人才的招聘者面前更具吸引力。您可以根据自身水平选择更适合的项目。
如果您有兴趣开始学习自然语言处理,最好的方式是先看看 DataCamp 的 Python 自然语言处理学习路径。您也可以查看这篇自然语言处理教程。


进入数据科学领域的最佳途径之一,是打造一个能有效展示您技术能力的数据科学项目作品集。随着 ChatGPT 的兴起,向招聘方证明您能解决 NLP 问题比以往任何时候都更重要。
本文将为您展示适合各个水平的七个 NLP 项目示例,从立志成为数据科学家的新手到经验丰富的专业人士。我们开始吧!
想提升您的 NLP 技能?立即开始我们的 Python 自然语言处理学习路径。
为什么要做一个 NLP 项目?
尝试解决 NLP 任务的理由很多。首先是市场需求。像 ChatGPT 这样的大型语言模型(LLM)吸引了各类组织的关注,这意味着他们希望投资这些新工具,并需要能够展示自然语言处理理解能力的人才。
此外,NLP 项目还能帮助您:
NLP 入门项目
这些 NLP 项目适合刚开始数据科学之旅的人。在这些项目中,您可以掌握 NLP 的基础概念,如文本处理技术、词袋模型和 tf-idf。
如果您需要回顾 NLP 基础,可以查看我们的 Python 自然语言处理入门课程。学习解决监督学习问题的机器学习技术,参加我们的 scikit-learn 监督学习课程也很有帮助。
1. 从新闻标题中提取股票情绪
情感分析是最流行的 NLP 项目之一。它旨在预测一段文本是正面、负面还是中性。理解情感有助于企业洞察用户对产品的满意/不满情况。
在 从新闻标题中提取股票情绪项目中,您将基于 Finviz 的财经新闻标题训练一个情感分析模型。首先清洗文本,然后应用机器学习技术来判断该股票是否受到正面情绪的影响。
该 NLP 项目的一个示例
2. 谁在发推?特朗普还是特鲁多?
另一个热门项目是推文数据分析,因为 Twitter 提供了健全的 API 以下载数据。
在 谁在发推?特朗普还是特鲁多项目中,您将对推文进行分类,判断其作者是唐纳德·特朗普还是贾斯廷·特鲁多。相比上一个项目,从推文中提取信息更具挑战性,因为其文本更短且充满提及、表情符号和话题标签。
NLP 进阶项目
在学习了文本清洗、处理、可视化以及将机器学习模型应用于分类任务之后,就该迈向下一个层次了。在以下项目中,您将学习自然语言处理的三种不同应用:主题建模、命名实体识别,以及推荐系统。
3. 机器学习领域的最热主题
NLP 技术不仅适用于带标签的数据集;它们也能解决无监督问题。主题建模是一大典型应用,能够从文档集合(如产品评论)中提取最具代表性的主题。
在 机器学习领域的最热主题项目中,您将从 NIPS 的研究论文中发现主题。NIPS 是每年举办的知名机器学习与计算神经科学会议。该项目可分为两部分:预处理步骤,以及使用潜在狄利克雷分配(LDA)识别主题。
“机器学习领域的最热主题”NLP 项目示例
4. 使用 Spacy 的简历分析
命名实体识别是自然语言处理中的一项任务,旨在将文本中的命名实体识别并分类到预定义类别,如人物、组织、地点和日期。
在 使用 Spacy 的简历分析项目中,您将构建一个系统,帮助招聘人员根据岗位所需技能有效管理候选人的简历。数据集是一组来自 livecareer.com 的简历。在该项目中,将使用 spaCy 模型来识别简历中的实体。
5. 查尔斯·达尔文的图书推荐
我们每天都会受到推荐系统的影响。当您在亚马逊购买商品时,会看到基于您喜好的商品推荐。观看 Netflix 影片时,也会根据过往选择生成影片列表。
在 查尔斯·达尔文的图书推荐项目中,您将基于图书内容构建一个图书推荐系统。数据来自古登堡计划(Project Gutenberg)。将利用查尔斯·达尔文的书目来识别可能引起您兴趣的书籍。
NLP 高阶项目
这些数据科学项目聚焦于解决更高级的问题,如语言翻译和问答系统。您将训练基于 Transformer 的模型来完成各项任务。
6. 使用 Hugging Face 模型的英/意翻译器
每年,机器翻译的效果都在变得更好、更准确。这一进步得益于复杂翻译技术的发展。
在 使用 Hugging Face 模型的英/意翻译器项目中,您将使用 Hugging Face 构建自己的翻译应用。Hugging Face 是一个 AI 平台,托管了大量专注于不同任务(包括机器翻译)的大型语言模型。在该项目中,您将选择这个模型将文本从意大利语翻译成英语。该应用使用 Streamlit 实现。
7. 使用微调 BERT 的问答系统
像 ChatGPT 这样的大型语言模型,为解决各类 NLP 任务(包括问答)带来了极大热情。向大型语言模型提问并快速获得答案,能够显著加快人们的工作进度,从而将精力投入到其他更具挑战性的任务上。
在 使用微调 BERT 的问答系统项目中,您将基于 CoQA 数据集微调 BERT。该数据集由斯坦福于 2019 年发布,包含 12.7 万个带答案的问题。目标是使用 BERT 模型,基于给定数据集来回答问题。
结语
就是这些!通过这些项目,您将习得新技能,并用 NLP 项目充实您的作品集,从而在寻找新人才的招聘者面前更具吸引力。您可以根据自身水平选择更适合的项目。
如果您有兴趣开始学习自然语言处理,最好的方式是先看看 DataCamp 的 Python 自然语言处理学习路径。您也可以查看这篇自然语言处理教程。