डेटा साइंस के क्षेत्र में नौकरी पाने के सबसे अच्छे तरीकों में से एक है ऐसे डेटा साइंस प्रोजेक्ट्स के साथ पोर्टफोलियो बनाना जो आपकी तकनीकी कौशल को प्रभावी ढंग से दिखाएँ। ChatGPT के उछाल के साथ, रिक्रूटर को यह दिखाना कि आप NLP समस्याएँ हल कर सकते हैं, पहले से कहीं अधिक महत्वपूर्ण हो गया है।
इस लेख में, मैं सभी स्तरों के लिए सात NLP प्रोजेक्ट्स के उदाहरण दिखाऊँगा—उदीयमान डेटा साइंटिस्ट से लेकर अनुभवी प्रोफेशनल तक। आइए शुरू करें!
अपनी NLP कौशल में सुधार करना चाहते हैं? आज ही हमारा Natural Language Processing in Python Track शुरू करें।
NLP प्रोजेक्ट क्यों शुरू करें?
आपको NLP टास्क हल करने की कोशिश क्यों करनी चाहिए, इसके कई कारण हैं। पहला है बाज़ार की मांग। Large Language Models (LLMs), जैसे ChatGPT, ने हर तरह के संगठनों का ध्यान खींचा है, जिसका अर्थ है कि वे इन नए टूल्स में निवेश करना चाहते हैं और ऐसे लोगों की ज़रूरत है जो नेचुरल लैंग्वेज प्रोसेसिंग की समझ प्रदर्शित कर सकें।
इसके अलावा, एक NLP प्रोजेक्ट आपकी मदद कर सकता है:
- सीखने और अपने CV में एक नया कौशल जोड़ने में।
- ऐसे प्रोजेक्ट्स का पोर्टफोलियो बनाने में जो आपकी कौशल और विविध प्रकार के टास्क हल करने की आपकी क्षमता दिखाएँ।
- यह दिखाने में कि आप नई प्रगतियों के बारे में अपडेट रहते हैं।
शुरुआती के लिए NLP प्रोजेक्ट्स
ये NLP प्रोजेक्ट्स उन लोगों के लिए हैं जो अपनी डेटा साइंस यात्रा शुरू कर रहे हैं। इन प्रोजेक्ट्स में, आप NLP की बुनियादी अवधारणाएँ, जैसे टेक्स्ट प्रोसेसिंग तकनीकें, बैग-ऑफ-वर्ड्स, और tf-idf में महारत हासिल कर सकते हैं।
यदि आपको NLP पर रीफ़्रेशर चाहिए, तो आप हमारा Introduction to Natural Language Processing in Python Course देख सकते हैं। सुपरवाइज़्ड समस्याएँ हल करने के लिए मशीन लर्निंग तकनीकें सीखने हेतु हमारा Supervised learning with scikit-learn Course लेना भी उपयोगी हो सकता है।
1. न्यूज़ हेडलाइंस से स्टॉक सेंटिमेंट निकालें
Sentiment analysis सबसे लोकप्रिय NLP प्रोजेक्ट्स में से एक है। इसमें यह भविष्यवाणी करना शामिल है कि कोई टेक्स्ट सकारात्मक, नकारात्मक या तटस्थ है। भावनात्मक रुझान को समझना आपके व्यवसाय को यह मॉनिटर करने के लिए इनसाइट्स दे सकता है कि आपके प्रोडक्ट्स से संतुष्टि/असंतुष्टि है या नहीं।
Extract Stock Sentiment from News Headlines प्रोजेक्ट में, आप Finviz की वित्तीय न्यूज़ हेडलाइंस पर एक सेंटिमेंट एनालिसिस मॉडल ट्रेन करेंगे। पहले, आप टेक्स्ट को साफ करेंगे, और फिर आप मशीन लर्निंग तकनीकों को लागू करेंगे ताकि यह पहचान सकें कि स्टॉक के बारे में पॉजिटिव फीलिंग है या नहीं।
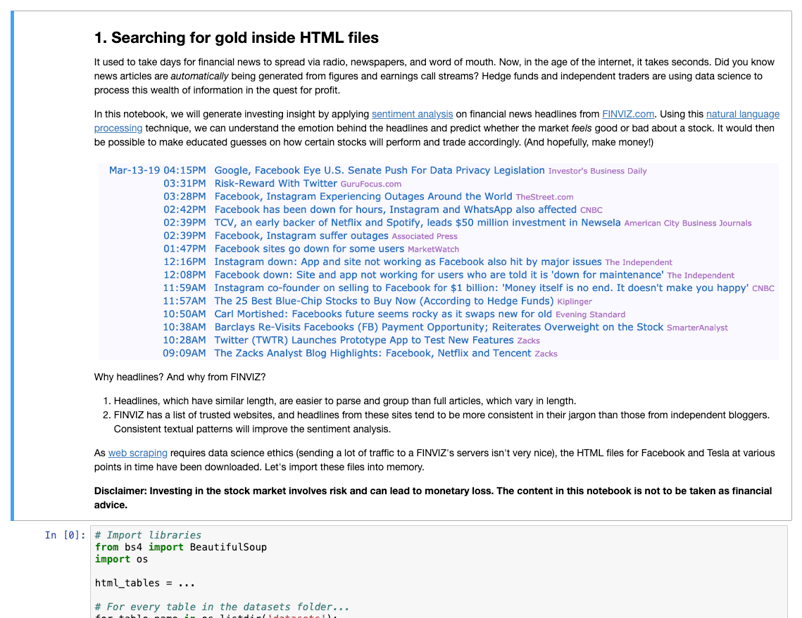
इस NLP प्रोजेक्ट का एक उदाहरण
2. कौन ट्वीट कर रहा है? ट्रंप या ट्रूडो?
एक और लोकप्रिय प्रोजेक्ट है ट्वीट्स का डेटा विश्लेषण, क्योंकि Twitter अपने सशक्त API के ज़रिए डेटा डाउनलोड करने की सुविधा देता है।
Who’s Tweeting? Trump or Trudeau प्रोजेक्ट में, आप वर्गीकृत करेंगे कि ट्वीट डोनाल्ड ट्रंप ने लिखा है या जस्टिन ट्रूडो ने। पिछले प्रोजेक्ट की तुलना में, ट्वीट्स से जानकारी निकालना अधिक चुनौतीपूर्ण हो सकता है क्योंकि वे छोटे होते हैं और उनमें मेंशन्स, इमोजी, और हैशटैग भरे होते हैं।
इंटरमीडिएट NLP प्रोजेक्ट्स
टेक्स्ट क्लीनिंग, प्रोसेसिंग, विज़ुअलाइज़ेशन, और क्लासिफिकेशन टास्क के लिए मशीन लर्निंग मॉडल्स के अनुप्रयोग को सीखने के बाद, अब अगले स्तर पर जाने का समय है। निम्नलिखित प्रोजेक्ट्स में, आप नेचुरल लैंग्वेज प्रोसेसिंग के तीन अलग-अलग अनुप्रयोग सीखेंगे: टॉपिक मॉडलिंग, नेम्ड एंटिटी रिकग्निशन, और रिकमेंडेशन सिस्टम्स।
3. मशीन लर्निंग में सबसे हॉट टॉपिक्स
NLP तकनीकें केवल लेबल्ड डेटासेट्स तक सीमित नहीं हैं; वे अनसुपरवाइज़्ड समस्याएँ भी हल कर सकती हैं। टॉपिक मॉडलिंग इसके प्रमुख अनुप्रयोगों में से एक है क्योंकि यह डॉक्युमेंट्स के संग्रह—जैसे प्रोडक्ट रिव्यूज़—में सबसे प्रतिनिधि टॉपिक्स निकालने में सक्षम है।
Hottest Topics in Machine Learning प्रोजेक्ट में, आप NIPS के रिसर्च पेपर्स से टॉपिक्स खोजेंगे, जो हर साल आयोजित होने वाला एक प्रतिष्ठित मशीन लर्निंग और कम्प्यूटेशनल न्यूरोसाइंस कॉन्फ्रेंस है। प्रोजेक्ट को दो भागों में बाँटा जा सकता है: प्री-प्रोसेसिंग स्टेप और Latent Dirichlet Allocation (LDA) का उपयोग करके टॉपिक्स की पहचान।
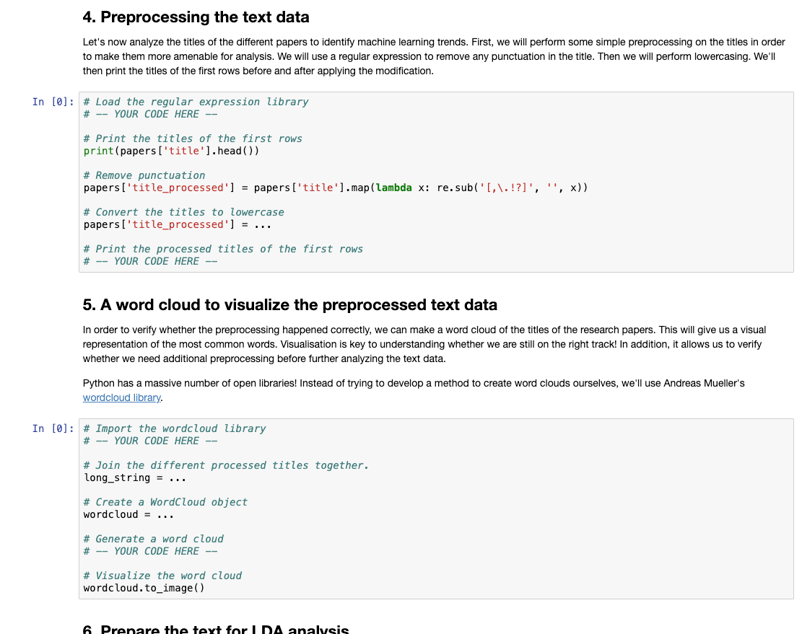
Hottest Topics in Machine Learning NLP प्रोजेक्ट का एक उदाहरण
4. spaCy के साथ रेज़्यूमे विश्लेषण
Named Entity Recognition नेचुरल लैंग्वेज प्रोसेसिंग का एक टास्क है, जिसमें टेक्स्ट डॉक्युमेंट में मौजूद नेम्ड एंटिटीज़ की पहचान करना और उन्हें व्यक्ति, संगठन, स्थान, और तारीख जैसी पूर्वनिर्धारित श्रेणियों में वर्गीकृत करना शामिल है।
Resume Analysis using Spacy प्रोजेक्ट में, आप एक ऐसा सिस्टम बनाएँगे जो रिक्रूटर्स को नौकरी के लिए आवश्यक कौशल के आधार पर उम्मीदवारों के CVs को प्रभावी ढंग से प्रबंधित करने में मदद करता है। डेटासेट livecareer.com से लिए गए रेज़्यूमे का संग्रह है। इस प्रोजेक्ट में, रेज़्यूमे में एंटिटीज़ की पहचान के लिए spaCy मॉडल का उपयोग किया जाएगा।
5. चार्ल्स डार्विन से पुस्तक सिफारिशें
हम हर दिन रिकमेंडेशन सिस्टम्स से प्रभावित होते हैं। जब आप Amazon पर कोई प्रोडक्ट खरीदते हैं, तो आपको आपके स्वाद के आधार पर प्रोडक्ट्स के सुझाव दिखते हैं। यही बात Netflix पर फिल्म देखने पर भी होती है, जहाँ आपको पिछली पसंद के आधार पर फिल्मों की सूची मिलती है।
Book Recommendations from Charles Darwin प्रोजेक्ट में, आप पुस्तकों की सामग्री के आधार पर एक बुक रिकमेंडेशन सिस्टम बनाएँगे। डेटा Project Gutenberg से लिया गया था। चार्ल्स डार्विन की ग्रंथ सूची का उपयोग उन पुस्तकों की पहचान करने के लिए किया जाएगा जो आपकी रुचि को आकर्षित कर सकती हैं।
एडवांस्ड NLP प्रोजेक्ट्स
ये डेटा साइंस प्रोजेक्ट्स अधिक उन्नत समस्याएँ हल करने पर केंद्रित हैं, जैसे भाषा अनुवाद और प्रश्न-उत्तर। आप प्रत्येक टास्क को हल करने के लिए ट्रांसफॉर्मर्स आधारित मॉडल्स ट्रेन करेंगे।
6. Hugging Face मॉडल के साथ अंग्रेज़ी/इतालवी अनुवादक
हर साल, भाषा अनुवाद बेहतर और अधिक सटीक होता जा रहा है। यह प्रगति परिष्कृत भाषा अनुवाद तकनीकों के विकास के कारण संभव हुई है।
English/Italian Translator with Hugging Face model प्रोजेक्ट में, आप Hugging Face के साथ अपना खुद का अनुवाद अनुप्रयोग बनाएँगे, जो एक AI प्लेटफ़ॉर्म है जो विभिन्न टास्क, जिनमें भाषा अनुवाद भी शामिल है, में विशेषज्ञता रखने वाले बहुत से बड़े भाषा मॉडल होस्ट करता है। इस प्रोजेक्ट में, आप इतालवी से अंग्रेज़ी में टेक्स्ट का अनुवाद करने के लिए इस मॉडल को चुनते हैं। यह अनुप्रयोग Streamlit का उपयोग करके具ित किया गया है।
7. फाइन-ट्यून किए गए BERT के साथ प्रश्नोत्तर
ChatGPT जैसे बड़े भाषा मॉडल्स ने प्रश्नोत्तर सहित विविध प्रकार के NLP टास्क हल करने के प्रति उत्साह बढ़ाया है। कोई प्रश्न पूछना और बड़े भाषा मॉडल से तुरंत उत्तर प्राप्त करना लोगों के काम को वास्तव में तेज़ कर सकता है और उन्हें अन्य चुनौतीपूर्ण कार्यों पर ध्यान केंद्रित करने में मदद कर सकता है।
Question Answering with a fine-tuned BERT प्रोजेक्ट में, आप BERT को CoQA डेटासेट पर फाइन-ट्यून करेंगे, जिसमें 2019 में Stanford द्वारा जारी 1.27 लाख प्रश्न-उत्तर का संग्रह है। लक्ष्य है दिए गए डेटासेट के आधार पर प्रश्नों के उत्तर देने के लिए BERT मॉडल का उपयोग करना।
निष्कर्ष
बस इतना ही! इन प्रोजेक्ट्स के साथ, आप नई कौशल हासिल करेंगे और अपने पोर्टफोलियो को NLP प्रोजेक्ट्स से समृद्ध करेंगे, जो आपको नए टैलेंट की तलाश कर रहे रिक्रूटर के लिए अधिक रोचक बनाएगा। स्तर के आधार पर, आप वह प्रोजेक्ट चुन सकते हैं जो आपको अधिक उपयुक्त लगे।
यदि आप नेचुरल लैंग्वेज प्रोसेसिंग से शुरुआत करने में रुचि रखते हैं, तो सबसे अच्छा तरीका है DataCamp के Natural Language Processing in Python ट्रैक पर नज़र डालना। आप Natural Language Processing ट्यूटोरियल भी देख सकते हैं।


डेटा साइंस के क्षेत्र में नौकरी पाने के सबसे अच्छे तरीकों में से एक है ऐसे डेटा साइंस प्रोजेक्ट्स के साथ पोर्टफोलियो बनाना जो आपकी तकनीकी कौशल को प्रभावी ढंग से दिखाएँ। ChatGPT के उछाल के साथ, रिक्रूटर को यह दिखाना कि आप NLP समस्याएँ हल कर सकते हैं, पहले से कहीं अधिक महत्वपूर्ण हो गया है।
इस लेख में, मैं सभी स्तरों के लिए सात NLP प्रोजेक्ट्स के उदाहरण दिखाऊँगा—उदीयमान डेटा साइंटिस्ट से लेकर अनुभवी प्रोफेशनल तक। आइए शुरू करें!
अपनी NLP कौशल में सुधार करना चाहते हैं? आज ही हमारा Natural Language Processing in Python Track शुरू करें।
NLP प्रोजेक्ट क्यों शुरू करें?
आपको NLP टास्क हल करने की कोशिश क्यों करनी चाहिए, इसके कई कारण हैं। पहला है बाज़ार की मांग। Large Language Models (LLMs), जैसे ChatGPT, ने हर तरह के संगठनों का ध्यान खींचा है, जिसका अर्थ है कि वे इन नए टूल्स में निवेश करना चाहते हैं और ऐसे लोगों की ज़रूरत है जो नेचुरल लैंग्वेज प्रोसेसिंग की समझ प्रदर्शित कर सकें।
इसके अलावा, एक NLP प्रोजेक्ट आपकी मदद कर सकता है:
शुरुआती के लिए NLP प्रोजेक्ट्स
ये NLP प्रोजेक्ट्स उन लोगों के लिए हैं जो अपनी डेटा साइंस यात्रा शुरू कर रहे हैं। इन प्रोजेक्ट्स में, आप NLP की बुनियादी अवधारणाएँ, जैसे टेक्स्ट प्रोसेसिंग तकनीकें, बैग-ऑफ-वर्ड्स, और tf-idf में महारत हासिल कर सकते हैं।
यदि आपको NLP पर रीफ़्रेशर चाहिए, तो आप हमारा Introduction to Natural Language Processing in Python Course देख सकते हैं। सुपरवाइज़्ड समस्याएँ हल करने के लिए मशीन लर्निंग तकनीकें सीखने हेतु हमारा Supervised learning with scikit-learn Course लेना भी उपयोगी हो सकता है।
1. न्यूज़ हेडलाइंस से स्टॉक सेंटिमेंट निकालें
Sentiment analysis सबसे लोकप्रिय NLP प्रोजेक्ट्स में से एक है। इसमें यह भविष्यवाणी करना शामिल है कि कोई टेक्स्ट सकारात्मक, नकारात्मक या तटस्थ है। भावनात्मक रुझान को समझना आपके व्यवसाय को यह मॉनिटर करने के लिए इनसाइट्स दे सकता है कि आपके प्रोडक्ट्स से संतुष्टि/असंतुष्टि है या नहीं।
Extract Stock Sentiment from News Headlines प्रोजेक्ट में, आप Finviz की वित्तीय न्यूज़ हेडलाइंस पर एक सेंटिमेंट एनालिसिस मॉडल ट्रेन करेंगे। पहले, आप टेक्स्ट को साफ करेंगे, और फिर आप मशीन लर्निंग तकनीकों को लागू करेंगे ताकि यह पहचान सकें कि स्टॉक के बारे में पॉजिटिव फीलिंग है या नहीं।
इस NLP प्रोजेक्ट का एक उदाहरण
2. कौन ट्वीट कर रहा है? ट्रंप या ट्रूडो?
एक और लोकप्रिय प्रोजेक्ट है ट्वीट्स का डेटा विश्लेषण, क्योंकि Twitter अपने सशक्त API के ज़रिए डेटा डाउनलोड करने की सुविधा देता है।
Who’s Tweeting? Trump or Trudeau प्रोजेक्ट में, आप वर्गीकृत करेंगे कि ट्वीट डोनाल्ड ट्रंप ने लिखा है या जस्टिन ट्रूडो ने। पिछले प्रोजेक्ट की तुलना में, ट्वीट्स से जानकारी निकालना अधिक चुनौतीपूर्ण हो सकता है क्योंकि वे छोटे होते हैं और उनमें मेंशन्स, इमोजी, और हैशटैग भरे होते हैं।
इंटरमीडिएट NLP प्रोजेक्ट्स
टेक्स्ट क्लीनिंग, प्रोसेसिंग, विज़ुअलाइज़ेशन, और क्लासिफिकेशन टास्क के लिए मशीन लर्निंग मॉडल्स के अनुप्रयोग को सीखने के बाद, अब अगले स्तर पर जाने का समय है। निम्नलिखित प्रोजेक्ट्स में, आप नेचुरल लैंग्वेज प्रोसेसिंग के तीन अलग-अलग अनुप्रयोग सीखेंगे: टॉपिक मॉडलिंग, नेम्ड एंटिटी रिकग्निशन, और रिकमेंडेशन सिस्टम्स।
3. मशीन लर्निंग में सबसे हॉट टॉपिक्स
NLP तकनीकें केवल लेबल्ड डेटासेट्स तक सीमित नहीं हैं; वे अनसुपरवाइज़्ड समस्याएँ भी हल कर सकती हैं। टॉपिक मॉडलिंग इसके प्रमुख अनुप्रयोगों में से एक है क्योंकि यह डॉक्युमेंट्स के संग्रह—जैसे प्रोडक्ट रिव्यूज़—में सबसे प्रतिनिधि टॉपिक्स निकालने में सक्षम है।
Hottest Topics in Machine Learning प्रोजेक्ट में, आप NIPS के रिसर्च पेपर्स से टॉपिक्स खोजेंगे, जो हर साल आयोजित होने वाला एक प्रतिष्ठित मशीन लर्निंग और कम्प्यूटेशनल न्यूरोसाइंस कॉन्फ्रेंस है। प्रोजेक्ट को दो भागों में बाँटा जा सकता है: प्री-प्रोसेसिंग स्टेप और Latent Dirichlet Allocation (LDA) का उपयोग करके टॉपिक्स की पहचान।
Hottest Topics in Machine Learning NLP प्रोजेक्ट का एक उदाहरण
4. spaCy के साथ रेज़्यूमे विश्लेषण
Named Entity Recognition नेचुरल लैंग्वेज प्रोसेसिंग का एक टास्क है, जिसमें टेक्स्ट डॉक्युमेंट में मौजूद नेम्ड एंटिटीज़ की पहचान करना और उन्हें व्यक्ति, संगठन, स्थान, और तारीख जैसी पूर्वनिर्धारित श्रेणियों में वर्गीकृत करना शामिल है।
Resume Analysis using Spacy प्रोजेक्ट में, आप एक ऐसा सिस्टम बनाएँगे जो रिक्रूटर्स को नौकरी के लिए आवश्यक कौशल के आधार पर उम्मीदवारों के CVs को प्रभावी ढंग से प्रबंधित करने में मदद करता है। डेटासेट livecareer.com से लिए गए रेज़्यूमे का संग्रह है। इस प्रोजेक्ट में, रेज़्यूमे में एंटिटीज़ की पहचान के लिए spaCy मॉडल का उपयोग किया जाएगा।
5. चार्ल्स डार्विन से पुस्तक सिफारिशें
हम हर दिन रिकमेंडेशन सिस्टम्स से प्रभावित होते हैं। जब आप Amazon पर कोई प्रोडक्ट खरीदते हैं, तो आपको आपके स्वाद के आधार पर प्रोडक्ट्स के सुझाव दिखते हैं। यही बात Netflix पर फिल्म देखने पर भी होती है, जहाँ आपको पिछली पसंद के आधार पर फिल्मों की सूची मिलती है।
Book Recommendations from Charles Darwin प्रोजेक्ट में, आप पुस्तकों की सामग्री के आधार पर एक बुक रिकमेंडेशन सिस्टम बनाएँगे। डेटा Project Gutenberg से लिया गया था। चार्ल्स डार्विन की ग्रंथ सूची का उपयोग उन पुस्तकों की पहचान करने के लिए किया जाएगा जो आपकी रुचि को आकर्षित कर सकती हैं।
एडवांस्ड NLP प्रोजेक्ट्स
ये डेटा साइंस प्रोजेक्ट्स अधिक उन्नत समस्याएँ हल करने पर केंद्रित हैं, जैसे भाषा अनुवाद और प्रश्न-उत्तर। आप प्रत्येक टास्क को हल करने के लिए ट्रांसफॉर्मर्स आधारित मॉडल्स ट्रेन करेंगे।
6. Hugging Face मॉडल के साथ अंग्रेज़ी/इतालवी अनुवादक
हर साल, भाषा अनुवाद बेहतर और अधिक सटीक होता जा रहा है। यह प्रगति परिष्कृत भाषा अनुवाद तकनीकों के विकास के कारण संभव हुई है।
English/Italian Translator with Hugging Face model प्रोजेक्ट में, आप Hugging Face के साथ अपना खुद का अनुवाद अनुप्रयोग बनाएँगे, जो एक AI प्लेटफ़ॉर्म है जो विभिन्न टास्क, जिनमें भाषा अनुवाद भी शामिल है, में विशेषज्ञता रखने वाले बहुत से बड़े भाषा मॉडल होस्ट करता है। इस प्रोजेक्ट में, आप इतालवी से अंग्रेज़ी में टेक्स्ट का अनुवाद करने के लिए इस मॉडल को चुनते हैं। यह अनुप्रयोग Streamlit का उपयोग करके具ित किया गया है।
7. फाइन-ट्यून किए गए BERT के साथ प्रश्नोत्तर
ChatGPT जैसे बड़े भाषा मॉडल्स ने प्रश्नोत्तर सहित विविध प्रकार के NLP टास्क हल करने के प्रति उत्साह बढ़ाया है। कोई प्रश्न पूछना और बड़े भाषा मॉडल से तुरंत उत्तर प्राप्त करना लोगों के काम को वास्तव में तेज़ कर सकता है और उन्हें अन्य चुनौतीपूर्ण कार्यों पर ध्यान केंद्रित करने में मदद कर सकता है।
Question Answering with a fine-tuned BERT प्रोजेक्ट में, आप BERT को CoQA डेटासेट पर फाइन-ट्यून करेंगे, जिसमें 2019 में Stanford द्वारा जारी 1.27 लाख प्रश्न-उत्तर का संग्रह है। लक्ष्य है दिए गए डेटासेट के आधार पर प्रश्नों के उत्तर देने के लिए BERT मॉडल का उपयोग करना।
निष्कर्ष
बस इतना ही! इन प्रोजेक्ट्स के साथ, आप नई कौशल हासिल करेंगे और अपने पोर्टफोलियो को NLP प्रोजेक्ट्स से समृद्ध करेंगे, जो आपको नए टैलेंट की तलाश कर रहे रिक्रूटर के लिए अधिक रोचक बनाएगा। स्तर के आधार पर, आप वह प्रोजेक्ट चुन सकते हैं जो आपको अधिक उपयुक्त लगे।
यदि आप नेचुरल लैंग्वेज प्रोसेसिंग से शुरुआत करने में रुचि रखते हैं, तो सबसे अच्छा तरीका है DataCamp के Natural Language Processing in Python ट्रैक पर नज़र डालना। आप Natural Language Processing ट्यूटोरियल भी देख सकते हैं।