

什么是主题建模?
主题建模是一种常用方法,用于发掘文本语料所呈现的隐藏语义模式,并自动识别其中包含的主题。
具体而言,它是一种统计建模方式,利用无监督机器学习来分析并识别文本中相似词语的簇或分组。
例如,可以部署主题建模算法来判断某份文档的内容是否暗示它是一张发票、一则投诉或一份合同。
主题建模在商业中的作用
据部分来源统计,普通人每秒会产生超过 1.7MB 的数字数据。按天计算,该数字超过 2.5×10¹⁸ 字节,其中 80%–90% 为非结构化数据。
设想一家企业安排一名员工审阅每一条非结构化数据,并根据其潜在主题进行归类。这几乎是不可能完成的任务。
不仅耗时且枯燥乏味,还会带来更大风险,因为与机器相比,人类天生更容易产生偏见并犯错。
解决方案就是主题建模。
借助主题建模,可以更快,甚至更好地从数据中提取洞见。该技术将主题整合为可理解的结构,帮助企业迅速把握全局。
例如,企业若想了解客户面临的最大挑战,可通过非结构化数据运用主题建模来获取这类信息。
简而言之,主题建模可帮助企业:
- 对非结构化文本数据进行实时分析
- 大规模从非结构化数据中学习
- 无论数据格式如何,构建一致的数据理解。
主题建模的核心概念
我们已经知道,主题建模使数据专业人士能够快速、规模化地分析并识别文本中相似词语的簇或分组。
但什么是“主题”?主题建模又如何运作?
什么是主题?主题模型如何工作?
主题是对一组(大量)文本的潜在描述。直观来看,关于某一特定主题的文档,更可能更频繁地出现某些词语。
例如,“dog”和“bone”更可能出现在与狗相关的文档中,而“cat”和“meow”更可能出现在与猫相关的文档中。因此,主题模型会扫描文档并生成相似词语的簇。
本质上,主题模型通过推断词语并将相似词语归入主题,从而形成主题簇。
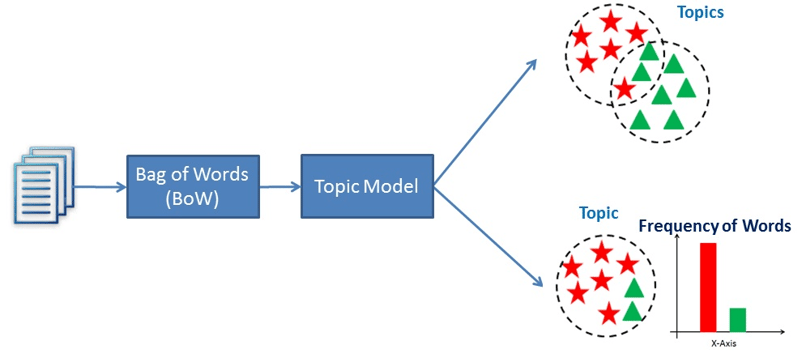
主题建模工作机制的可视化
探索主题建模技术
两种常见的主题建模技术是潜在语义分析(LSA)和潜在狄利克雷分配(LDA)。二者的目标都是发现文本数据所呈现的隐藏语义模式,但实现路径不同。
潜在语义分析(LSA)
潜在语义分析(LSA)是一种自然语言处理技术,用于分析文档与其包含术语之间的关系。该方法最早发表于 1988 年的一篇论文“Using Latent Semantic Analysis to Improve Access to Textual Information”中,至今仍被用于将一组非结构化文本转化为结构化数据。
LSA 假设含义相近的词会出现在相似的文档中。它通过构建一个“每篇文档的词频”矩阵来实现:每一行代表一个唯一词语,列代表每篇文档,随后使用奇异值分解(SVD)在保留列间相似性结构的同时减少行数。SVD 是一种数学方法,可在保留重要特征的前提下简化数据;在此用于保持词与文档之间的关系。
为判断文档间的相似度,会使用余弦相似度。它计算两个向量(此处代表文档)之间夹角的余弦值。值越接近 1,说明基于其中的词,这两篇文档越相似;越接近 0 则说明差异越大。
潜在狄利克雷分配(LDA)
潜在狄利克雷分配(LDA)最初在 2000 年的一篇题为“Inference of population structure using multilocus genotype data.”的论文中提出。该论文主要聚焦群体遗传学,即研究群体内部与群体之间遗传差异的分支。三年后,潜在狄利克雷分配被应用于机器学习。
论文作者将该技术描述为“一种用于文本和其他离散数据集合的生成式模型。”因此,LDA 可被视为一种自然语言技术,它根据文档所含词语来识别文档所属的主题。
更具体地说,LDA 是一个贝叶斯网络,即一种生成式统计模型,假设文档由帮助确定主题的词语构成。因此,通过为文档中的每个词分配不同主题,将文档映射为一个主题列表。该模型忽略文档中词语的顺序,将其视为“词袋”。
LSA 与 LDA 的比较
潜在语义分析(LSA)与潜在狄利克雷分配(LDA)都是将一组非结构化文本转化为结构化数据的自然语言处理技术。
然而,LSA 利用奇异值分解(SVD)来降低词项-文档矩阵的维度,并基于“含义相近的词会出现在相似文档中”的假设。通过创建低维表示,模型可捕捉词语之间的潜在关系,从而判断两篇文档的相似程度。
相较之下,LDA 是一种生成式概率模型,利用贝叶斯推断在语料库中寻找潜在主题。它假设每篇文档由少量潜在主题组合而成,每个词由某个特定主题生成。
归根结底,LSA 试图发现词语之间的潜在关系,而 LDA 则致力于发现语料库中的潜在主题。尽管两者都是将文本向量化的技术,但其底层假设不同。
主题建模的实践实现
接下来看看这些技术如何工作。您可以使用这个 DataLab 工作簿跟进代码。
数据准备
首先我们需要数据。
在主题建模中,我们使用的数据称为语料(corpus),即一组文本的集合。
下面是我根据互联网上的事实创建的一小段语料:
# Creating example documents
doc_1 = "A whopping 96.5 percent of water on Earth is in our oceans, covering 71 percent of the surface of our planet. And at any given time, about 0.001 percent is floating above us in the atmosphere. If all of that water fell as rain at once, the whole planet would get about 1 inch of rain."
doc_2 = "One-third of your life is spent sleeping. Sleeping 7-9 hours each night should help your body heal itself, activate the immune system, and give your heart a break. Beyond that--sleep experts are still trying to learn more about what happens once we fall asleep."
doc_3 = "A newborn baby is 78 percent water. Adults are 55-60 percent water. Water is involved in just about everything our body does."
doc_4 = "While still in high school, a student went 264.4 hours without sleep, for which he won first place in the 10th Annual Great San Diego Science Fair in 1964."
doc_5 = "We experience water in all three states: solid ice, liquid water, and gas water vapor."
# Create corpus
corpus = [doc_1, doc_2, doc_3, doc_4, doc_5]预处理
下一步是清洗文本:
# Code source: https://www.analyticsvidhya.com/blog/2016/08/beginners-guide-to-topic-modeling-in-python/
import string
import nltk
nltk.download('stopwords')
nltk.download('wordnet')
nltk.download('omw-1.4')
from nltk.corpus import stopwords
from nltk.stem.wordnet import WordNetLemmatizer
# remove stopwords, punctuation, and normalize the corpus
stop = set(stopwords.words('english'))
exclude = set(string.punctuation)
lemma = WordNetLemmatizer()
def clean(doc):
stop_free = " ".join([i for i in doc.lower().split() if i not in stop])
punc_free = "".join(ch for ch in stop_free if ch not in exclude)
normalized = " ".join(lemma.lemmatize(word) for word in punc_free.split())
return normalized
clean_corpus = [clean(doc).split() for doc in corpus]在上述代码中我们:
- 导入必要的库,并下载停用词与wordnet
- 定义英文停用词
- 实例化需要排除的标点集合
- 创建 wordnet 词形还原器的实例
- 创建函数以移除停用词和标点,并对文档进行词形还原
- 将清洗函数应用于语料中的每个文档
但这并不意味着我们已经准备就绪。
在将该数据作为 LDA 或 LSA 模型的输入之前,必须将其转换为词项-文档矩阵。词项-文档矩阵是对一组文档及其所含词项的数学表示。
它通过统计每个文档中每个词项的出现次数来创建,随后对计数进行归一化,生成可用于分析的矩阵。
在 Python 中,我们将使用 Gensim 库来完成这一工作。
from gensim import corpora
# Creating document-term matrix
dictionary = corpora.Dictionary(clean_corpus)
doc_term_matrix = [dictionary.doc2bow(doc) for doc in clean_corpus]现在,我们可以训练模型了。
建模
我们先使用 LSA 模型:
from gensim.models import LsiModel
# LSA model
lsa = LsiModel(doc_term_matrix, num_topics=3, id2word = dictionary)
# LSA model
print(lsa.print_topics(num_topics=3, num_words=3))
"""
[
(0, '0.555*"water" + 0.489*"percent" + 0.239*"planet"'),
(1, '0.361*"sleeping" + 0.215*"hour" + 0.215*"still"'),
(2, '-0.562*"water" + 0.231*"rain" + 0.231*"planet"')
]
"""这会输出主题(每一行)以及各主题词项(terms)及其权重。
再试试 LDA:
from gensim.models import LdaModel
# LDA model
lda = LdaModel(doc_term_matrix, num_topics=3, id2word = dictionary)
# Results
print(lda.print_topics(num_topics=3, num_words=3))
"""
[
(0, '0.071*"water" + 0.025*"state" + 0.025*"three"'),
(1, '0.030*"still" + 0.028*"hour" + 0.026*"sleeping"'),
(2, '0.073*"percent" + 0.069*"water" + 0.031*"rain"')
]
"""主题建模的用途是什么?
通过消除手动且重复的任务,主题建模能够以简单且低成本的方式加速流程。以下是一些示例:
为支持工单打标签
主题建模可帮助客服人员分析支持请求,识别主要问题并确定是否存在反复出现的情况。基于这些数据,他们可以创建更有信息量的自助内容,或直接为客户提供帮助。
提升客户体验
主题建模可用于为对话打标签,从而将其路由到最合适的团队。例如,包含“pricing”“subscription”“renewal”等词语的对话,可以直接发送至财务部门处理。
主题建模与其他技术的比较
主题建模 vs 聚类
主题建模用于发现一组文档中存在的潜在主题。这涉及识别文档中出现的词语与短语的模式,并根据其相似性将它们归入主题。
相反,聚类是一种基于相似性度量对相似对象进行分组的技术。此类方法用于通过将相似的数据点归为一组来发现数据中的模式与结构。
尽管两种方法都能在文本数据中挖掘模式,但目标不同。主题建模关注识别文档集合中的潜在主题,而聚类关注将相似的数据点聚在一起。
主题建模 vs 文本分类
文本分类虽属自然语言处理技术,但归入监督学习范畴。具体而言,文本分类用于为预定义类别或某段文本打标签。为实现此目标,模型必须先从带标签的数据集中学习,然后才能用于对新的、未见过的文本样本进行预测。
另一方面,主题建模是一种无监督学习技术,用于在文本文档集合中发现潜在主题。这意味着它无需从带标签的数据集中学习。
因此,两者的区别在于:文本分类用于为文本分配预定义标签,而主题建模用于发现文档集合中的潜在主题。
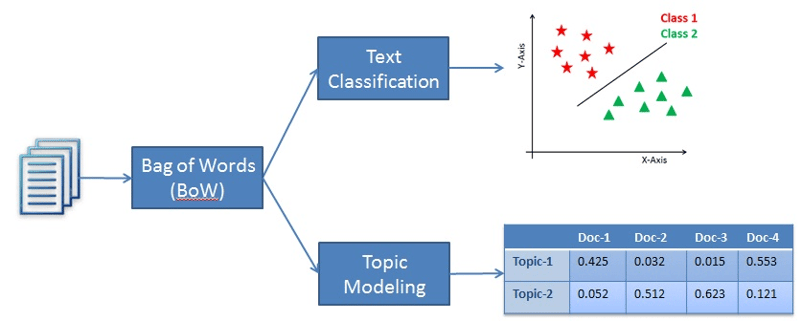
分类与主题建模的示例
结论
主题建模是一种常用的自然语言处理技术,用于将一组非结构化数据转化为结构化数据。换言之,该技术使企业能够学习文本语料所呈现的隐藏语义模式,并自动识别其中存在的主题。
两种常见的主题建模方法是 LSA 和 LDA。二者都旨在发现文本数据中的隐藏模式,但为实现目标所作的假设不同。LSA 假设含义相近的词会出现在相似的文档中;而 LDA 假设文档由有助于确定主题的词语构成。
在本教程中,我们介绍了主题建模的核心概念、实践实现,以及它与文本分类和聚类等其他技术的差异。若要继续学习,请查阅以下资源:

分析的目标是从数据中提炼洞见。传统上,此类数据是结构化的,意味着它采用标准化格式以便高效访问。随着世界数字化进程加速,如今生成的大量数据是非结构化的,即没有预定义的数据模型。
据 Gartner 称,非结构化数据占所有新增企业数据的 80%–90%,而且其增长速度是结构化数据的三倍。因此,分析专家必须采用新技术,才能从数据集中获取相关信息。
其中一种被广泛应用的技术是来源于文本挖掘领域的主题建模。本文接下来将介绍: