

要点速览
- 规范化通过组织关系型数据库中的表,来消除冗余并保护数据完整性
- 1NF:每个单元仅包含一个原子值;每行可以被唯一标识
- 2NF:消除部分依赖——非键列必须依赖于整个主键
- 3NF:消除传递依赖——非键列只依赖主键,而不依赖其他非键列
- BCNF、4NF、5NF:分别处理复杂模式下的函数依赖、多值依赖和连接依赖
- 大多数生产数据库通常规范化到 3NF 即可;更高范式适用于专项场景
什么是 SQL 中的规范化?
在这里,规范化是指在数据库(关系型数据库)内组织数据的过程,以消除诸如冗余等数据异常。
更直白地说,就是在保持数据关系的同时,把庞大而复杂的表拆分成更小、更简单的表。
规范化常用于处理大型数据集。
下面简要看看一些常见的规范化使用场景。
数据完整性
设想一个包含客户信息的数据库。如果不进行规范化,当客户的年龄发生变化时,我们需要在多个位置更新,这会增加不一致的风险。通过规范化,我们可以使用由唯一标识符连接的独立表,从而确保数据准确一致。
高效查询
设想一个包含多张相关表的复杂数据库,同时还存储了重复信息。在这种情况下,涉及连接的查询会变得更复杂、资源消耗更大。规范化通过将数据拆分为更小的表,每张表仅包含相关信息,从而减少对复杂连接的需求,帮助简化查询。
存储优化
冗余数据的主要问题在于占用不必要的存储空间。比如,如果我们在每条订单记录中都存储相同的产品详情,就会造成重复。通过规范化,您可以将数据拆分到独立表中以消除冗余。
为什么 SQL 中的规范化很重要?
规范化在数据库设计中发挥着关键作用。其重要性体现在以下方面:
- 减少冗余:冗余是指同一信息被多次存储,避免冗余的一个好方法就是将数据拆分到更小的表中。
- 提升查询性能:对于经过规范化、更小的表,查询执行更快。
- 减少更新异常:通过规范化表,您可以更容易地更新数据而不影响其他记录。
- 增强数据完整性:确保数据保持一致且准确。
是什么引发了规范化的需求?
如果表没有被正确规范化且存在数据冗余,不仅会占用额外的存储空间,还会让数据库的处理和更新变得困难。
推动规范化需求的因素有很多,从数据冗余(如上所述)到难以管理关系。主要包括:
- 插入、删除和更新异常:如果处理不当,对表进行的任何更改都可能导致其他表出现错误或不一致。这些更改可能是向数据库添加新数据、更新数据或删除记录,都会引起意外的数据丢失。
- 关系管理困难:在非规范化结构中,维护复杂关系会更具挑战性。
- 其他驱动因素包括部分依赖和传递依赖。部分依赖可能导致数据冗余和更新异常,传递依赖可能导致数据异常。我们将在接下来的部分中介绍如何处理这些依赖,以确保数据库规范化。
数据库规范化的不同类型
到目前为止,我们已经了解了SQL 中的规范化是什么、为什么重要,以及规范化需求的原因。数据库规范化有不同的形式,各自对应更高层次的数据组织。
本节我们将先简要讨论不同的规范化级别,然后在下一节中深入展开。
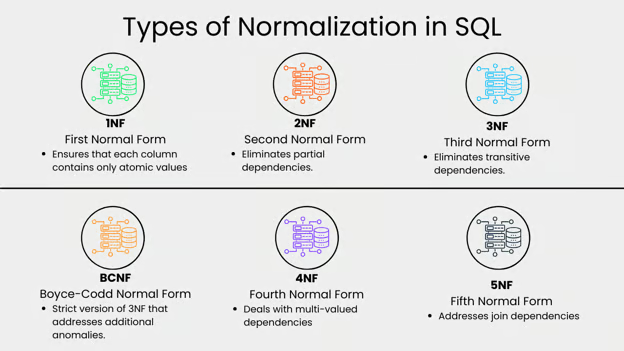
作者制图
各范式快速对比
| 范式 | 要求 | 消除的问题 |
|---|---|---|
| 1NF | 每个单元为原子值;行唯一 | 重复组与多值单元 |
| 2NF | 复合键上无部分依赖 | 来自部分键关系的冗余 |
| 3NF | 无传递依赖 | 非键列之间的间接依赖 |
| BCNF | 每个决定因素都是候选键 | 3NF 遗漏的异常 |
| 4NF | 无多值依赖 | 相互独立的多值属性 |
| 5NF | 无连接依赖 | 由有损分解引起的冗余 |
第一范式(1NF)
该级别确保数据中每一列都只包含原子值。此处的原子值指的是列中的每个条目都是不可再分的。就像电子表格中每个单元格应只保存一条信息。1NF确保数据的原子性:每个单元格只包含单一值,每列具有唯一名称。
第二范式(2NF)
通过确保非键属性仅依赖于主键,以消除部分依赖。本质上,这意味着每一列都应直接与主键相关,而不是依赖其他列。
第三范式(3NF)
通过确保非键属性只依赖主键来消除传递依赖。该级别基于 2NF 进一步规范。
Boyce-Codd 范式(BCNF)
这是 3NF 的更严格版本,解决额外的异常。在该级别中,每个决定因素都是候选键。
第四范式(4NF)
在 BCNF 的基础上处理多值依赖的规范化级别。
第五范式(5NF)
5NF 是最高级别的规范化,处理连接依赖。在特定场景下,通过将表进一步拆分为更小的表来最大限度地减少冗余。
结合真实案例理解数据库规范化
我们已经概览了所有的规范化级别。下面通过示例与说明更深入地探讨每个级别。
第一范式(1NF)规范化
1NF 要求每个单元格仅包含原子值。设想一个图书馆数据库,其中一张表存储图书信息(title、author、genre 和 borrowed_by)。如果该表未规范化,borrowed_by 可能包含以逗号分隔的借阅者姓名列表。这违反了 1NF,因为单个单元格包含多个值。下面的表就很好地体现了之前所述的违反 1NF 的情况。
title | author | genre | borrowed_by |
To Kill a Mockingbird | Harper Lee | Fiction | John Doe, Jane Doe, James Brown |
The Lord of the Rings | J. R. R. Tolkien | Fantasy | Emily Garcia, David Lee |
Harry Potter and the Sorcerer’s Stone | J.K. Rowling | Fantasy | Michael Chen |
如何解决?
在 1NF 下,我们为借阅者创建单独的表,并将其与图书表关联。这些表可以通过在借阅者表中使用外键,或通过一个单独的关联表来链接。采用在借阅者表中添加外键的方式,即在借阅者表中新增一个引用图书表主键的外键列。这样可以在表之间强制建立关系,确保数据一致性。
如下所示:
以下是创建这些规范化表的 SQL:
CREATE TABLE books (
book_id INT PRIMARY KEY,
title VARCHAR(255),
author VARCHAR(100),
genre VARCHAR(50)
);
CREATE TABLE borrowers (
borrower_id INT PRIMARY KEY,
name VARCHAR(100),
book_id INT,
FOREIGN KEY (book_id) REFERENCES books(book_id)
);Books 表
book_id (PK) | title | author | genre |
1 | To Kill a Mockingbird | Harper Lee | Fiction |
2 | The Lord of the Rings | J. R. R. Tolkien | Fantasy |
3 | Harry Potter and the Sorcerer’s Stone | J.K. Rowling | Fantasy |
Borrowers 表
borrower_id (PK) | name | book_id (FK) |
1 | John Doe | 1 |
2 | Jane Doe | 1 |
3 | James Brown | 1 |
4 | Emily Garcia | 2 |
5 | David Lee | 2 |
6 | Michael Chen | 3 |
第二范式(2NF)
如前所述,该级别在 1NF 基础上,确保主键上不存在部分依赖。简言之,所有非键属性必须依赖于整个主键,而不是主键的一部分。
在 1NF 的实现中,我们已经有两张独立的表(可参见 1NF 部分)。
现在,假设我们希望将这些表关联以记录借阅情况。最初的做法可能是在Books 表中简单添加一个 borrower_id 列,如下所示:
book_id (PK) | title | author | genre | borrower_id (FK) |
1 | To Kill a Mockingbird | Harper Lee | Fiction | 1 |
2 | The Lord of the Rings | J. R. R. Tolkien | Fantasy | NULL |
3 | Harry Potter and the Sorcerer’s Stone | J.K. Rowling | Fantasy | 6 |
这看起来像是一个方案,但它违反了 2NF,因为 borrower_id 只部分依赖于 book_id。一本书可以有多个借阅者,但在此结构中单个 borrower_id 只能关联一本书,这就产生了部分依赖。
如何解决?
为实现 2NF,我们需要在图书与借阅者之间建立多对多关系。这可以通过引入一张独立的表来完成:
Book_borrowings 表
| borrowing_id (PK) | book_id (FK) | borrower_id (FK) | borrowed_date |
|---|---|---|---|
| 1 | 1 | 1 | 2024-05-04 |
| 2 | 2 | 4 | 2024-05-04 |
| 3 | 3 | 6 | 2024-05-04 |
该表建立了图书与借阅者之间的清晰关系。book_id 和 borrower_id 作为外键,分别引用其各自主键。此方式确保 borrower_id 依赖于 Books 表的整个主键(book_id),从而符合 2NF。
第三范式(3NF)
3NF 在 2NF 的基础上消除传递依赖。传递依赖是指非键属性依赖于另一个非键属性,而后者又依赖于主键。其含义可类比“传递律”。
在已实现的 2NF 结构中,我们的图书馆数据库包含三张表:
Books 表
book_id (PK) | title | author | genre |
1 | To Kill a Mockingbird | Harper Lee | Fiction |
2 | The Lord of the Rings | J. R. R. Tolkien | Fantasy |
3 | Harry Potter and the Sorcerer’s Stone | J.K. Rowling | Fantasy |
Borrowers 表
borrower_id (PK) | name | book_id (FK) |
1 | John Doe | 1 |
2 | Jane Doe | 1 |
3 | James Brown | 1 |
4 | Emily Garcia | 2 |
5 | David Lee | 2 |
6 | Michael Chen | 3 |
Book_borrowings 表
borrowing_id (PK) | book_id (FK) | borrower_id (FK) | borrowed_date |
1 | 1 | 1 | 2024-05-04 |
2 | 2 | 4 | 2024-05-04 |
3 | 3 | 6 | 2024-05-04 |
2NF 的结构看起来很高效,但可能存在隐藏依赖。设想我们在 Books 表中添加一个 due_date 列。乍看合理,但会产生如下传递依赖:
- due_date 列依赖于 Book_borrowings 表中的 borrowing_id(一个非键属性)。
- 而 borrowing_id 又依赖于 Books 表的主键 book_id。
这意味着 due_date 依赖于一个中间的非键属性(borrowing_id),而非直接依赖主键(book_id),从而违反 3NF。
如何解决?
我们可以将 due_date 列移动到更合适的表中,即将 Book_borrowings 表更新为包含 due_date 和 returned_date 列。
更新后的表如下:
borrowing_id (PK) | book_id (FK) | borrower_id (FK) | borrowed_date | due_date |
1 | 1 | 1 | 2024-05-04 | 2024-05-20 |
2 | 2 | 4 | 2024-05-04 | 2024-05-18 |
3 | 3 | 6 | 2024-05-04 | 2024-05-10 |
将 due_date 放在 Book_borrowings 表中,我们成功消除了传递依赖。
这意味着 due_date 现在直接依赖于 book_id 与 borrower_id 的组合关系。在此语境下,book_id 和 borrower_id 作为复合外键共同构成 Book_borrowings 表的主键。
Boyce-Codd 范式(BCNF)
BCNF 基于函数依赖,考虑关系中的所有候选键。
函数依赖(FD)定义了关系型数据库中属性之间的关系。FD 指明某一列的值可以决定另一相关列的值。FD 非常重要,因为它通过识别依赖关系来指导规范化过程,确保数据被合理分布到各表中。
BCNF 是 3NF 的更严格版本。它确保表中的每个决定因素(能唯一标识一行的一组属性)都是候选键(能唯一标识一行的最小属性集)。其核心在于:所有决定因素都应能充当主键。
它要求每个函数依赖(FD)的决定因素都是超键。换言之,若X —> Y(X 决定 Y)成立,则 X 必须是该关系的候选键(超键)。请注意,X 和 Y 指的是数据表中的列。
延续 3NF 结构,我们有三张表:
Books 表
book_id (PK) | title | author | genre |
1 | To Kill a Mockingbird | Harper Lee | Fiction |
2 | The Lord of the Rings | J. R. R. Tolkien | Fantasy |
3 | Harry Potter and the Sorcerer’s Stone | J.K. Rowling | Fantasy |
Borrowers 表
borrower_id (PK) | name | book_id (FK) |
1 | John Doe | 1 |
2 | Jane Doe | 1 |
3 | James Brown | 1 |
4 | Emily Garcia | 2 |
5 | David Lee | 2 |
6 | Michael Chen | 3 |
Book_borrowings 表
borrowing_id (PK) | book_id (FK) | borrower_id (FK) | borrowed_date | due_date |
1 | 1 | 1 | 2024-05-04 | 2024-05-20 |
2 | 2 | 4 | 2024-05-04 | 2024-05-18 |
3 | 3 | 6 | 2024-05-04 | 2024-05-10 |
虽然 3NF 的结构不错,但在 Book_borrowings 表中可能存在隐藏的决定因素。假设同一借阅者不能同时借阅同一本书,那么 book_id 与 borrower_id 的组合就能唯一标识一条借阅记录。
这就违反了 BCNF,因为该组合(book_id 与 borrower_id)并不是该表的主键(主键仅为 borrowing_id)。
如何解决?
为满足 BCNF,我们可以将 Book_borrowings 表拆分为两张独立表,或将该组合属性设为主键。
- 方案一(拆分表):将 Book_borrowings 表拆分为两张表:
- 一张以 borrowing_id 为主键,包含 borrowed_date、due_date 和 returned_date。
- 另一张用于关联图书与借阅者,包含 book_id 和 borrower_id 两个外键,并可包含借阅事件的附加属性。
- 方案二(将组合属性设为主键):考虑使用 book_id 与 borrower_id 作为复合主键来唯一标识借阅记录。但若借阅者可多次借同一本书,该方案将无法满足需求。
最终选择取决于您的具体数据需求以及对借阅关系的建模方式。
第四范式(4NF)
4NF 处理多值依赖。当一个属性可以拥有多个依赖属性,且这些依赖属性与主键相互独立时,就存在多值依赖。这比较复杂,我们将通过示例深入说明。
前面的图书馆示例不适用于这一规范化级别。4NF 通常出现在单个属性可能拥有多个彼此独立、且不直接与主键相关的依赖属性的场景中。
我们换个场景。设想一个存储出版物信息的数据库。考虑一张“Publications”表,包含列:title、author、publication_year 和 keywords。
publication_id (PK) | title | author | publication_year | keywords |
1 | To Kill a Mockingbird | Harper Lee | 1960 | Coming-of-Age, Legal |
2 | The Lord of the Rings | J. R. R. Tolkien | 1954 | Fantasy, Epic, Adventure |
3 | Pride and Prejudice | Jane Austen | 1813 | Romance, Social Commentary |
上述表结构违反 4NF,因为:
- keywords 列对主键 publication_id 存在多值依赖。即一篇出版物可以拥有多个关键词,这些关键词独立于出版物的唯一标识。
如何解决?
我们可以创建一张独立的表。
Publication_keywords 表
publication_id (FK) | keyword |
1 | Coming-of-Age |
1 | Legal |
2 | Fantasy |
2 | Epic |
2 | Adventure |
3 | Romance |
3 | Social Commentary |
新建的 Publication_keywords 表在出版物与关键词之间建立了多对多关系。每篇出版物可以通过作为外键的 publication_id 关联多个关键词,而每个关键词也可以关联多篇出版物。
至此,我们成功消除了多值依赖,达到 4NF。
第五范式(5NF)
5NF 是最复杂的规范化形式,消除连接依赖。即使表已经达到 4NF,为回答特定查询仍需从多张表进行连接时,就可能存在连接依赖。
更直白地说,5NF 确保通过连接各表不会产生那些原本不在各自独立表中可得的额外信息。
当表已规范化(达到 3NF 或 4NF)时,连接依赖不太常见,因此很难为 5NF 构造清晰直接的示例。
不过,我们来看一个 5NF 可能相关的场景:
设想一个大学数据库,其中“Courses”和“Enrollments”两张表已规范化。
Courses 表
course_id (PK) | course_name | department |
101 | Introduction to Programming | Computer Science |
202 | Data Structures and Algorithms | Computer Science |
301 | Web Development I | Computer Science |
401 | Artificial Intelligence | Computer Science |
Enrollments 表
enrollment_id (PK) | student_id (FK) | course_id (FK) | grade |
1 | 12345 | 101 | A |
2 | 12345 | 202 | B |
3 | 56789 | 301 | A- |
4 | 56789 | 401 | B+ |
假设这些表已达到 3NF 或 4NF,仍可能因数据存储方式而存在连接依赖。例如,在“Courses”表中用“prerequisite_course_id”列存储课程的先修课要求。
这看似高效。但若需要查询某位学生所修课程及各自的先修课程,则需要先连接“Courses”与“Enrollments”,然后可能再次连接“Courses”以取回先修信息。
如何解决?
为潜在地消除连接依赖并实现 5NF,我们可以引入一张独立的“Course Prerequisites”表:
Course_prerequisite 表
course_id (FK) | prerequisite_course_id (FK) |
202 | 101 |
301 | NULL |
401 | 202 |
此做法将先修信息拆分出来,仅需在“Enrollments”和“Course_prerequisites”之间进行一次连接,即可高效检索所修课程及其先修课。
注:此处假设每门课程对某位学生仅有一个先修要求。
5NF 十分复杂且较为少见,作为数据学习的入门者,您可能暂时用不到。但提前了解能帮助您在遇到复杂数据库时更有准备。
规范化 vs. 反规范化
尽管规范化能降低冗余、提升数据完整性,但在某些情况下,反规范化更合适。反规范化会有意引入冗余,以提升特定工作负载下的读取性能。
| 对比项 | 规范化 | 反规范化 |
|---|---|---|
| 目标 | 减少冗余和异常 | 提升读取/查询性能 |
| 最适合 | OLTP 系统(事务) | OLAP 系统(分析、报表) |
| 写入速度 | 更快(只需在一个位置更新) | 更慢(需在多个位置更新) |
| 读取速度 | 可能较慢(需要更多连接) | 更快(需要更少连接) |
| 数据完整性 | 更高 | 更低(存在不一致风险) |
| 存储 | 更少(无重复数据) | 更多(有意重复数据) |
在实践中,大多数生产数据库会综合使用两种方法。以完全规范化的模式起步,然后在查询性能需要的地方选择性地进行反规范化。
提升您的 SQL 技能
如果您看到这里,恭喜您坚持读到最后。我们已经系统探索了 SQL 中的规范化是什么、为什么重要、规范化需求的成因,以及数据库规范化的不同类型。文中的情景示例旨在帮助您充分理解并能在学习中加以应用。
规范化是任何数据相关职业路径的入门必备技能。理解这些原则后,您已准备好构建高效、结构良好的数据库。
在数据领域,持续学习非常重要。若您希望强化 SQL 能力,下面这些资源将助您一臂之力。
常见问题解答
什么是 DBMS 中的规范化?
数据库规范化是一种为关系型数据库设计最优模式的技术。它通过将表划分为更小的子表,并以指针(引用)指向数据而非复制数据本身来实现。
为什么规范化很重要?
规范化有助于防止数据冗余、提升数据完整性,并简化数据库中的数据操作。
是否需要将数据库规范化到 5NF?
不一定。对于大多数数据库,3NF 或 4NF 往往已足够。5NF 是最严格的形式,可能仅对具有特定查询模式的复杂数据库有益。
如何判断是否需要规范化到 5NF?
请仔细分析您的查询与数据模型。如果您发现为检索某些信息需要连接多张表,而这些信息在理论上应能从各独立表中推导出来,那么可以考虑 5NF。不过,务必在复杂性与潜在性能收益之间权衡。您可参考文中的 5NF 部分以获取基于案例的进一步理解。
规范化与反规范化有何区别?
规范化是通过将数据拆分为更小、相互关联的表来组织数据库,从而减少冗余。反规范化则相反:为提升读取性能而有意引入冗余。多数生产数据库先进行规范化,再针对报表与分析等查询密集型工作负载选择性地反规范化。
实践中最常用的范式是什么?
第三范式(3NF)是生产数据库中最常用的规范化级别。它在保持模式易用的同时,消除了来自部分依赖与传递依赖的冗余。更高的范式如 BCNF、4NF 和 5NF 使用频率较低,通常仅适用于具有复杂数据关系的专项场景。
资深数据从业者与写作者,热衷于帮助有志于数据领域的专业人士成长与精进。
规范化是关系型数据库设计中最基本的概念之一。在本指南中,我将通过真实案例讲解每一种范式(从 1NF 到 5NF),以便您将这些原则应用到自己的数据库中。无论您希望成为数据科学家还是数据工程师,理解规范化都非常重要。