用户与关注者、学生与课程、客户与产品:我们的世界充满了天然的多对多关系。然而,这些关系并不总能被良好地落实到数据库设计中。糟糕的多对多设计是生产系统中数据重复、分析结果不准确、以及长期维护困难的最常见根源之一。
在本文中,我将从第一性原理到真实落地实现,全面讲解多对多关系。我们还将探讨高级设计模式、规范化、性能考量,以及多对多关系在关系型与 NoSQL 系统中的实现方式。
读完本文后,您应能设计出可扩展、易维护、能正确建模复杂关系的模式,避免数据异常,并支持可靠的报表与商业智能工作流。
对于希望在阅读过程中巩固基础的读者,推荐学习我们的《SQL 关系型数据库入门》课程。
什么是多对多关系
多对多关系(M:N)是一种双向的数据库关系,其中表 A 的每条记录可关联表 B 的多条记录,表 B 的每条记录也可关联表 A 的多条记录。与更简单的关系类型不同,基数在两侧同时存在。
这种关系在真实系统中随处可见:
- 教育:一个学生可以选修多门课程,每门课程也可拥有许多学生。
- 电商:一个产品可以属于多个品类,每个品类也可包含许多产品。
- 社交平台:用户可以加入多个群组,群组也可包含许多用户。
- 医疗:一位患者可以被处方多种药物,每种药物也可被处方给许多患者。
这种关系本身具有意义,且往往承载数据。理解这一点对正确的模式设计与查询至关重要,尤其是在为分析目的进行表连接时。
多对多 vs 一对多关系
要理解为何多对多关系需要特殊处理,将其与更简单的基数关系进行对比会有帮助。
- 一对一(1:1):表 A 中的每条记录精确关联表 B 中的一条记录,反之亦然(例如用户与用户档案)。
- 一对多(1:N):表 A 的一条记录可关联表 B 的多条记录,但表 B 的每条记录仅关联表 A 的一条记录(例如客户与其订单)。
|
关系类型
|
描述
|
逻辑
|
示例
|
|
一对一(1:1)
|
表 A 中的每条记录恰好关联表 B 中的一条记录。
|
唯一配对。
|
User ↔ User Profile
|
|
一对多(1:N)
|
表 A 的一条记录可关联表 B 的多条记录,但表 B 的记录仅有一个父级。
|
父子结构。
|
Customer → Multiple Orders
|
|
多对多(M:N)
|
表 A 的多条记录关联表 B 的多条记录。
|
双向网络。
|
Students ↔ Courses
|
例如,在一对多设计中,订单表通常包含一个 customer_id 外键,每条唯一订单都有一个 order_id。每个订单恰好属于一个客户,但一个客户可以拥有多个 order_id 键。
现在再看学生—课程的例子。如果尝试将 course_id 直接存放在学生表中,每位学生都会关联多个 course_id 值。相反,在课程表内,每门课程也会有多个 student_id 引用。关系不再是整齐的单向结构,而是双向共享信息。
第一范式违例与多对多难题
一个常见问题是试图直接表示多对多关系,比如在单列中存放多个值(如在 students 表上使用 course_ids 数组),或使用重复列如 course_1、course_2、course_3。
这种做法违反第一范式(1NF),其要求每一列包含原子且不可再分的值。若需复习,请阅读这篇关于SQL 规范化的博文。
违反 1NF 会导致经典的更新异常:
- 插入异常:添加一条新关系需要修改现有行的结构。
- 更新异常:更改一条关系需要更新多行、多列或嵌入值,增加不一致的风险。
- 删除异常:移除一条关系可能会意外删除无关信息。
除了规范化理论外,还有一个严重的分析后果,被称为多对多问题。当未谨慎地连接存在多对多关系的表时,极易导致行数倍增。这会带来计算时间的浪费以及聚合分析的错误。
例如,基于 student_id 将 courses 与 students 连接,可能由于某门课程对应多名学生而使每门课程被多次连接。此后再进行聚合,容易在收入或学生计数等指标上出现分析偏差。
正确的模式设计直接影响报表准确性、财务计算以及对数据产品的信任。同时,它还能简化连接,降低人为失误。了解更多常见连接陷阱,请参阅这篇SQL 连接教程,并练习这些SQL 连接 Top 20 面试题。
连接表:基础与结构
在关系型系统中,解决多对多关系的标准方案是连接表(也称联结表、桥接表、关联表)。与其尝试直接存储关系,不如引入一个同时引用两个父表的中间表。
从概念上,这将 A ↔ B 转换为 A ← JT→ B。
现在,二者分别与连接表形成一对多关系,从而得到简化的分析型模式。我将介绍如何构建这些连接表以及如何使用它们。
组成与要素
一个基本的连接表包含:
- 一个外键,引用表 A 的主键
- 一个外键,引用表 B 的主键
在大多数情况下,这两个外键共同组成复合主键。这可保证同一关系不会被重复插入,并在数据库层面强制唯一性。
例如,enrollments 表可以将 student_id 与 course_id 的拼接作为主键。数据库由此获得该关系的唯一参考键,我们便可开始构建业务用例。
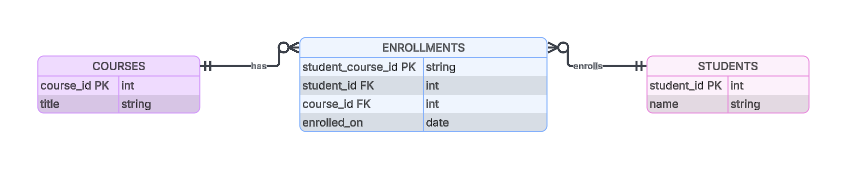
示例:enrollments 连接表的可能结构。
为连接表添加属性
当连接表存储了额外属性,它更接近于“关联实体”而非纯结构性产物。这样,连接表可包含关于关系的上下文信息。常见示例包括:
这有助于让关系承载更多意义。查询复杂度会略有上升,但模式能更准确地反映现实。在关系会随时间演变的系统中,这种权衡几乎总是值得的。我们可以加入更多信息,使连接表成为实用的分析工具。
维护数据完整性
连接表高度依赖参照完整性。外键约束确保每条关系行都引用有效的父记录,避免产生孤儿数据。
删除规则很重要:
- CASCADE:当父记录被删除时自动移除连接表中的相关行。
- RESTRICT / NO ACTION:若关系仍存在,则阻止删除父记录。
选择取决于业务语义。在某些领域,自动清理是合适的;在另一些领域,必须保留历史关系,或在移除前进行明确复核。
规范化与连接表
连接表是第三范式(3NF)的直接应用。它们消除传递依赖并移除关系数据的冗余存储。其核心目标就是提升数据库内的规范化程度。
很多情况下,连接表也有助于满足 Boyce–Codd 范式(BCNF),因为复合主键能够完全决定所有非键属性。这很重要,因为它最大限度地减少更新异常,并保证修改一条关系只需变更恰好一行。
若想深入理解为何确保 3NF 对我们的数据库如此重要,请参阅这篇关于传递依赖的文章。
多对多关系的设计与实现
接下来讨论如何真正构建数据库以支持多对多关系。我们将介绍一些最佳实践,帮您事半功倍。
命名规范与模式清晰度
清晰的表命名可降低认知负担、提升可维护性。常见约定包括使用 TableA_TableB 或 join_TableATableB,例如:
-
student_course
-
user_group
-
join_user_group
列名应当与父表主键相呼应(如 student_id、course_id),让连接逻辑直观、可读。随着模式规模扩大与团队扩张,一致性愈发关键。
常见模式与变体
构建连接表有多种方式,从非常简单的关系跟踪到更复杂的多态关系。
简单连接表
简单连接表仅包含外键,适合静态或上下文较少的关系。它们非常易于维护,开销极小,因为通常只需表达两张表之间的关联关系。这类连接表不包含时间或上下文数据。
自引用的多对多关系
当两个外键都引用同一张表时,就会出现自引用的多对多关系。
例如,在追踪一款社交应用中的用户、其关注者与被关注关系时,可能在两个方向上都存在 user_id 到 follower_id 的关系。可能还需要额外约束以防止无效或对称的重复记录。
多态多对多关系
多态多对多关系允许使用类型鉴别符,让一张连接表关联多种实体类型。这带来灵活性,但会将完整性约束转移到应用逻辑中,并使查询更复杂。
例如,社交应用中的一个名为 Tag 的连接表,可能同时关联 Posts、Comments 与 Users,并增加一个上下文字段以将标签关联到正确的实体。
时序与加权关系
时序与加权关系都通过额外属性来存储关于关系本身的信息。
时序型多对多关系会新增提供时间信息的列,如 active_from、active_to 或 created_on,以追踪历史有效性。我们先前学生—课程数据库中的 enrolled_on 键就是时序关系的一个例子。
这对审计追踪、缓慢变化的关系、以及时点分析至关重要。它也带来一些复杂性:用户必须注意在合适的时间尺度上过滤,并考虑可能处于非活动状态的行。
另一方面,加权关系会存储排序或强度度量。推荐引擎、标签系统与相关性评分通常依赖这一模式来记录如推荐置信度等信息。
多方关系
尽管大多数 OLTP 系统避免涉及多于两个实体的关系,但分析系统中却经常使用。维度建模中的事实表实质上充当了连接不同粒度表的连接表。这些设计功能强大,但需要有纪律的查询与清晰的文档。
一种潜在设计是创建包含所有参与实体外键的连接表。
例如,在学生与课程的例子上再加一张教室编号表。一个连接表可以包含某位学生在某门课程、某间教室的外键。显而易见,随着关系数量的扩展,查询与模式复杂度会呈指数级增长。
想要更深入学习数据库构建,请务必选修我们的数据库设计课程。
性能优化与查询效率
面对任何复杂的数据库设计,我们都需要关注性能与查询因素。组件越多,越容易遭遇性能瓶颈!
查询模式与优化
先来看一些查询连接表的方式。常见访问模式包括:
- 为表 A 中给定实体获取表 B 的所有关联实体
- 统计关系数量
- 按关系属性进行过滤
优化这些查询的做法:
这些技巧是高效连接与聚合的基础。还要记住,如果您打算用连接表来桥接两张表,务必考虑如何高效连接三张表。
批量操作与并发
连接表常见高写入量。使用批量插入与更新可降低事务开销。
然而,对热门外键的高竞争可能造成锁竞争瓶颈。请务必监控性能,并对表进行分区以实现并行化。
规范化 vs 反规范化
我们来简单比较一下规范化与反规范化在数据库设计中的取向差异:
- 规范化设计适合写入密集、对一致性要求极高的系统(如财务、ERP)。若必须严格一致、杜绝重复或多余数据,应坚持严格的规范化设计。
- 反规范化设计适合读负载为主、可接受最终一致性的分析场景。若数据可访问性更重要,且允许数据稍后“收敛”,则可采用反规范化设计,但需提供严格的最佳实践指引。
务必认真评估访问模式、团队经验与运维约束。
反规范化的权衡
在不经常变化的写入密集系统中,反规范化可以提升性能。代价是复杂性增加、维护负担加重、以及数据陈旧的风险。
我的一点看法:反规范化应仅作为对读负载瓶颈的审慎回应,并且始终要配套定期一致性检查。
跨数据库系统的实现
SQL 与 NoSQL 系统在实现多对多关系时略有差异。
关系型与 NoSQL 架构
关系型数据库如PostgreSQL、MySQL 与 SQL Server,会使用带有外键与复合主键的连接表显式实现多对多关系。同样,云端关系型数据库如Snowflake也遵循类似的设计模式。
NoSQL 系统通常通过嵌入相关 ID 的数组或由应用逻辑管理的引用来表示多对多关系。这是因为 NoSQL 数据库优先考虑读性能与水平扩展能力。此举提升读性能与模式灵活性,但牺牲了规范化。
|
特性
|
关系型(SQL)
|
NoSQL
|
|
实现方式
|
连接表:使用第三张表,包含外键与复合主键。
|
嵌入或引用:使用 ID 数组或嵌套文档。
|
|
主要目标
|
规范化:确保数据一致性并消除冗余。
|
性能:优先读速与水平扩展。
|
|
灵活性
|
刚性模式:需要预定义结构并通过连接取数。
|
高灵活性:允许无模式设计与多样数据类型。
|
|
权衡
|
复杂连接:数据集显著增长时可能变慢。
|
牺牲规范化:可能导致数据重复或“陈旧”数据。
|
|
示例
|
PostgreSQL、MySQL、SQL Server、Snowflake。
|
MongoDB、DynamoDB、Cassandra。
|
SQL vs NoSQL
当您需要一个定义完善的模式结构时,更推荐使用关系型数据库。这类数据库更便于操作,且有助于更好的数据管理。考虑在以下情形优先选择关系型 SQL 数据库:
- 关系变动频繁
- 完整性对业务至关重要
- 查询涉及复杂连接
当灵活性与批量可操作性优先时,NoSQL 数据库更合适。比如,MongoDB 等 NoSQL 数据库在需要对大量文档执行更新时,支持使用如updateMany之类的操作符。以下是考虑使用 NoSQL 实现的一些指导原则:
- 基数可预测
- 读远多于写
- 模式灵活性比严格一致性更重要
结语
在现实的数据模型中,多对多关系不可避免。正确设计它们对数据完整性、可扩展性与分析准确性至关重要。经过恰当规范化与索引优化的连接表,为从事务系统到企业级分析的各类场景提供了稳健基础。
任何设计都涉及权衡:规范化与性能、简洁与灵活、抽象与控制。关键在于剖析您的访问模式,选择与工作负载契合的模式,并通过模式评审与查询测试验证设计。
对于希望深化数据库设计技能的从业者,我强烈推荐报名我们的SQL 助理数据分析师职业路径。


用户与关注者、学生与课程、客户与产品:我们的世界充满了天然的多对多关系。然而,这些关系并不总能被良好地落实到数据库设计中。糟糕的多对多设计是生产系统中数据重复、分析结果不准确、以及长期维护困难的最常见根源之一。
在本文中,我将从第一性原理到真实落地实现,全面讲解多对多关系。我们还将探讨高级设计模式、规范化、性能考量,以及多对多关系在关系型与 NoSQL 系统中的实现方式。
读完本文后,您应能设计出可扩展、易维护、能正确建模复杂关系的模式,避免数据异常,并支持可靠的报表与商业智能工作流。
对于希望在阅读过程中巩固基础的读者,推荐学习我们的《SQL 关系型数据库入门》课程。
什么是多对多关系
多对多关系(M:N)是一种双向的数据库关系,其中表 A 的每条记录可关联表 B 的多条记录,表 B 的每条记录也可关联表 A 的多条记录。与更简单的关系类型不同,基数在两侧同时存在。
这种关系在真实系统中随处可见:
这种关系本身具有意义,且往往承载数据。理解这一点对正确的模式设计与查询至关重要,尤其是在为分析目的进行表连接时。
多对多 vs 一对多关系
要理解为何多对多关系需要特殊处理,将其与更简单的基数关系进行对比会有帮助。
关系类型
描述
逻辑
示例
一对一(1:1)
表 A 中的每条记录恰好关联表 B 中的一条记录。
唯一配对。
User ↔ User Profile
一对多(1:N)
表 A 的一条记录可关联表 B 的多条记录,但表 B 的记录仅有一个父级。
父子结构。
Customer → Multiple Orders
多对多(M:N)
表 A 的多条记录关联表 B 的多条记录。
双向网络。
Students ↔ Courses
例如,在一对多设计中,订单表通常包含一个
customer_id外键,每条唯一订单都有一个order_id。每个订单恰好属于一个客户,但一个客户可以拥有多个order_id键。现在再看学生—课程的例子。如果尝试将
course_id直接存放在学生表中,每位学生都会关联多个course_id值。相反,在课程表内,每门课程也会有多个student_id引用。关系不再是整齐的单向结构,而是双向共享信息。第一范式违例与多对多难题
一个常见问题是试图直接表示多对多关系,比如在单列中存放多个值(如在
students表上使用course_ids数组),或使用重复列如course_1、course_2、course_3。这种做法违反第一范式(1NF),其要求每一列包含原子且不可再分的值。若需复习,请阅读这篇关于SQL 规范化的博文。
违反 1NF 会导致经典的更新异常:
除了规范化理论外,还有一个严重的分析后果,被称为多对多问题。当未谨慎地连接存在多对多关系的表时,极易导致行数倍增。这会带来计算时间的浪费以及聚合分析的错误。
例如,基于
student_id将courses与students连接,可能由于某门课程对应多名学生而使每门课程被多次连接。此后再进行聚合,容易在收入或学生计数等指标上出现分析偏差。正确的模式设计直接影响报表准确性、财务计算以及对数据产品的信任。同时,它还能简化连接,降低人为失误。了解更多常见连接陷阱,请参阅这篇SQL 连接教程,并练习这些SQL 连接 Top 20 面试题。
连接表:基础与结构
在关系型系统中,解决多对多关系的标准方案是连接表(也称联结表、桥接表、关联表)。与其尝试直接存储关系,不如引入一个同时引用两个父表的中间表。
从概念上,这将 A ↔ B 转换为 A ← JT→ B。
现在,二者分别与连接表形成一对多关系,从而得到简化的分析型模式。我将介绍如何构建这些连接表以及如何使用它们。
组成与要素
一个基本的连接表包含:
在大多数情况下,这两个外键共同组成复合主键。这可保证同一关系不会被重复插入,并在数据库层面强制唯一性。
例如,
enrollments表可以将student_id与course_id的拼接作为主键。数据库由此获得该关系的唯一参考键,我们便可开始构建业务用例。示例:
enrollments连接表的可能结构。为连接表添加属性
当连接表存储了额外属性,它更接近于“关联实体”而非纯结构性产物。这样,连接表可包含关于关系的上下文信息。常见示例包括:
日期:
enrollment_date、creation_date及类似的时间信息角色:例如群组中的管理员与成员
度量:在推荐系统中的相关性评分
这有助于让关系承载更多意义。查询复杂度会略有上升,但模式能更准确地反映现实。在关系会随时间演变的系统中,这种权衡几乎总是值得的。我们可以加入更多信息,使连接表成为实用的分析工具。
维护数据完整性
连接表高度依赖参照完整性。外键约束确保每条关系行都引用有效的父记录,避免产生孤儿数据。
删除规则很重要:
选择取决于业务语义。在某些领域,自动清理是合适的;在另一些领域,必须保留历史关系,或在移除前进行明确复核。
规范化与连接表
连接表是第三范式(3NF)的直接应用。它们消除传递依赖并移除关系数据的冗余存储。其核心目标就是提升数据库内的规范化程度。
很多情况下,连接表也有助于满足 Boyce–Codd 范式(BCNF),因为复合主键能够完全决定所有非键属性。这很重要,因为它最大限度地减少更新异常,并保证修改一条关系只需变更恰好一行。
若想深入理解为何确保 3NF 对我们的数据库如此重要,请参阅这篇关于传递依赖的文章。
多对多关系的设计与实现
接下来讨论如何真正构建数据库以支持多对多关系。我们将介绍一些最佳实践,帮您事半功倍。
命名规范与模式清晰度
清晰的表命名可降低认知负担、提升可维护性。常见约定包括使用
TableA_TableB或join_TableATableB,例如:student_courseuser_groupjoin_user_group列名应当与父表主键相呼应(如
student_id、course_id),让连接逻辑直观、可读。随着模式规模扩大与团队扩张,一致性愈发关键。常见模式与变体
构建连接表有多种方式,从非常简单的关系跟踪到更复杂的多态关系。
简单连接表
简单连接表仅包含外键,适合静态或上下文较少的关系。它们非常易于维护,开销极小,因为通常只需表达两张表之间的关联关系。这类连接表不包含时间或上下文数据。
自引用的多对多关系
当两个外键都引用同一张表时,就会出现自引用的多对多关系。
例如,在追踪一款社交应用中的用户、其关注者与被关注关系时,可能在两个方向上都存在
user_id到follower_id的关系。可能还需要额外约束以防止无效或对称的重复记录。多态多对多关系
多态多对多关系允许使用类型鉴别符,让一张连接表关联多种实体类型。这带来灵活性,但会将完整性约束转移到应用逻辑中,并使查询更复杂。
例如,社交应用中的一个名为
Tag的连接表,可能同时关联Posts、Comments与Users,并增加一个上下文字段以将标签关联到正确的实体。时序与加权关系
时序与加权关系都通过额外属性来存储关于关系本身的信息。
时序型多对多关系会新增提供时间信息的列,如
active_from、active_to或created_on,以追踪历史有效性。我们先前学生—课程数据库中的enrolled_on键就是时序关系的一个例子。这对审计追踪、缓慢变化的关系、以及时点分析至关重要。它也带来一些复杂性:用户必须注意在合适的时间尺度上过滤,并考虑可能处于非活动状态的行。
另一方面,加权关系会存储排序或强度度量。推荐引擎、标签系统与相关性评分通常依赖这一模式来记录如推荐置信度等信息。
多方关系
尽管大多数 OLTP 系统避免涉及多于两个实体的关系,但分析系统中却经常使用。维度建模中的事实表实质上充当了连接不同粒度表的连接表。这些设计功能强大,但需要有纪律的查询与清晰的文档。
一种潜在设计是创建包含所有参与实体外键的连接表。
例如,在学生与课程的例子上再加一张教室编号表。一个连接表可以包含某位学生在某门课程、某间教室的外键。显而易见,随着关系数量的扩展,查询与模式复杂度会呈指数级增长。
想要更深入学习数据库构建,请务必选修我们的数据库设计课程。
性能优化与查询效率
面对任何复杂的数据库设计,我们都需要关注性能与查询因素。组件越多,越容易遭遇性能瓶颈!
查询模式与优化
先来看一些查询连接表的方式。常见访问模式包括:
优化这些查询的做法:
为连接表中的外键建立索引
使用
GROUP BY或DISTINCT防止重复计数对于读负载较重的场景,考虑覆盖索引
在
WHERE子句中尽量具体,以限制参与连接的数据量。这些技巧是高效连接与聚合的基础。还要记住,如果您打算用连接表来桥接两张表,务必考虑如何高效连接三张表。
批量操作与并发
连接表常见高写入量。使用批量插入与更新可降低事务开销。
然而,对热门外键的高竞争可能造成锁竞争瓶颈。请务必监控性能,并对表进行分区以实现并行化。
规范化 vs 反规范化
我们来简单比较一下规范化与反规范化在数据库设计中的取向差异:
务必认真评估访问模式、团队经验与运维约束。
反规范化的权衡
在不经常变化的写入密集系统中,反规范化可以提升性能。代价是复杂性增加、维护负担加重、以及数据陈旧的风险。
我的一点看法:反规范化应仅作为对读负载瓶颈的审慎回应,并且始终要配套定期一致性检查。
跨数据库系统的实现
SQL 与 NoSQL 系统在实现多对多关系时略有差异。
关系型与 NoSQL 架构
关系型数据库如PostgreSQL、MySQL 与 SQL Server,会使用带有外键与复合主键的连接表显式实现多对多关系。同样,云端关系型数据库如Snowflake也遵循类似的设计模式。
NoSQL 系统通常通过嵌入相关 ID 的数组或由应用逻辑管理的引用来表示多对多关系。这是因为 NoSQL 数据库优先考虑读性能与水平扩展能力。此举提升读性能与模式灵活性,但牺牲了规范化。
特性
关系型(SQL)
NoSQL
实现方式
连接表:使用第三张表,包含外键与复合主键。
嵌入或引用:使用 ID 数组或嵌套文档。
主要目标
规范化:确保数据一致性并消除冗余。
性能:优先读速与水平扩展。
灵活性
刚性模式:需要预定义结构并通过连接取数。
高灵活性:允许无模式设计与多样数据类型。
权衡
复杂连接:数据集显著增长时可能变慢。
牺牲规范化:可能导致数据重复或“陈旧”数据。
示例
PostgreSQL、MySQL、SQL Server、Snowflake。
MongoDB、DynamoDB、Cassandra。
SQL vs NoSQL
当您需要一个定义完善的模式结构时,更推荐使用关系型数据库。这类数据库更便于操作,且有助于更好的数据管理。考虑在以下情形优先选择关系型 SQL 数据库:
当灵活性与批量可操作性优先时,NoSQL 数据库更合适。比如,MongoDB 等 NoSQL 数据库在需要对大量文档执行更新时,支持使用如
updateMany之类的操作符。以下是考虑使用 NoSQL 实现的一些指导原则:结语
在现实的数据模型中,多对多关系不可避免。正确设计它们对数据完整性、可扩展性与分析准确性至关重要。经过恰当规范化与索引优化的连接表,为从事务系统到企业级分析的各类场景提供了稳健基础。
任何设计都涉及权衡:规范化与性能、简洁与灵活、抽象与控制。关键在于剖析您的访问模式,选择与工作负载契合的模式,并通过模式评审与查询测试验证设计。
对于希望深化数据库设计技能的从业者,我强烈推荐报名我们的SQL 助理数据分析师职业路径。