如果您刚开始接触数据库,可能还没有经历过杂乱、冗余数据带来的混乱,或是超慢查询的挫败感。但请相信我,在不同初创公司工作五年、接触过各种数据库结构之后,我可以告诉您,这些问题出现的频率远比您想象的要高。
数据库规范化是解决这些问题的最佳方法之一,而一切都始于第一范式(1NF)。1NF 是一个简单却强大的概念,通过在表中强制原子性,帮助构建高效、可靠且易维护的数据库。它也是其他规范化形式(如 2NF 和 3NF)的基础步骤。
在本文中,我将带您全面了解 1NF:它是什么、如何在实践中应用以及为什么重要。无论您是数据库设计新手,还是想要提升技能,这份指南都将帮助您优化表结构,并为后续的规范化步骤打下坚实基础。
数据库规范化的历史演进
数据库最初的发展阶段,与我们今天所说的“规范化”相去甚远。早期的数据库系统常依赖平面文件或层次结构,导致数据管理与检索异常繁琐。这些设计有明显局限,如数据冗余、不一致和缺乏灵活性。以第一范式为起点的数据库规范化演进,正是为应对这些挑战,彻底革新了我们存储与管理数据的方式。
1NF 的起源
第一范式的概念由被誉为关系型数据库之父的 Edgar F. Codd 提出。20 世纪 70 年代,Codd 提出了关系模型,作为当时占主导地位的层次与网络模型的替代方案。他的动机很明确:建立一种系统化的数据组织方法,以减少冗余、消除异常,并提升数据操作效率。
该模型的核心是 1NF,它确立了基础规则:数据库表中的每个单元格必须只包含一个单一、原子的值,且应消除重复分组。这一原则解决了早期系统中的常见问题,如更新不一致,以及对嵌套或分组数据查询的困难。Codd 关于规范化的工作不仅解决了当下问题,也为更高级的数据库结构与操作铺平了道路。
从早期数据库到现代系统
1NF 的采用标志着数据库发展史上的一个转折点。它将数据组织为具有清晰关系的表格这一过程正规化,为如今占据主流的基于 SQL 的系统奠定了基础。
在 1NF 之前,诸如 IBM 的 Information Management System(IMS)等系统依赖层次结构,需要采用严格的树状设计。这类系统难以适应数据或业务需求的变化。随着 1NF 与关系模型的引入,数据库变得更加灵活,能够在表之间建立动态关系,并实现更好的可扩展性。
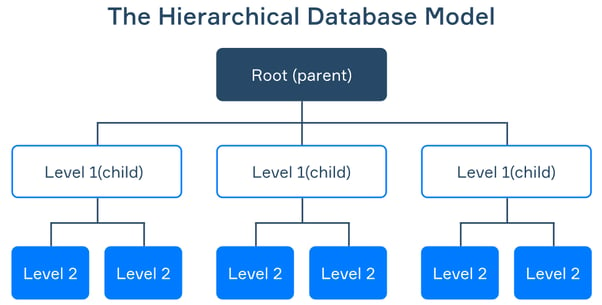
来源:Airbyte
现代关系型数据库管理系统(RDBMS),如 MySQL、PostgreSQL 和 Microsoft SQL Server,都将其设计原则归功于 1NF 的基础理念。这些系统使开发者能够在良好结构的数据上工作,从而更轻松地执行复杂的查询、更新与集成。
行业采纳
1NF(以及数据库规范化整体)的实际收益很快在各行业获得认可。以银行业为例,1NF 通过确保数据以一致、可查询的格式存储,帮助管理客户记录与交易历史。零售商利用 1NF 跟踪库存、销售和客户订单。库存管理系统也是 1NF 大显身手的领域之一。通过将数据结构化为原子、非重复的形式,制造商可以准确维护部件、库存水平与供应链流转的记录。
实现第一范式的条件
实现 1NF 需要满足四个关键条件:
- 行唯一性:每一行都必须唯一,具有唯一标识符。通常通过主键实现,以确保没有重复行。
- 无排序假设:行的存储或检索顺序不应影响数据库设计。
- 原子性:每一列必须包含原子(不可再分)的值。也就是说,单个列中不能出现集合、数组或列表。
- 无重复列:不应存在重复列(即不应有两个列存储相同类型的信息)。
前两个条件在多数现代数据库中通常由设计自带约束,因此本文将重点关注后两个条件:原子性与唯一列。
分解表以实现 1NF 的步骤
要分解违反 1NF 的表,有一套简单可循的步骤。
步骤 1:识别非原子值与重复分组
首先定位那些在单个单元格中存储多个值的列,或者——为避免此类情况而出现的——重复列。这些违规通常表现为:
- 列表或数组(例如,将多个电话号码放在一个列中,用逗号分隔)。
- 嵌套表或内嵌在单个单元格内的结构。
- 多个列表示相同类型的数据(例如三个名为PhoneNumber1、PhoneNumber2、PhoneNumber3)。
步骤 2:将值拆分为新行
接下来,我们需要重构表,使每个单元格只包含一个值,并确保每个列只表示一种数据类型。这通常包括:
- 在必要时复制行,以确保保留所有数据组合。
- 创建新行,甚至新表,以更合理地组织数据。
步骤 3:确保一致性
重构完成后,检查您的表是否满足以下 1NF 要求。如果不确定,可以问自己:“是否无需额外处理就能轻松对数据进行排序、筛选或查询?”“每一列是否仅表示一种属性、每一行是否仅代表一个唯一记录?”如果这两个问题的答案都是肯定的,那么该表已符合 1NF。
第一范式的实践示例
现在我们已经了解了将表转换为 1NF 的步骤,来看两个实用示例。
示例 1:客户订单表
设想一个客户订单表如下:
| CustomerID | Name | Product1 | Product2 | OrderDate |
|---|
| 1 | Alice | Apples | Bananas | 2025-01-10 |
| 2 | Bob | Oranges | Grapes | 2025-01-11 |
问题在哪?
该表违反了 1NF,因为它包含多个列,Product1 和 Product2,它们指向相同类型的数据(产品)。
那该如何修复?要达到 1NF,将数据拆分为独立的行,使每个单元格仅包含一个值:
| CustomerID | Name | Product | OrderDate |
|---|
| 1 | Alice | Apples | 2025-01-10 |
| 1 | Alice | Bananas | 2025-01-10 |
| 2 | Bob | Oranges | 2025-01-11 |
| 2 | Bob | Grapes | 2025-01-11 |
为什么这很重要?
在这个第一范式示例中,我们消除了歧义,使查询和分析数据更简单。现在要找出所有订购香蕉的客户,变得非常容易!
示例 2:学生成绩表
来看一个学生成绩表,如下所示:
| StudentID | Name | Grades |
|---|
| 101 | Sarah | A, B, C |
| 102 | Michael | B, A, A |
问题在哪?
该Grades 列违反 1NF,因为它在单个单元格中存储了多个成绩,而非使用原子值。
那该如何修复?为符合 1NF,我们需要为每个成绩创建单独的行:
| StudentID | Name | Grade |
|---|
| 101 | Sarah | A |
| 101 | Sarah | B |
| 101 | Sarah | C |
| 102 | Michael | B |
| 102 | Michael | A |
| 102 | Michael | A |
为什么这很重要?
将成绩拆分为原子值,有助于改进数据组织,更便于计算平均分、识别优秀学生或分析成绩分布。
如果您想亲自动手创建自己的数据库,可以看看我们的 PostgresQL 课程。如果您已有一定基础,可以尝试这门 Introduction to Data Modeling in Snowflake,涵盖实体-关系与维度建模等理念。
第一范式的优缺点
来看一下它的利与弊:
1NF 的优势
采用 1NF 带来一些关键好处,使数据库工作更加轻松高效。
通过强制原子值,它消除了诸如在一行中出现 "Apples, Bananas"、在另一行中出现 "Apples;Bananas" 这类混乱、拼接数据的可能性。这种一致性让数据更整洁,也更易读、易查、易更新。
1NF 也使数据操作更加直接。使用原子值,您可以更轻松地搜索、筛选和更新数据而不易出错。例如,当每个产品都在自己的行中时,搜索 "Apples" 的查询会更快、更精准,而不是将多个产品堆在同一列里。在执行更新时,它也降低了不一致的风险,因为更改仅限于特定的行。
1NF 的局限
1NF 并非完美无缺。将重复列转换为独立行,或将多值单元格拆分为单独的行,可能会导致表的行数增加。更多行意味着需要处理更多数据,这可能会影响查询性能。
需要注意的是,1NF 本身并非终点,因为它并不能处理所有形式的冗余。诸如部分依赖或传递依赖等问题,需要在更高的范式中(如第二范式与第三范式)加以解决。因此,虽然 1NF 是坚实的基础,但它只是数据库规范化的第一步,本身并不能将数据库结构完全优化。
超越第一范式:迈向第二范式(2NF)
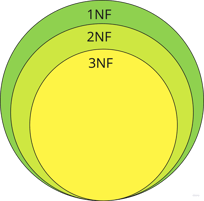
数据库规范化的前几种范式。来源:作者
当您确认数据库已达到第一范式后,下一步的合乎逻辑的方向就是迈向第二范式。2NF 在 1NF 的基础上,解决一个关键问题:部分依赖。
在 2NF 中,目标是消除部分依赖,即当一个非主属性(不属于主键的属性)仅依赖于复合主键的部分时所发生的情况。这在具有复合键(由多个列组成的键)的表中尤为重要。听起来也许有些抽象,但我写过这篇第二范式指南,将概念分解并提供实用示例。您很快就能掌握!
结论
第一范式是数据库规范化的第一步,确保每一列包含原子值,并消除重复列。
由于它为更高级的规范化形式(如 2NF 和 3NF)奠定基础,如果您计划构建高效、可扩展且易维护、能够轻松处理复杂查询与大型数据集的数据库,那么极有可能需要采用 1NF!
如果您准备进一步提升技能,可探索我们的 Database Design 课程,加深对规范化技术及其实践应用的理解。您还可以通过我们的 SQL Associate Certification 验证您的 SQL 与数据库管理技能,向潜在雇主展示您的专业能力!


如果您刚开始接触数据库,可能还没有经历过杂乱、冗余数据带来的混乱,或是超慢查询的挫败感。但请相信我,在不同初创公司工作五年、接触过各种数据库结构之后,我可以告诉您,这些问题出现的频率远比您想象的要高。
数据库规范化是解决这些问题的最佳方法之一,而一切都始于第一范式(1NF)。1NF 是一个简单却强大的概念,通过在表中强制原子性,帮助构建高效、可靠且易维护的数据库。它也是其他规范化形式(如 2NF 和 3NF)的基础步骤。
在本文中,我将带您全面了解 1NF:它是什么、如何在实践中应用以及为什么重要。无论您是数据库设计新手,还是想要提升技能,这份指南都将帮助您优化表结构,并为后续的规范化步骤打下坚实基础。
数据库规范化的历史演进
数据库最初的发展阶段,与我们今天所说的“规范化”相去甚远。早期的数据库系统常依赖平面文件或层次结构,导致数据管理与检索异常繁琐。这些设计有明显局限,如数据冗余、不一致和缺乏灵活性。以第一范式为起点的数据库规范化演进,正是为应对这些挑战,彻底革新了我们存储与管理数据的方式。
1NF 的起源
第一范式的概念由被誉为关系型数据库之父的 Edgar F. Codd 提出。20 世纪 70 年代,Codd 提出了关系模型,作为当时占主导地位的层次与网络模型的替代方案。他的动机很明确:建立一种系统化的数据组织方法,以减少冗余、消除异常,并提升数据操作效率。
该模型的核心是 1NF,它确立了基础规则:数据库表中的每个单元格必须只包含一个单一、原子的值,且应消除重复分组。这一原则解决了早期系统中的常见问题,如更新不一致,以及对嵌套或分组数据查询的困难。Codd 关于规范化的工作不仅解决了当下问题,也为更高级的数据库结构与操作铺平了道路。
从早期数据库到现代系统
1NF 的采用标志着数据库发展史上的一个转折点。它将数据组织为具有清晰关系的表格这一过程正规化,为如今占据主流的基于 SQL 的系统奠定了基础。
在 1NF 之前,诸如 IBM 的 Information Management System(IMS)等系统依赖层次结构,需要采用严格的树状设计。这类系统难以适应数据或业务需求的变化。随着 1NF 与关系模型的引入,数据库变得更加灵活,能够在表之间建立动态关系,并实现更好的可扩展性。
来源:Airbyte
现代关系型数据库管理系统(RDBMS),如 MySQL、PostgreSQL 和 Microsoft SQL Server,都将其设计原则归功于 1NF 的基础理念。这些系统使开发者能够在良好结构的数据上工作,从而更轻松地执行复杂的查询、更新与集成。
行业采纳
1NF(以及数据库规范化整体)的实际收益很快在各行业获得认可。以银行业为例,1NF 通过确保数据以一致、可查询的格式存储,帮助管理客户记录与交易历史。零售商利用 1NF 跟踪库存、销售和客户订单。库存管理系统也是 1NF 大显身手的领域之一。通过将数据结构化为原子、非重复的形式,制造商可以准确维护部件、库存水平与供应链流转的记录。
实现第一范式的条件
实现 1NF 需要满足四个关键条件:
前两个条件在多数现代数据库中通常由设计自带约束,因此本文将重点关注后两个条件:原子性与唯一列。
分解表以实现 1NF 的步骤
要分解违反 1NF 的表,有一套简单可循的步骤。
步骤 1:识别非原子值与重复分组
首先定位那些在单个单元格中存储多个值的列,或者——为避免此类情况而出现的——重复列。这些违规通常表现为:
步骤 2:将值拆分为新行
接下来,我们需要重构表,使每个单元格只包含一个值,并确保每个列只表示一种数据类型。这通常包括:
步骤 3:确保一致性
重构完成后,检查您的表是否满足以下 1NF 要求。如果不确定,可以问自己:“是否无需额外处理就能轻松对数据进行排序、筛选或查询?”“每一列是否仅表示一种属性、每一行是否仅代表一个唯一记录?”如果这两个问题的答案都是肯定的,那么该表已符合 1NF。
第一范式的实践示例
现在我们已经了解了将表转换为 1NF 的步骤,来看两个实用示例。
示例 1:客户订单表
设想一个客户订单表如下:
问题在哪?
该表违反了 1NF,因为它包含多个列,Product1 和 Product2,它们指向相同类型的数据(产品)。
那该如何修复?要达到 1NF,将数据拆分为独立的行,使每个单元格仅包含一个值:
为什么这很重要?
在这个第一范式示例中,我们消除了歧义,使查询和分析数据更简单。现在要找出所有订购香蕉的客户,变得非常容易!
示例 2:学生成绩表
来看一个学生成绩表,如下所示:
问题在哪?
该Grades 列违反 1NF,因为它在单个单元格中存储了多个成绩,而非使用原子值。
那该如何修复?为符合 1NF,我们需要为每个成绩创建单独的行:
为什么这很重要?
将成绩拆分为原子值,有助于改进数据组织,更便于计算平均分、识别优秀学生或分析成绩分布。
如果您想亲自动手创建自己的数据库,可以看看我们的 PostgresQL 课程。如果您已有一定基础,可以尝试这门 Introduction to Data Modeling in Snowflake,涵盖实体-关系与维度建模等理念。
第一范式的优缺点
来看一下它的利与弊:
1NF 的优势
采用 1NF 带来一些关键好处,使数据库工作更加轻松高效。
通过强制原子值,它消除了诸如在一行中出现 "Apples, Bananas"、在另一行中出现 "Apples;Bananas" 这类混乱、拼接数据的可能性。这种一致性让数据更整洁,也更易读、易查、易更新。
1NF 也使数据操作更加直接。使用原子值,您可以更轻松地搜索、筛选和更新数据而不易出错。例如,当每个产品都在自己的行中时,搜索 "Apples" 的查询会更快、更精准,而不是将多个产品堆在同一列里。在执行更新时,它也降低了不一致的风险,因为更改仅限于特定的行。
1NF 的局限
1NF 并非完美无缺。将重复列转换为独立行,或将多值单元格拆分为单独的行,可能会导致表的行数增加。更多行意味着需要处理更多数据,这可能会影响查询性能。
需要注意的是,1NF 本身并非终点,因为它并不能处理所有形式的冗余。诸如部分依赖或传递依赖等问题,需要在更高的范式中(如第二范式与第三范式)加以解决。因此,虽然 1NF 是坚实的基础,但它只是数据库规范化的第一步,本身并不能将数据库结构完全优化。
超越第一范式:迈向第二范式(2NF)
数据库规范化的前几种范式。来源:作者
当您确认数据库已达到第一范式后,下一步的合乎逻辑的方向就是迈向第二范式。2NF 在 1NF 的基础上,解决一个关键问题:部分依赖。
在 2NF 中,目标是消除部分依赖,即当一个非主属性(不属于主键的属性)仅依赖于复合主键的部分时所发生的情况。这在具有复合键(由多个列组成的键)的表中尤为重要。听起来也许有些抽象,但我写过这篇第二范式指南,将概念分解并提供实用示例。您很快就能掌握!
结论
第一范式是数据库规范化的第一步,确保每一列包含原子值,并消除重复列。
由于它为更高级的规范化形式(如 2NF 和 3NF)奠定基础,如果您计划构建高效、可扩展且易维护、能够轻松处理复杂查询与大型数据集的数据库,那么极有可能需要采用 1NF!
如果您准备进一步提升技能,可探索我们的 Database Design 课程,加深对规范化技术及其实践应用的理解。您还可以通过我们的 SQL Associate Certification 验证您的 SQL 与数据库管理技能,向潜在雇主展示您的专业能力!