कोर्स
इंटरमीडिएट SQL
4 घंटा
526.4K
इस सन्दर्भ में, नॉर्मलाइज़ेशन डेटाबेस (रिलेशनल डेटाबेस) के भीतर डेटा को व्यवस्थित करने की प्रक्रिया है, ताकि दोहराव जैसी डेटा विसंगतियाँ समाप्त हों।
सरल शब्दों में, यह एक बड़े, जटिल टेबल को छोटे और सरल टेबल्स में तोड़ना है, जबकि डेटा संबंध बनाए रखे जाते हैं।
नॉर्मलाइज़ेशन का उपयोग प्रायः बड़े डेटा सेट्स के साथ काम करते समय किया जाता है।
आइए संक्षेप में कुछ ऐसे परिदृश्यों पर नज़र डालते हैं जहाँ नॉर्मलाइज़ेशन अक्सर उपयोगी होता है।
कल्पना कीजिए एक डेटाबेस जिसकी टेबल में ग्राहक जानकारी है। बिना नॉर्मलाइज़ेशन के, यदि कोई ग्राहक अपनी उम्र बदलता है, तो हमें इसे कई जगह अपडेट करना पड़ेगा, जिससे असंगतियों का जोखिम बढ़ेगा। डेटा को नॉर्मलाइज़ करके, हम अलग-अलग टेबल बना सकते हैं, जिन्हें एक यूनिक आइडेंटिफ़ायर से जोड़ा जाता है, ताकि डेटा सटीक और सुसंगत बना रहे।
मान लें एक जटिल डेटाबेस है जिसमें कई संबद्ध टेबल्स हैं और उनमें अनावश्यक दोहराव है। ऐसे में जॉइन वाली क्वेरीज़ अधिक जटिल और संसाधन-गहन हो जाती हैं। नॉर्मलाइज़ेशन डेटा को छोटे-छोटे टेबल्स में विभाजित करके क्वेरी करना सरल बनाता है—प्रत्येक टेबल में केवल प्रासंगिक जानकारी रहती है, जिससे जटिल जॉइन की आवश्यकता घटती है।
दोहराए गए डेटा की एक बड़ी समस्या यह है कि वह अनावश्यक स्टोरेज घेरता है। उदाहरण के लिए, हर ऑर्डर रिकॉर्ड में समान उत्पाद विवरण रखने से डुप्लिकेशन होता है। नॉर्मलाइज़ेशन से आप डेटा को अलग-अलग टेबल्स में बाँटकर दोहराव समाप्त कर सकते हैं।
नॉर्मलाइज़ेशन डेटाबेस डिज़ाइन में अहम भूमिका निभाता है। इसके आवश्यक होने के कुछ कारण यह हैं:
यदि कोई टेबल सही तरह नॉर्मलाइज़ नहीं है और उसमें डेटा दोहराव है, तो वह न केवल अतिरिक्त स्टोरेज लेगा बल्कि डेटाबेस को संभालना और अपडेट करना भी कठिन बना देगा।
नॉर्मलाइज़ेशन की आवश्यकता कई कारकों से उत्पन्न होती है—ऊपर बताए गए डेटा दोहराव से लेकर रिलेशनशिप प्रबंधन की कठिनाइयों तक। आइए सीधे मुद्दों पर आते हैं:
अब तक हमने देखा कि SQL में नॉर्मलाइज़ेशन क्या है, यह क्यों महत्वपूर्ण है, और इसकी ज़रूरत किन कारणों से पड़ती है। डेटाबेस नॉर्मलाइज़ेशन अलग-अलग रूपों में आता है, जिनमें डेटा संगठन का स्तर क्रमशः बढ़ता है।
इस खंड में हम अलग-अलग नॉर्मलाइज़ेशन स्तरों पर संक्षेप में चर्चा करेंगे और फिर अगले खंड में उन्हें विस्तार से समझेंगे।
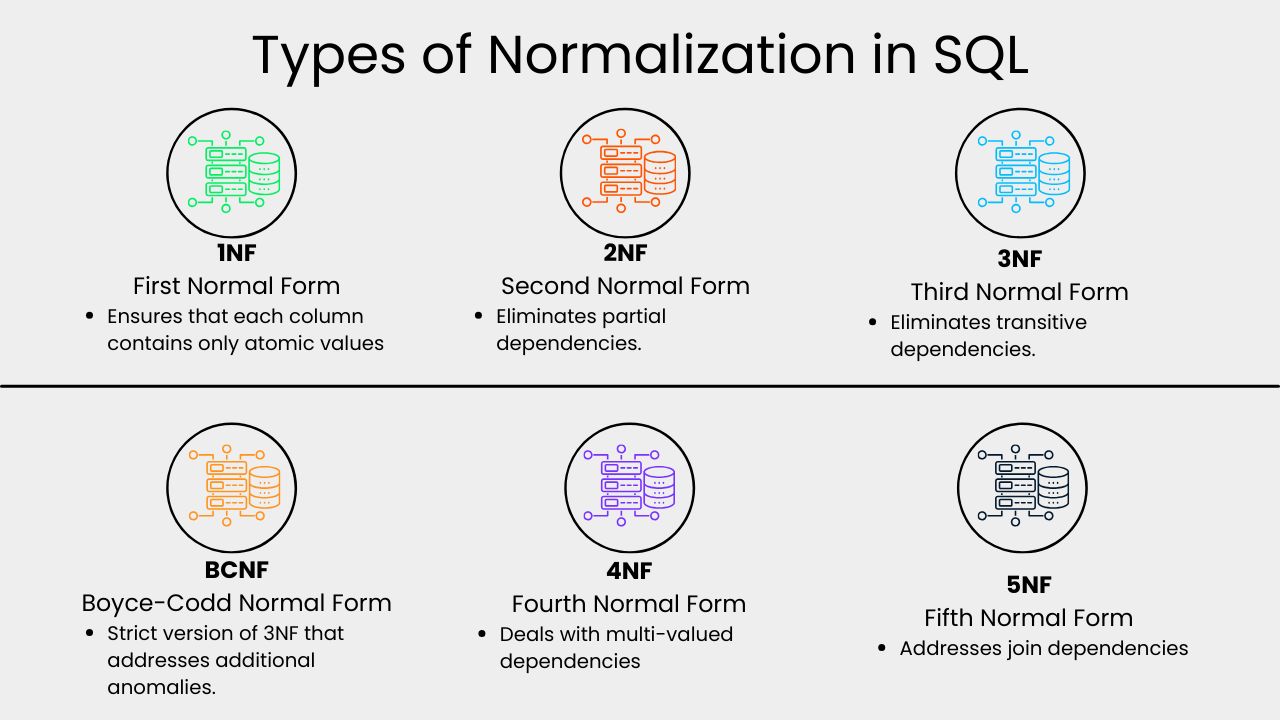
छवि: लेखक द्वारा
| नॉर्मल फॉर्म | आवश्यकता | क्या हटाता है |
|---|---|---|
| 1NF | हर सेल में एटॉमिक मान; पंक्तियाँ अद्वितीय | दोहराए गए समूह और मल्टी-वैल्यूड सेल्स |
| 2NF | कंपोज़िट की पर आंशिक निर्भरता नहीं | आंशिक की संबंधों से उत्पन्न दोहराव |
| 3NF | ट्रांज़िटिव निर्भरता नहीं | नॉन-की कॉलमों के बीच अप्रत्यक्ष निर्भरताएँ |
| BCNF | हर डिटरमिनेंट एक कैंडिडेट की है | 3NF से छूट गई विसंगतियाँ |
| 4NF | मल्टी-वैल्यूड निर्भरता नहीं | स्वतंत्र मल्टी-वैल्यूड विशेषताएँ |
| 5NF | जॉइन निर्भरता नहीं | लॉसी टेबल डीकंपोज़िशन से उत्पन्न दोहराव |
यह स्तर सुनिश्चित करता है कि आपके डेटा के हर कॉलम में केवल एटॉमिक मान हों। यहाँ एटॉमिक का अर्थ है कि कॉलम की हर एंट्री अविभाज्य हो। मानो स्प्रेडशीट के हर सेल में सिर्फ एक ही जानकारी होनी चाहिए। 1NF डेटा की एटॉमिकिटी सुनिश्चित करता है—हर सेल में एक मान हो और हर कॉलम का नाम अद्वितीय हो।
आंशिक निर्भरताएँ हटाता है, यह सुनिश्चित करके कि नॉन-की एट्रिब्यूट्स केवल प्राइमरी की पर निर्भर हों। मतलब यह कि हर कॉलम का सीधा संबंध प्राइमरी की से हो, न कि अन्य कॉलमों से।
ट्रांज़िटिव निर्भरताएँ हटाता है, यह सुनिश्चित करके कि नॉन-की एट्रिब्यूट्स केवल प्राइमरी की पर निर्भर हों। यह स्तर 2NF पर आधारित है।
यह 3NF का अधिक कड़ा रूप है जो अतिरिक्त विसंगतियों को संबोधित करता है। इस स्तर पर हर डिटरमिनेंट एक कैंडिडेट की होता है।
यह स्तर BCNF पर आधारित है और मल्टी-वैल्यूड निर्भरताओं से निपटता है।
5NF सबसे उच्च स्तर है, जो जॉइन निर्भरताओं को संबोधित करता है। इसे विशेष परिदृश्यों में दोहराव को और घटाने के लिए टेबल्स को और छोटे भागों में बाँटने हेतु प्रयोग किया जाता है।
हमने सभी नॉर्मलाइज़ेशन स्तरों को रेखांकित कर लिया है। अब उदाहरणों और व्याख्याओं के साथ इन्हें गहराई से देखते हैं।
1NF सुनिश्चित करता है कि हर कॉलम सेल में केवल एटॉमिक मान हों। एक लाइब्रेरी डेटाबेस की कल्पना कीजिए, जिसमें किताब की जानकारी (title, author, genre, और borrowed_by) की टेबल है। यदि टेबल नॉर्मलाइज़ नहीं है, तो borrowed_by में कॉमा से अलग किए गए कई उधारकर्ताओं के नाम हो सकते हैं। यह 1NF का उल्लंघन है, क्योंकि एक ही सेल में कई मान हैं। नीचे दी गई टेबल 1NF के उल्लंघन का अच्छा उदाहरण है।
title | author | genre | borrowed_by |
To Kill a Mockingbird | Harper Lee | Fiction | John Doe, Jane Doe, James Brown |
The Lord of the Rings | J. R. R. Tolkien | Fantasy | Emily Garcia, David Lee |
Harry Potter and the Sorcerer’s Stone | J.K. Rowling | Fantasy | Michael Chen |
1NF में, हम उधारकर्ताओं के लिए एक अलग टेबल बनाते हैं और उन्हें किताबों की टेबल से जोड़ते हैं। ये टेबल्स या तो उधारकर्ताओं की टेबल में फॉरेन की से या एक अलग लिंकिंग टेबल से जोड़े जा सकते हैं। उधारकर्ताओं की टेबल में फॉरेन की जोड़ने के तरीके में, हम borrowers टेबल में एक फॉरेन की कॉलम जोड़ते हैं जो books टेबल के प्राइमरी की को संदर्भित करता है। यह तालिकाओं के बीच संबंध लागू करता है और डेटा सुसंगतता सुनिश्चित करता है।
इसका निरूपण आप नीचे देख सकते हैं:
इन नॉर्मलाइज़्ड टेबल्स को बनाने के लिए SQL यह है:
CREATE TABLE books (
    book_id INT PRIMARY KEY,
    title VARCHAR(255),
    author VARCHAR(100),
    genre VARCHAR(50)
);

CREATE TABLE borrowers (
    borrower_id INT PRIMARY KEY,
    name VARCHAR(100),
    book_id INT,
    FOREIGN KEY (book_id) REFERENCES books(book_id)
);
Books टेबल
book_id (PK) | title | author | genre |
1 | To Kill a Mockingbird | Harper Lee | Fiction |
2 | The Lord of the Rings | J. R. R. Tolkien | Fantasy |
3 | Harry Potter and the Sorcerer’s Stone | J.K. Rowling | Fantasy |
Borrowers टेबल
borrower_id (PK) | name | book_id (FK) |
1 | John Doe | 1 |
2 | Jane Doe | 1 |
3 | James Brown | 1 |
4 | Emily Garcia | 2 |
5 | David Lee | 2 |
6 | Michael Chen | 3 |
जैसा कि वर्णित है, यह स्तर 1NF पर आधारित है और सुनिश्चित करता है कि प्राइमरी की पर कोई आंशिक निर्भरता न हो। सरल शब्दों में, सभी नॉन-की एट्रिब्यूट्स पूरे प्राइमरी की पर निर्भर हों, केवल किसी हिस्से पर नहीं।
1NF लागू करने से हमारे पास पहले से दो अलग टेबल हैं (आप 1NF अनुभाग देख सकते हैं)।
अब मान लें हम उधार रिकॉर्ड करने के लिए इन टेबल्स को जोड़ना चाहते हैं। शुरुआती तरीका यह हो सकता है कि books टेबल में borrower_id कॉलम जोड़ दिया जाए, जैसा नीचे दिखाया गया है:
book_id (PK) | title | author | genre | borrower_id (FK) |
1 | To Kill a Mockingbird | Harper Lee | Fiction | 1 |
2 | The Lord of the Rings | J. R. R. Tolkien | Fantasy | NULL |
3 | Harry Potter and the Sorcerer’s Stone | J.K. Rowling | Fantasy | 6 |
यह समाधान जैसा दिखता है, लेकिन यह 2NF का उल्लंघन है क्योंकि borrower_id केवल book_id पर आंशिक रूप से निर्भर है। एक किताब के कई उधारकर्ता हो सकते हैं, पर इस संरचना में एक borrower_id केवल एक ही किताब से जुड़ सकता है—यही आंशिक निर्भरता है।
हमें books और borrowers के बीच many-to-many संबंध स्थापित करना होगा, ताकि 2NF सुनिश्चित हो। यह एक अलग टेबल बनाकर किया जा सकता है:
Book_borrowings टेबल
| borrowing_id (PK) | book_id (FK) | borrower_id (FK) | borrowed_date |
|---|---|---|---|
| 1 | 1 | 1 | 2024-05-04 |
| 2 | 2 | 4 | 2024-05-04 |
| 3 | 3 | 6 | 2024-05-04 |
यह टेबल books और borrowers के बीच स्पष्ट संबंध स्थापित करती है। book_id और borrower_id अपने-अपने टेबल्स के प्राइमरी की को संदर्भित करते हुए फॉरेन की का कार्य करते हैं। यह तरीका सुनिश्चित करता है कि borrower_id पूरे प्राइमरी की (book_id) पर निर्भर हो, और 2NF का पालन हो।
3NF 2NF पर आधारित है और ट्रांज़िटिव निर्भरताएँ हटाता है। ट्रांज़िटिव निर्भरता तब होती है जब कोई नॉन-की एट्रिब्यूट किसी अन्य नॉन-की एट्रिब्यूट पर निर्भर हो, जो स्वयं प्राइमरी की पर निर्भर हो। यह ट्रांज़िटिव लॉ पर आधारित है।
2NF लागू करने के बाद, हमारी लाइब्रेरी में तीन टेबल हैं:
Books टेबल
book_id (PK) | title | author | genre |
1 | To Kill a Mockingbird | Harper Lee | Fiction |
2 | The Lord of the Rings | J. R. R. Tolkien | Fantasy |
3 | Harry Potter and the Sorcerer’s Stone | J.K. Rowling | Fantasy |
Borrowers टेबल
borrower_id (PK) | name | book_id (FK) |
1 | John Doe | 1 |
2 | Jane Doe | 1 |
3 | James Brown | 1 |
4 | Emily Garcia | 2 |
5 | David Lee | 2 |
6 | Michael Chen | 3 |
Book_borrowings टेबल
borrowing_id (PK) | book_id (FK) | borrower_id (FK) | borrowed_date |
1 | 1 | 1 | 2024-05-04 |
2 | 2 | 4 | 2024-05-04 |
3 | 3 | 6 | 2024-05-04 |
2NF संरचना प्रभावी दिखती है, पर एक छिपी निर्भरता हो सकती है। मान लें हम books टेबल में due_date कॉलम जोड़ते हैं। यह दिखने में तार्किक लगेगा, पर इससे ट्रांज़िटिव निर्भरता बनेगी, जहाँ:
अर्थात due_date सीधे प्राइमरी की (book_id) पर नहीं, बल्कि एक मध्यवर्ती नॉन-की एट्रिब्यूट (borrowing_id) पर निर्भर होगा—यह 3NF का उल्लंघन है।
हम due_date कॉलम को उपयुक्त टेबल में ले जा सकते हैं—book_borrowings टेबल को due_date और returned_date कॉलम्स के साथ अपडेट करके।
अपडेटेड टेबल नीचे है:
borrowing_id (PK) | book_id (FK) | borrower_id (FK) | borrowed_date | due_date |
1 | 1 | 1 | 2024-05-04 | 2024-05-20 |
2 | 2 | 4 | 2024-05-04 | 2024-05-18 |
3 | 3 | 6 | 2024-05-04 | 2024-05-10 |
due_date कॉलम को book_borrowings में रखने से ट्रांज़िटिव निर्भरता समाप्त हो गई।
अब due_date सीधे book_id और borrower_id के संयुक्त संबंध पर निर्भर है। इस सन्दर्भ में book_id और borrower_id एक कंपोज़िट फॉरेन की की तरह काम कर रहे हैं, जो मिलकर book_borrowings टेबल की प्राइमरी की बनाते हैं।
BCNF फंक्शनल डिपेंडेंसीज़ पर आधारित है और रिलेशन में सभी कैंडिडेट कीज़ को ध्यान में रखता है।
फंक्शनल डिपेंडेंसीज (FD) रिलेशनल डेटाबेस में एट्रिब्यूट्स के बीच संबंधों को परिभाषित करती हैं। कोई FD बताती है कि एक कॉलम का मान किसी संबंधित दूसरे कॉलम के मान को निर्धारित करता है। नॉर्मलाइज़ेशन की प्रक्रिया में FD बेहद महत्वपूर्ण हैं क्योंकि वे निर्भरताएँ पहचानती हैं और सुनिश्चित करती हैं कि डेटा तालिकाओं में समुचित रूप से वितरित हो।
BCNF, 3NF का सख्त रूप है। यह सुनिश्चित करता है कि टेबल में हर डिटरमिनेंट (ऐट्रिब्यूट्स का वह सेट जो एक पंक्ति को अद्वितीय रूप से पहचानता है) एक कैंडिडेट की हो (ऐट्रिब्यूट्स का न्यूनतम सेट जो एक पंक्ति को अद्वितीय रूप से पहचानता है)। आशय यह कि हर डिटरमिनेंट प्राइमरी की के रूप में काम कर सके।
यह सुनिश्चित करता है कि हर फंक्शनल डिपेंडेंसी (FD) का डिटरमिनेंट एक सुपरकी हो। दूसरे शब्दों में, यदि X —> Y (X, Y को निर्धारित करता है) सत्य है, तो X उस रिलेशन का कैंडिडेट की (सुपरकी) होना चाहिए। ध्यान दें कि X और Y डेटा टेबल के कॉलम हैं।
3NF से आगे बढ़ते हुए, हमारे पास तीन टेबल हैं:
Books टेबल
book_id (PK) | title | author | genre |
1 | To Kill a Mockingbird | Harper Lee | Fiction |
2 | The Lord of the Rings | J. R. R. Tolkien | Fantasy |
3 | Harry Potter and the Sorcerer’s Stone | J.K. Rowling | Fantasy |
Borrowers टेबल
borrower_id (PK) | name | book_id (FK) |
1 | John Doe | 1 |
2 | Jane Doe | 1 |
3 | James Brown | 1 |
4 | Emily Garcia | 2 |
5 | David Lee | 2 |
6 | Michael Chen | 3 |
Book_borrowings टेबल
borrowing_id (PK) | book_id (FK) | borrower_id (FK) | borrowed_date | due_date |
1 | 1 | 1 | 2024-05-04 | 2024-05-20 |
2 | 2 | 4 | 2024-05-04 | 2024-05-18 |
3 | 3 | 6 | 2024-05-04 | 2024-05-10 |
3NF संरचना अच्छी है, पर book_borrowings टेबल में एक छिपा डिटरमिनेंट हो सकता है। यदि मान लें कि एक उधारकर्ता एक ही समय में वही किताब दोबारा नहीं ले सकता, तो book_id और borrower_id का संयोजन मिलकर एक उधारी रिकॉर्ड को अद्वितीय रूप से पहचानता है।
यह संरचना BCNF का उल्लंघन करती है क्योंकि यह संयुक्त सेट (book_id और borrower_id) टेबल की प्राइमरी की नहीं है (जो केवल borrowing_id है)।
BCNF प्राप्त करने के लिए, हम या तो book_borrowings टेबल को दो अलग टेबल्स में विभाजित कर सकते हैं या संयुक्त एट्रिब्यूट सेट को प्राइमरी की बना सकते हैं।
अंततः, इन विकल्पों में चुनाव आपके डेटा की ज़रूरतों और आप उधारी संबंधों को कैसे मॉडल करना चाहते हैं, इस पर निर्भर करेगा।
4NF मल्टी-वैल्यूड निर्भरताओं से निपटता है। ऐसी निर्भरता तब होती है जब एक एट्रिब्यूट के साथ कई आश्रित एट्रिब्यूट्स जुड़े हों, और ये आश्रित एट्रिब्यूट्स प्राइमरी की से स्वतंत्र हों। यह काफ़ी जटिल है, पर हम इसे एक उदाहरण से गहराई से समझेंगे।
अब तक इस्तेमाल किया गया लाइब्रेरी उदाहरण इस स्तर पर उपयुक्त नहीं है। 4NF आमतौर पर उन स्थितियों पर लागू होता है जहाँ एक एट्रिब्यूट के अनेक आश्रित एट्रिब्यूट्स हो सकते हैं जो सीधे प्राइमरी की से संबंधित नहीं हैं।
एक और परिदृश्य लें। मान लें कि एक डेटाबेस प्रकाशनों की जानकारी संग्रहीत करता है। हम “Publications” टेबल पर विचार करेंगे, जिसमें title, author, publication_year, और keywords कॉलम हैं।
publication_id (PK) | title | author | publication_year | keywords |
1 | To Kill a Mockingbird | Harper Lee | 1960 | Coming-of-Age, Legal |
2 | The Lord of the Rings | J. R. R. Tolkien | 1954 | Fantasy, Epic, Adventure |
3 | Pride and Prejudice | Jane Austen | 1813 | Romance, Social Commentary |
ऊपर दी गई संरचना 4NF का उल्लंघन करती है क्योंकि:
हम एक अलग टेबल बना सकते हैं।
Publication_keywords टेबल
publication_id (FK) | keyword |
1 | Coming-of-Age |
1 | Legal |
2 | Fantasy |
2 | Epic |
2 | Adventure |
3 | Romance |
3 | Social Commentary |
नई बनाई गई टेबल (Publication_keywords) प्रकाशन और कीवर्ड्स के बीच एक many-to-many संबंध स्थापित करती है। हर प्रकाशन के कई कीवर्ड्स हो सकते हैं, जो publication_id (फॉरेन की) के माध्यम से जुड़े हैं, और प्रत्येक कीवर्ड कई प्रकाशनों से संबद्ध हो सकता है।
इसके साथ, हमने मल्टी-वैल्यूड निर्भरता सफलतापूर्वक समाप्त कर दी और 4NF प्राप्त कर लिया।
5NF नॉर्मलाइज़ेशन का सबसे जटिल रूप है जो जॉइन निर्भरताओं को हटाता है। यह वह स्थिति है जब किसी विशेष क्वेरी का उत्तर देने के लिए कई टेबल्स को जॉइन करना पड़ता है, भले ही वे टेबल्स पहले से 4NF में हों।
सरल शब्दों में, 5NF सुनिश्चित करता है कि टेबल्स को साथ जोड़ने पर कोई अतिरिक्त जानकारी निष्कर्षित न की जा सके जो अलग-अलग टेबल्स में पहले से उपलब्ध न हो।
जब टेबल्स पहले से 3NF या 4NF में हों, तो जॉइन निर्भरताएँ कम ही होती हैं—इसीलिए 5NF का सीधा, स्पष्ट उदाहरण बनाना कठिन है।
फिर भी, एक ऐसा परिदृश्य देखें जहाँ 5NF प्रासंगिक हो सकता है:
मान लें एक विश्वविद्यालय डेटाबेस है जिसमें “Courses” और “Enrollments” के नॉर्मलाइज़्ड टेबल्स हैं।
Courses टेबल
course_id (PK) | course_name | department |
101 | Introduction to Programming | Computer Science |
202 | Data Structures and Algorithms | Computer Science |
301 | Web Development I | Computer Science |
401 | Artificial Intelligence | Computer Science |
Enrollments टेबल
enrollment_id (PK) | student_id (FK) | course_id (FK) | grade |
1 | 12345 | 101 | A |
2 | 12345 | 202 | B |
3 | 56789 | 301 | A- |
4 | 56789 | 401 | B+ |
मान लें कि ये टेबल्स पहले से 3NF या 4NF में हैं, तब भी डेटा कैसे संग्रहीत है इस पर निर्भर करते हुए जॉइन निर्भरता हो सकती है। उदाहरण के लिए, किसी कोर्स का प्रीरेक्विज़िट “Courses” टेबल में “prerequisite_course_id” कॉलम के रूप में संग्रहीत है।
यह पहली नज़र में कुशल लग सकता है। पर मान लें एक क्वेरी चाहिए जो छात्र के एनरोल्ड कोर्सेज़ और उनके प्रीरेक्विज़िट्स निकाले। तब आपको “Courses” और “Enrollments” टेबल्स को जॉइन करना होगा, और फिर प्रीरेक्विज़िट जानकारी लाने के लिए संभवतः “Courses” टेबल को फिर से जॉइन करना पड़ेगा।
जॉइन निर्भरता को संभावित रूप से समाप्त कर 5NF पाने के लिए, हम एक अलग “Course Prerequisites” टेबल जोड़ सकते हैं:
Course_prerequisite टेबल
course_id (FK) | prerequisite_course_id (FK) |
202 | 101 |
301 | NULL |
401 | 202 |
यह तरीका प्रीरेक्विज़िट जानकारी को अलग कर देता है और “Enrollments” तथा “Course_prerequisites” टेबल्स के बीच एक एकल जॉइन के साथ एनरोल्ड कोर्सेज़ और उनके प्रीरेक्विज़िट्स को कुशलता से निकालने देता है।
नोट: यहाँ हमने मान लिया है कि किसी कोर्स के लिए छात्र का केवल एक ही प्रीरेक्विज़िट हो सकता है।
5NF बहुत जटिल और दुर्लभ है, इसलिए डेटा सीखना शुरू करने वालों के लिए इसका अनुप्रयोग कम दिखेगा। फिर भी, यह अतिरिक्त ज्ञान है और जटिल डेटाबेस मिलने पर आपको तैयार रखेगा।
जहाँ नॉर्मलाइज़ेशन दोहराव कम करता है और डेटा अखंडता बढ़ाता है, वहीं कुछ मामलों में डी-नॉर्मलाइज़ेशन बेहतर विकल्प होता है। डी-नॉर्मलाइज़ेशन जानबूझकर दोहराव लाता है, ताकि खास वर्कलोड्स में रीड प्रदर्शन सुधरे।
| मापदंड | नॉर्मलाइज़ेशन | डी-नॉर्मलाइज़ेशन |
|---|---|---|
| उद्देश्य | दोहराव और विसंगतियाँ घटाना | रीड/क्वेरी प्रदर्शन सुधारना |
| उपयुक्त | OLTP सिस्टम (ट्रांज़ैक्शन्स) | OLAP सिस्टम (एनालिटिक्स, रिपोर्टिंग) |
| राइट स्पीड | तेज़ (एक ही जगह अपडेट) | धीमी (कई जगह अपडेट) |
| रीड स्पीड | कभी-कभी धीमी (अधिक जॉइन आवश्यक) | तेज़ (कम जॉइन आवश्यक) |
| डेटा अखंडता | उच्च | कम (असंगति का जोखिम) |
| स्टोरेज | कम (डुप्लिकेट डेटा नहीं) | अधिक (जानबूझकर डुप्लिकेट डेटा) |
व्यवहार में, अधिकांश प्रोडक्शन डेटाबेस दोनों तरीकों का संयोजन अपनाते हैं। एक पूर्णत: नॉर्मलाइज़्ड स्कीमा से शुरू करें, फिर जहाँ क्वेरी प्रदर्शन की ज़रूरत हो वहाँ चुनिंदा डी-नॉर्मलाइज़ करें।
यदि आप यहाँ तक पढ़ चुके हैं, तो बधाई। हमने SQL में नॉर्मलाइज़ेशन क्या है, यह क्यों महत्वपूर्ण है, इसकी आवश्यकता किन कारणों से पड़ती है, और डेटाबेस नॉर्मलाइज़ेशन के विभिन्न प्रकार—इन सबका अन्वेषण किया। अलग-अलग प्रकारों को समझाने के लिए उपयोग किए गए परिदृश्य इसीलिए चुने गए ताकि आप पूरी तरह समझ सकें और अपने सीखने के सफ़र में इस ज्ञान को लागू कर सकें।
नॉर्मलाइज़ेशन किसी भी डेटा-संबंधित करियर पथ की शुरुआत करने वालों के लिए एक बुनियादी कौशल है। इन सिद्धांतों को समझकर आप कुशल और सुव्यवस्थित डेटाबेस बनाने के लिए तैयार हैं।
डेटा क्षेत्र में सीखना बेहद आवश्यक है, और अपनी SQL कौशल को निखारने के लिए हमारे पास आपके लिए कुछ संसाधन हैं।
आज ही अपनी SQL यात्रा जारी रखें!
कोर्स
कोर्स
कोर्स