对数据进行排序是数据从业者日常工作中最常见的操作之一。很多时候,我们需要按特定顺序展示数据,才能提炼出有意义的信息。幸运的是,如今我们不必手动完成这项任务。计算机可以以不可匹敌的性能为我们完成“魔法”。
有多种策略可以对数据进行排序。在本教程中,我们将分析最有效的排序技术之一。“归并排序”算法采用分治策略来对未排序的数组进行排序:它先将数组拆分为更小的数组,随后再按正确顺序将它们合并。
接下来几节中,我们将讨论归并排序算法的全部细节、其在 Python 中的样子,以及一些顺利实现的实用技巧。
什么是归并排序?
市面上有很多排序算法,但要找到性能优于归并排序的并不容易。毫不意外,这种算法被广泛应用于各种真实场景,比如对大型数据库进行排序或在普通计算机上整理文件。
该算法基于分治范式,可分为三部分:
- 分解(Divide):将问题划分为更小的子问题。
- 解决(Conquer):递归地求解各个子问题。
- 合并(Combine):将子问题的解组合起来,得到最终解。
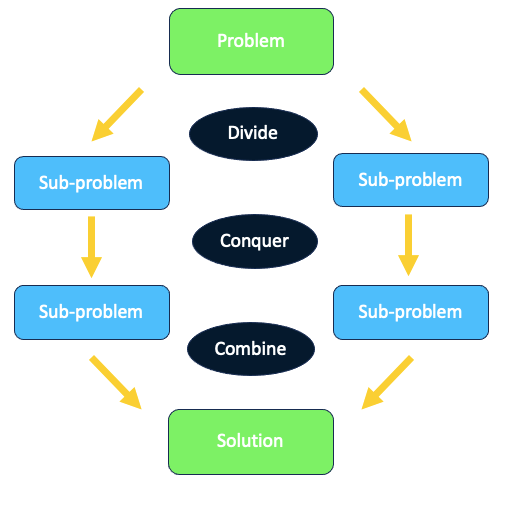
分治策略
我们来看看归并排序是如何工作的。假设我们要用归并排序算法对下面这些数字进行排序。该算法会把数据递归地分成两部分,并持续分割,直到每个列表只有一个元素。然后,我们再将它们按顺序合并到另一个列表中。
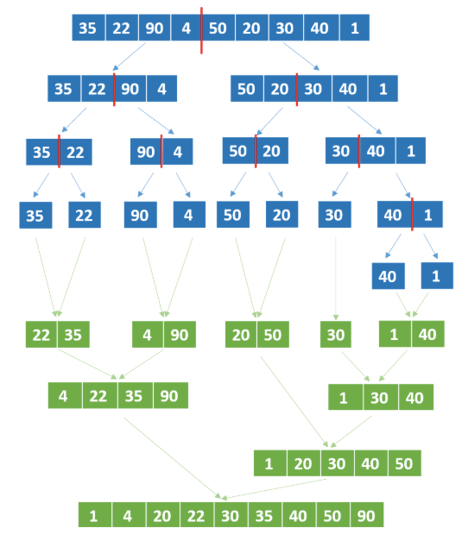
归并排序问题。来源:DataCamp
归并排序的时间与空间复杂度
我们无法预先知道针对某个特定问题表现最好的排序算法是什么。除了算法本身,还需要考虑多种变量,包括用于编写代码的编程语言、执行所依赖的硬件,以及待排序数据的具体特性。
虽然我们无法预测某个排序算法的精确运行时间,但仍可以通过分析时间和空间复杂度来比较不同排序算法的性能。
归并排序的时间复杂度
正如我们在大 O 表示法与时间复杂度的指南中所解释的,时间复杂度分析的目标不是预测算法的确切运行时间,而是通过分析随着输入数据量增长,其运行时间如何变化,来评估算法的效率。
时间复杂度使用大 O 表示法书写,这是一种描述函数增长或下降速率的数学记号。归并排序的时间复杂度是对数线性(线性对数)级别,记为 O(N log(N)),其中 N 为列表中元素的数量。字母“O”代表增长的“数量级”。
在时间复杂度分析中,线性对数复杂度的表现与线性复杂度近似相似,意味着执行时间将与数据量近似成正比。因此,如果数据量加倍,算法处理数据所需的时间也应加倍,即分割与合并的次数会加倍。
由于归并排序的时间复杂度近似线性,其在最佳、平均和最差情况下的复杂度相同。也就是说,无论输入顺序如何,算法完成所需的步骤数基本一致。
归并排序的空间复杂度
最后,除了完成任务所需的时间之外,在分析算法复杂度时,另一个重要方面是估计随着问题规模增大,算法完成所需的内存量。
这涉及空间复杂度与辅助空间的概念。辅助空间指算法使用的额外或临时空间,而空间复杂度则指相对于输入规模,算法占用的总空间。换言之,空间复杂度同时包含辅助空间与输入本身占用的空间。
归并排序的空间复杂度为 O(N)。这是因为它在合并输入数组已排序的两半时,会使用大小为 N 的辅助数组。该辅助数组用于存储合并后的结果,输入数组会被排序结果覆盖。
Python 中的归并排序实现
让我们在 Python 中实现归并排序算法。实现该算法的方式有多种;不过,我们将采用基于递归的实现。这种方式可以说最易理解,且比基于迭代的替代方案所需代码更少。
理解归并排序中的递归
如果您对此还不熟悉,在编程中,递归是指函数调用其自身。您可以查看我们的Python 递归函数详解教程,全面了解这些强大的函数。
要实现归并排序,我们首先定义基例:如果列表只有一个元素,它已经是有序的,因此我们直接返回。否则,就把列表分成两半,left_half 和 right_half,并对它们各自递归调用 merge_sort()。这一过程会持续,直到所有子列表都只包含一个元素。
当我们得到这些已排序的子列表后,开始执行合并过程。为此,我们初始化三个索引变量:i 用于跟踪 left_half 中的位置,j 用于跟踪 right_half,k 用于最终的合并列表。随后比较两边的元素。如果 left_half 中当前元素更小,就把它放到 my_list[k],并将 i 前移;否则,从 right_half 取元素,放入 my_list[k],并递增 j。每次比较后,将 k 前移到最终列表中的下一个位置。
该过程会持续,直到其中一边的所有元素都比较完毕。如果 left_half 或 right_half 中还有剩余元素,就直接将它们追加到最终列表,确保不遗漏任何数据。由于归并排序是递归操作,这个合并过程会在递归的每一层执行,直到整个列表完成排序。
Python 实现
下面的代码使用前面图示中的未排序列表作为示例:
def merge_sort(my_list):
    if len(my_list) > 1:
        mid = len(my_list)//2
        left_half = my_list[:mid]
        right_half = my_list[mid:]

        merge_sort(left_half)
        merge_sort(right_half)

        i = j = k = 0

        while i < len(left_half) and j < len(right_half):
            if left_half[i] < right_half[j]:
                my_list[k] = left_half[i]
                i += 1
            else:
                my_list[k] = right_half[j]
                j += 1
            k += 1

        while i < len(left_half):
            my_list[k] = left_half[i]
            i += 1
            k += 1

        while j < len(right_half):
            my_list[k] = right_half[j]
            j += 1
            k += 1

my_list = [35,22,90,4,50,20,30,40,1]
merge_sort(my_list)
print(my_list)
>>> [1, 4, 20, 22, 30, 35, 40, 50, 90]技术支持
归并排序与其他排序算法的比较
归并排序是相当快速的排序算法,尤其适用于大型数据库,且常被用作其他算法的基准。然而,对于较短的列表,它的性能往往不如其他排序算法。
在下表中,您可以看到归并排序与其他常见排序算法的对比。
| |
Merge Sort
|
Quick Sort
|
Buble Sort
|
Insertion Sort
|
|
Sorting Strategy
|
Divide and Conquer
|
Divide and Conquer
|
Repeatedly swapping the adjacent elements if they are in the wrong order.
|
Builds the final sorted list one item at a time by comparisons.
|
|
Partition strategy
|
Partition in 2 halves
|
Based on the position of the pivot element
|
Doesn’t require partitions
|
Doesn’t require partitions
|
|
Worst-case time complexity
|
O(N log N)
|
O(N^2)
|
O(N^2)
|
O(N^2)
|
|
Performance
|
Good for any kind of database, but better on bigger ones
|
Good for small databases
|
Good for small datasets
|
Fine for a small and nearly sorted list. Not as efficient as other sorting algorithms
|
|
Stability
|
Stable
|
Not stable
|
Stable
|
Stable
|
|
Space required
|
Require memory for temporary sorted-subarrays
|
Doesn’t require additional memory
|
Doesn’t require additional memory
|
Doesn't require additional memory
|
归并排序的实际应用
归并排序在对大型列表进行排序时具有很高的性能,但在处理较小列表时效率会下降。同样地,在输入列表已经具有一定有序性的场景中,它的效率也往往较低,因为无论列表顺序如何,归并排序都会执行相同的步骤。
一个归并排序特别适用的优秀用例是链表。链表是一种数据结构,由线性相连的节点构成。每个节点包含数据以及与下一个节点相连的链接。
归并排序之所以适合链表,是因为它只需要顺序访问数据,这与链表的特性高度契合。此外,归并排序是稳定的排序算法(即在排序输出中保留相等元素的相对顺序),这对于维护链表的顺序非常重要。
常见错误与故障排查
归并排序算法相当直接,代码的改进空间有限。不过,您可以根据输入数据的大小来提高排序策略的灵活性与复杂度。
我们已经指出,归并排序更适用于较大的数据集。对于较小的数据集,时间复杂度为 O(N^2) 的其他排序算法(如插入排序)可能表现更好。在这种情况下,您只需设定一个大小阈值:当低于该阈值时,选择插入排序而非归并排序。
除此之外,一个值得探索的思路是并行化。只要具备相应的计算能力,归并排序的各个步骤都很容易并行化,从而缩短完成时间。阅读我们的CPU 与 GPU 指南,了解更多关于并行计算的内容。
总结
归并排序是最有效、最流行的排序算法之一,但在精彩且不断扩展的算法世界中,还有很多值得学习的内容。如果您对算法的技术细节、其工作原理以及相关的复杂度、优缺点感兴趣,以下 DataCamp 资源可助您继续学习:


对数据进行排序是数据从业者日常工作中最常见的操作之一。很多时候,我们需要按特定顺序展示数据,才能提炼出有意义的信息。幸运的是,如今我们不必手动完成这项任务。计算机可以以不可匹敌的性能为我们完成“魔法”。
有多种策略可以对数据进行排序。在本教程中,我们将分析最有效的排序技术之一。“归并排序”算法采用分治策略来对未排序的数组进行排序:它先将数组拆分为更小的数组,随后再按正确顺序将它们合并。
接下来几节中,我们将讨论归并排序算法的全部细节、其在 Python 中的样子,以及一些顺利实现的实用技巧。
什么是归并排序?
市面上有很多排序算法,但要找到性能优于归并排序的并不容易。毫不意外,这种算法被广泛应用于各种真实场景,比如对大型数据库进行排序或在普通计算机上整理文件。
该算法基于分治范式,可分为三部分:
分治策略
我们来看看归并排序是如何工作的。假设我们要用归并排序算法对下面这些数字进行排序。该算法会把数据递归地分成两部分,并持续分割,直到每个列表只有一个元素。然后,我们再将它们按顺序合并到另一个列表中。
归并排序问题。来源:DataCamp
归并排序的时间与空间复杂度
我们无法预先知道针对某个特定问题表现最好的排序算法是什么。除了算法本身,还需要考虑多种变量,包括用于编写代码的编程语言、执行所依赖的硬件,以及待排序数据的具体特性。
虽然我们无法预测某个排序算法的精确运行时间,但仍可以通过分析时间和空间复杂度来比较不同排序算法的性能。
归并排序的时间复杂度
正如我们在大 O 表示法与时间复杂度的指南中所解释的,时间复杂度分析的目标不是预测算法的确切运行时间,而是通过分析随着输入数据量增长,其运行时间如何变化,来评估算法的效率。
时间复杂度使用大 O 表示法书写,这是一种描述函数增长或下降速率的数学记号。归并排序的时间复杂度是对数线性(线性对数)级别,记为 O(N log(N)),其中 N 为列表中元素的数量。字母“O”代表增长的“数量级”。
在时间复杂度分析中,线性对数复杂度的表现与线性复杂度近似相似,意味着执行时间将与数据量近似成正比。因此,如果数据量加倍,算法处理数据所需的时间也应加倍,即分割与合并的次数会加倍。
由于归并排序的时间复杂度近似线性,其在最佳、平均和最差情况下的复杂度相同。也就是说,无论输入顺序如何,算法完成所需的步骤数基本一致。
归并排序的空间复杂度
最后,除了完成任务所需的时间之外,在分析算法复杂度时,另一个重要方面是估计随着问题规模增大,算法完成所需的内存量。
这涉及空间复杂度与辅助空间的概念。辅助空间指算法使用的额外或临时空间,而空间复杂度则指相对于输入规模,算法占用的总空间。换言之,空间复杂度同时包含辅助空间与输入本身占用的空间。
归并排序的空间复杂度为 O(N)。这是因为它在合并输入数组已排序的两半时,会使用大小为 N 的辅助数组。该辅助数组用于存储合并后的结果,输入数组会被排序结果覆盖。
Python 中的归并排序实现
让我们在 Python 中实现归并排序算法。实现该算法的方式有多种;不过,我们将采用基于递归的实现。这种方式可以说最易理解,且比基于迭代的替代方案所需代码更少。
理解归并排序中的递归
如果您对此还不熟悉,在编程中,递归是指函数调用其自身。您可以查看我们的Python 递归函数详解教程,全面了解这些强大的函数。
要实现归并排序,我们首先定义基例:如果列表只有一个元素,它已经是有序的,因此我们直接返回。否则,就把列表分成两半,
left_half和right_half,并对它们各自递归调用merge_sort()。这一过程会持续,直到所有子列表都只包含一个元素。当我们得到这些已排序的子列表后,开始执行合并过程。为此,我们初始化三个索引变量:
i用于跟踪left_half中的位置,j用于跟踪right_half,k用于最终的合并列表。随后比较两边的元素。如果left_half中当前元素更小,就把它放到my_list[k],并将i前移;否则,从right_half取元素,放入my_list[k],并递增j。每次比较后,将 k 前移到最终列表中的下一个位置。该过程会持续,直到其中一边的所有元素都比较完毕。如果
left_half或right_half中还有剩余元素,就直接将它们追加到最终列表,确保不遗漏任何数据。由于归并排序是递归操作,这个合并过程会在递归的每一层执行,直到整个列表完成排序。Python 实现
下面的代码使用前面图示中的未排序列表作为示例:
归并排序与其他排序算法的比较
归并排序是相当快速的排序算法,尤其适用于大型数据库,且常被用作其他算法的基准。然而,对于较短的列表,它的性能往往不如其他排序算法。
在下表中,您可以看到归并排序与其他常见排序算法的对比。
Merge Sort
Quick Sort
Buble Sort
Insertion Sort
Sorting Strategy
Divide and Conquer
Divide and Conquer
Repeatedly swapping the adjacent elements if they are in the wrong order.
Builds the final sorted list one item at a time by comparisons.
Partition strategy
Partition in 2 halves
Based on the position of the pivot element
Doesn’t require partitions
Doesn’t require partitions
Worst-case time complexity
O(N log N)
O(N^2)
O(N^2)
O(N^2)
Performance
Good for any kind of database, but better on bigger ones
Good for small databases
Good for small datasets
Fine for a small and nearly sorted list. Not as efficient as other sorting algorithms
Stability
Stable
Not stable
Stable
Stable
Space required
Require memory for temporary sorted-subarrays
Doesn’t require additional memory
Doesn’t require additional memory
Doesn't require additional memory
归并排序的实际应用
归并排序在对大型列表进行排序时具有很高的性能,但在处理较小列表时效率会下降。同样地,在输入列表已经具有一定有序性的场景中,它的效率也往往较低,因为无论列表顺序如何,归并排序都会执行相同的步骤。
一个归并排序特别适用的优秀用例是链表。链表是一种数据结构,由线性相连的节点构成。每个节点包含数据以及与下一个节点相连的链接。
归并排序之所以适合链表,是因为它只需要顺序访问数据,这与链表的特性高度契合。此外,归并排序是稳定的排序算法(即在排序输出中保留相等元素的相对顺序),这对于维护链表的顺序非常重要。
常见错误与故障排查
归并排序算法相当直接,代码的改进空间有限。不过,您可以根据输入数据的大小来提高排序策略的灵活性与复杂度。
我们已经指出,归并排序更适用于较大的数据集。对于较小的数据集,时间复杂度为 O(N^2) 的其他排序算法(如插入排序)可能表现更好。在这种情况下,您只需设定一个大小阈值:当低于该阈值时,选择插入排序而非归并排序。
除此之外,一个值得探索的思路是并行化。只要具备相应的计算能力,归并排序的各个步骤都很容易并行化,从而缩短完成时间。阅读我们的CPU 与 GPU 指南,了解更多关于并行计算的内容。
总结
归并排序是最有效、最流行的排序算法之一,但在精彩且不断扩展的算法世界中,还有很多值得学习的内容。如果您对算法的技术细节、其工作原理以及相关的复杂度、优缺点感兴趣,以下 DataCamp 资源可助您继续学习: