时间复杂度分析提供了一种方法,可以独立于实现语言和执行硬件,对算法的效率进行分析与预估。
时间复杂度分析的目标并不是精确预测算法的实际运行时间,而是帮助我们回答以下问题:
- 针对解决同一问题的两个算法,在提供相同规模的数据时,哪个预期更快?
- 如果将输入数据量加倍,执行时间会如何变化?会线性增长并且同样加倍吗?会保持不变吗?还是会有其他增长方式?
读完本文,您将能够分析算法的时间复杂度,并回答以上问题。
在 2024 年,时间复杂度仍然重要吗?
计算机越来越快,因此有人会疑惑是否还有必要关心时间复杂度。如今的超级计算机难道不是什么问题都能解决,而与算法优劣无关吗?
并非如此。近年来硬件性能的巨大飞跃确实推动了 AI 的繁荣。然而,即便在最先进的硬件上,如果采用低效算法,简单问题也可能导致灾难性的性能表现。
例如,设想用一个朴素算法对一张拥有一千万条记录的数据库表进行排序。即便在现代计算机上,这样一个简单操作也可能需要几天才能完成,使数据库在实际应用中几乎不可用。相反,如果使用高效算法,预期耗时可能不到 0.1 秒。
基本操作与基本指令
我们使用随机存取机器(RAM 或 RA-machine)模型来分析算法。该模型假设以下操作均在一个时间步内完成:
- 算术运算
- 逻辑运算(<、>、== 等)
- 诸如
if 或 return 的语句
- 访问内存位置,如读取或写入变量值
这些操作称为基本操作。一行执行常数数量基本操作的代码称为基本指令。
由于基本指令中的操作数是常数,不依赖于数据量。既然我们关心的是随着数据量增长,执行时间如何增长,那么就可以专注于统计算法执行了多少条基本指令。
函数调用以及 for 和 while 等循环,通过将其内部基本指令的数量相加来评估。请看下面用于对列表元素求和的代码。
def sum_list(lst):
total = 0
for value in lst:
total += value
return total 技术支持
我们在每行加了注释,帮助可视化基本指令的数量。若 N 是 lst 的长度,则基本指令总数为 1 + N + 1 = N + 2。
大 O 记号
设想我们有两个排序算法。我们分别计算了它们的基本指令数量,得到如下表达式:
|
第一个算法
|
第二个算法
|
|
4N2 + 2N + 7
|
3N2 + 5N + 13
|
乍看之下,很难判断哪个扩展性更好。大 O 记号提供了一种进一步简化这些表达式的方法,规则如下:
- 丢弃低次项
- 去掉乘法常数
对两个表达式应用该过程,都得到 N2:
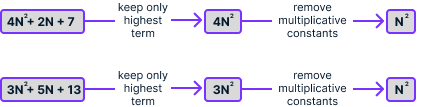
简化后得到的表达式就是算法的时间复杂度,用 O() 表示。在此例中,可以写作 4N2 + 2N + 7 = O(N2) 与 3N2 + 5N + 13 = O(N2)。这意味着这两个算法的时间复杂度相同,均与列表元素个数的平方成正比。
上文我们计算出 sum_list 算法执行了 N + 2 次操作,其中 N 为列表长度。按相同规则简化,得到 N,因此 sum_list 的时间复杂度是 O(N)。
这意味着执行时间与列表大小成正比。这也符合直觉:在求和时,将列表元素个数加倍,应需要双倍的工作量,不多也不少。
大 O 记号:直观解释
我们之所以可以忽略低次项,是因为当 N 增大时,与最高次项相比,它们对总和的影响可以忽略不计。下图展示了三项 4N2、2N 和 7 各自对总和的贡献。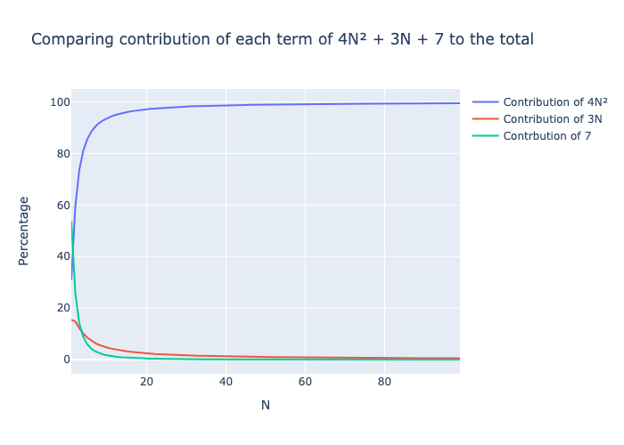
二次项 4N2 很快就几乎贡献了 100% 的操作数,即使在很小的 N 上也是如此。因此,在处理大规模数据时,低阶项所需时间相较高阶项可忽略不计。
我们去掉乘法常数,是因为该值与数据量无关。
大 O 记号:数学定义
上述步骤足以应对大多数实际需求,从而准确推导算法的时间复杂度。我们统计算法执行的基本指令数,得到某个表达式 f(N)。经两步简化后,得到简化表达式 g(N)。于是可写作 f(N) = O(g(N)),读作“f 是 g 的大 O”。
然而,这并不是严格的数学定义,某些情况下并不充分。
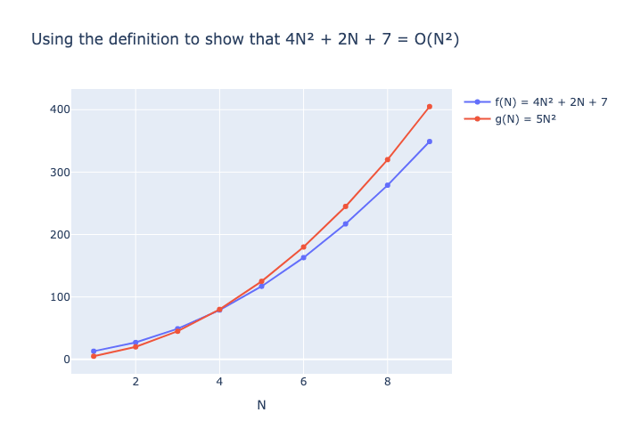
数学上的定义是:若存在常数 C,使得当 N 充分大时,下式成立,则正函数 f(N) = O(g(N)):
f(N) ≤ C × g(N)
我们可用该定义说明 f(N) = 4N2 + 2N + 7 = O(N2)。此时取 C = 5,可见对任意 N > 4,f(N) ≤ 5 × N2:
在实践中,我们通常按上述简化规则使用即可。
时间复杂度的类型
理解了大 O 记号的基础后,我们来看看常见的时间复杂度及其影响,从最高效的常数时间开始。
常数时间:O(1)
顾名思义,常数时间算法的时间复杂度是常数,其性能不随数据量变化。这类算法通常只涉及固定数量输入的计算,例如计算两点间的距离。
两点间的距离可通过计算两点 x、y 坐标差的平方和的平方根得到。
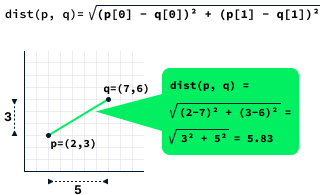
下面的 dist 函数计算两点间的距离。它由三条基本指令组成,是一个常数。因此其时间复杂度为 O(1)。
def dist(p, q):
dx = (p[0] - q[0]) ** 2
dy = (p[1] - q[1]) ** 2
return (dx + dy) ** 0.5 技术支持
有趣的是,即使处理大型数据集,函数也可能表现出常数时间复杂度。例如使用 len 函数计算列表长度。该操作是 O(1),因为其实现会在内部维护列表大小,而无需每次请求长度时都逐一计数。
线性时间:O(N)
我们之前讨论过 sum_list 作为线性时间函数的例子。一般而言,线性时间算法需要逐个检查每个数据点的任务。计算最小值、最大值或平均值属于此类典型操作。
让我们练习分析以下用于计算列表最小值的函数:
def minimum(lst):
min_value = lst[0]
for i in range(1, len(lst)):
min_value = min(min_value, lst[i])
return min_value 技术支持
若列表有 N 个元素,则复杂度为 1 + (N - 1) + 1 = N + 1 = O(N)。
线性时间算法的执行时间与数据量成正比。因此,如果数据量加倍,算法处理数据所需时间也应加倍。
对数时间:O(log(N))
猜数字游戏要求在 1 到 N 之间猜一个隐藏的数字,目标是在尽可能少的次数内猜中。每次猜测后,我们会得到反馈:隐藏数字比猜测值大、比猜测值小,或正好相等。若猜中即获胜,否则继续。
一种有效策略是每次都猜中点。假设 N = 15。第一次猜 8。若秘密数字小于 8,则范围缩小到 1 到 7;若更大,则在 9 到 15 之间。我们不断对剩余范围取中点,直到找到正确答案。下图展示了该策略可能的路径。
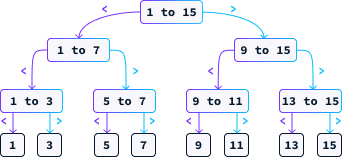
我们来分析这种方法的时间复杂度。与之前的例子不同,该算法的步数并不只取决于输入规模 N,因为有可能第一次就猜中。
分析此类算法时,我们关注最坏情况。例如 N = 15 时,在最坏情况下我们需要 4 次猜测。每次取中点都会排除剩余可能性的一半。最坏情况下,我们会一直猜到只剩一个可能为止。因此,我们需要回答的问题是:
N 需要被 2 除以多少次才能得到 1?
答案是以 2 为底的对数 log2(N)。用于定位正确数字的算法称为二分查找。由于最多需要 log2(N) 次猜测,我们可将其复杂度表示为 O(log2(N)),或简写为 O(log(N)),因为常数在时间复杂度表示中无关紧要。
由于增长极其缓慢,对数时间复杂度在实践中非常受青睐,几乎与常数时间相当。即使 N 很大,操作总数仍然相当低。例如,即使 N 达到十亿,所需操作大约也只有 30 次。
二分查找是计算机科学中的基础算法,应用广泛。例如在自然语言处理中,拼写检查与自动更正系统可以利用二分查找的变体高效地定位候选词。
二次时间:O(N2)
排序是计算机经常需要执行的一项基本任务。一种排序 N 个数的方法是反复找出列表中的最小元素。
def selection_sort(lst):
sorted_lst = []
for _ in range(len(lst)):
minimum = min(lst)
lst.remove(minimum)
sorted_lst.append(minimum)
return sorted_lst 技术支持
要分析 for 循环的复杂度,我们先评估循环体内指令的复杂度,再乘以循环执行的次数。
计算列表最小值与从列表移除一个元素都是 O(N) 操作。追加操作为常数时间 O(1)。因此,每次循环的复杂度为 O(N + N + 1) = O(2N + 1),简化为 O(N)。由于共有 N 次循环,总体复杂度为 N × O(N) = O(N2)。selection_sort() 的其余部分由三条简单指令构成,因此整体复杂度为 O(N2 + 3) = O(N2)。
我们对 for 循环的分析做了简化。每次迭代都会从列表中移除一个元素,这意味着并非每次迭代执行的指令数都相同。第一次执行 N 条,第二次 N - 1 条,第三次 N - 2 条,直到最后一次只执行 1 条。
这意味着 for 循环的真实复杂度为:
N + (N - 1) + (N - 2) + … + 1
可以证明该和等于 (N2 + N) / 2。不过,
(N2 + N) / 2 = ½N2 + ½N = O(N2)
即便我们先前略有高估,整体复杂度仍为二次。selection_sort() 由于其 O(N2) 的二次复杂度,属于较慢的排序算法。
二次复杂度的函数扩展性很差,适用于小列表,但对于上百万数据点的排序并不现实,可能需要数天才能完成。将数据量加倍,执行时间会增加到四倍。
对数线性时间:O(N log(N))
我们可以设计 O(N log(N)) 的排序算法。其中一种称为归并排序。我们不展开实现细节,若您想进一步了解,请查看课程中的这篇归并排序快速介绍,课程为Python 数据结构与算法。
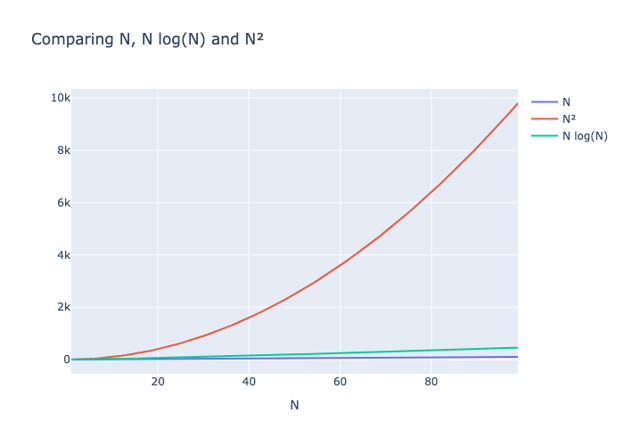
如前所述,对数复杂度在实践中表现近似常数。因此,O(N log(N)) 算法在实际应用中的执行时间,可能与线性时间算法相当。
下图显示 N log(N) 和 N 的增长速率相近,而 N2 增长很快,速度很快会变得很慢。
立方时间:O(N3)
AI 中一个广泛使用的立方时间算法是矩阵乘法,它在大型语言模型(如 GPT)的训练与推理中都发挥关键作用。
要将两个 N×N 矩阵 A 和 B 相乘,需要用 A 的每一行与 B 的每一列相乘。具体地,乘积在 (i, j) 位置的值由 A 的第 i 行与 B 的第 j 列对应元素相乘并求和得到。
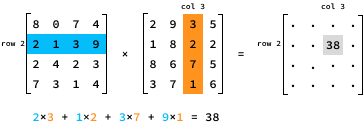
以下是矩阵乘法的 Python 实现:
def matrix_mul(A, B):
n = len(A)
res = [[0 for _ in range(n)] for _ in range(n)]
for i in range(n):
for j in range(n):
for k in range(n):
res[i][j] += A[i][k] * B[k][j]
return res 技术支持
总体而言,matrix_mul() 执行了 N3 + N2 + 2 条指令,因此时间复杂度为 O(N3)。
另一种分析方式是基于计算量来推断。矩阵乘法的结果有 N2 个元素,每个元素的计算需要 O(N) 时间,因此总体复杂度为 N2 × O(N) = O(N3)。
立方时间算法相当缓慢。数据量加倍会使执行时间增加到 8 倍,扩展性很差。即使 N 相对较小,指令数量也会迅速爆炸。
矩阵乘法是一个硬件进步产生显著影响的计算难题。虽然也存在略高效一些的矩阵乘法算法,但主要是 GPU 芯片在设计上针对矩阵乘法进行了优化,这才使得像 GPT 这样的大模型能够在可接受的时间内完成训练。
近来,研究者提出在大型学习模型中消除矩阵乘法——详情可参阅这篇文章:无 MatMul 的大语言模型:关键概念解读。
指数时间复杂度:O(2N) 与 O(N!)
指数时间算法通常出现在通过穷举所有可能解来求解的问题中。设想为一辆需要访问 N 个投递点的送货卡车规划路线。一种方法是评估所有可能的投递顺序。Python 的 itertools 包提供了遍历列表所有排列的简便方法。
import itertools
for order in itertools.permutations([1, 2, 3]):
  print(order)技术支持
(1, 2, 3)
(1, 3, 2)
(2, 1, 3)
(2, 3, 1)
(3, 1, 2)
(3, 2, 1)技术支持
长度为 N 的列表的排列数记为 N!,读作“ N 的阶乘”。阶乘函数呈指数式增长。例如当 N = 13 时,排列数已超过十亿。
若投递点给定为一组二维坐标,我们可以遍历所有可能顺序,并记录最优解,从而找到总距离最短的投递顺序。
def optimize_route(locations):
minimum_distance = float("inf")
best_order = None
for order in itertools.permutations(locations):
distance = 0
for i in range(1, len(order)):
distance += dist(order[i - 1], order[i])
if distance < minimum_distance:
distance = minimum_distance
best_order = order
return best_order 技术支持
外层 for 循环执行 N! 次。因此,optimize_route() 的操作数为 N! × (1 + N - 1 + 2) + 3 = N! × (N + 2) + 3 = N! × N + 2N! + 3。
我们已知在计算时间复杂度时应忽略低次项。但此处出现了 N!,它并非 N 的幂。我们可以将简化策略推广为:丢弃增长更慢的项。下表列出了算法时间复杂度中常见的项,按增长率从低到高排列。
|
1
|
log(N)
|
N
|
N2
|
N3
|
Nk
|
2N
|
N!
|
因此,我们可以将 optimize_route() 的时间复杂度表示为 N! × N + 2N! + 3 = O(N! × N)。
指数时间复杂度的算法通常只适用于非常小的实例。即使只有 13 个地点,排列数也超过十亿,使得该算法在现实中不具可行性。
时间复杂度:最坏情况与最好情况
在猜数字游戏中,我们聚焦最坏情况的复杂度。关注最坏情况可以保证算法执行时间的增长速率。
在最好情况下,我们第一次就猜中,因此最好情况复杂度为 O(1)。这当然是准确的——最好情况下只需一次常数操作。但这并不很有参考价值,因为其发生概率极低。
一般而言,我们分析算法复杂度时都会关注最坏情况,原因在于:
- 性能保障:关注最坏复杂度可确保算法性能不会劣于某个阈值。这对需要可靠性能的应用(如实时系统)至关重要,延迟可能造成严重问题。
- 安全与可靠:最坏情况分析有助于设计健壮算法,能够应对最苛刻情形。即使在最不利的情况下,也能在可接受范围内运行。
- 上界:了解最坏复杂度可给出性能上界,有助于理解算法可能需要的最大资源(时间、内存)。
时间复杂度:实践意义
时间复杂度看似理论化,但在实践中非常有用。
例如,若某个函数始终只处理小数据集,那么一个易于理解的 O(N2) 算法可能比复杂且难维护的 O(N) 算法更合适。但这应是有意识的取舍,避免当用户量上升时措手不及,导致应用无法承载。
时间复杂度分析揭示:微小的代码优化对算法执行时间的影响微乎其微。显著的改进来自从根本上减少为得到结果所需的基本操作数量。通常应优先保持代码清晰易读,而非过度优化以致难以理解。
较慢的部分会主导整体性能。在优化较慢部分之前优化较快部分往往没有意义。举例来说,假设我们有一个函数执行两项任务:
def process_data(data):
  clean_data(data)
  analyze_data(data)技术支持
如果 clean_data() 的复杂度是 O(N2),而 analyze_data() 的复杂度是 O(N3),那么降低 clean_data() 的复杂度并不会改善 process_data() 的整体复杂度。更应将精力放在改进 analyze_data() 上。
此外,时间复杂度还能指导硬件选型。例如,一个 O(N3) 的算法尽管理论上扩展性差,但在数据量有限的任务上,如果运行在更强的硬件或更快的编程语言上,仍可能足够快。反之,若算法时间复杂度为 O(2N) 的指数级,再好的硬件也难以救场,说明必须寻找更高效的算法。
结论
尽管理论上计算机越来越快,我们处理的数据却前所未有地庞大。可以这样理解:每次使用互联网、智能手机或智能家居设备,我们都会产生海量信息。随着这些数据的“高山”不断增高,从中进行整理并找到有价值的内容愈发困难。因此,持续改进我们的工具——尤其是算法——以更好地处理和理解这些信息,显得尤为重要。
时间复杂度分析为推理算法的执行时间提供了一个直观框架。其核心目标是洞察时间复杂度的增长率,而非预测精确运行时间。尽管该模型包含诸多简化与假设,但在实践中极为有用,能够有效捕捉算法执行时间行为的本质。
如果您想继续探索更多计算机科学主题,欢迎阅读我的文章:数据结构:一份含 Python 示例的完整指南。


时间复杂度分析提供了一种方法,可以独立于实现语言和执行硬件,对算法的效率进行分析与预估。
时间复杂度分析的目标并不是精确预测算法的实际运行时间,而是帮助我们回答以下问题:
读完本文,您将能够分析算法的时间复杂度,并回答以上问题。
在 2024 年,时间复杂度仍然重要吗?
计算机越来越快,因此有人会疑惑是否还有必要关心时间复杂度。如今的超级计算机难道不是什么问题都能解决,而与算法优劣无关吗?
并非如此。近年来硬件性能的巨大飞跃确实推动了 AI 的繁荣。然而,即便在最先进的硬件上,如果采用低效算法,简单问题也可能导致灾难性的性能表现。
例如,设想用一个朴素算法对一张拥有一千万条记录的数据库表进行排序。即便在现代计算机上,这样一个简单操作也可能需要几天才能完成,使数据库在实际应用中几乎不可用。相反,如果使用高效算法,预期耗时可能不到 0.1 秒。
基本操作与基本指令
我们使用随机存取机器(RAM 或 RA-machine)模型来分析算法。该模型假设以下操作均在一个时间步内完成:
if或return的语句这些操作称为基本操作。一行执行常数数量基本操作的代码称为基本指令。
由于基本指令中的操作数是常数,不依赖于数据量。既然我们关心的是随着数据量增长,执行时间如何增长,那么就可以专注于统计算法执行了多少条基本指令。
函数调用以及
for和while等循环,通过将其内部基本指令的数量相加来评估。请看下面用于对列表元素求和的代码。我们在每行加了注释,帮助可视化基本指令的数量。若 N 是
lst的长度,则基本指令总数为 1 + N + 1 = N + 2。大 O 记号
设想我们有两个排序算法。我们分别计算了它们的基本指令数量,得到如下表达式:
第一个算法
第二个算法
4N2 + 2N + 7
3N2 + 5N + 13
乍看之下,很难判断哪个扩展性更好。大 O 记号提供了一种进一步简化这些表达式的方法,规则如下:
对两个表达式应用该过程,都得到 N2:
简化后得到的表达式就是算法的时间复杂度,用 O() 表示。在此例中,可以写作 4N2 + 2N + 7 = O(N2) 与 3N2 + 5N + 13 = O(N2)。这意味着这两个算法的时间复杂度相同,均与列表元素个数的平方成正比。
上文我们计算出
sum_list算法执行了 N + 2 次操作,其中 N 为列表长度。按相同规则简化,得到 N,因此sum_list的时间复杂度是 O(N)。这意味着执行时间与列表大小成正比。这也符合直觉:在求和时,将列表元素个数加倍,应需要双倍的工作量,不多也不少。
大 O 记号:直观解释
我们之所以可以忽略低次项,是因为当 N 增大时,与最高次项相比,它们对总和的影响可以忽略不计。下图展示了三项 4N2、2N 和 7 各自对总和的贡献。
二次项 4N2 很快就几乎贡献了 100% 的操作数,即使在很小的 N 上也是如此。因此,在处理大规模数据时,低阶项所需时间相较高阶项可忽略不计。
我们去掉乘法常数,是因为该值与数据量无关。
大 O 记号:数学定义
上述步骤足以应对大多数实际需求,从而准确推导算法的时间复杂度。我们统计算法执行的基本指令数,得到某个表达式 f(N)。经两步简化后,得到简化表达式 g(N)。于是可写作 f(N) = O(g(N)),读作“f 是 g 的大 O”。
然而,这并不是严格的数学定义,某些情况下并不充分。
数学上的定义是:若存在常数 C,使得当 N 充分大时,下式成立,则正函数 f(N) = O(g(N)):
f(N) ≤ C × g(N)
我们可用该定义说明 f(N) = 4N2 + 2N + 7 = O(N2)。此时取 C = 5,可见对任意 N > 4,f(N) ≤ 5 × N2:
在实践中,我们通常按上述简化规则使用即可。
时间复杂度的类型
理解了大 O 记号的基础后,我们来看看常见的时间复杂度及其影响,从最高效的常数时间开始。
常数时间:O(1)
顾名思义,常数时间算法的时间复杂度是常数,其性能不随数据量变化。这类算法通常只涉及固定数量输入的计算,例如计算两点间的距离。
两点间的距离可通过计算两点 x、y 坐标差的平方和的平方根得到。
下面的
dist函数计算两点间的距离。它由三条基本指令组成,是一个常数。因此其时间复杂度为 O(1)。有趣的是,即使处理大型数据集,函数也可能表现出常数时间复杂度。例如使用 len 函数计算列表长度。该操作是 O(1),因为其实现会在内部维护列表大小,而无需每次请求长度时都逐一计数。
线性时间:O(N)
我们之前讨论过
sum_list作为线性时间函数的例子。一般而言,线性时间算法需要逐个检查每个数据点的任务。计算最小值、最大值或平均值属于此类典型操作。让我们练习分析以下用于计算列表最小值的函数:
若列表有 N 个元素,则复杂度为 1 + (N - 1) + 1 = N + 1 = O(N)。
线性时间算法的执行时间与数据量成正比。因此,如果数据量加倍,算法处理数据所需时间也应加倍。
对数时间:O(log(N))
猜数字游戏要求在 1 到 N 之间猜一个隐藏的数字,目标是在尽可能少的次数内猜中。每次猜测后,我们会得到反馈:隐藏数字比猜测值大、比猜测值小,或正好相等。若猜中即获胜,否则继续。
一种有效策略是每次都猜中点。假设 N = 15。第一次猜 8。若秘密数字小于 8,则范围缩小到 1 到 7;若更大,则在 9 到 15 之间。我们不断对剩余范围取中点,直到找到正确答案。下图展示了该策略可能的路径。
我们来分析这种方法的时间复杂度。与之前的例子不同,该算法的步数并不只取决于输入规模 N,因为有可能第一次就猜中。
分析此类算法时,我们关注最坏情况。例如 N = 15 时,在最坏情况下我们需要 4 次猜测。每次取中点都会排除剩余可能性的一半。最坏情况下,我们会一直猜到只剩一个可能为止。因此,我们需要回答的问题是:
N 需要被 2 除以多少次才能得到 1?
答案是以 2 为底的对数 log2(N)。用于定位正确数字的算法称为二分查找。由于最多需要 log2(N) 次猜测,我们可将其复杂度表示为 O(log2(N)),或简写为 O(log(N)),因为常数在时间复杂度表示中无关紧要。
由于增长极其缓慢,对数时间复杂度在实践中非常受青睐,几乎与常数时间相当。即使 N 很大,操作总数仍然相当低。例如,即使 N 达到十亿,所需操作大约也只有 30 次。
二分查找是计算机科学中的基础算法,应用广泛。例如在自然语言处理中,拼写检查与自动更正系统可以利用二分查找的变体高效地定位候选词。
二次时间:O(N2)
排序是计算机经常需要执行的一项基本任务。一种排序 N 个数的方法是反复找出列表中的最小元素。
要分析
for循环的复杂度,我们先评估循环体内指令的复杂度,再乘以循环执行的次数。计算列表最小值与从列表移除一个元素都是 O(N) 操作。追加操作为常数时间 O(1)。因此,每次循环的复杂度为 O(N + N + 1) = O(2N + 1),简化为 O(N)。由于共有 N 次循环,总体复杂度为 N × O(N) = O(N2)。
selection_sort()的其余部分由三条简单指令构成,因此整体复杂度为 O(N2 + 3) = O(N2)。我们对 for 循环的分析做了简化。每次迭代都会从列表中移除一个元素,这意味着并非每次迭代执行的指令数都相同。第一次执行 N 条,第二次 N - 1 条,第三次 N - 2 条,直到最后一次只执行 1 条。
这意味着 for 循环的真实复杂度为:
N + (N - 1) + (N - 2) + … + 1
可以证明该和等于 (N2 + N) / 2。不过,
(N2 + N) / 2 = ½N2 + ½N = O(N2)
即便我们先前略有高估,整体复杂度仍为二次。
selection_sort()由于其 O(N2) 的二次复杂度,属于较慢的排序算法。二次复杂度的函数扩展性很差,适用于小列表,但对于上百万数据点的排序并不现实,可能需要数天才能完成。将数据量加倍,执行时间会增加到四倍。
对数线性时间:O(N log(N))
我们可以设计 O(N log(N)) 的排序算法。其中一种称为归并排序。我们不展开实现细节,若您想进一步了解,请查看课程中的这篇归并排序快速介绍,课程为Python 数据结构与算法。
如前所述,对数复杂度在实践中表现近似常数。因此,O(N log(N)) 算法在实际应用中的执行时间,可能与线性时间算法相当。
下图显示 N log(N) 和 N 的增长速率相近,而 N2 增长很快,速度很快会变得很慢。
立方时间:O(N3)
AI 中一个广泛使用的立方时间算法是矩阵乘法,它在大型语言模型(如 GPT)的训练与推理中都发挥关键作用。
要将两个 N×N 矩阵 A 和 B 相乘,需要用 A 的每一行与 B 的每一列相乘。具体地,乘积在 (i, j) 位置的值由 A 的第 i 行与 B 的第 j 列对应元素相乘并求和得到。
以下是矩阵乘法的 Python 实现:
总体而言,
matrix_mul()执行了 N3 + N2 + 2 条指令,因此时间复杂度为 O(N3)。另一种分析方式是基于计算量来推断。矩阵乘法的结果有 N2 个元素,每个元素的计算需要 O(N) 时间,因此总体复杂度为 N2 × O(N) = O(N3)。
立方时间算法相当缓慢。数据量加倍会使执行时间增加到 8 倍,扩展性很差。即使 N 相对较小,指令数量也会迅速爆炸。
矩阵乘法是一个硬件进步产生显著影响的计算难题。虽然也存在略高效一些的矩阵乘法算法,但主要是 GPU 芯片在设计上针对矩阵乘法进行了优化,这才使得像 GPT 这样的大模型能够在可接受的时间内完成训练。
近来,研究者提出在大型学习模型中消除矩阵乘法——详情可参阅这篇文章:无 MatMul 的大语言模型:关键概念解读。
指数时间复杂度:O(2N) 与 O(N!)
指数时间算法通常出现在通过穷举所有可能解来求解的问题中。设想为一辆需要访问 N 个投递点的送货卡车规划路线。一种方法是评估所有可能的投递顺序。Python 的 itertools 包提供了遍历列表所有排列的简便方法。
长度为 N 的列表的排列数记为 N!,读作“ N 的阶乘”。阶乘函数呈指数式增长。例如当 N = 13 时,排列数已超过十亿。
若投递点给定为一组二维坐标,我们可以遍历所有可能顺序,并记录最优解,从而找到总距离最短的投递顺序。
外层
for循环执行 N! 次。因此,optimize_route()的操作数为 N! × (1 + N - 1 + 2) + 3 = N! × (N + 2) + 3 = N! × N + 2N! + 3。我们已知在计算时间复杂度时应忽略低次项。但此处出现了 N!,它并非 N 的幂。我们可以将简化策略推广为:丢弃增长更慢的项。下表列出了算法时间复杂度中常见的项,按增长率从低到高排列。
1
log(N)
N
N2
N3
Nk
2N
N!
因此,我们可以将
optimize_route()的时间复杂度表示为 N! × N + 2N! + 3 = O(N! × N)。指数时间复杂度的算法通常只适用于非常小的实例。即使只有 13 个地点,排列数也超过十亿,使得该算法在现实中不具可行性。
时间复杂度:最坏情况与最好情况
在猜数字游戏中,我们聚焦最坏情况的复杂度。关注最坏情况可以保证算法执行时间的增长速率。
在最好情况下,我们第一次就猜中,因此最好情况复杂度为 O(1)。这当然是准确的——最好情况下只需一次常数操作。但这并不很有参考价值,因为其发生概率极低。
一般而言,我们分析算法复杂度时都会关注最坏情况,原因在于:
时间复杂度:实践意义
时间复杂度看似理论化,但在实践中非常有用。
例如,若某个函数始终只处理小数据集,那么一个易于理解的 O(N2) 算法可能比复杂且难维护的 O(N) 算法更合适。但这应是有意识的取舍,避免当用户量上升时措手不及,导致应用无法承载。
时间复杂度分析揭示:微小的代码优化对算法执行时间的影响微乎其微。显著的改进来自从根本上减少为得到结果所需的基本操作数量。通常应优先保持代码清晰易读,而非过度优化以致难以理解。
较慢的部分会主导整体性能。在优化较慢部分之前优化较快部分往往没有意义。举例来说,假设我们有一个函数执行两项任务:
如果
clean_data()的复杂度是 O(N2),而analyze_data()的复杂度是 O(N3),那么降低clean_data()的复杂度并不会改善process_data()的整体复杂度。更应将精力放在改进analyze_data()上。此外,时间复杂度还能指导硬件选型。例如,一个 O(N3) 的算法尽管理论上扩展性差,但在数据量有限的任务上,如果运行在更强的硬件或更快的编程语言上,仍可能足够快。反之,若算法时间复杂度为 O(2N) 的指数级,再好的硬件也难以救场,说明必须寻找更高效的算法。
结论
尽管理论上计算机越来越快,我们处理的数据却前所未有地庞大。可以这样理解:每次使用互联网、智能手机或智能家居设备,我们都会产生海量信息。随着这些数据的“高山”不断增高,从中进行整理并找到有价值的内容愈发困难。因此,持续改进我们的工具——尤其是算法——以更好地处理和理解这些信息,显得尤为重要。
时间复杂度分析为推理算法的执行时间提供了一个直观框架。其核心目标是洞察时间复杂度的增长率,而非预测精确运行时间。尽管该模型包含诸多简化与假设,但在实践中极为有用,能够有效捕捉算法执行时间行为的本质。
如果您想继续探索更多计算机科学主题,欢迎阅读我的文章:数据结构:一份含 Python 示例的完整指南。