
课程
Python 入门
4 小时
7.1M
实践并学习路径你的进步。
使用 Google 继续在线运行和编辑此教程中的代码
运行代码本教程讲解如何在 Python 中读取文本文件。这是处理文本数据(尤其是自然语言处理“NLP”)项目的关键第一步。将文本文件导入 Python 时存在一些细节与常见陷阱,这意味着数据科学家往往需要暂时绕开诸如 pandas 之类的熟悉工具,才能更高效地处理文本数据。
为更好地理解本文,您需要具备 Python 的基础知识,尤其是理解字符串、整数和列表等数据类型的差异。了解 pandas 以及 dataframe 的概念也会有所帮助。
如果您想了解如何从 .csv 文件导入数据,请参见pandas read csv() 教程:导入数据。若要进一步了解从 JSON 与 pickle (.pkl) 文件导入数据,请查阅将数据导入 pandas教程。若您对抓取网页 HTML 感兴趣,可以阅读使用 Python(及 Beautiful Soup)进行网页抓取。或者,您也可以直接在 DataCamp 上通过交互课程Introduction to Importing Data in Python开始学习,第一章免费。
在本教程中,我们将使用一个简单的文本文件,它是从维基百科“自然语言处理”词条的第一段复制而来。该文件保存为 nlp_wiki.txt,内容如下:
"Natural language processing (NLP) is an interdisciplinary subfield of linguistics, computer science, and artificial intelligence concerned with the interactions between computers and human language, in particular how to program computers to process and analyze large amounts of natural language data. The goal is a computer capable of "understanding" the contents of documents, including the contextual nuances of the language within them. The technology can then accurately extract information and insights contained in the documents as well as categorize and organize the documents themselves. Challenges in natural language processing frequently involve speech recognition, natural-language understanding, and natural-language generation."pandas 的 read_table() 函数用于将分隔的文本文件(例如以逗号分隔列的文本格式电子表格)读取为 dataframe。我们的文本文件并非分隔格式,只是一些文本的复制粘贴。不过,使用 pandas 仍然是快速查看内容的便捷方式,因为该函数的语法与大多数数据科学家熟悉的 read_csv() 相似。
下面的代码可用于通过 pandas 读取文本文件。
pd.read_table('nlp_wiki.txt', header=None, delimiter=None)输出:
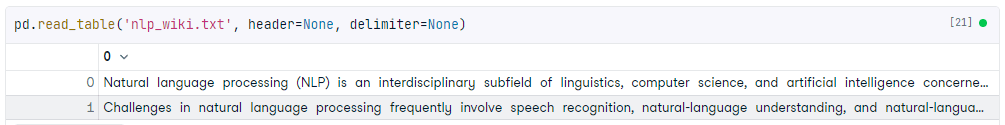
我们向 read_table() 函数传入了文本文件名和两个参数。
header=None 告诉 pandas 第一行是文本而非表头。delimiter=None 告诉 pandas 不要在任何位置(除换行外)拆分行,因此会得到单列表、每行一行的结果。在这种情况下,DataFrame 并不总是理想选择。段落被拆成了独立的行(pandas 使用了换行符来拆分),而且我们无法看到完整输出。另一种做法是对该列调用 .to_list() 方法。
pd.read_table('nlp_wiki.txt', header=None, delimiter=None)[0].to_list()输出:
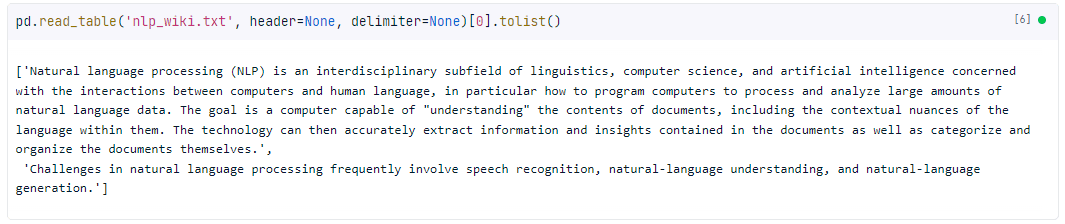
这会返回一个列表,可像普通的 Python 列表一样访问。它也会打印出完整文本。
read_table() 提供了大量可选关键字参数,您可在官方文档中查阅。以下是几个最常用的:
skiprows=n
跳过前 n 行。在我们的示例中,我们跳过了第一行。
nrows=n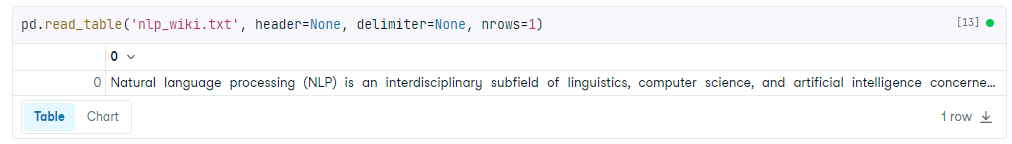
仅保留前 n 行。在我们的示例中,我们保留了第一行。
skip_blank_lines= True pandas 会跳过任何 NaN 值,而不是返回空行。
NumPy 的 loadtxt() 旨在从文本文件读取数值数组;不过,它也可用于读取文本行。如果您在后续分析中使用 NumPy,这会很方便,因为输出是一个 NumPy 数组。
np.loadtxt('nlp_wiki.txt', dtype="str", delimiter="\0")输出:
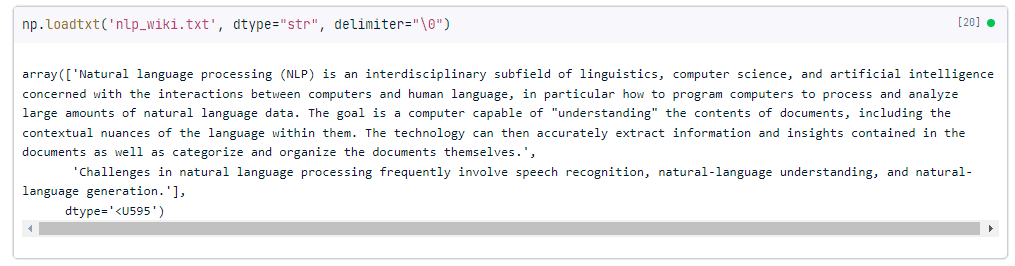
与 pandas 示例类似,我们传入了分隔符参数以避免拆分行。在此情况下,分隔符必须是单个字符(使用 None 会有不同的行为),因此我们使用“空终止”字符 \0。由于该字符不可能出现在字符串中间,因此这相当于“不要使用分隔符”。
我们还传入了 dtype="str",用于指定 NumPy 生成数组的数据类型。在此我们使用 “str” 以返回字符串。随后也可通过 .tolist() 函数将其转换为列表。
使用 Python 的内置功能可以获得最大的灵活性。这种方式对用户不太友好,主要面向软件工程。对于数据分析而言,pandas 或 NumPy 的方案通常已足够。
要使用 open(),您还需要使用上下文管理器,即 with 关键字。它会仅在 with 下方缩进代码运行期间分配计算机资源。在此示例中,我们打开文件,遍历并将其存入内存的 lines 变量,然后关闭文件。
此处的 for 循环使用了列表推导式,每一行都由 open() 函数按行解析,在此场景下行分隔符为换行符 (\n)。
该代码块还使用了 strip() 函数,用于去除每个对象(或行)前后的多余空白。
with open(filename) as file:
    lines = [line.strip() for line in file]
输出:
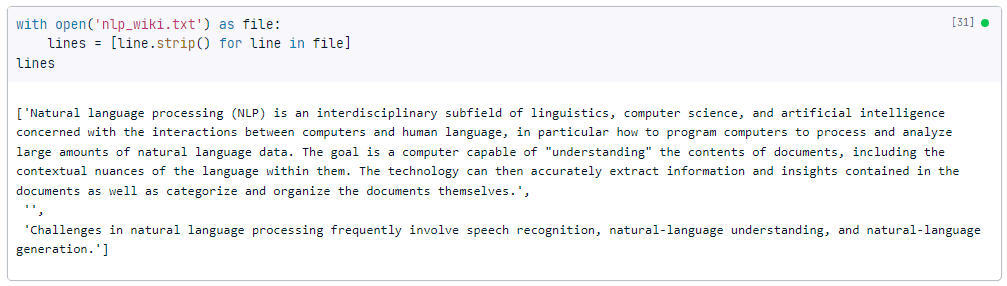
如您所见,这会输出一个单一列表,其中每个元素是一个段落。与 pandas 与 NumPy 示例不同,我们这里有三个对象,因为原始文本在段落之间包含两个换行。
介绍完如何在 Python 中导入文本文件后,我们继续看看如何写入文本文件。这里的写入是指将 Python 中的文本保存为您电脑上的文件。当您在 Python 中处理过文本并希望保存结果时,这尤其有用。
您可以使用 Python 内置的 write() 方法写入文本文件。这同样需要配合 open() 使用,并使用上下文管理器 with。下面通过示例说明:
with open("new_nlp_wiki.txt", "w") as file:
  file.write("New wiki entry: ChatGPT")
在该示例中,我们以写入模式(参数 'w')打开名为 new_nlp_wiki.txt 的文件,这意味着文件中任何已有内容都会被覆盖。随后我们在文件对象上调用 write() 方法,将字符串“New wiki entry: ChatGPT”写入文件。
如果您希望向现有文件追加文本而非覆盖它,可以改为以追加模式(参数 'a')打开文件:
with open("new_nlp_wiki.txt", "a") as file:
    file.write("New wiki entry: ChatGPT")
使用 pandas 写入文本文件的方式中,to_csv() 方法可能是最简单的。下面演示其用法:
nlp_wiki = pd.read_table("nlp_wiki.txt", header=None, delimiter=None)
nlp_wiki.to_csv("nlp_wiki_pandas.txt", sep="\t", index=False)
第一行代码中,我们使用上一节介绍的 read_table() 方法读取了一个文本文件。随后我们使用 to_csv() 方法保存文件,指定分隔符为制表符 ('\t'),并将 index 参数设为 False,以在输出中省略行索引。
希望您喜欢本教程!回顾一下,我们涵盖了如下内容:
Python 课程
课程
课程
实践并学习路径你的进步。
使用 Google 继续