Kurs
Einführung in Python
4 Std.
7M
Code aus diesem Tutorial online ausführen und bearbeiten
Code ausführenIn diesem Tutorial erfährst du, wie du Textdateien in Python einliest. Das ist ein zentraler erster Schritt in jedem Projekt mit Textdaten, insbesondere im Bereich Natural Language Processing (“NLP”). Beim Import von Textdateien nach Python gibt es einige Besonderheiten und Stolperfallen. Daher weichen Data Scientists für Textdaten oft von vertrauten Paketen wie pandas ab, um effizienter zu arbeiten.
Um das Beste aus diesem Artikel mitzunehmen, solltest du grundlegende Python-Kenntnisse haben, insbesondere die Unterschiede zwischen Datentypen wie Strings, Integers und Listen. Ein Grundverständnis von pandas und dem Konzept eines DataFrames ist ebenfalls hilfreich.
Wenn du Daten aus .csv-Dateien importieren möchtest, findest du alles Nötige im pandas read csv()-Tutorial: Daten importieren. Mehr zum Import aus JSON- und Pickle-Dateien (.pkl) erfährst du im Tutorial Importing Data into pandas. Interessierst du dich für Web Scraping von HTML-Seiten, ist Web Scraping using Python (and Beautiful Soup) das Richtige für dich. Oder leg direkt auf DataCamp los mit unserem interaktiven Kurs Introduction to Importing Data in Python – das erste Kapitel ist kostenlos.
Für dieses Tutorial nutzen wir eine einfache Textdatei: eine Kopie des ersten Absatzes der Wikipedia-Seite zu Natural Language Processing. Sie wurde als nlp_wiki.txt gespeichert und enthält Folgendes:
"Natural language processing (NLP) is an interdisciplinary subfield of linguistics, computer science, and artificial intelligence concerned with the interactions between computers and human language, in particular how to program computers to process and analyze large amounts of natural language data. The goal is a computer capable of "understanding" the contents of documents, including the contextual nuances of the language within them. The technology can then accurately extract information and insights contained in the documents as well as categorize and organize the documents themselves. Challenges in natural language processing frequently involve speech recognition, natural-language understanding, and natural-language generation."Die pandas-Funktion read_table() ist dafür gedacht, getrennte Textdateien (z. B. als Text gespeicherte Tabellen mit durch Kommas getrennten Spalten) in einen DataFrame einzulesen. Unsere Textdatei ist nicht getrennt, sondern nur reiner Text. Trotzdem ist pandas praktisch, um den Inhalt schnell zu sichten, denn die Syntax ähnelt read_csv(), das den meisten Data Scientists geläufig ist.
Mit dem folgenden Code liest du eine Textdatei per pandas ein.
pd.read_table('nlp_wiki.txt', header=None, delimiter=None)Ausgabe:
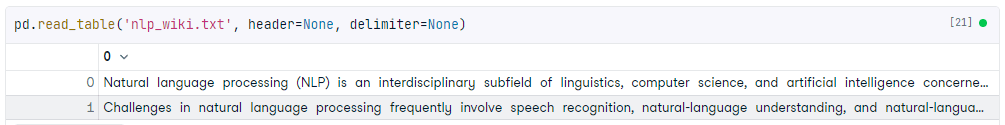
Wir übergeben den Dateinamen und zwei Argumente an read_table().
header=None teilt pandas mit, dass die erste Zeile Text enthält und keine Kopfzeile ist. delimiter=None weist pandas an, die Zeilen nicht zu splitten (außer an Zeilenumbrüchen), sodass es eine einzelne Spalte mit einer Zeile pro Textzeile gibt.Ein DataFrame ist hier nicht immer ideal. Die Absätze werden in einzelne Zeilen zerlegt (pandas nutzt dazu das Newline-Zeichen), und die vollständige Ausgabe ist schwer zu sehen. Eine Alternative ist, für die Spalte die Methode .to_list() aufzurufen.
pd.read_table('nlp_wiki.txt', header=None, delimiter=None)[0].to_list()Ausgabe:
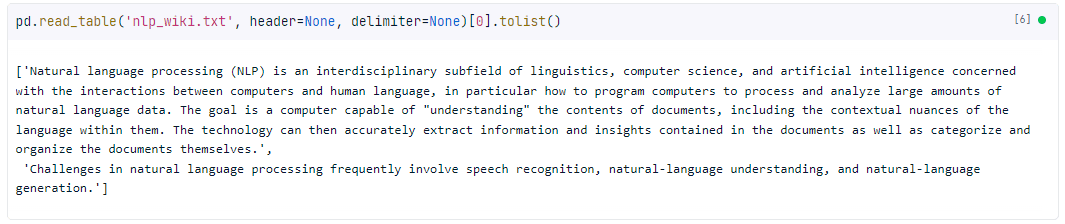
Das ergibt eine Liste, die du wie eine normale Python-Liste verwenden kannst. Außerdem wird der gesamte Text ausgegeben.
Die Funktion read_table() bietet zahlreiche optionale Keyword-Argumente, die du in der offiziellen Dokumentation findest. Hier sind einige der nützlichsten:
skiprows=n
Überspringt die ersten n Zeilen. Im Beispiel haben wir die erste Zeile übersprungen.
nrows=n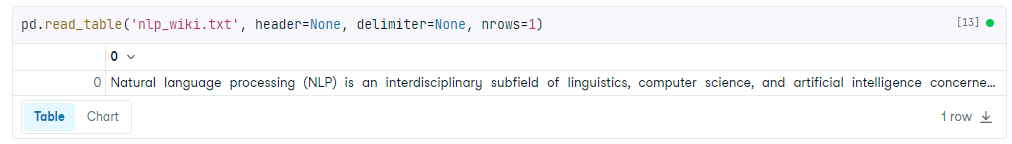
Liest nur die ersten n Zeilen ein. Im Beispiel haben wir die erste Zeile behalten.
skip_blank_lines= True pandas überspringt leere Zeilen bzw. NaN-Werte, statt eine leere Zeile zurückzugeben.
NumPys loadtxt() ist eigentlich dafür gedacht, Zahlenarrays aus einer Textdatei zu lesen; es kann aber auch Textzeilen einlesen. Das ist praktisch, wenn du ohnehin mit NumPy arbeitest, da die Ausgabe ein NumPy-Array ist.
np.loadtxt('nlp_wiki.txt', dtype="str", delimiter="\0")Ausgabe:
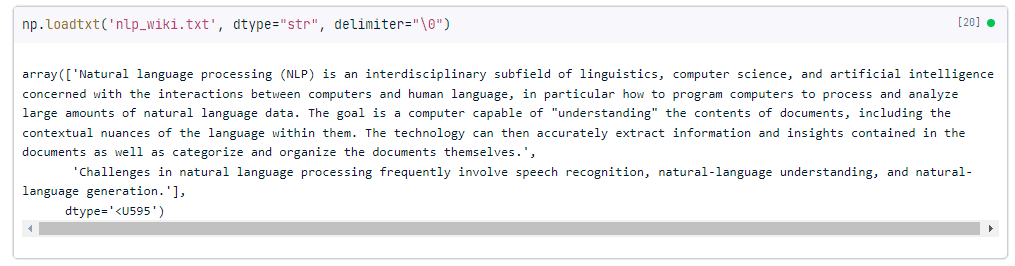
Wie im pandas-Beispiel übergeben wir das delimiter-Argument, um ein Aufsplitten der Zeilen zu verhindern. Hier muss der Trenner ein einzelnes Zeichen sein (None hat ein anderes Verhalten), daher nutzen wir das "Null-Terminator"-Zeichen \0. Da dieses nicht mitten in einem String vorkommen kann, bedeutet es hier effektiv "kein Trennzeichen verwenden".
Außerdem übergeben wir dtype="str", was NumPy den gewünschten Datentyp für das resultierende Array vorgibt. In unserem Fall ist das “str” für Strings. Das Ergebnis lässt sich mit der Funktion .tolist() auch in eine Liste umwandeln.
Die größte Flexibilität erhältst du mit Pythons Bordmitteln. Das ist weniger komfortabel und eher für Software-Engineering gedacht. Für die Datenanalyse reichen pandas- oder NumPy-Lösungen meist aus.
Für open() brauchst du außerdem einen Kontextmanager, also das Schlüsselwort with. Damit werden Ressourcen nur während des eingerückten Codeblocks belegt. In unserem Fall öffnen wir die Datei, iterieren Zeile für Zeile, speichern sie in der Variable lines und schließen sie anschließend.
Die for-Schleife nutzt eine List Comprehension. Jede Zeile entspricht dabei einer vom open()-Aufruf interpretierten Zeile, hier getrennt durch Newline (\n).
Der Codeblock verwendet außerdem die Funktion strip(), die führende und nachgestellte Leerzeichen jeder Zeile entfernt.
with open(filename) as file:
    lines = [line.strip() for line in file]
Ausgabe:
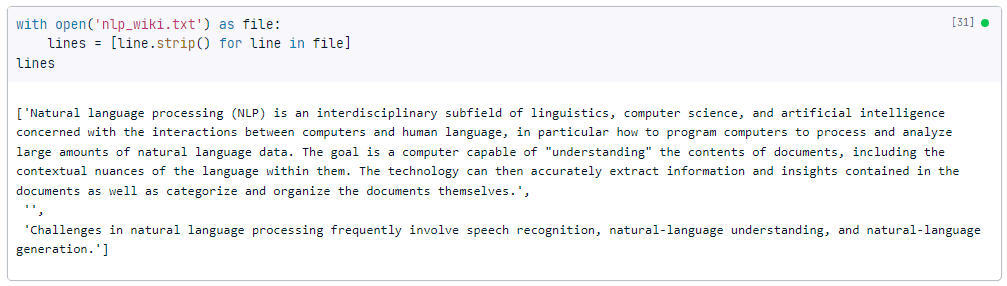
Wie du siehst, entsteht eine einzelne Liste, in der jedes Element ein Absatz ist. Anders als bei den pandas- und NumPy-Beispielen haben wir hier drei Elemente, weil der Originaltext zwei Leerzeilen zwischen den Absätzen enthält.
Nachdem wir den Import behandelt haben, schauen wir uns nun an, wie du Textdateien schreibst. Damit ist gemeint, dass du Textdateien aus Python heraus auf deinem Rechner speicherst. Das ist besonders nützlich, wenn du Textdaten in Python bearbeitet hast und das Ergebnis sichern willst.
Du kannst in Python mit der eingebauten Methode write() Textdateien schreiben. Dafür brauchst du ebenfalls open() und einen Kontextmanager mit dem Schlüsselwort with. Hier ein Beispiel:
with open("new_nlp_wiki.txt", "w") as file:
  file.write("New wiki entry: ChatGPT")
In diesem Beispiel öffnen wir eine Datei namens new_nlp_wiki.txt im Schreibmodus (Argument 'w'). Das überschreibt vorhandene Inhalte. Anschließend schreiben wir mit write() den String “New wiki entry: ChatGPT” in die Datei.
Wenn du Text an eine bestehende Datei anhängen statt sie überschreiben möchtest, öffne die Datei im Append-Modus (Argument 'a'):
with open("new_nlp_wiki.txt", "a") as file:
file.write("New wiki entry: ChatGPT")Am einfachsten schreibst du Textdateien mit pandas über die Methode to_csv(). So funktioniert's:
nlp_wiki = pd.read_table("nlp_wiki.txt", header=None, delimiter=None)
nlp_wiki.to_csv("nlp_wiki_pandas.txt", sep="\t", index=False)
In der ersten Zeile lesen wir die Textdatei mit read_table() ein, wie oben gezeigt. Anschließend speichern wir sie mit to_csv(), geben als Trennzeichen den Tabulator ('\t') an und setzen index=False, damit der Zeilenindex nicht mit ausgegeben wird.
Wir hoffen, dir hat das Tutorial gefallen. Hier ist die Zusammenfassung:
Python-Kurse
Kurs
Kurs
Kurs