
Last chance! 50% off DataCamp Premium
Sale ends in
इस ट्यूटोरियल का कोड ऑनलाइन चलाएं और संपादित करें
कोड चलाएंयह ट्यूटोरियल बताता है कि Python में टेक्स्ट फ़ाइलें कैसे पढ़ें। टेक्स्ट डेटा से जुड़े किसी भी प्रोजेक्ट में यह पहला आवश्यक कदम है, खासकर Natural Language Processing (“NLP”) में। टेक्स्ट फ़ाइलों को Python में इम्पोर्ट करते समय कुछ बारीकियाँ और आम गलतियाँ होती हैं, जिनके कारण डेटा वैज्ञानिकों को टेक्स्ट डेटा को सबसे कुशल तरीके से संभालने के लिए अक्सर pandas जैसे परिचित पैकेजों से आगे बढ़ना पड़ता है।
इस लेख से अधिकतम लाभ उठाने के लिए, आपको Python का बुनियादी ज्ञान होना चाहिए, खासकर डेटा टाइप्स जैसे स्ट्रिंग्स, इंटीजर और लिस्ट्स के बीच के अंतर को समझना। pandas और डेटा फ़्रेम क्या होता है, इसका ज्ञान भी उपयोगी रहेगा।
यदि आप .csv फ़ाइलों से डेटा इम्पोर्ट करने के बारे में जानना चाहते हैं, तो यह pandas read csv() Tutorial: Importing Data में कवर किया गया है। JSON और pickle (.pkl) फ़ाइलों से इम्पोर्ट करने के बारे में अधिक जानने के लिए Importing Data into pandas ट्यूटोरियल देखें। यदि आप HTML पेजों की वेब स्क्रैपिंग में रुचि रखते हैं, तो Web Scraping using Python (and Beautiful Soup) आपके लिए उपयोगी हो सकता है। वैकल्पिक रूप से, आप DataCamp पर हमारे इंटरैक्टिव कोर्स Introduction to Importing Data in Python से सीधे सीखना शुरू कर सकते हैं, जिसका पहला अध्याय निःशुल्क है।
इस ट्यूटोरियल के लिए, हम एक सरल टेक्स्ट फ़ाइल का उपयोग करेंगे, जो Natural Language Processing के Wikipedia पेज के पहले पैराग्राफ का कॉपी-पेस्ट है। इसे nlp_wiki.txt नाम की फ़ाइल के रूप में सेव किया गया है। इसमें निम्नलिखित सामग्री है:
"Natural language processing (NLP) is an interdisciplinary subfield of linguistics, computer science, and artificial intelligence concerned with the interactions between computers and human language, in particular how to program computers to process and analyze large amounts of natural language data. The goal is a computer capable of "understanding" the contents of documents, including the contextual nuances of the language within them. The technology can then accurately extract information and insights contained in the documents as well as categorize and organize the documents themselves. Challenges in natural language processing frequently involve speech recognition, natural-language understanding, and natural-language generation."pandas की read_table() फ़ंक्शन डिलीमिटेड टेक्स्ट फ़ाइलों (जैसे टेक्स्ट फ़ाइल के रूप में सेव की गई स्प्रेडशीट, जिसमें कॉलम कॉमा से अलग हों) को डेटा फ़्रेम में पढ़ने के लिए बनाई गई है। हमारी टेक्स्ट फ़ाइल डिलीमिटेड नहीं है। यह सिर्फ कुछ टेक्स्ट का कॉपी-पेस्ट है। फिर भी, pandas का उपयोग सामग्री को तुरंत देखने का एक उपयोगी तरीका हो सकता है क्योंकि इस फ़ंक्शन का सिंटैक्स read_csv() जैसा है, जिससे अधिकांश डेटा वैज्ञानिक परिचित होते हैं।
नीचे दिया गया कोड pandas का उपयोग करके टेक्स्ट फ़ाइल पढ़ने के लिए इस्तेमाल किया जा सकता है।
pd.read_table('nlp_wiki.txt', header=None, delimiter=None)आउटपुट:
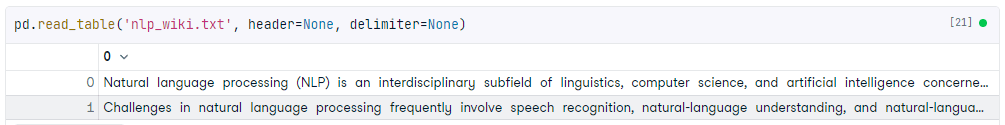
हम अपनी read_table() फ़ंक्शन को टेक्स्ट फ़ाइल का नाम और दो आर्ग्युमेंट्स पास करते हैं।
header=None pandas को बताता है कि पहली पंक्ति हेडर नहीं बल्कि टेक्स्ट है। delimiter=None pandas को बताता है कि लाइनों को कहीं भी न बाँटे (सिवाय नई पंक्ति के), ताकि एक सिंगल कॉलम हो जिसमें प्रति पंक्ति एक रो हो।इस स्थिति में, एक DataFrame हमेशा आदर्श नहीं होता। पैराग्राफ़ अलग-अलग पंक्तियों में बँट जाते हैं (pandas इसके लिए newline कैरेक्टर का उपयोग कर रहा है), और हम पूरा आउटपुट नहीं देख पाते। एक और विकल्प कॉलम के लिए .to_list() मेथड कॉल करना है।
pd.read_table('nlp_wiki.txt', header=None, delimiter=None)[0].to_list()आउटपुट:
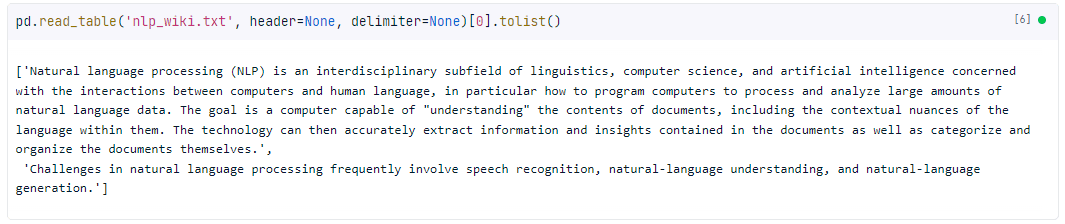
यह एक सूचियों की सूची (list of lists) लौटाता है जिसे सामान्य Python सूची की तरह एक्सेस किया जा सकता है। यह पूरा टेक्स्ट भी प्रिंट करता है।
read_table() फ़ंक्शन में कई वैकल्पिक कीवर्ड आर्ग्युमेंट्स हैं, जिनके बारे में आप आधिकारिक डॉक्यूमेंटेशन में पढ़ सकते हैं। यहाँ कुछ सबसे उपयोगी दिए गए हैं:
skiprows=n
यह पहली n पंक्तियाँ स्किप कर देता है। हमारे उदाहरण में, हमने पहली पंक्ति स्किप की।
nrows=n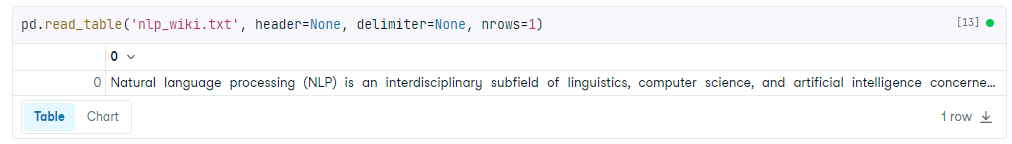
यह पहली n पंक्तियाँ रखता है। हमारे उदाहरण में, हमने पहली पंक्ति रखी है।
skip_blank_lines= True pandas खाली पंक्ति लौटाने के बजाय किसी भी NaN मान को स्किप कर देगा।
NumPy का loadtxt() टेक्स्ट फ़ाइल से संख्याओं के एरे पढ़ने के लिए बनाया गया है; फिर भी, इसे टेक्स्ट की पंक्तियाँ पढ़ने के लिए इस्तेमाल किया जा सकता है। यदि आप अपने बाकी विश्लेषण में NumPy का उपयोग कर रहे हैं, तो यह सुविधाजनक है क्योंकि आउटपुट एक NumPy array होता है।
np.loadtxt('nlp_wiki.txt', dtype="str", delimiter="\0")आउटपुट:
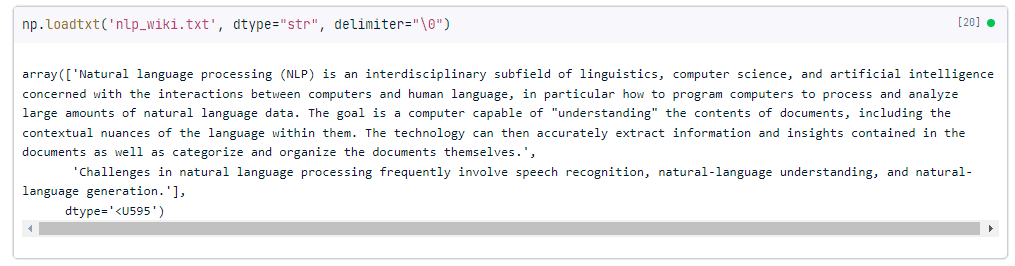
pandas वाले उदाहरण की तरह, हम लाइनों को बँटने से रोकने के लिए delimiter आर्ग्युमेंट पास करते हैं। इस मामले में, delimiter एक सिंगल कैरेक्टर होना चाहिए (None का अलग व्यवहार होता है), इसलिए हम "null termination" कैरेक्टर \0 का उपयोग करते हैं। चूँकि यह किसी स्ट्रिंग के बीच में आ नहीं सकता, इसका उपयोग करने का अर्थ है "कोई delimiter उपयोग न करें"।
हम dtype="str" भी पास करते हैं, जो NumPy को बताता है कि प्राप्त array को कौन-सा डेटा टाइप देना है। हमारे मामले में, हम “str” का उपयोग करते हैं जो स्ट्रिंग लौटाता है। इसे .tolist() फ़ंक्शन से सूची में भी बदला जा सकता है।
अधिकतम लचीलापन Python की बिल्ट-इन कार्यक्षमता का उपयोग करके प्राप्त किया जा सकता है। यह कम उपयोगकर्ता-मित्र है और मुख्य रूप से सॉफ़्टवेयर इंजीनियरिंग के लिए डिज़ाइन किया गया है। डेटा विश्लेषण के लिए pandas या NumPy के समाधान आम तौर पर पर्याप्त होते हैं।
open() का उपयोग करने के लिए, आपको एक कॉन्टेक्स्ट मैनेजर की भी आवश्यकता होती है, जो with कीवर्ड है। यह आपके कंप्यूटर के संसाधनों को केवल उतनी देर के लिए आवंटित करता है जब तक with के नीचे इंडेंट किया हुआ कोड चलता है। इस मामले में, हम फ़ाइल खोलते हैं, उसे लूप करके lines वेरिएबल में मेमोरी में स्टोर करते हैं, फिर उसे बंद कर देते हैं।
यहाँ for लूप लिस्ट कॉम्प्रिहेंशन का उपयोग करता है; हर line, open() फ़ंक्शन द्वारा व्याख्यायित एक लाइन होती है, जो इस मामले में newline (\n) है।
यह कोड ब्लॉक strip() फ़ंक्शन का भी उपयोग करता है, जो प्रत्येक ऑब्जेक्ट (या लाइन) से पहले और बाद का अतिरिक्त whitespace हटा देता है।
with open(filename) as file:
    lines = [line.strip() for line in file]
आउटपुट:
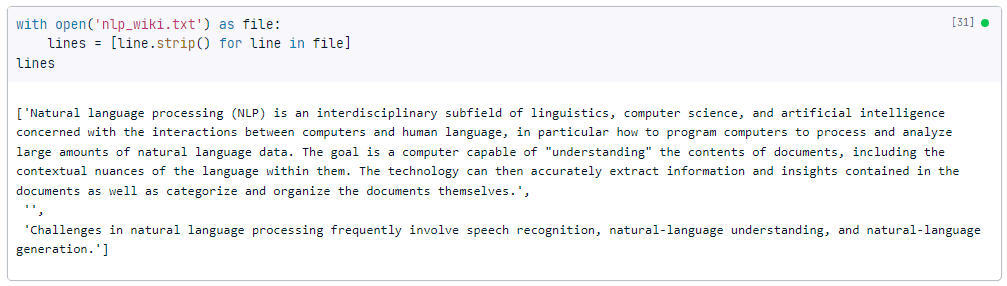
जैसा कि आप देख सकते हैं, यह एक सिंगल सूची आउटपुट करता है, जहाँ सूची का प्रत्येक आइटम एक पैराग्राफ़ है। pandas और NumPy के उदाहरणों के विपरीत, यहाँ हमारे पास तीन ऑब्जेक्ट हैं, क्योंकि मूल टेक्स्ट में पैराग्राफ़ों के बीच दो नई पंक्तियाँ हैं।
अब जब हमने Python में टेक्स्ट फ़ाइलें इम्पोर्ट करना कवर कर लिया है, तो आइए देखें कि टेक्स्ट फ़ाइलें कैसे लिखें। फ़ाइलें लिखने से हमारा मतलब है Python से आपकी मशीन पर टेक्स्ट फ़ाइलें सेव करना। यह विशेष रूप से तब उपयोगी होता है जब आपने Python में टेक्स्ट फ़ाइलों में बदलाव किया हो और आउटपुट को सेव करना चाहते हों।
आप Python में बिल्ट-इन write() मेथड का उपयोग करके टेक्स्ट फ़ाइलें लिख सकते हैं। इसके लिए open() का भी उपयोग करना पड़ता है, और एक कॉन्टेक्स्ट मैनेजर की भी आवश्यकता होती है, जो with कीवर्ड है। आइए एक उदाहरण से समझते हैं:
with open("new_nlp_wiki.txt", "w") as file:
  file.write("New wiki entry: ChatGPT")
इस उदाहरण में, हमने new_nlp_wiki.txt नाम की फ़ाइल को लिखने के मोड में खोला ('w' आर्ग्युमेंट), जिसका अर्थ है कि फ़ाइल की कोई भी मौजूदा सामग्री ओवरराइट हो जाएगी। फिर हमने फ़ाइल ऑब्जेक्ट पर write() मेथड कॉल किया ताकि स्ट्रिंग “New wiki entry: ChatGPT” फ़ाइल में लिखी जा सके।
यदि आप मौजूदा फ़ाइल को ओवरराइट करने के बजाय उसके अंत में टेक्स्ट जोड़ना चाहते हैं, तो आप फ़ाइल को append मोड ('a' आर्ग्युमेंट) में खोल सकते हैं:
with open("new_nlp_wiki.txt", "a") as file:
    file.write("New wiki entry: ChatGPT")
pandas का उपयोग करके टेक्स्ट फ़ाइल लिखने का शायद सबसे आसान तरीका to_csv() मेथड का उपयोग करना है। आइए इसे क्रियान्वयन में देखें!
nlp_wiki = pd.read_table("nlp_wiki.txt", header=None, delimiter=None)
nlp_wiki.to_csv("nlp_wiki_pandas.txt", sep="\t", index=False)
पहली कोड लाइन में, हमने पिछले सेक्शन में बताए अनुसार read_table() मेथड का उपयोग करके टेक्स्ट फ़ाइल पढ़ी। फिर हमने to_csv() मेथड का उपयोग करके फ़ाइल को सेव किया और सेपरेटर के रूप में टैब कैरेक्टर ('\t') निर्दिष्ट किया तथा आउटपुट से रो इंडेक्स को बाहर रखने के लिए index आर्ग्युमेंट को False सेट किया।
हमें उम्मीद है कि आपको यह ट्यूटोरियल पसंद आया होगा! संक्षेप में, हमने यह कवर किया:
Python कोर्स
कोर्स
कोर्स
कोर्स