Corso
Introduzione a Python
4 ore
7M
Esegui e modifica il codice da questo tutorial online
Esegui codiceQuesto tutorial spiega come leggere file di testo in Python. È un primo passo essenziale in qualsiasi progetto che coinvolga dati testuali, in particolare l’elaborazione del linguaggio naturale ("NLP"). Ci sono sfumature e insidie comuni nell’importazione di file di testo in Python, per cui spesso i data scientist devono allontanarsi da pacchetti familiari come pandas per gestire i dati testuali nel modo più efficiente.
Per trarre il massimo da questo articolo, dovresti avere una conoscenza di base di Python, in particolare dei tipi di dato, come le differenze tra stringhe, interi e liste. È utile anche conoscere pandas e cosa sia un dataframe.
Se vuoi sapere come importare dati da file .csv, trovi tutto nel Tutorial su pandas read csv(): importare dati. Per saperne di più sull’importazione da file JSON e pickle (.pkl), dai un’occhiata al tutorial Importare dati in pandas. Se ti interessa effettuare web scraping di pagine HTML, potrebbe fare al caso tuo Web Scraping con Python (e Beautiful Soup). In alternativa, puoi iniziare a imparare direttamente su DataCamp con il nostro corso interattivo Introduzione all’importazione di dati in Python; il primo capitolo è gratuito.
Per questo tutorial useremo un semplice file di testo che è solo il copia e incolla del primo paragrafo della pagina Wikipedia sull’Elaborazione del Linguaggio Naturale. È stato salvato come file chiamato nlp_wiki.txt. Contiene quanto segue:
"Natural language processing (NLP) is an interdisciplinary subfield of linguistics, computer science, and artificial intelligence concerned with the interactions between computers and human language, in particular how to program computers to process and analyze large amounts of natural language data. The goal is a computer capable of "understanding" the contents of documents, including the contextual nuances of the language within them. The technology can then accurately extract information and insights contained in the documents as well as categorize and organize the documents themselves. Challenges in natural language processing frequently involve speech recognition, natural-language understanding, and natural-language generation."La funzione read_table() di pandas è pensata per leggere file di testo delimitati (ad es. un foglio di calcolo salvato come file di testo, con virgole che separano le colonne) in un dataframe. Il nostro file di testo non è delimitato. È solo un copia e incolla di un testo. Tuttavia, usare pandas può essere utile per visualizzare rapidamente il contenuto, dato che la sintassi di questa funzione è simile a read_csv(), con cui la maggior parte dei data scientist ha familiarità.
Il codice seguente può essere usato per leggere un file di testo con pandas.
pd.read_table('nlp_wiki.txt', header=None, delimiter=None)Output:
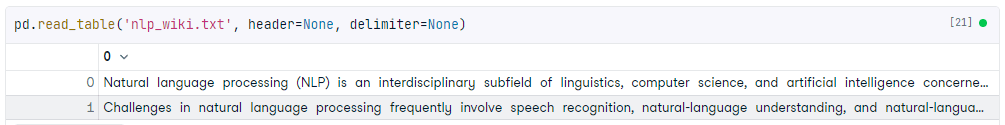
Passiamo il nome del file di testo e due argomenti alla nostra funzione read_table().
header=None dice a pandas che la prima riga contiene testo, non un’intestazione. delimiter=None dice a pandas di non separare le righe in nessun punto (tranne i newline), così da ottenere una singola colonna con una riga per linea.In questa situazione, un DataFrame non è sempre l’ideale. I paragrafi sono separati in righe singole (pandas usa il carattere newline per farlo) e non possiamo vedere l’output completo. Un’altra opzione è chiamare il metodo .to_list() sulla colonna.
pd.read_table('nlp_wiki.txt', header=None, delimiter=None)[0].to_list()Output:
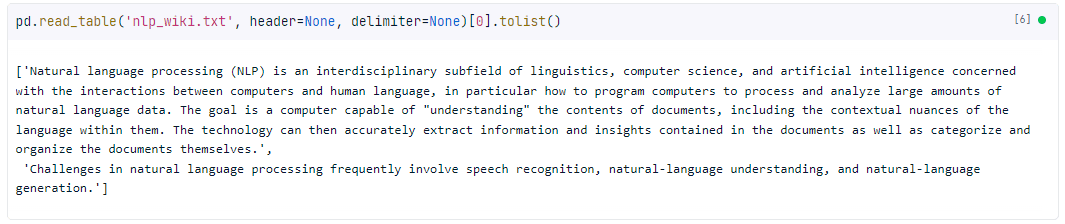
Questo restituisce una lista di liste a cui si può accedere come a una normale lista Python. Stampa anche il testo completo.
La funzione read_table() ha molti argomenti opzionali con parola chiave, che puoi leggere nella documentazione ufficiale. Eccone alcuni tra i più utili:
skiprows=n
Salta le prime n righe. Nel nostro esempio, abbiamo saltato la prima riga.
nrows=n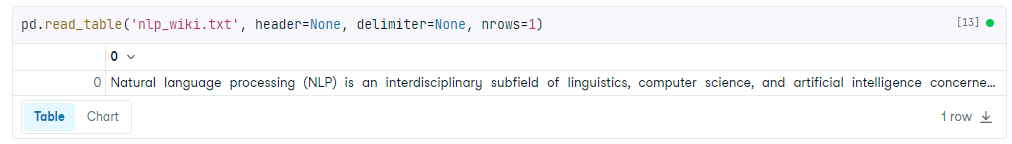
Conserva le prime n righe. Nel nostro esempio, abbiamo mantenuto la prima riga.
skip_blank_lines= True pandas salterà eventuali valori NaN invece di restituire una riga vuota.
loadtxt() di NumPy è progettato per leggere array di numeri da un file di testo; tuttavia, può essere usato per leggere righe di testo. Questo è comodo se stai usando NumPy nel resto dell’analisi, poiché l’output è un array NumPy.
np.loadtxt('nlp_wiki.txt', dtype="str", delimiter="\0")Output:
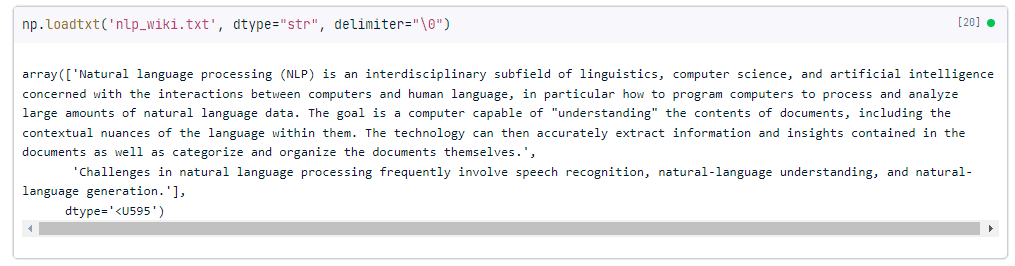
Come nell’esempio con pandas, passiamo l’argomento delimiter per evitare che le righe vengano divise. In questo caso, il delimitatore deve essere un singolo carattere (usare None ha un comportamento diverso), quindi usiamo un carattere di "terminazione null", \0. Poiché questo non può comparire in mezzo a una stringa, usarlo significa "non usare alcun delimitatore".
Passiamo anche dtype="str" che dice a NumPy quale tipo di dato assegnare all’array risultante. Nel nostro caso usiamo “str” che restituisce una stringa. Questo può anche essere convertito in una lista usando la funzione .tolist().
La massima flessibilità si ottiene usando le funzionalità integrate di Python. È meno intuitivo e pensato principalmente per l’ingegneria del software. Le soluzioni con pandas o NumPy sono in genere sufficienti per l’analisi dei dati.
Per usare open(), serve anche un context manager, ovvero la parola chiave with. Questa alloca le risorse del tuo computer solo mentre il codice indentato sotto with è in esecuzione. In questo caso, apriamo il file, lo scorriamo e lo memorizziamo in memoria nella variabile lines, quindi lo chiudiamo.
Il ciclo for qui utilizza una list comprehension: ogni riga è una riga così come interpretata dalla funzione open(), che in questo caso è un newline (\n).
Questo blocco di codice usa anche la funzione strip(), che rimuove gli spazi bianchi aggiuntivi prima e dopo ogni oggetto (o riga).
with open(filename) as file:
    lines = [line.strip() for line in file]
Output:
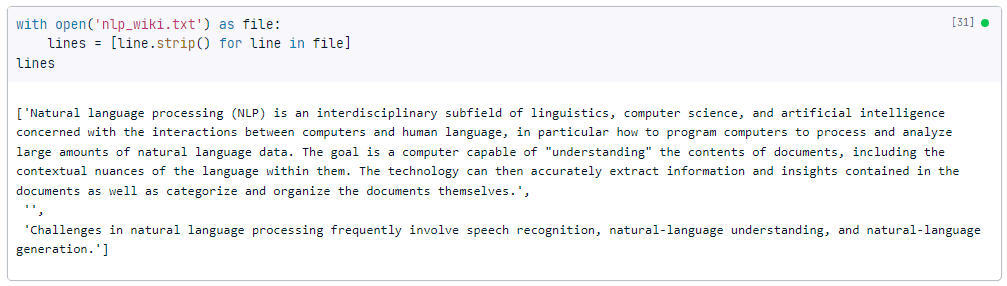
Come puoi vedere, questo produce un’unica lista, in cui ogni elemento è un paragrafo. A differenza degli esempi con pandas e NumPy, qui abbiamo tre oggetti, perché il testo originale ha due newline tra i paragrafi.
Ora che abbiamo visto come importare file di testo in Python, vediamo come scriverli. Con scrivere i file intendiamo salvare file di testo sulla tua macchina da Python. Questo è particolarmente utile quando hai manipolato file di testo in Python e vuoi salvare l’output.
Puoi scrivere file di testo in Python usando il metodo integrato write(). Richiede anche l’uso di open() e di un context manager, ovvero la parola chiave with. Vediamolo con un esempio:
with open("new_nlp_wiki.txt", "w") as file:
  file.write("New wiki entry: ChatGPT")
In questo esempio, abbiamo aperto un file chiamato new_nlp_wiki.txt in modalità scrittura (l’argomento 'w'), il che significa che qualsiasi contenuto già presente nel file verrà sovrascritto. Abbiamo poi chiamato il metodo write() sull’oggetto file per scrivere la stringa “New wiki entry: ChatGPT” nel file.
Se vuoi aggiungere testo a un file esistente invece di sovrascriverlo, puoi aprire il file in modalità append (l’argomento 'a') al suo posto:
with open("new_nlp_wiki.txt", "a") as file:
file.write("New wiki entry: ChatGPT")Probabilmente il modo più semplice per scrivere un file di testo usando pandas è il metodo to_csv(). Vediamolo in azione!
nlp_wiki = pd.read_table("nlp_wiki.txt", header=None, delimiter=None)
nlp_wiki.to_csv("nlp_wiki_pandas.txt", sep="\t", index=False)
Nella prima riga di codice, leggiamo un file di testo usando il metodo read_table() come descritto in una sezione precedente. Poi salviamo il file usando il metodo to_csv() e specifichiamo come separatore il carattere di tabulazione ('\t'), impostando l’argomento index su False per escludere l’indice delle righe dall’output.
Speriamo che questo tutorial ti sia piaciuto! In breve, ecco cosa abbiamo trattato:
Corsi di Python
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



