
Last chance! 50% off DataCamp Premium
Sale ends in
Voer de code van deze tutorial online uit en bewerk deze
Code uitvoerenDeze tutorial laat zien hoe je tekstbestanden leest in Python. Dit is een essentiële eerste stap in elk project met tekstdata, zeker bij Natural Language Processing (“NLP”). Er zijn wat nuances en veelvoorkomende valkuilen bij het importeren van tekstbestanden in Python, waardoor data scientists vaak moeten uitwijken van vertrouwde pakketten zoals pandas om tekstdata zo efficiënt mogelijk te verwerken.
Om het meeste uit dit artikel te halen, is het handig als je basiskennis van Python hebt, met name van datatypes zoals de verschillen tussen strings, integers en lijsten. Kennis van pandas en wat een dataframe is, komt ook van pas.
Wil je weten hoe je data uit .csv-bestanden importeert, lees dan de pandas read csv() Tutorial: Importing Data. Meer over importeren uit JSON- en pickle (.pkl)-bestanden vind je in de tutorial Importing Data into pandas. En als je geïnteresseerd bent in webscraping van HTML-pagina’s, is Web Scraping using Python (and Beautiful Soup) iets voor jou. Of ga direct aan de slag op DataCamp met onze interactieve cursus Introduction to Importing Data in Python; het eerste hoofdstuk is gratis.
Voor deze tutorial gebruiken we een eenvoudig tekstbestand: een kopie van de eerste alinea van de Wikipedia-pagina over Natural Language Processing. Dit is opgeslagen als nlp_wiki.txt. Het bevat het volgende:
"Natural language processing (NLP) is an interdisciplinary subfield of linguistics, computer science, and artificial intelligence concerned with the interactions between computers and human language, in particular how to program computers to process and analyze large amounts of natural language data. The goal is a computer capable of "understanding" the contents of documents, including the contextual nuances of the language within them. The technology can then accurately extract information and insights contained in the documents as well as categorize and organize the documents themselves. Challenges in natural language processing frequently involve speech recognition, natural-language understanding, and natural-language generation."De pandas-functie read_table() is bedoeld om door scheidingstekens begrensde tekstbestanden (bijv. een spreadsheet opgeslagen als tekstbestand, met komma’s tussen kolommen) in een dataframe te lezen. Ons tekstbestand heeft geen scheidingstekens; het is gewoon geplakte tekst. Toch kan pandas handig zijn om de inhoud snel te bekijken, omdat de syntaxis lijkt op read_csv(), waar de meeste data scientists bekend mee zijn.
Met onderstaande code lees je een tekstbestand met pandas.
pd.read_table('nlp_wiki.txt', header=None, delimiter=None)Output:
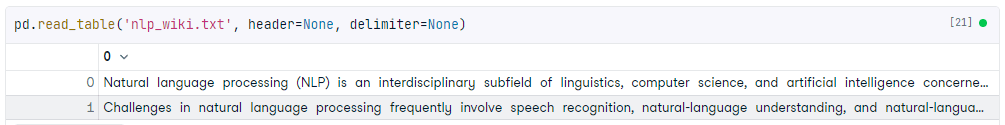
We geven de bestandsnaam mee en twee argumenten aan onze read_table()-functie.
header=None vertelt pandas dat de eerste rij tekst bevat en geen kop. delimiter=None vertelt pandas de regels niet te splitsen (behalve op nieuwe regels), zodat er één kolom is met één rij per regel.In dit geval is een DataFrame niet altijd ideaal. De alinea’s worden opgeknipt in losse regels (pandas gebruikt de newline om dit te doen) en we zien niet de volledige output. Een andere optie is de methode .to_list() op de kolom aan te roepen.
pd.read_table('nlp_wiki.txt', header=None, delimiter=None)[0].to_list()Output:
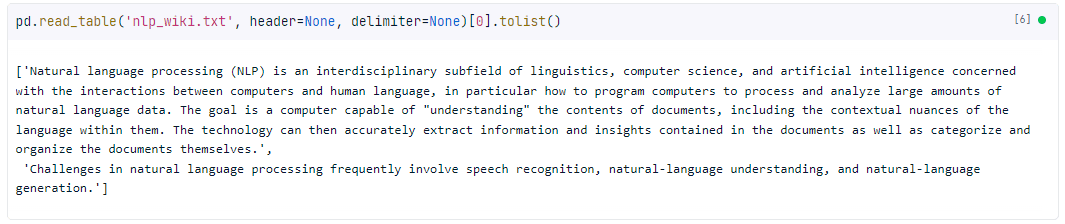
Dit retourneert een lijst van lijsten die je kunt benaderen als een normale Python-lijst. Ook wordt de volledige tekst afgedrukt.
De functie read_table() heeft veel optionele keyword-argumenten. Je vindt ze in de officiële documentatie. Hier zijn een paar van de meest nuttige:
skiprows=n
Hiermee sla je de eerste n rijen over. In ons voorbeeld sloegen we de eerste rij over.
nrows=n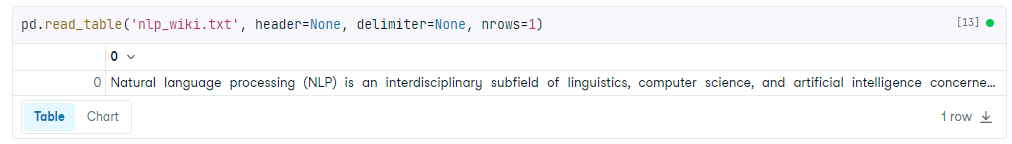
Hiermee behoud je de eerste n rijen. In ons voorbeeld hebben we de eerste rij behouden.
skip_blank_lines= True pandas slaat eventuele NaN-waarden over in plaats van een lege rij terug te geven.
NumPy’s loadtxt() is bedoeld om reeksen getallen uit een tekstbestand te lezen; het kan echter ook regels tekst inlezen. Dit is handig als je NumPy in de rest van je analyse gebruikt, omdat de output een NumPy-array is.
np.loadtxt('nlp_wiki.txt', dtype="str", delimiter="\0")Output:
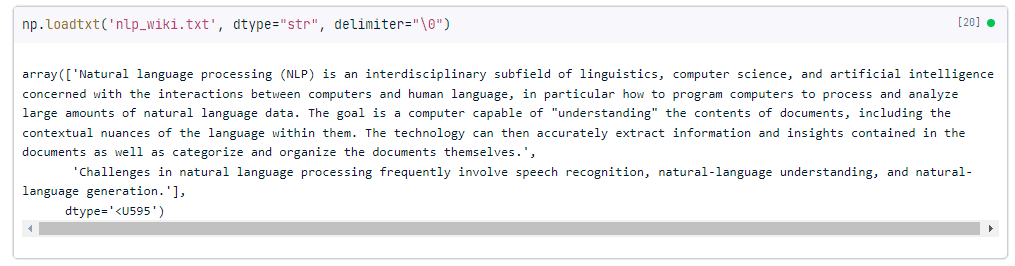
Net als in het pandas-voorbeeld geven we het delimiter-argument mee om te voorkomen dat de regels worden opgesplitst. In dit geval moet de delimiter één enkel teken zijn (None heeft een andere werking), dus gebruiken we een "nul-terminatie"-teken, \0. Omdat dit niet midden in een string kan voorkomen, betekent dit in feite: geen delimiter gebruiken.
We geven ook dtype="str" mee, wat NumPy vertelt welk datatype de resulterende array moet krijgen. In ons geval gebruiken we “str”, wat een string oplevert. Dit kan ook worden omgezet naar een lijst met de functie .tolist().
Met de ingebouwde functionaliteit van Python heb je maximale flexibiliteit. Dit is minder gebruiksvriendelijk en vooral bedoeld voor software-engineering. Voor data-analyse zijn de oplossingen met pandas of NumPy meestal voldoende.
Om open() te gebruiken, heb je ook een contextmanager nodig: het trefwoord with. Dit reserveert de resources van je computer alleen zolang de ingesprongen code onder with draait. In dit geval openen we het bestand, lopen erdoorheen en slaan het op in het geheugen in de variabele lines, en sluiten het daarna.
De for-lus hier gebruikt een list comprehension: elke regel is een regel zoals geïnterpreteerd door de functie open(), wat in dit geval een newline is (\n).
Dit codeblok gebruikt ook de functie strip(), die extra witruimte vóór en na elk object (of regel) verwijdert.
with open(filename) as file:
    lines = [line.strip() for line in file]
Output:
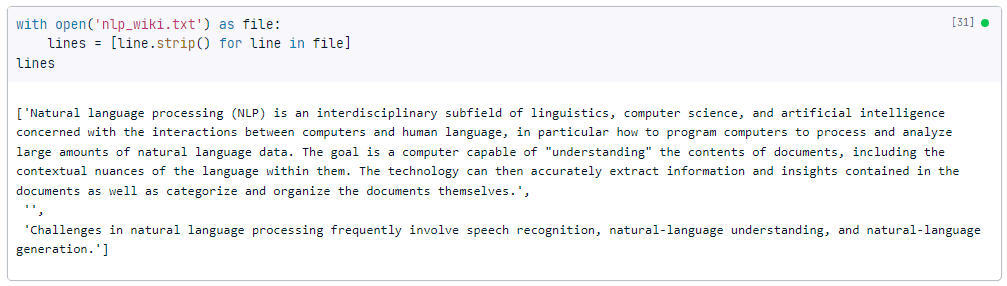
Zoals je ziet levert dit één enkele lijst op, waarbij elk item in de lijst een alinea is. In tegenstelling tot de pandas- en NumPy-voorbeelden hebben we hier drie objecten, omdat de oorspronkelijke tekst twee nieuwe regels tussen de alinea’s heeft.
Nu we hebben behandeld hoe je tekstbestanden in Python importeert, kijken we naar het schrijven van tekstbestanden. Met bestanden schrijven bedoelen we: tekstbestanden vanuit Python op je machine opslaan. Dit is vooral nuttig als je tekstbestanden in Python hebt bewerkt en de output wilt bewaren.
Je kunt tekstbestanden in Python schrijven met de ingebouwde methode write(). Dit vereist ook het gebruik van open(), en je hebt ook een contextmanager nodig: het trefwoord with. Laten we het illustreren met een voorbeeld:
with open("new_nlp_wiki.txt", "w") as file:
  file.write("New wiki entry: ChatGPT")
In dit voorbeeld openden we een bestand new_nlp_wiki.txt in schrijfmodes (het argument 'w'), wat betekent dat bestaande inhoud in het bestand wordt overschreven. Vervolgens riepen we de methode write() aan op het file-object om de string “New wiki entry: ChatGPT” naar het bestand te schrijven.
Als je tekst aan een bestaand bestand wilt toevoegen in plaats van het te overschrijven, kun je het bestand openen in append-modus (het argument 'a'):
with open("new_nlp_wiki.txt", "a") as file:
file.write("New wiki entry: ChatGPT")Waarschijnlijk is de makkelijkste manier om een tekstbestand met pandas te schrijven via de methode to_csv(). Laten we kijken hoe dat werkt!
nlp_wiki = pd.read_table("nlp_wiki.txt", header=None, delimiter=None)
nlp_wiki.to_csv("nlp_wiki_pandas.txt", sep="\t", index=False)
In de eerste regel lazen we een tekstbestand in met de methode read_table(), zoals eerder beschreven. Daarna hebben we het bestand opgeslagen met de methode to_csv() en de scheidingsteken ingesteld op een tab ('\t'), en het index-argument op False gezet om de rij-index uit de output te laten.
We hopen dat je deze tutorial leuk vond! Ter samenvatting, dit hebben we behandeld:
Python-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

