

课程
Python 中的 Gymnasium 强化学习
4 小时
13.9K
实践并学习路径你的进步。
使用 Google 继续强化学习(RL)是一种强大的机器学习范式。在 RL 中,通常称为智能体(agent)的软件通过与环境交互、在试错中解决复杂问题,无需人工干预。在众多 RL 算法中,SARSA 因其高效的“同策略”(on-policy)特性而脱颖而出。
SARSA 是 State-Action-Reward-State-Action 的缩写,代表智能体为解决问题而遵循的一个循环。这个循环让智能体能从过去的错误中学习,并且偶尔走出舒适区尝试新动作。这种行为使算法在特定类型问题上尤为有效,并将其与像 Q-learning 这样的离策略(off-policy)算法区分开来。
在本教程中,您将学习 SARSA 的工作原理及其在 Python 中的实现。为帮助您建立具体直观的理解,我们将贯穿使用经典的 Taxi Ride 问题。同时,我们还将讨论 SARSA 的优势、局限性及其在现实世界中的应用。
SARSA(State-Action-Reward-State-Action)描述了学习过程中的一连串事件。它是一种有效的方法,帮助计算机程序(智能体)在不同场景下做出良好决策。
SARSA 背后的核心思想是试错。智能体在某种情境下采取一个动作、观察结果,并根据结果(好或坏)调整策略。这个过程重复多次,使智能体的决策随着时间不断改善。
在 RL 算法中,SARSA 的特别之处在于它基于智能体实际做出的选择进行学习,包含探索新动作时的选择。这种方法在学习过程与最终结果同样重要的场景中特别有用。
这就像一个机器人通过真正骑自行车来学习骑行,包括摔倒在内,而不是靠辅助轮只为了尽快从 A 到 B。
在本教程中,我们将大量使用 Numpy 和 Gymnasium 强化学习库。Numpy 将帮助我们编写 SARSA 算法,Gymnasium 则提供内置环境用于测试我们的实现。
让我们在一个新的虚拟环境中用以下命令安装它们:
$ conda create -n sarsa python=3.9 -y
$ conda activate sarsa
$ pip install "gymnasium[atari]" numpy matplotlib
$ pip install autorom[accept-rom-license]  # Downloading Gym env data files
$ AutoROM --accept-license  # Accepting the license for data files
$ pip install ipykernel  # Install Jupyter kernel manager
$ ipython kernel install --user --name=sarsa  # Add the new Conda env to Jupyter
在继续之前,我强烈建议您阅读我们的 强化学习入门一文。它涵盖了 RL 的基本概念,如智能体、环境、探索与利用的权衡以及 Q-learning。
整个教程中,我们将使用 Gymnasium 提供的经典强化学习问题 Taxi-v3。它模拟一位出租车司机在 5x5 网格世界中接送乘客。
要加载该环境,我们使用 Gymnasium 的.make()方法,并设置rgb_array 渲染模式(以便稍后可视化环境):
import gymnasium as gym
env = gym.make('Taxi-v3', render_mode='rgb_array')
该环境是一个 5x5 网格,包含四个指定位置:红(R)、绿(G)、黄(Y)和蓝(B)。出租车从随机格子出发,必须在某个彩色位置接乘客,并将其送至另一个位置。
出租车可以向北、南、东或西移动,也可以尝试接客或下客。
下面展示如何用 Matplotlib 对环境的初始状态进行可视化:
import matplotlib.pyplot as plt
# Reset the environment to get an initial state
# Each time we reset the environment, we get a new random state
initial_state, _ = env.reset()
# Render the initial state
img = env.render()
# Create a figure and display the environment
fig, ax = plt.subplots(figsize=(8, 8))
ax.imshow(img)
# Remove axis ticks
ax.set_xticks([])
ax.set_yticks([]);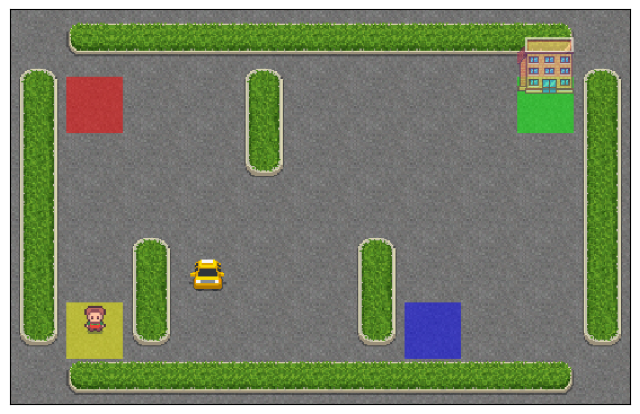
首先,我们重置环境以获得初始状态。然后用render 函数显示该初始状态,并得到一个 Numpy 图像数组。Matplotlib 的 imshow() 函数接收此数组并生成去除坐标刻度的清晰可视化图。
花点时间理解 Taxi-v3 网格世界的布局,注意出租车的位置、障碍、乘客位置以及目的地。
智能体(出租车)在成功下客时获得 +20 分。非法接客或下客将获得 -10 的奖励(惩罚)。同时,每个时间步都会产生 -1 的奖励,以鼓励尽快完成任务。
Taxi-v3 的单个回合在成功下客或达到最大步数时终止。
# The number of states and actions
n_states = env.observation_space.n
n_actions = env.action_space.n
print(n_states)
print(n_actions)
500
6环境的状态空间共有 500 个状态。每个状态由以下部分表示:
动作编码如下:
目标是让智能体学到一套最优策略,通过高效接送乘客来最大化总回报。
在编写完整算法之前,让我们先利用该环境看看“状态-动作-奖励-状态-动作”循环如何工作。
首先,我们定义要运行多少个回合。单个回合表示从初始状态开始,直到成功下客或达到最大步数为止的一次完整出租车任务。每个回合都让智能体从经验中学习并随时间改进策略。
n_episodes = 5000现在,我们编写交互循环:
for episode in range(n_episodes):
   state, _ = env.reset()
   done = False
   total_reward = 0
   steps = 0
   while not done:
       # Choose a random action
       action = env.action_space.sample()
       # Take the action and observe the result
       next_state, reward, terminated, truncated, _ = env.step(action)
       done = terminated or truncated
       # Update total reward and step count
       total_reward += reward
       steps += 1
       # Move to the next state
       state = next_state
   if episode % 1000 == 0:
       print(f"Episode {episode}, Total Reward: {total_reward}, Steps: {steps}")
Episode 0, Total Reward: -812, Steps: 200
Episode 1000, Total Reward: -830, Steps: 200
Episode 2000, Total Reward: -902, Steps: 200
Episode 3000, Total Reward: -522, Steps: 129
Episode 4000, Total Reward: -767, Steps: 200上述代码演示了基本的 SARSA 交互循环,但尚未实现任何学习算法:
env.reset()。env.step(action)。本版本使用随机动作以演示交互循环。next_state, reward, ... = env.take(action)。在上述交互循环中,出租车在环境中四处乱走并随机执行动作,直到时间步耗尽。
在继续之前,让我们实现一个功能来为交互循环制作动画。这样我们就能直观看到出租车与环境的交互过程。
制作动画的过程很简单:
env.render() 函数将环境状态捕获为图像数组。moviepy 的库,我们将所有图像数组拼接为一个 GIF。让我们修改代码:
env = gym.make("Taxi-v3", render_mode="rgb_array")
n_episodes = 1
frames = []  # for animation
for episode in range(n_episodes):
   # Reset the environment
   state, _ = env.reset()
   # Capture the state as an image
   img = env.render()
   frames.append(img)
   done = False
   total_reward = 0
   steps = 0
   while not done:
       # Choose a random action
       action = env.action_space.sample()
       # Take the action and observe the result
       next_state, reward, terminated, truncated, _ = env.step(action)
       done = terminated or truncated

       # Capture the next state as an image
       img = env.render()
       frames.append(img)
       # Update total reward and step count
       total_reward += reward
       steps += 1
       # Move to the next state
       state = next_state
此版本中,我们将回合数设为 1,因为将环境状态渲染为图像较为耗时。我们还创建了一个空列表来存储图像数组。随后交互循环与之前一致,唯一的不同是多了两行代码:将环境渲染为图像并追加到frames。
现在,frames 中应有 201 张图像(多出的那一张是额外状态):
>>> len(frames)
201让我们使用moviepy 库将这些图像合成为 GIF:
from moviepy.editor import ImageSequenceClip  # pip install moviepy
def create_gif(frames: list, filename, fps=5):
   """
   Creates a GIF animation from a list of RGBA NumPy arrays.
   Args:
       frames: A list of RGBA NumPy arrays representing the animation frames.
       filename: The output filename for the GIF animation.
       fps: The frames per second of the animation (default: 10).
   """
   clip = ImageSequenceClip(frames, fps=fps)
   clip.write_gif(filename, fps=fps)
# Example usage
create_gif(frames, "animation.gif", fps=25) # saves the GIF locally函数create_gif() 接收帧列表,并使用moviepy 的ImageSequenceClip 类将其转换为 GIF。一个重要参数是每秒帧数 fps,它控制 GIF 的时长。fps 越高,GIF 越短。
最后,我们以 25 FPS 将单个回合的帧转换为 GIF。效果如下:
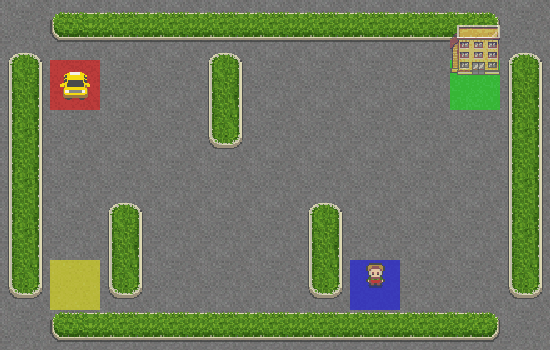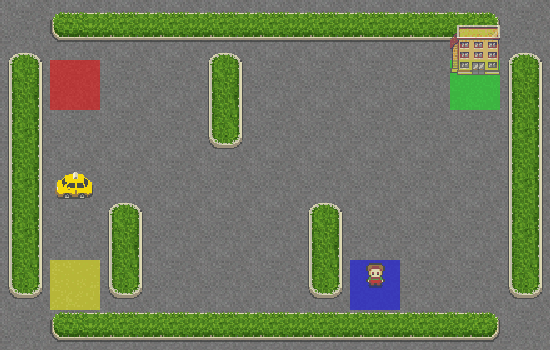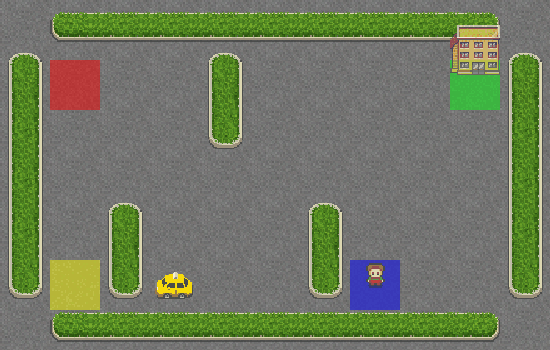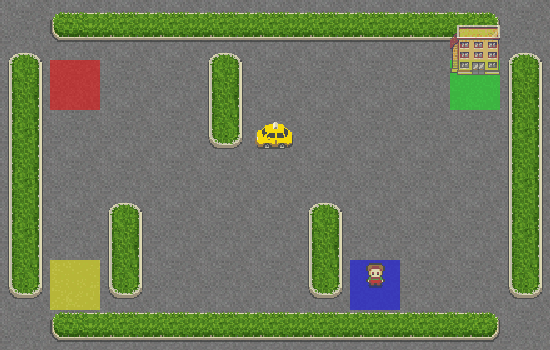
如您所见,出租车并不知道自己在做什么,甚至没有靠近乘客。让我们给它加点“脑子”,把 SARSA 加入导航系统中。
我们将从零开始构建 SARSA 的代码,帮助您清晰记忆每一步。
1. 设置 Gymnasium 环境:
import gymnasium as gym
import numpy as np
import matplotlib.pyplot as plt
# Create the Taxi environment
env = gym.make("Taxi-v3", render_mode="rgb_array")
2. 初始化 Q 表
# Initialize Q-table
n_states = env.observation_space.n
n_actions = env.action_space.n
Q_table = np.zeros((n_states, n_actions))
此步骤我们引入一个新的数据结构——Q 表。其维度为(状态数)×(动作数)。对于我们的智能体(出租车司机)来说,Q 表看起来大致如下:
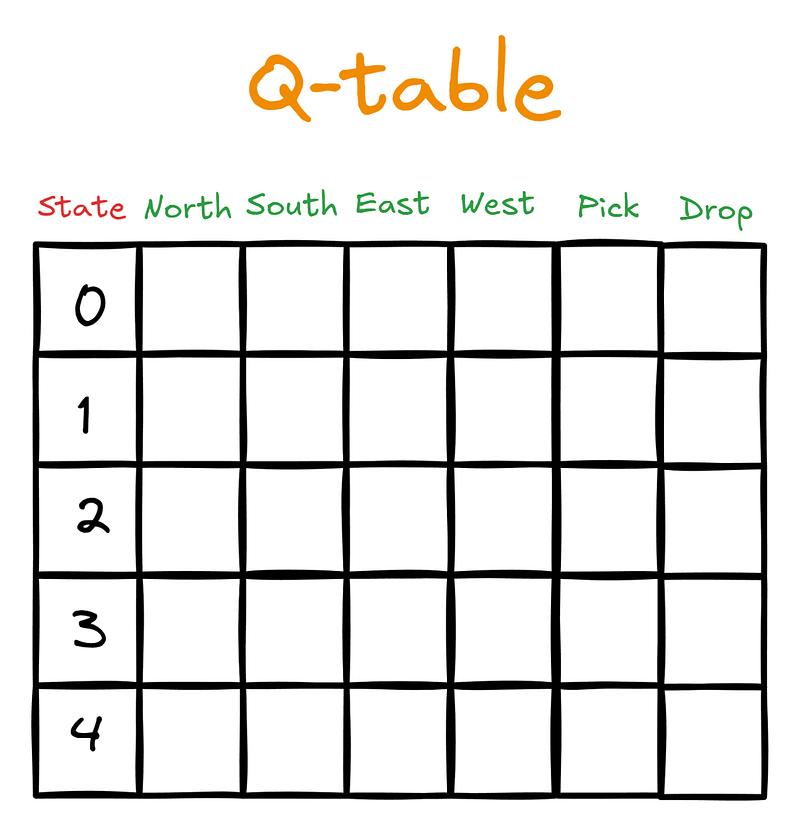
初始时,Q 表用零填充:
>>> Q_table.shape
(500, 6)
接着,当智能体在 SARSA 的指导下与环境交互时,它会用 Q 值来更新 Q 表。Q 值是一些分数,告诉智能体在当前状态下哪个动作更优。
3. 定义 SARSA 超参数
初始化 Q 表后,我们将 SARSA 的超参数设置为常用取值(稍后会详细介绍):
# SARSA parameters
alpha = 0.1  # Learning rate
gamma = 0.99  # Discount factor
epsilon = 0.1  # Exploration rate for epsilon-greedy policy
n_episodes = 20000
4. 定义用于评估表现的存储
接着,我们定义两个列表以存储性能指标:每个回合的总奖励和时间步数。智能体的目标是在尽可能少的时间内获取尽可能多的奖励:
# Lists to store performance metrics
episode_rewards = []
episode_lengths = []
5. 用于采取动作的 ε-贪心策略
在上一节中,我们的智能体没有指导——它在随机行动。我们希望通过给予司机一套 ε-贪心策略来改变这一点:
def epsilon_greedy(state, epsilon):
   if np.random.random() < epsilon:
       # Take random action - explore
       return env.action_space.sample()
   else:
       # Take action with the highest Q-value - exploit
return np.argmax(Q_table[state])该策略用于控制探索与利用之间的重要平衡。以epsilon 的概率,智能体通过采取随机动作来探索环境;以1-epsilon 的概率,它根据 Q 表选择当前 Q 值最高的动作进行利用。该方法既能帮助智能体发现潜在更优的策略,也能利用已有知识。
6. 编写 SARSA 训练循环
最后,我们编写 SARSA 训练循环。循环的开始部分我们已经熟悉。唯一的不同是,我们使用epsilon_greedy() 函数来决定在当前状态采取哪个动作:
# SARSA training loop
for episode in range(n_episodes):
   state, _ = env.reset()
   action = epsilon_greedy(state, epsilon)
   done = False
   total_reward = 0
   steps = 0
...然后,我们启动允许运行交互循环直到到达终止状态的while 循环:
# SARSA training loop
for episode in range(n_episodes):
   ...
   while not done:
       next_state, reward, terminated, truncated, _ = env.step(action)
       done = terminated or truncated
next_action = epsilon_greedy(next_state, epsilon)在while 循环中,我们执行由epsilon_greedy() 返回的动作,并接收下一个状态、该动作的奖励以及表示回合是否终止的布尔值。
接着,我们到达关键部分——SARSA 的更新规则:
# SARSA training loop
for episode in range(n_episodes):
   ...
   while not done:
       next_state, reward, terminated, truncated, _ = env.step(action)
       done = terminated or truncated
       next_action = epsilon_greedy(next_state, epsilon)
       # SARSA update rule
       Q_table[state, action] += alpha * (
           reward + gamma * Q_table[next_state, next_action] - Q_table[state, action]
       )
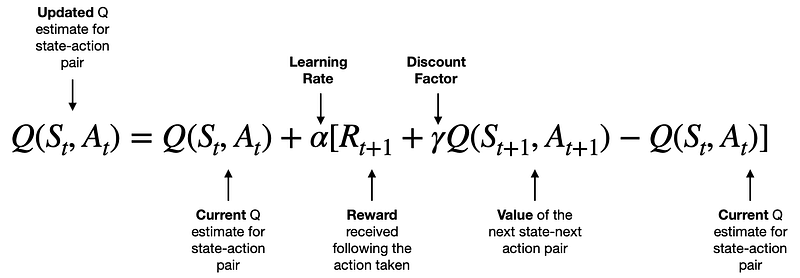
更新规则源于下列公式:
[来源]
我们将在下一节学习该公式的直观解释。现在,您可以将其视为一段数学“魔法”,它会依据 SARSA 的规则更新 Q 表中的 Q 值。
完成 Q 更新后,我们将state 和action 变量更新为结果状态与动作,将接收到的奖励加入回合总奖励,并增加时间步数。
# SARSA training loop
for episode in range(n_episodes):
   ...
   while not done:
       ...
       state = next_state
       action = next_action
       total_reward += reward
steps += 1该while 循环持续,直到达到最大步数(在出租车环境中为 200)或出租车在正确位置成功下客为止。
一旦循环终止,我们记录该回合的总奖励和长度。我们还每 1000 个回合打印一次平均回合奖励和长度:
# SARSA training loop
for episode in range(n_episodes):
   ...
   while not done:
       ...
   episode_rewards.append(total_reward)
   episode_lengths.append(steps)
   if episode % 1000 == 0:
       avg_reward = np.mean(episode_rewards[-1000:])
       avg_length = np.mean(episode_lengths[-1000:])
       print(f"Episode {episode}, Avg Reward: {avg_reward:.2f}, Avg Length: {avg_length:.2f}")
以下是完整交互循环的执行:
# SARSA training loop
for episode in range(n_episodes):
   state, _ = env.reset()
   action = epsilon_greedy(state, epsilon)
   done = False
   total_reward = 0
   steps = 0
   while not done:
       next_state, reward, terminated, truncated, _ = env.step(action)
       done = terminated or truncated
       next_action = epsilon_greedy(next_state, epsilon)
       Q_table[state, action] += alpha * (
           reward + gamma * Q_table[next_state, next_action] - Q_table[state, action]
       )
       state = next_state
       action = next_action
       total_reward += reward
       steps += 1
   episode_rewards.append(total_reward)
   episode_lengths.append(steps)
   if episode % 2000 == 0:
       avg_reward = np.mean(episode_rewards[-1000:])
       avg_length = np.mean(episode_lengths[-1000:])
       print(f"Episode {episode}, Avg Reward: {avg_reward:.2f}, Avg Length: {avg_length:.2f}")
Episode 0, Avg Reward: -551.00, Avg Length: 185.00
Episode 2000, Avg Reward: -4.37, Avg Length: 19.47
Episode 4000, Avg Reward: 1.98, Avg Length: 15.09
Episode 6000, Avg Reward: 2.29, Avg Length: 14.79
Episode 8000, Avg Reward: 2.06, Avg Length: 14.80
Episode 10000, Avg Reward: 2.16, Avg Length: 14.78
Episode 12000, Avg Reward: 2.06, Avg Length: 14.89
Episode 14000, Avg Reward: 2.33, Avg Length: 14.81
Episode 16000, Avg Reward: 2.36, Avg Length: 14.66
Episode 18000, Avg Reward: 2.53, Avg Length: 14.72从输出可以看到,随着回合数增加,每个回合的平均奖励显著上升,平均步数显著下降。
我们也可以通过绘制episode_rewards 和 episode_lengths 数组直观看到这一点:
# Plot the learning curve
plt.figure(figsize=(12, 5))
plt.subplot(1, 2, 1)
plt.plot(episode_rewards)
plt.title("Episode Rewards")
plt.xlabel("Episode")
plt.ylabel("Total Reward")
plt.subplot(1, 2, 2)
plt.plot(episode_lengths)
plt.title("Episode Lengths")
plt.xlabel("Episode")
plt.ylabel("Number of Steps")
plt.tight_layout()
plt.show()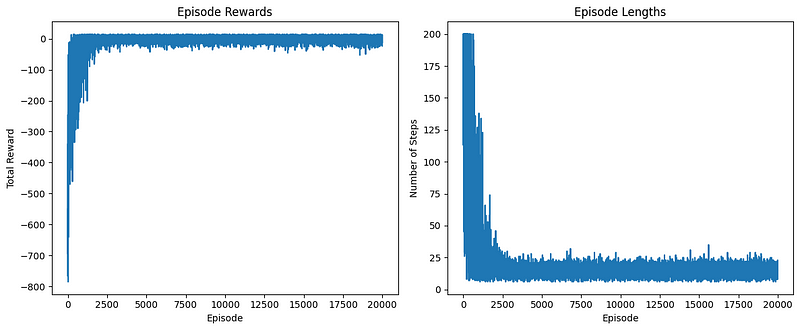
左图显示每个回合获得的总奖励。我们可以观察到:
右图显示每个回合的步数。我们可以看到:
短时间内我们已经覆盖了很多内容。现在让我们回过头,把所有代码组织起来。我们将为实现 SARSA 的各个步骤创建函数。
首先,创建环境的函数:
import gymnasium as gym
import numpy as np
import matplotlib.pyplot as plt
from moviepy.editor import ImageSequenceClip
def create_environment(env_name="Taxi-v3", render_mode="rgb_array"):
   """Create and return a Gymnasium environment."""
   return gym.make(env_name, render_mode=render_mode)
然后,给定环境初始化 Q 表的函数:
def initialize_q_table(env):
   """Initialize and return a Q-table for the given environment."""
   n_states = env.observation_space.n
   n_actions = env.action_space.n
   return np.zeros((n_states, n_actions))
接受环境、Q 表、当前状态和 epsilon 的 ε-贪心策略:
def epsilon_greedy(env, Q_table, state, epsilon=0.1):
   """Epsilon-greedy action selection."""
   if np.random.random() < epsilon:
       return env.action_space.sample()
   else:
       return np.argmax(Q_table[state])
SARSA 的更新规则函数,需要 Q 表、当前状态、该状态下采取的动作、该动作的奖励、下一个状态与下一个动作:
def sarsa_update(Q_table, state, action, reward, next_state, next_action, alpha, gamma):
   """Perform SARSA update on Q-table."""
   Q_table[state, action] += alpha * (
       reward + gamma * Q_table[next_state, next_action] - Q_table[state, action]
   )
最后,一个用 SARSA 训练智能体的大函数,它需要环境、回合数以及 alpha、gamma、epsilon 参数:
def train_sarsa(env, n_episodes=20000, alpha=0.1, gamma=0.99, epsilon=0.1):
   """Train the agent using SARSA algorithm."""
   Q_table = initialize_q_table(env)
   episode_rewards = []
   episode_lengths = []
   for episode in range(n_episodes):
       state, _ = env.reset()
       action = epsilon_greedy(env, Q_table, state, epsilon)
       done = False
       total_reward = 0
       steps = 0
       while not done:
           next_state, reward, terminated, truncated, _ = env.step(action)
           done = terminated or truncated
           next_action = epsilon_greedy(env, Q_table, next_state, epsilon)
           sarsa_update(
               Q_table, state, action, reward, next_state, next_action, alpha, gamma
           )
           state = next_state
           action = next_action
           total_reward += reward
           steps += 1
       episode_rewards.append(total_reward)
       episode_lengths.append(steps)
   return Q_table, episode_rewards, episode_lengths
另外,一个用于绘制性能指标的函数:
def plot_learning_curve(episode_rewards, episode_lengths):
   """Plot the learning curve."""
   plt.figure(figsize=(12, 5))
   plt.subplot(1, 2, 1)
   plt.plot(episode_rewards)
   plt.title("Episode Rewards")
   plt.xlabel("Episode")
   plt.ylabel("Total Reward")
   plt.subplot(1, 2, 2)
   plt.plot(episode_lengths)
   plt.title("Episode Lengths")
   plt.xlabel("Episode")
   plt.ylabel("Number of Steps")
   plt.tight_layout()
plt.show()我们之前的create_gif() 函数:
def create_gif(frames, filename, fps=5):
   """Creates a GIF animation from a list of frames."""
   clip = ImageSequenceClip(frames, fps=fps)
   clip.write_gif(filename, fps=fps)
以及另一个函数,使用完整、已学习的 Q 表渲染运行单个回合(用于动画目的):
def run_episode(env, Q_table, epsilon=0):
   """Run a single episode using the learned Q-table."""
   state, _ = env.reset()
   done = False
   total_reward = 0
   frames = [env.render()]
   while not done:
       action = epsilon_greedy(env, Q_table, state, epsilon)
       next_state, reward, terminated, truncated, _ = env.step(action)
       done = terminated or truncated
       frames.append(env.render())
       total_reward += reward
       state = next_state
   return frames, total_reward
现在,让我们运行所有代码:
if __name__ == "__main__":
   env = create_environment()

   Q_table, episode_rewards, episode_lengths = train_sarsa(env, n_episodes=20000)
   plot_learning_curve(episode_rewards, episode_lengths)

   frames, total_reward = run_episode(env, Q_table)
   create_gif(frames, "images/sarsa_final_animation.gif", fps=1)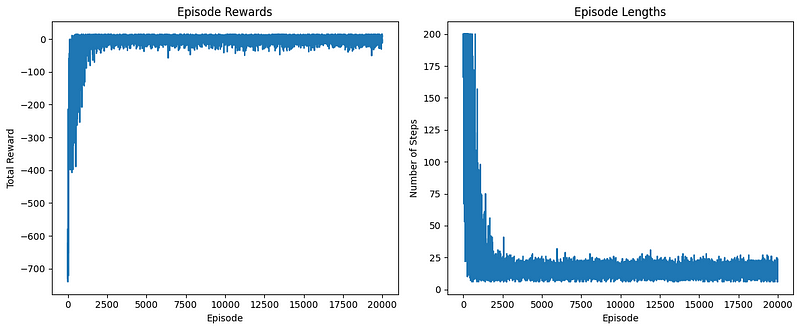
性能图看起来不错。现在,让我们看看生成的 GIF:
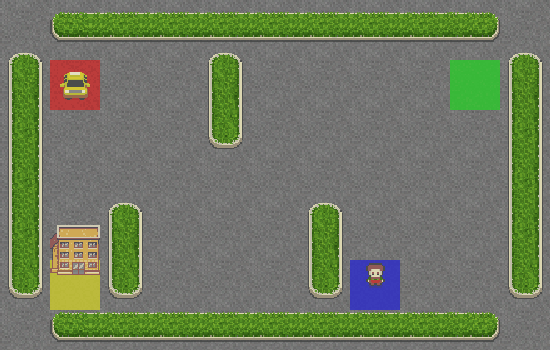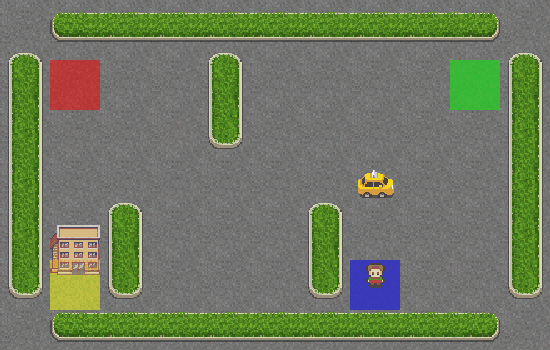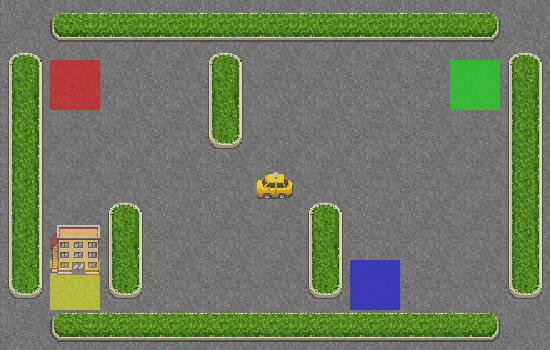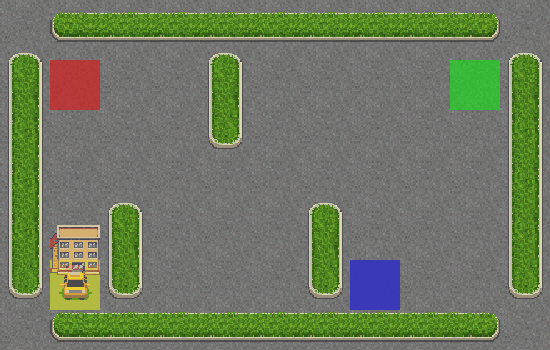
太棒了!出租车已能在蓝色方格接到乘客,并在黄色方格正确下客。
我已将 完整整理的 SARSA 实现代码粘贴到了一个 GitHub gist 中,您可随时回看。
SARSA 的核心在于其更新规则,它决定智能体如何从经验中学习。让我们分解这个规则,并探索其直觉:
Q(s, a) = Q(s, a) + α [R + γ Q(s', a') - Q(s, a)]
SARSA 的更新规则旨在根据新经验来修正智能体对环境的理解。其工作方式如下:
项 [R + γ * Q(s',a') — Q(s, a)] 被称为时序差分(TD)误差。可以将其视为“惊讶度”的度量:
该误差帮助智能体不断修正其估计,推动学习过程走向最优策略。
1. 学习率(α):
2. 折扣因子(γ):
3. 探索率(ε):
SARSA 的更新规则让智能体通过不断调整对状态-动作价值的估计,从经验中学习。每一次交互,智能体都会对环境“更懂一点”。经过大量回合,这一过程将促成用于导航环境的最优策略的形成。
通过调节超参数,我们可以控制学习过程的各个方面,使 SARSA 能适配不同的问题类型和环境。这种灵活性加上直观的更新规则,使 SARSA 成为一种强大且广泛使用的强化学习算法。
尽管 SARSA 和 Q-learning 都是广泛使用的强化学习算法,但它们存在重要差异。理解这些差异对于决定何时、如何使用各算法至关重要。
同策略算法 SARSA 学习的是其所遵循策略的价值,甚至包括探索时采取的步骤。Q-learning 是离策略的;它学习最优策略的价值——即便没有遵循该策略,也会在最终回合结束时学习到最优策略的价值。因此我们在开头提到,当学习过程本身与结果同等重要时应使用 SARSA。Q-learning 并不太在意学习过程。
关键差异在于,SARSA 使用实际采取的下一个动作(a')的 Q 值,而 Q-learning 使用下一个状态中最大 Q 值(max(Q(s',a')))。
在更新 Q 值时,SARSA 不忽略探索策略,因此更为保守。相比之下,Q-learning 总是假设智能体未来会采取最优动作,因此更为激进。
虽然两种算法最终都能达到最优策略,但在确定性环境中,Q-learning 往往学习得更快。
在探索可能导致不良后果的环境中,SARSA 通常能学到更安全的策略,因为它会考虑实际所遵循的策略。
在经典的“悬崖行走”问题中,SARSA 通常会学习远离悬崖边缘的更安全路径,而 Q-learning 可能会学到沿边缘行走的更冒险路径。
在某些随机环境中,SARSA 可能更稳定,因为它考虑了实际的下一个动作,即使该动作是次优的探索动作。
在高度随机的环境中,Q-learning 可能对学习率和探索率的选择更敏感。
在机器人或其他探索代价较高的物理系统中,我们可能更偏好同策略算法 SARSA,因为我们希望实施更安全的策略。在仿真世界、游戏或其他能获取大量反馈、希望较快且相对安全地找到最优策略的环境中,我们可能更青睐 Q-learning。
因此,您可以将 SARSA 视为更安全的一派,而 Q-learning 则更快、更激进。在实践中,往往取决于具体问题。两种算法都很强大,了解它们的差异总是有意义的。
在这份全面指南中,我们探讨了 SARSA 算法,涵盖其核心概念、实现细节,并在 Taxi-v3 环境中进行了实践应用。
要点包括:
SARSA 能学习更安全的策略,使其适用于探索代价高的真实应用场景,不过在某些情况下,它可能比像 Q-learning 这样的离策略算法收敛更慢。
请记住,选择 SARSA 还是其他算法取决于您的具体问题和环境。试验与调优是获得最佳结果的关键。
我们鼓励您在此基础上进一步探索更复杂的环境、结合函数逼近实现 SARSA,或深入研究其他强化学习算法。
以下是一些相关资源,助您深入学习:
DataCamp 精品课程
课程
课程
实践并学习路径你的进步。
使用 Google 继续