

Cours
Reinforcement Learning avec Gymnasium en Python
4 h
13.9K
S'entraîner et cursus vos progrès.
Continuer Avec GoogleL’apprentissage par renforcement (RL) est un puissant paradigme d’apprentissage automatique. En RL, un logiciel, généralement appelé agent, apprend à interagir avec des environnements pour résoudre des problèmes complexes par essais et erreurs, sans intervention humaine. Parmi les algorithmes de RL, SARSA se distingue par sa nature en ligne (on-policy) efficace.
SARSA signifie State-Action-Reward-State-Action (État-Action-Récompense-État-Action) et décrit un cycle que l’agent répète pour résoudre des problèmes. Ce cycle permet à l’agent d’apprendre de ses erreurs passées tout en explorant occasionnellement de nouvelles actions. Ce comportement rend l’algorithme particulièrement efficace pour certains types de problèmes et le différencie des algorithmes hors ligne (off-policy) comme Q-learning.
Dans ce tutoriel, vous allez découvrir le fonctionnement de SARSA et son implémentation en Python. Pour ancrer la compréhension, nous utiliserons tout au long l’exemple classique du problème du taxi. Nous aborderons aussi les atouts, les limites et des cas d’usage concrets de SARSA.
SARSA, acronyme de State-Action-Reward-State-Action, décrit une séquence d’événements dans un processus d’apprentissage. C’est une méthode efficace pour amener des programmes (agents) à prendre de bonnes décisions dans diverses situations.
L’idée centrale de SARSA repose sur l’essai-erreur. L’agent effectue une action dans une situation, observe le résultat, puis ajuste sa stratégie selon l’issue (favorable ou non). Ce processus se répète de nombreuses fois et améliore progressivement les décisions de l’agent.
La particularité de SARSA parmi les algorithmes de RL est qu’il apprend à partir des choix réellement effectués par l’agent, y compris pendant l’exploration. Cette approche est utile lorsque le parcours d’apprentissage compte autant que le résultat final.
C’est comme un robot qui apprend à faire du vélo en pratiquant réellement, chutes comprises, plutôt que de chercher simplement le plus court chemin de A à B avec des petites roues.
Dans ce tutoriel, nous utiliserons intensivement Numpy et la bibliothèque d’apprentissage par renforcement Gymnasium. Numpy nous aidera à coder l’algorithme SARSA, et Gymnasium nous fournira des environnements prêts à l’emploi pour nos tests.
Installons-les dans un nouvel environnement virtuel avec les commandes suivantes :
$ conda create -n sarsa python=3.9 -y
$ conda activate sarsa
$ pip install "gymnasium[atari]" numpy matplotlib
$ pip install autorom[accept-rom-license]  # Downloading Gym env data files
$ AutoROM --accept-license  # Accepting the license for data files
$ pip install ipykernel  # Install Jupyter kernel manager
$ ipython kernel install --user --name=sarsa  # Add the new Conda env to Jupyter
Avant de continuer, nous vous recommandons vivement de lire notre article Introduction à l’apprentissage par renforcement. Il couvre les idées fondamentales du RL : agents, environnements, dilemme exploration vs. exploitation, et Q-learning.
Tout au long du tutoriel, nous utiliserons l’environnement Taxi‑v3, un problème classique de RL fourni par la bibliothèque Gymnasium. Il simule un taxi se déplaçant dans une grille 5×5 pour prendre et déposer des passagers.
Pour charger l’environnement, nous utilisons la méthode .make() de Gymnasium avec le mode de rendu rgb_array (afin de visualiser l’environnement ensuite) :
import gymnasium as gym
env = gym.make('Taxi-v3', render_mode='rgb_array')
L’environnement est une grille 5×5 avec quatre emplacements identifiés : rouge (R), vert (G), jaune (Y) et bleu (B). Le taxi démarre sur une case aléatoire, doit récupérer un passager sur l’un des emplacements colorés et le déposer sur un autre.
Le taxi peut se déplacer vers le nord, le sud, l’est ou l’ouest et peut aussi tenter de prendre ou déposer un passager.
Voici comment visualiser l’état initial de l’environnement avec Matplotlib :
import matplotlib.pyplot as plt
# Réinitialiser l'environnement pour obtenir un état initial
# À chaque reset, on obtient un nouvel état aléatoire
initial_state, _ = env.reset()
# Rendu de l'état initial
img = env.render()
# Créer une figure et afficher l'environnement
fig, ax = plt.subplots(figsize=(8, 8))
ax.imshow(img)
# Supprimer les graduations des axes
ax.set_xticks([])
ax.set_yticks([]);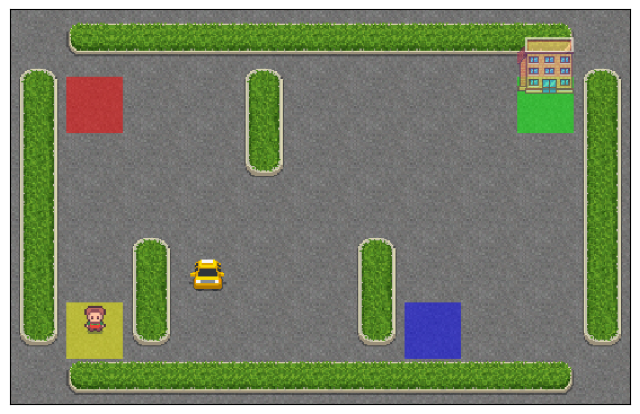
Nous réinitialisons d’abord l’environnement pour obtenir un état initial. Puis nous l’affichons avec la fonction render, qui retourne une image Numpy. La fonction imshow() de Matplotlib prend ce tableau et produit une visualisation épurée sans graduations.
Prenez un moment pour comprendre la disposition de la grille Taxi‑v3 : position du taxi, obstacles, emplacements des passagers et destination.
L’agent (le taxi) reçoit +20 points pour un dépôt réussi. Une prise en charge ou un dépôt illégal vaut −10. Par ailleurs, chaque pas de temps inflige −1 afin d’inciter le taxi à terminer la tâche rapidement.
Un épisode de Taxi‑v3 se termine soit en cas de dépôt réussi, soit lorsque le nombre maximal de pas de temps est atteint.
# Le nombre d'états et d'actions
n_states = env.observation_space.n
n_actions = env.action_space.n
print(n_states)
print(n_actions)
500
6L’espace d’états compte 500 états. Chaque état est défini par :
Les codes d’action :
L’objectif est que l’agent apprenne une politique optimale pour maximiser sa récompense totale en récupérant et déposant les passagers efficacement.
Avant d’écrire l’algorithme complet, voyons comment fonctionne le cycle État‑Action‑Récompense‑État‑Action dans notre environnement.
Commençons par définir le nombre d’épisodes. Un épisode correspond à une exécution complète de la tâche du taxi, de l’état initial jusqu’au dépôt réussi du passager ou à l’atteinte du nombre maximum de pas de temps. Chaque épisode permet à l’agent d’apprendre de son expérience et d’améliorer sa stratégie.
n_episodes = 5000Écrivons maintenant la boucle d’interaction :
for episode in range(n_episodes):
   state, _ = env.reset()
   done = False
   total_reward = 0
   steps = 0
   while not done:
       # Choose a random action
       action = env.action_space.sample()
       # Take the action and observe the result
       next_state, reward, terminated, truncated, _ = env.step(action)
       done = terminated or truncated
       # Update total reward and step count
       total_reward += reward
       steps += 1
       # Move to the next state
       state = next_state
   if episode % 1000 == 0:
       print(f"Episode {episode}, Total Reward: {total_reward}, Steps: {steps}")
Episode 0, Total Reward: -812, Steps: 200
Episode 1000, Total Reward: -830, Steps: 200
Episode 2000, Total Reward: -902, Steps: 200
Episode 3000, Total Reward: -522, Steps: 129
Episode 4000, Total Reward: -767, Steps: 200Le code ci‑dessus illustre le cycle d’interaction de base de SARSA, sans apprentissage :
env.reset().env.step(action). Ici nous utilisons des actions aléatoires pour démontrer la boucle d’interaction.next_state, reward, ... = env.take(action).Dans cette boucle, le taxi se déplace au hasard et enchaîne des actions jusqu’à épuiser les pas de temps.
Avant d’aller plus loin, ajoutons une fonctionnalité pour animer nos boucles d’interaction. Cela nous permet de visualiser le taxi en action dans l’environnement.
La création de l’animation est simple :
env.render().moviepy, nous concaténons toutes les images pour créer un GIF.Modifions le code :
env = gym.make("Taxi-v3", render_mode="rgb_array")
n_episodes = 1
frames = []  # for animation
for episode in range(n_episodes):
   # Reset the environment
   state, _ = env.reset()
   # Capture the state as an image
   img = env.render()
   frames.append(img)
   done = False
   total_reward = 0
   steps = 0
   while not done:
       # Choose a random action
       action = env.action_space.sample()
       # Take the action and observe the result
       next_state, reward, terminated, truncated, _ = env.step(action)
       done = terminated or truncated

       # Capture the next state as an image
       img = env.render()
       frames.append(img)
       # Update total reward and step count
       total_reward += reward
       steps += 1
       # Move to the next state
       state = next_state
Ici, nous limitons à un seul épisode, car le rendu d’images est coûteux. Nous créons aussi une liste vide pour stocker nos images. La boucle d’interaction reste identique, à ceci près que nous rendons l’environnement en image et l’ajoutons à frames à chaque étape.
Nous devrions maintenant avoir 201 images dans frames (une image supplémentaire pour l’état initial) :
>>> len(frames)
201
Transformons ces images en GIF avec la bibliothèque moviepy :
from moviepy.editor import ImageSequenceClip  # pip install moviepy
def create_gif(frames: list, filename, fps=5):
   """
   Creates a GIF animation from a list of RGBA NumPy arrays.
   Args:
       frames: A list of RGBA NumPy arrays representing the animation frames.
       filename: The output filename for the GIF animation.
       fps: The frames per second of the animation (default: 10).
   """
   clip = ImageSequenceClip(frames, fps=fps)
   clip.write_gif(filename, fps=fps)
# Example usage
create_gif(frames, "animation.gif", fps=25)  # saves the GIF locally
La fonction create_gif() prend une liste de frames et les convertit en GIF avec ImageSequenceClip de moviepy. Un paramètre clé est le nombre d’images par seconde, fps, qui détermine la durée du GIF : plus le fps est élevé, plus le GIF est court.
Au final, nous convertissons les frames d’un épisode en un GIF à 25 FPS. Voici le résultat :
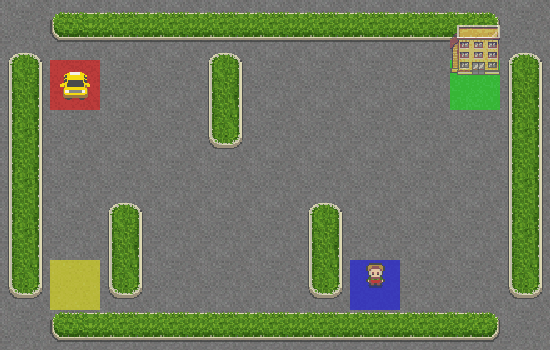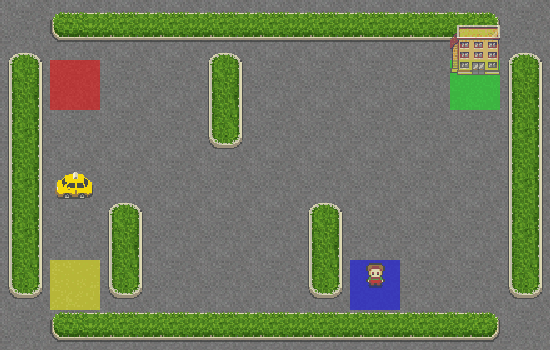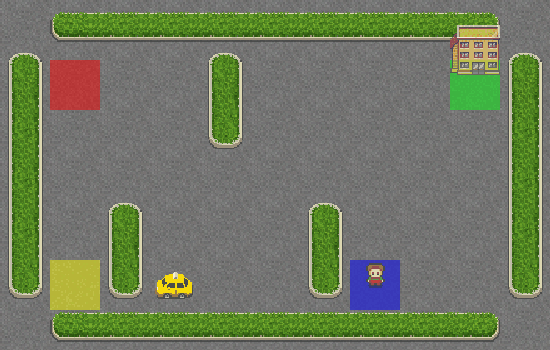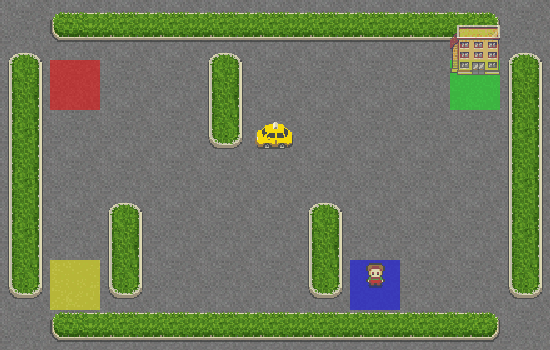
Comme vous le voyez, le taxi navigue à l’aveugle et ne s’approche même pas du passager. Donnons‑lui un peu de jugeote en ajoutant SARSA à son système de navigation.
Nous allons construire le code SARSA depuis zéro pour bien ancrer chaque étape.
1. Préparer l’environnement Gymnasium :
import gymnasium as gym
import numpy as np
import matplotlib.pyplot as plt
# Create the Taxi environment
env = gym.make("Taxi-v3", render_mode="rgb_array")
2. Initialiser une Q‑table
# Initialize Q-table
n_states = env.observation_space.n
n_actions = env.action_space.n
Q_table = np.zeros((n_states, n_actions))
Ici, nous introduisons une structure de données : la Q‑table. Elle a pour dimensions (nombre d’états) × (nombre d’actions). La table ressemble à ceci pour notre agent, le conducteur de taxi :
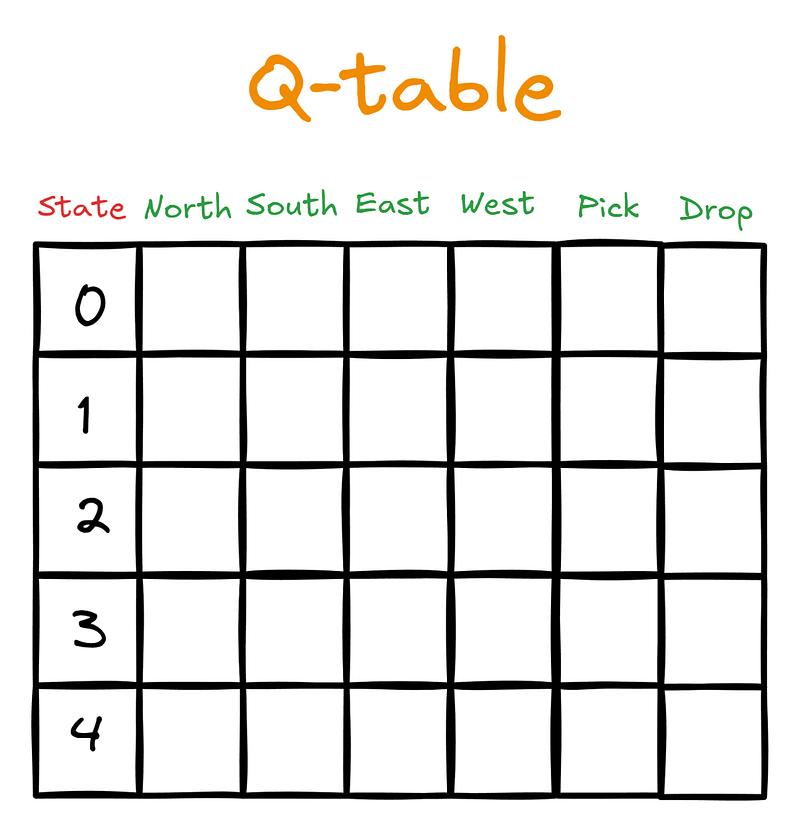
Au départ, la Q‑table est remplie de zéros :
>>> Q_table.shape
(500, 6)
Ensuite, guidé par SARSA, l’agent mettra à jour la Q‑table avec des Q‑valeurs. Ces Q‑valeurs sont des scores qui indiquent à l’agent quelle action est la meilleure à entreprendre dans l’état courant.
3. Définir les hyperparamètres de SARSA
Après l’initialisation de la Q‑table, nous fixons des valeurs courantes pour les hyperparamètres de SARSA (nous y reviendrons) :
# SARSA parameters
alpha = 0.1  # Learning rate
gamma = 0.99  # Discount factor
epsilon = 0.1  # Exploration rate for epsilon-greedy policy
n_episodes = 20000
4. Définir le stockage des métriques de performance
Nous définissons deux listes pour conserver, pour chaque épisode, la récompense totale et le nombre de pas de temps. L’objectif de l’agent est de maximiser la récompense en un minimum d’étapes :
# Lists to store performance metrics
episode_rewards = []
episode_lengths = []
5. Politique epsilon‑greedy pour choisir une action
Précédemment, notre agent agissait sans guide — il choisissait des actions aléatoires. Nous allons y remédier avec une stratégie epsilon‑greedy :
def epsilon_greedy(state, epsilon):
   if np.random.random() < epsilon:
       # Take random action - explore
       return env.action_space.sample()
   else:
       # Take action with the highest Q-value - exploit
       return np.argmax(Q_table[state])
Cette stratégie gère l’équilibre crucial entre exploration et exploitation. Avec une probabilité epsilon, l’agent explore en prenant une action aléatoire ; avec une probabilité 1-epsilon, il exploite ses connaissances actuelles en choisissant l’action de plus forte Q‑valeur. Ainsi, l’agent découvre de nouvelles stratégies potentiellement meilleures tout en capitalisant sur ce qu’il a appris.
6. Écrire la boucle d’entraînement SARSA
Enfin, écrivons la boucle d’apprentissage SARSA. Le début de la boucle vous est déjà familier. La différence : nous utilisons la fonction epsilon_greedy() pour déterminer l’action à entreprendre dans l’état courant :
# SARSA training loop
for episode in range(n_episodes):
   state, _ = env.reset()
   action = epsilon_greedy(state, epsilon)
   done = False
   total_reward = 0
   steps = 0
   ...
Nous lançons ensuite la boucle while, qui exécute le cycle d’interaction jusqu’à un état terminal :
# SARSA training loop
for episode in range(n_episodes):
   ...
   while not done:
       next_state, reward, terminated, truncated, _ = env.step(action)
       done = terminated or truncated
       next_action = epsilon_greedy(next_state, epsilon)
Dans la boucle while, nous exécutons l’action choisie par epsilon_greedy() et recevons l’état suivant, la récompense et un booléen indiquant la fin éventuelle de l’épisode.
Vient ensuite l’essentiel : la règle de mise à jour de SARSA :
# SARSA training loop
for episode in range(n_episodes):
   ...
   while not done:
       next_state, reward, terminated, truncated, _ = env.step(action)
       done = terminated or truncated
       next_action = epsilon_greedy(next_state, epsilon)
       # SARSA update rule
       Q_table[state, action] += alpha * (
           reward + gamma * Q_table[next_state, next_action] - Q_table[state, action]
       )
La règle de mise à jour découle de la formule suivante :
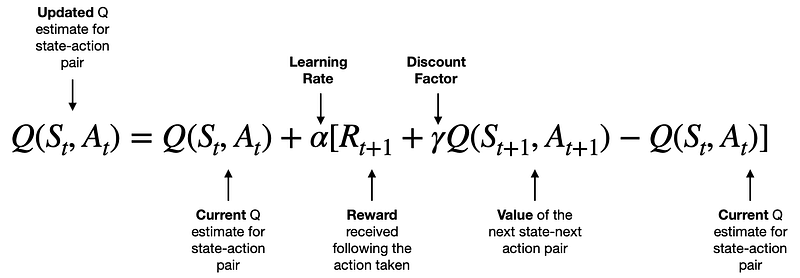
[Source]
Nous verrons l’intuition derrière cette formule dans la section suivante. Pour l’instant, considérez‑la comme une mécanique qui met à jour les Q‑valeurs de la Q‑table selon les principes de SARSA.
Une fois la mise à jour effectuée, nous remplaçons les variables state et action par l’état et l’action suivants, nous ajoutons la récompense à la somme de l’épisode et incrémentons le nombre d’étapes.
# SARSA training loop
for episode in range(n_episodes):
   ...
   while not done:
       ...
       state = next_state
       action = next_action
       total_reward += reward
       steps += 1
La boucle while continue jusqu’au nombre maximal d’étapes (200 pour l’environnement taxi) ou jusqu’au dépôt réussi du passager au bon endroit.
Une fois l’épisode terminé, nous enregistrons la récompense totale et la longueur de l’épisode. Nous affichons aussi la moyenne toutes les 1000 itérations :
# SARSA training loop
for episode in range(n_episodes):
   ...
   while not done:
       ...
   episode_rewards.append(total_reward)
   episode_lengths.append(steps)
   if episode % 1000 == 0:
       avg_reward = np.mean(episode_rewards[-1000:])
       avg_length = np.mean(episode_lengths[-1000:])
       print(f"Episode {episode}, Avg Reward: {avg_reward:.2f}, Avg Length: {avg_length:.2f}")
Voici la boucle complète exécutée :
# SARSA training loop
for episode in range(n_episodes):
   state, _ = env.reset()
   action = epsilon_greedy(state, epsilon)
   done = False
   total_reward = 0
   steps = 0
   while not done:
       next_state, reward, terminated, truncated, _ = env.step(action)
       done = terminated or truncated
       next_action = epsilon_greedy(next_state, epsilon)
       Q_table[state, action] += alpha * (
           reward + gamma * Q_table[next_state, next_action] - Q_table[state, action]
       )
       state = next_state
       action = next_action
       total_reward += reward
       steps += 1
   episode_rewards.append(total_reward)
   episode_lengths.append(steps)
   if episode % 2000 == 0:
       avg_reward = np.mean(episode_rewards[-1000:])
       avg_length = np.mean(episode_lengths[-1000:])
       print(f"Episode {episode}, Avg Reward: {avg_reward:.2f}, Avg Length: {avg_length:.2f}")
Episode 0, Avg Reward: -551.00, Avg Length: 185.00
Episode 2000, Avg Reward: -4.37, Avg Length: 19.47
Episode 4000, Avg Reward: 1.98, Avg Length: 15.09
Episode 6000, Avg Reward: 2.29, Avg Length: 14.79
Episode 8000, Avg Reward: 2.06, Avg Length: 14.80
Episode 10000, Avg Reward: 2.16, Avg Length: 14.78
Episode 12000, Avg Reward: 2.06, Avg Length: 14.89
Episode 14000, Avg Reward: 2.33, Avg Length: 14.81
Episode 16000, Avg Reward: 2.36, Avg Length: 14.66
Episode 18000, Avg Reward: 2.53, Avg Length: 14.72Comme on le voit, la récompense moyenne augmente et le nombre d’étapes par épisode diminue fortement au fil des épisodes.
Visualisons cela en traçant les tableaux episode_rewards et episode_lengths :
# Plot the learning curve
plt.figure(figsize=(12, 5))
plt.subplot(1, 2, 1)
plt.plot(episode_rewards)
plt.title("Episode Rewards")
plt.xlabel("Episode")
plt.ylabel("Total Reward")
plt.subplot(1, 2, 2)
plt.plot(episode_lengths)
plt.title("Episode Lengths")
plt.xlabel("Episode")
plt.ylabel("Number of Steps")
plt.tight_layout()
plt.show()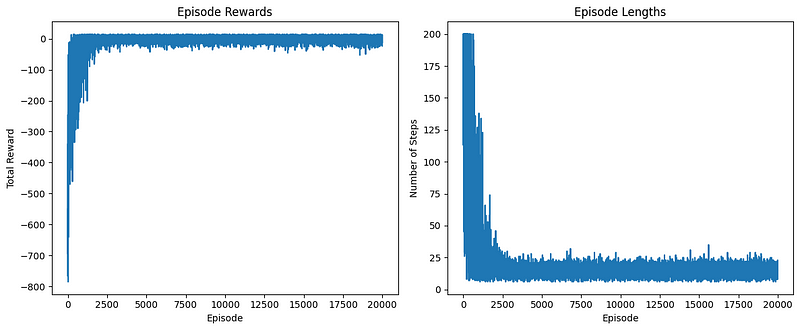
Le graphique de gauche affiche la récompense totale par épisode. On observe :
Le graphique de droite montre le nombre d’étapes par épisode. On constate :
En peu de temps, nous avons couvert beaucoup de terrain. Prenons du recul et organisons le tout. Nous allons créer des fonctions pour chaque étape de l’implémentation de SARSA.
D’abord, une fonction pour créer un environnement :
import gymnasium as gym
import numpy as np
import matplotlib.pyplot as plt
from moviepy.editor import ImageSequenceClip
def create_environment(env_name="Taxi-v3", render_mode="rgb_array"):
   """Create and return a Gymnasium environment."""
   return gym.make(env_name, render_mode=render_mode)
Ensuite, une fonction pour initialiser une Q‑table à partir d’un environnement :
def initialize_q_table(env):
   """Initialize and return a Q-table for the given environment."""
   n_states = env.observation_space.n
   n_actions = env.action_space.n
   return np.zeros((n_states, n_actions))
La stratégie epsilon‑greedy qui accepte un environnement, une Q‑table, l’état courant et epsilon :
def epsilon_greedy(env, Q_table, state, epsilon=0.1):
   """Epsilon-greedy action selection."""
   if np.random.random() < epsilon:
       return env.action_space.sample()
   else:
       return np.argmax(Q_table[state])
La règle de mise à jour de SARSA, qui requiert une Q‑table, l’état, l’action effectuée, la récompense, l’état et l’action suivants :
def sarsa_update(Q_table, state, action, reward, next_state, next_action, alpha, gamma):
   """Perform SARSA update on Q-table."""
   Q_table[state, action] += alpha * (
       reward + gamma * Q_table[next_state, next_action] - Q_table[state, action]
   )
Enfin, une fonction pour entraîner l’agent avec SARSA, qui prend l’environnement, le nombre d’épisodes, et les paramètres alpha, gamma, epsilon :
def train_sarsa(env, n_episodes=20000, alpha=0.1, gamma=0.99, epsilon=0.1):
   """Train the agent using SARSA algorithm."""
   Q_table = initialize_q_table(env)
   episode_rewards = []
   episode_lengths = []
   for episode in range(n_episodes):
       state, _ = env.reset()
       action = epsilon_greedy(env, Q_table, state, epsilon)
       done = False
       total_reward = 0
       steps = 0
       while not done:
           next_state, reward, terminated, truncated, _ = env.step(action)
           done = terminated or truncated
           next_action = epsilon_greedy(env, Q_table, next_state, epsilon)
           sarsa_update(
               Q_table, state, action, reward, next_state, next_action, alpha, gamma
           )
           state = next_state
           action = next_action
           total_reward += reward
           steps += 1
       episode_rewards.append(total_reward)
       episode_lengths.append(steps)
   return Q_table, episode_rewards, episode_lengths
Ajoutons une fonction pour tracer les métriques :
def plot_learning_curve(episode_rewards, episode_lengths):
   """Plot the learning curve."""
   plt.figure(figsize=(12, 5))
   plt.subplot(1, 2, 1)
   plt.plot(episode_rewards)
   plt.title("Episode Rewards")
   plt.xlabel("Episode")
   plt.ylabel("Total Reward")
   plt.subplot(1, 2, 2)
   plt.plot(episode_lengths)
   plt.title("Episode Lengths")
   plt.xlabel("Episode")
   plt.ylabel("Number of Steps")
   plt.tight_layout()
   plt.show()
Notre fonction create_gif() précédente :
def create_gif(frames, filename, fps=5):
   """Creates a GIF animation from a list of frames."""
   clip = ImageSequenceClip(frames, fps=fps)
   clip.write_gif(filename, fps=fps)
Et une autre fonction pour exécuter un épisode avec rendu en utilisant une Q‑table apprise (pour l’animation) :
def run_episode(env, Q_table, epsilon=0):
   """Run a single episode using the learned Q-table."""
   state, _ = env.reset()
   done = False
   total_reward = 0
   frames = [env.render()]
   while not done:
       action = epsilon_greedy(env, Q_table, state, epsilon)
       next_state, reward, terminated, truncated, _ = env.step(action)
       done = terminated or truncated
       frames.append(env.render())
       total_reward += reward
       state = next_state
   return frames, total_reward
Passons à l’exécution :
if __name__ == "__main__":
   env = create_environment()

   Q_table, episode_rewards, episode_lengths = train_sarsa(env, n_episodes=20000)
   plot_learning_curve(episode_rewards, episode_lengths)

   frames, total_reward = run_episode(env, Q_table)
   create_gif(frames, "images/sarsa_final_animation.gif", fps=1)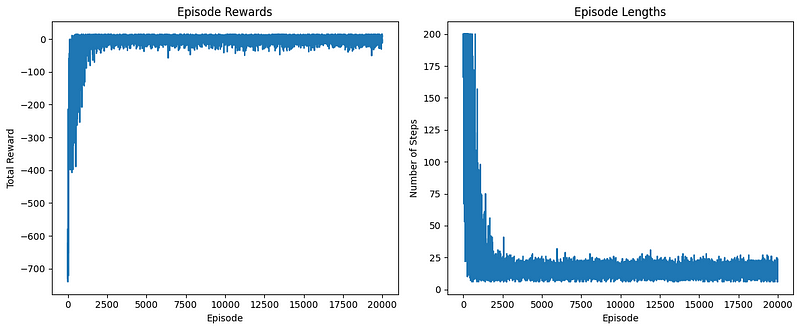
Les courbes de performance sont convaincantes. Regardons le GIF généré :
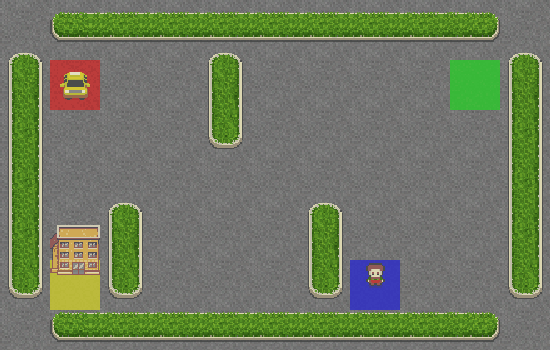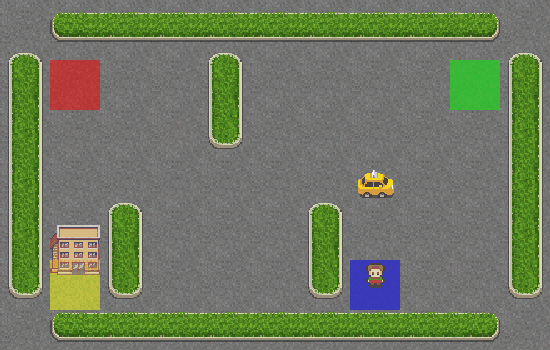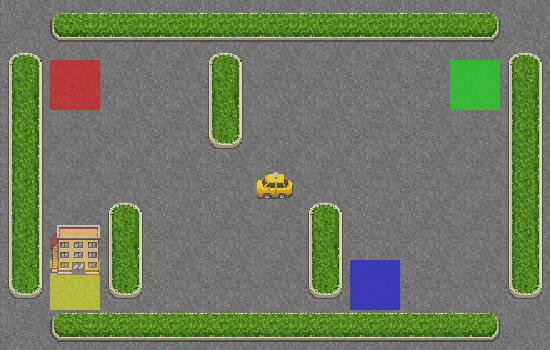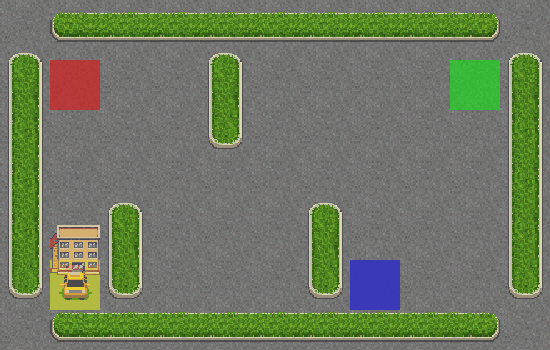
Hourra ! Le taxi prend correctement le passager sur la case bleue et le dépose sur la case jaune.
J’ai déposé le code organisé complet pour implémenter SARSA dans un gist GitHub afin que vous puissiez y revenir à tout moment.
Au cœur de SARSA se trouve sa règle de mise à jour, qui pilote l’apprentissage à partir des expériences. Décomposons‑la et explorons son intuition :
Q(s, a) = Q(s, a) + α [R + γ Q(s', a') - Q(s, a)]
La règle de SARSA affine la compréhension de l’environnement en ajustant les Q‑valeurs selon les nouvelles expériences :
Le terme [R + γ × Q(s’, a’) − Q(s, a)] est l’erreur de différence temporelle (TD). Voyez‑la comme une mesure de surprise :
Cette erreur permet à l’agent d’affiner continuellement ses estimations, le conduisant vers une politique optimale.
1. Taux d’apprentissage (α) :
2. Facteur d’actualisation (γ) :
3. Taux d’exploration (ε) :
La règle de mise à jour de SARSA permet à l’agent d’apprendre de ses interactions en ajustant en continu ses estimations des valeurs état‑action. À chaque interaction, l’agent gagne en discernement. Sur de nombreux épisodes, ce processus mène à une politique optimale pour naviguer dans l’environnement.
En ajustant les hyperparamètres, on contrôle différents aspects de l’apprentissage, ce qui rend SARSA adaptable à divers problèmes et environnements. Cette flexibilité, couplée à une règle intuitive, fait de SARSA un algorithme d’apprentissage par renforcement puissant et largement utilisé.
Même si SARSA et Q‑learning sont deux algorithmes phares du RL, ils diffèrent sur des points importants. Ces différences sont essentielles pour savoir quand et comment les utiliser.
Algorithme en ligne, SARSA apprend la valeur de la politique qu’il suit, y compris pendant l’exploration. Q‑learning est hors ligne : il apprend la valeur de la politique optimale — même sans la suivre à chaque pas, il tend vers cette valeur en fin d’épisode. C’est pourquoi nous disions que SARSA s’impose lorsque le parcours d’apprentissage compte autant que le résultat. Q‑learning se soucie moins du chemin parcouru.
La différence clé : SARSA utilise la Q‑valeur de l’action réellement entreprise ensuite (a’), tandis que Q‑learning utilise la Q‑valeur maximale de l’état suivant (max(Q(s’, a’))).
Lors des mises à jour, SARSA n’ignore pas la politique d’exploration et se montre donc plus conservateur. À l’inverse, Q‑learning suppose que l’agent prendra toujours l’action optimale à l’avenir, ce qui le rend plus agressif.
Les deux algorithmes convergent vers une politique optimale, mais Q‑learning peut apprendre plus vite, en particulier dans des environnements déterministes.
Dans des environnements où l’exploration peut entraîner de mauvaises issues, SARSA apprend généralement des politiques plus sûres, car il tient compte de la politique effectivement suivie.
Dans le problème classique du « cliff walking », SARSA apprend typiquement un chemin plus sûr, loin de la falaise, tandis que Q‑learning peut privilégier un trajet plus risqué au bord du vide.
Dans des environnements aléatoires, SARSA peut être plus stable, car il prend en compte l’action suivante réelle, même si elle est exploratoire donc sous‑optimale.
Q‑learning peut être plus sensible au choix du taux d’apprentissage et du taux d’exploration, surtout dans des environnements très stochastiques.
En robotique ou dans des systèmes physiques où l’exploration est coûteuse et où l’on souhaite des politiques plus sûres, on privilégiera l’algorithme en ligne SARSA. En simulation, dans des jeux ou d’autres contextes où le feedback est abondant et où l’on veut trouver rapidement une politique optimale de façon raisonnablement sûre, Q‑learning est souvent un excellent choix.
On peut donc voir SARSA comme l’option plus prudente, et Q‑learning comme l’approche plus rapide mais plus téméraire. En pratique, tout dépend du problème. Les deux sont très puissants ; connaître leurs différences est incontournable.
Dans ce guide complet, nous avons exploré l’algorithme SARSA : ses concepts clés, son implémentation et son application pratique avec Taxi‑v3.
À retenir :
La capacité de SARSA à apprendre des politiques plus sûres le rend pertinent lorsque les coûts d’exploration sont élevés, même s’il peut converger plus lentement que des algorithmes off‑policy comme Q‑learning selon les contextes.
Rappelez‑vous : le choix entre SARSA et d’autres algorithmes dépend de votre problème et de votre environnement. L’expérimentation et le réglage fin sont essentiels pour obtenir les meilleurs résultats.
Nous vous encourageons à aller plus loin : explorez des environnements plus complexes, implémentez SARSA avec approximation de fonction, ou découvrez d’autres algorithmes de RL.
Ressources associées :
Meilleurs cours DataCamp
Cours
Cours
S'entraîner et cursus vos progrès.
Continuer Avec GoogleTutoriel
Satyabrata Pal
15 min
Tutoriel
Laiba Siddiqui
6 min
Tutoriel
Aditya Sharma
7 min
Tutoriel
Derrick Mwiti
10 min
Tutoriel
Abid Ali Awan
7 min
Tutoriel
DataCamp Team
5 min





