
Kurs
Reinforcement Learning mit Gymnasium in Python
4 Std.
13.6K
Reinforcement Learning (RL) ist ein leistungsfähiges Paradigma des maschinellen Lernens. Im RL lernt eine Software, meist Agent genannt, durch Versuch und Irrtum ohne menschliches Eingreifen, mit Umgebungen zu interagieren und komplexe Probleme zu lösen. Unter den RL-Algorithmen fällt SARSA durch seine effiziente On-Policy-Eigenschaft besonders auf.
SARSA steht für State-Action-Reward-State-Action und beschreibt einen Zyklus, dem der Agent beim Lösen von Aufgaben folgt. Durch diesen Kreislauf kann der Agent aus vergangenen Fehlern lernen und gelegentlich Neues ausprobieren. Dieses Verhalten macht den Algorithmus für bestimmte Problemklassen besonders effektiv und unterscheidet ihn von Off-Policy-Verfahren wie Q-Learning.
In diesem Tutorial lernst du, wie SARSA funktioniert und wie du es in Python implementierst. Zur Veranschaulichung nutzen wir durchgängig das klassische Taxi-Ride-Problem. Außerdem besprechen wir Stärken, Grenzen und Praxisanwendungen von SARSA.
SARSA, kurz für State-Action-Reward-State-Action, beschreibt eine Ereignissequenz im Lernprozess. Es ist eine effektive Methode, mit der Programme (Agenten) in verschiedensten Szenarien gute Entscheidungen treffen.
Die Grundidee hinter SARSA ist Versuch und Irrtum. Der Agent führt in einer Situation eine Aktion aus, beobachtet das Ergebnis und passt seine Strategie je nach Ausgang (gut oder schlecht) an. Dieser Vorgang wiederholt sich viele Male, wodurch sich die Entscheidungen des Agenten im Laufe der Zeit verbessern.
Das Besondere an SARSA unter den RL-Algorithmen: Es lernt aus den tatsächlichen Entscheidungen des Agenten – auch dann, wenn er gerade Neues ausprobiert. Dieser Ansatz ist besonders nützlich, wenn der Lernweg genauso wichtig ist wie das Endergebnis.
Es ist wie ein Roboter, der Radfahren lernt, indem er wirklich fährt – inklusive Stürzen – statt mit Stützrädern einfach nur den kürzesten Weg von A nach B zu finden.
In diesem Tutorial nutzen wir intensiv Numpy und die Reinforcement-Learning-Bibliothek Gymnasium. Numpy hilft uns beim Schreiben des SARSA-Algorithmus, Gymnasium stellt fertige Umgebungen zum Testen bereit.
Installiere beides in einer neuen virtuellen Umgebung mit folgenden Befehlen:
$ conda create -n sarsa python=3.9 -y
$ conda activate sarsa
$ pip install "gymnasium[atari]" numpy matplotlib
$ pip install autorom[accept-rom-license]  # Downloading Gym env data files
$ AutoROM --accept-license  # Accepting the license for data files
$ pip install ipykernel  # Install Jupyter kernel manager
$ ipython kernel install --user --name=sarsa  # Add the new Conda env to Jupyter
Bevor du weitermachst, lies dir unbedingt unseren Einstieg ins Reinforcement Learning durch. Er deckt die Grundlagen von RL ab, etwa Agenten, Umgebungen, den Trade-off zwischen Exploration und Exploitation sowie Q-Learning.
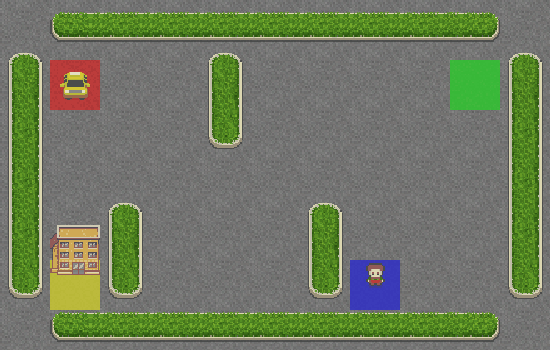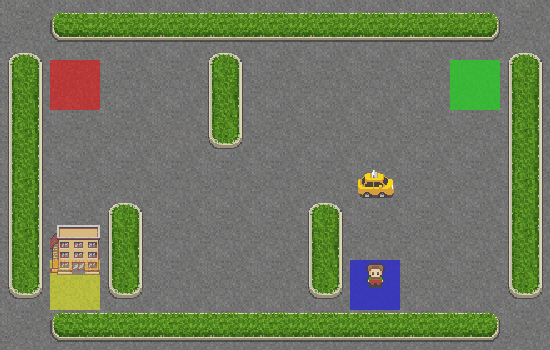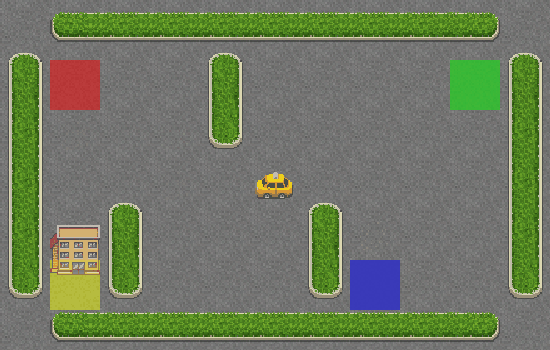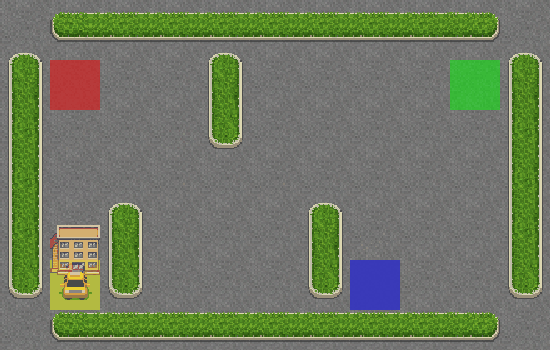
Im gesamten Tutorial verwenden wir die Umgebung Taxi-v3, ein klassisches RL-Problem aus der Gymnasium-Bibliothek. Es simuliert einen Taxifahrer, der sich in einer 5x5-Gitterwelt bewegt, um Fahrgäste aufzunehmen und abzusetzen.
Zum Laden der Umgebung nutzen wir die .make()-Methode von Gymnasium mit dem Render-Modus rgb_array (damit wir die Umgebung später visualisieren können):
import gymnasium as gym
env = gym.make('Taxi-v3', render_mode='rgb_array')
Die Umgebung ist ein 5x5-Gitter mit vier markierten Orten: rot (R), grün (G), gelb (Y) und blau (B). Das Taxi startet zufällig und muss einen Fahrgast an einem farbigen Ort aufnehmen und an einem anderen absetzen.
Das Taxi kann nach Norden, Süden, Osten oder Westen fahren sowie versuchen, einen Fahrgast aufzunehmen oder abzusetzen.
So visualisierst du den Anfangszustand der Umgebung mit Matplotlib:
import matplotlib.pyplot as plt
# Reset the environment to get an initial state
# Each time we reset the environment, we get a new random state
initial_state, _ = env.reset()
# Render the initial state
img = env.render()
# Create a figure and display the environment
fig, ax = plt.subplots(figsize=(8, 8))
ax.imshow(img)
# Remove axis ticks
ax.set_xticks([])
ax.set_yticks([]);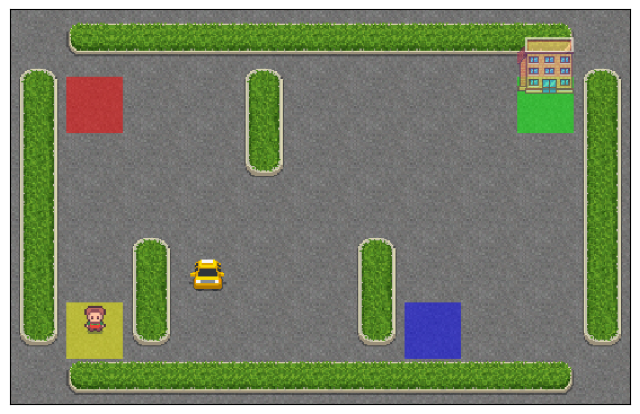
Zuerst setzen wir die Umgebung zurück und erhalten so einen Anfangszustand. Anschließend zeigen wir diesen Zustand mit der Funktion render als Numpy-Bildarray an. Matplotlibs imshow() übernimmt dieses Array und erstellt eine saubere Visualisierung ohne Achsenbeschriftung.
Nimm dir kurz Zeit, um das Layout der Taxi-v3-Gitterwelt zu verstehen: Position des Taxis, Barrieren, Fahrgastorte und Ziel.
Der Agent (das Taxi) erhält +20 Punkte für ein erfolgreiches Absetzen. Illegales Aufnehmen oder Absetzen führt zu -10. Zusätzlich kostet jeder Zeitschritt -1, um das Taxi zu zügigem Handeln zu motivieren.
Eine Episode endet entweder nach erfolgreichem Absetzen oder wenn die maximale Anzahl an Zeitschritten erreicht ist.
# The number of states and actions
n_states = env.observation_space.n
n_actions = env.action_space.n
print(n_states)
print(n_actions)
500
6Der Zustandsraum umfasst 500 Zustände. Jeder Zustand wird beschrieben durch:
Die Aktionscodes sind:
Ziel des Agenten ist es, eine optimale Policy zu erlernen, um die Gesamtbelohnung zu maximieren – also Fahrgäste effizient aufzunehmen und abzusetzen.
Bevor wir den vollständigen Algorithmus schreiben, sehen wir uns an, wie der State-Action-Reward-State-Action-Zyklus in unserer Umgebung funktioniert.
Zunächst legen wir fest, wie viele Episoden wir laufen lassen wollen. Eine Episode entspricht einem vollständigen Durchlauf der Taxi-Aufgabe – vom Anfangszustand bis zum erfolgreichen Absetzen oder bis die maximale Anzahl an Zeitschritten erreicht ist. In jeder Episode lernt der Agent aus seinen Erfahrungen und verbessert seine Strategie.
n_episodes = 5000Nun schreiben wir die Interaktionsschleife:
for episode in range(n_episodes):
   state, _ = env.reset()
   done = False
   total_reward = 0
   steps = 0
   while not done:
       # Choose a random action
       action = env.action_space.sample()
       # Take the action and observe the result
       next_state, reward, terminated, truncated, _ = env.step(action)
       done = terminated or truncated
       # Update total reward and step count
       total_reward += reward
       steps += 1
       # Move to the next state
       state = next_state
   if episode % 1000 == 0:
       print(f"Episode {episode}, Total Reward: {total_reward}, Steps: {steps}")
Episode 0, Total Reward: -812, Steps: 200
Episode 1000, Total Reward: -830, Steps: 200
Episode 2000, Total Reward: -902, Steps: 200
Episode 3000, Total Reward: -522, Steps: 129
Episode 4000, Total Reward: -767, Steps: 200Der obige Code zeigt den grundlegenden SARSA-Interaktionszyklus ohne Lernanteil:
env.reset().env.step(action). Diese Version nutzt Zufallsaktionen, um die Interaktionsschleife zu demonstrieren.next_state, reward, ... = env.take(action).In der obigen Schleife fährt das Taxi ziellos in alle Richtungen und führt zufällige Aktionen aus, bis die Zeitschritte aufgebraucht sind.
Bevor wir weitermachen, bauen wir eine kleine Animationsfunktion. So können wir das Taxi bei der Interaktion mit der Umgebung beobachten.
Die Animation zu erstellen ist simpel:
env.render().moviepy fügen wir alle Bilder zu einem GIF zusammen.Passen wir den Code an:
env = gym.make("Taxi-v3", render_mode="rgb_array")
n_episodes = 1
frames = []  # for animation
for episode in range(n_episodes):
   # Reset the environment
   state, _ = env.reset()
   # Capture the state as an image
   img = env.render()
   frames.append(img)
   done = False
   total_reward = 0
   steps = 0
   while not done:
       # Choose a random action
       action = env.action_space.sample()
       # Take the action and observe the result
       next_state, reward, terminated, truncated, _ = env.step(action)
       done = terminated or truncated

       # Capture the next state as an image
       img = env.render()
       frames.append(img)
       # Update total reward and step count
       total_reward += reward
       steps += 1
       # Move to the next state
       state = next_state
In dieser Version setzen wir die Anzahl der Episoden auf eins, da das Rendern als Bilder recht aufwendig ist. Wir legen außerdem eine leere Liste zum Speichern der Bildarrays an. Die Interaktionsschleife bleibt wie zuvor; neu sind lediglich die zwei Zeilen, in denen wir rendern und zu frames hinzufügen.
Jetzt sollten 201 Bilder in frames liegen (ein Bild extra für den Endzustand):
>>> len(frames)
201
Wandeln wir diese Bilder mit der Bibliothek moviepy in ein GIF um:
from moviepy.editor import ImageSequenceClip  # pip install moviepy
def create_gif(frames: list, filename, fps=5):
   """
   Creates a GIF animation from a list of RGBA NumPy arrays.
   Args:
       frames: A list of RGBA NumPy arrays representing the animation frames.
       filename: The output filename for the GIF animation.
       fps: The frames per second of the animation (default: 10).
   """
   clip = ImageSequenceClip(frames, fps=fps)
   clip.write_gif(filename, fps=fps)
# Example usage
create_gif(frames, "animation.gif", fps=25)  # saves the GIF locally
Die Funktion create_gif() nimmt eine Liste von Frames und erstellt daraus per ImageSequenceClip ein GIF. Ein wichtiger Parameter ist die Bildrate fps, die die Dauer des GIFs steuert: Je mehr Bilder pro Sekunde, desto kürzer wirkt das GIF.
Zum Schluss wandeln wir die Frames einer Episode mit 25 FPS in ein GIF um. So sieht das aus:
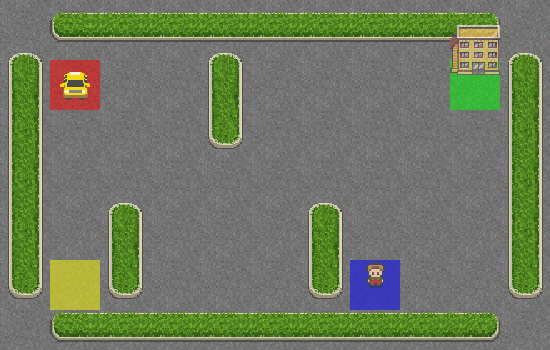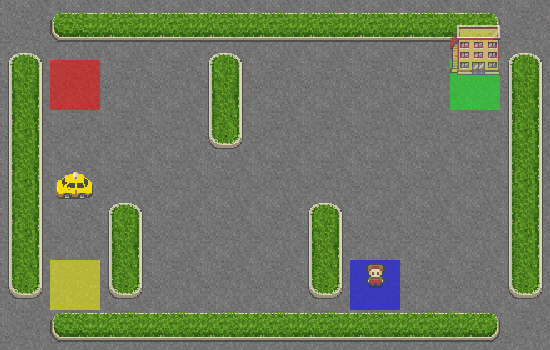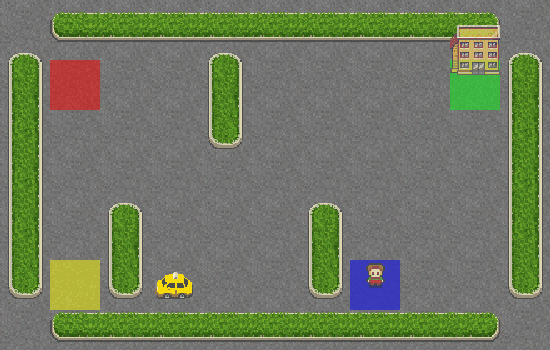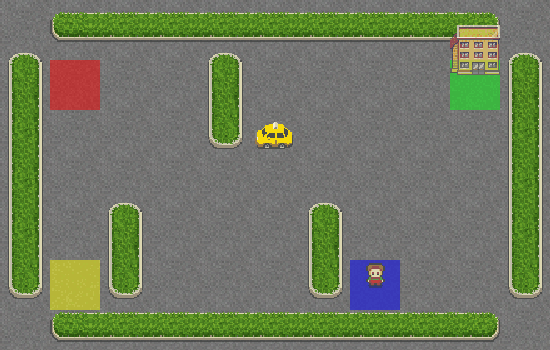
Wie du siehst, hat das Taxi keine Ahnung, was es tut, und kommt nicht einmal in die Nähe des Fahrgasts. Geben wir ihm mit SARSA etwas Verstand für die Navigation.
Wir bauen den SARSA-Code von Grund auf, damit die einzelnen Schritte klar im Kopf bleiben.
1. Gymnasium-Umgebung einrichten:
import gymnasium as gym
import numpy as np
import matplotlib.pyplot as plt
# Create the Taxi environment
env = gym.make("Taxi-v3", render_mode="rgb_array")
2. Q-Tabelle initialisieren
# Initialize Q-table
n_states = env.observation_space.n
n_actions = env.action_space.n
Q_table = np.zeros((n_states, n_actions))
Hier führen wir eine neue Datenstruktur ein – die Q-Tabelle. Sie hat die Dimensionen (Anzahl Zustände) × (Anzahl Aktionen). Für unseren Agenten, den Taxifahrer, sieht die Tabelle so aus:
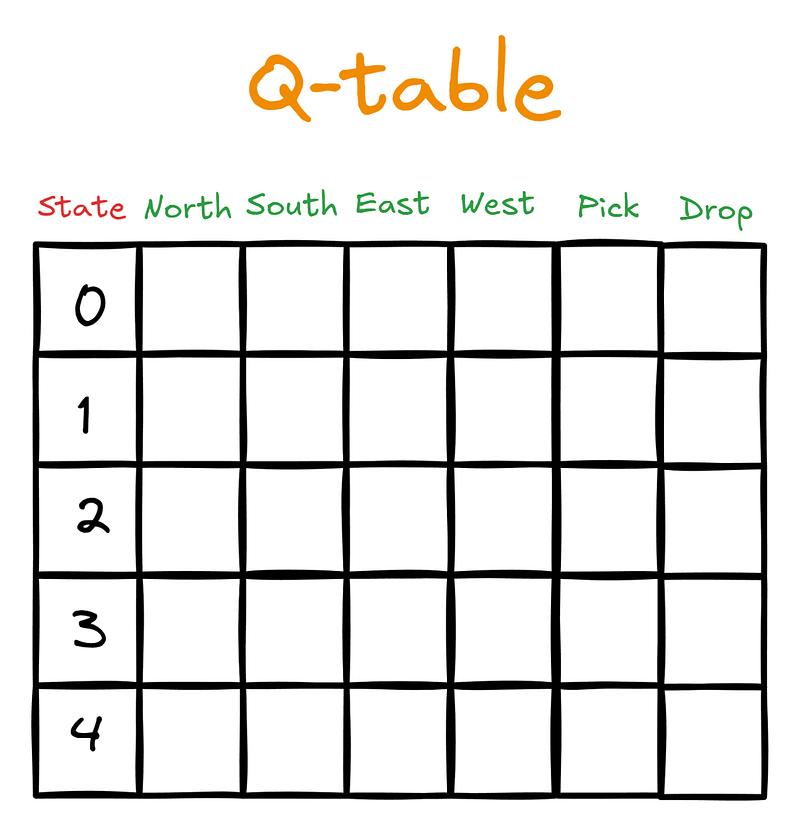
Anfangs ist die Q-Tabelle mit Nullen gefüllt:
>>> Q_table.shape
(500, 6)
Sobald der Agent mit der Umgebung interagiert – gesteuert durch SARSA – aktualisiert er die Q-Tabelle mit Q-Werten. Diese Q-Werte sind Bewertungen, die dem Agenten sagen, welche Aktion im aktuellen Zustand am besten ist.
3. SARSA-Hyperparameter definieren
Nach der Initialisierung der Q-Tabelle setzen wir die Hyperparameter von SARSA auf übliche Werte (Details dazu gleich):
# SARSA parameters
alpha = 0.1  # Learning rate
gamma = 0.99  # Discount factor
epsilon = 0.1  # Exploration rate for epsilon-greedy policy
n_episodes = 20000
4. Speicher für Performance-Metriken anlegen
Wir legen zwei Listen an, um die Performance zu speichern: Gesamtbelohnung und Anzahl Zeitschritte pro Episode. Ziel des Agenten ist: so viel Belohnung wie möglich in möglichst kurzer Zeit sammeln.
# Lists to store performance metrics
episode_rewards = []
episode_lengths = []
5. Epsilon-gierige Strategie zur Aktionswahl
Im vorherigen Abschnitt war unser Agent planlos – er hat zufällige Aktionen ausgeführt. Das ändern wir mit einer Epsilon-Greedy-Strategie:
def epsilon_greedy(state, epsilon):
   if np.random.random() < epsilon:
       # Take random action - explore
       return env.action_space.sample()
   else:
       # Take action with the highest Q-value - exploit
       return np.argmax(Q_table[state])
Diese Strategie steuert das Gleichgewicht zwischen Exploration und Exploitation. Mit Wahrscheinlichkeit epsilon erkundet der Agent die Umgebung mit einer Zufallsaktion. Mit Wahrscheinlichkeit 1-epsilon nutzt er sein aktuelles Wissen und wählt die Aktion mit dem höchsten Q-Wert. So kann der Agent neue, potenziell bessere Strategien entdecken und zugleich Erlerntes nutzen.
6. Die SARSA-Trainingsschleife schreiben
Zum Schluss schreiben wir die SARSA-Trainingsschleife. Der Anfang kommt dir bekannt vor. Der Unterschied: Wir nutzen die Funktion epsilon_greedy(), um die nächste Aktion im aktuellen Zustand zu wählen:
# SARSA training loop
for episode in range(n_episodes):
   state, _ = env.reset()
   action = epsilon_greedy(state, epsilon)
   done = False
   total_reward = 0
   steps = 0
   ...
Dann starten wir die while-Schleife, die den Interaktionszyklus bis zum Terminierungszustand laufen lässt:
# SARSA training loop
for episode in range(n_episodes):
   ...
   while not done:
       next_state, reward, terminated, truncated, _ = env.step(action)
       done = terminated or truncated
       next_action = epsilon_greedy(next_state, epsilon)
In der while-Schleife führen wir die von epsilon_greedy() zurückgegebene Aktion aus und erhalten den nächsten Zustand, die Belohnung sowie die Info, ob die Episode beendet ist.
Jetzt kommt der entscheidende Teil – die SARSA-Aktualisierungsregel:
# SARSA training loop
for episode in range(n_episodes):
   ...
   while not done:
       next_state, reward, terminated, truncated, _ = env.step(action)
       done = terminated or truncated
       next_action = epsilon_greedy(next_state, epsilon)
       # SARSA update rule
       Q_table[state, action] += alpha * (
           reward + gamma * Q_table[next_state, next_action] - Q_table[state, action]
       )
Die Aktualisierungsregel ergibt sich aus folgender Formel:
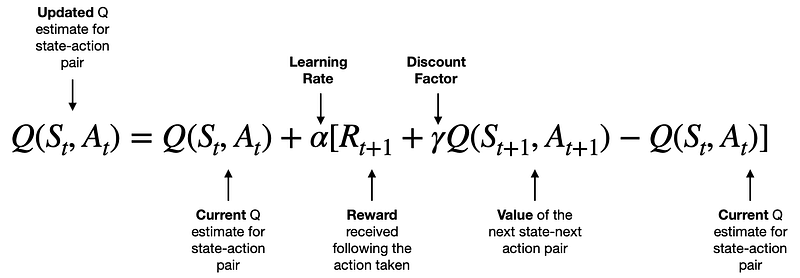
[Quelle]
Die Intuition hinter dieser Formel schauen wir uns im nächsten Abschnitt an. Für den Moment kannst du sie als „Mathe-Magie“ betrachten, die die Q-Werte in unserer Q-Tabelle gemäß den SARSA-Regeln aktualisiert.
Nach der Q-Aktualisierung setzen wir die Variablen state und action auf den resultierenden Zustand und die nächste Aktion, addieren die erhaltene Belohnung zur Episodenbelohnung und erhöhen die Schrittanzahl.
# SARSA training loop
for episode in range(n_episodes):
   ...
   while not done:
       ...
       state = next_state
       action = next_action
       total_reward += reward
       steps += 1
Die while-Schleife läuft, bis die maximale Schrittanzahl (200 in der Taxi-Umgebung) erreicht ist oder das Taxi den Fahrgast korrekt abgesetzt hat.
Nach dem Abbruch speichern wir die Gesamtbelohnung und die Episodenlänge. Alle 1000 Episoden geben wir Durchschnittswerte aus:
# SARSA training loop
for episode in range(n_episodes):
   ...
   while not done:
       ...
   episode_rewards.append(total_reward)
   episode_lengths.append(steps)
   if episode % 1000 == 0:
       avg_reward = np.mean(episode_rewards[-1000:])
       avg_length = np.mean(episode_lengths[-1000:])
       print(f"Episode {episode}, Avg Reward: {avg_reward:.2f}, Avg Length: {avg_length:.2f}")
Hier ist die vollständige Interaktionsschleife im Einsatz:
# SARSA training loop
for episode in range(n_episodes):
   state, _ = env.reset()
   action = epsilon_greedy(state, epsilon)
   done = False
   total_reward = 0
   steps = 0
   while not done:
       next_state, reward, terminated, truncated, _ = env.step(action)
       done = terminated or truncated
       next_action = epsilon_greedy(next_state, epsilon)
       Q_table[state, action] += alpha * (
           reward + gamma * Q_table[next_state, next_action] - Q_table[state, action]
       )
       state = next_state
       action = next_action
       total_reward += reward
       steps += 1
   episode_rewards.append(total_reward)
   episode_lengths.append(steps)
   if episode % 2000 == 0:
       avg_reward = np.mean(episode_rewards[-1000:])
       avg_length = np.mean(episode_lengths[-1000:])
       print(f"Episode {episode}, Avg Reward: {avg_reward:.2f}, Avg Length: {avg_length:.2f}")
Episode 0, Avg Reward: -551.00, Avg Length: 185.00
Episode 2000, Avg Reward: -4.37, Avg Length: 19.47
Episode 4000, Avg Reward: 1.98, Avg Length: 15.09
Episode 6000, Avg Reward: 2.29, Avg Length: 14.79
Episode 8000, Avg Reward: 2.06, Avg Length: 14.80
Episode 10000, Avg Reward: 2.16, Avg Length: 14.78
Episode 12000, Avg Reward: 2.06, Avg Length: 14.89
Episode 14000, Avg Reward: 2.33, Avg Length: 14.81
Episode 16000, Avg Reward: 2.36, Avg Length: 14.66
Episode 18000, Avg Reward: 2.53, Avg Length: 14.72Wie die Ausgabe zeigt, steigen die durchschnittlichen Belohnungen deutlich, und die Schrittzahlen pro Episode sinken stark, je mehr Episoden wir laufen lassen.
Das lässt sich auch visuell zeigen, indem wir episode_rewards und episode_lengths plotten:
# Plot the learning curve
plt.figure(figsize=(12, 5))
plt.subplot(1, 2, 1)
plt.plot(episode_rewards)
plt.title("Episode Rewards")
plt.xlabel("Episode")
plt.ylabel("Total Reward")
plt.subplot(1, 2, 2)
plt.plot(episode_lengths)
plt.title("Episode Lengths")
plt.xlabel("Episode")
plt.ylabel("Number of Steps")
plt.tight_layout()
plt.show()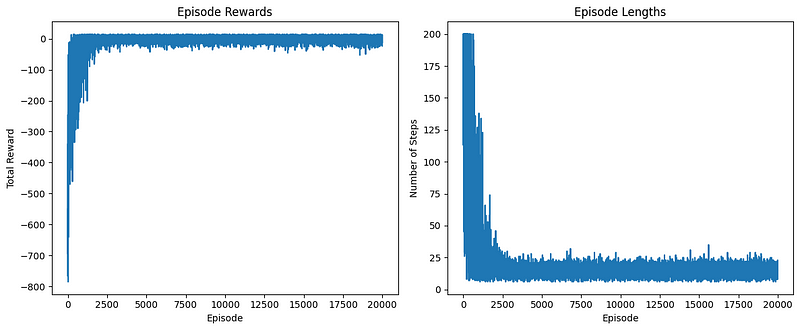
Der linke Plot zeigt die Gesamtbelohnung pro Episode. Wir sehen:
Der rechte Plot zeigt die Anzahl der Schritte pro Episode. Wir erkennen:
In kurzer Zeit haben wir viel aufgebaut. Gehen wir nun einen Schritt zurück und strukturieren alles. Wir erstellen Funktionen für jeden Schritt der SARSA-Implementierung.
Zuerst eine Funktion zum Erstellen einer Umgebung:
import gymnasium as gym
import numpy as np
import matplotlib.pyplot as plt
from moviepy.editor import ImageSequenceClip
def create_environment(env_name="Taxi-v3", render_mode="rgb_array"):
   """Create and return a Gymnasium environment."""
   return gym.make(env_name, render_mode=render_mode)
Dann eine Funktion zum Initialisieren der Q-Tabelle für eine gegebene Umgebung:
def initialize_q_table(env):
   """Initialize and return a Q-table for the given environment."""
   n_states = env.observation_space.n
   n_actions = env.action_space.n
   return np.zeros((n_states, n_actions))
Die Epsilon-gierige Strategie, die Umgebung, Q-Tabelle, aktuellen Zustand und Epsilon entgegennimmt:
def epsilon_greedy(env, Q_table, state, epsilon=0.1):
   """Epsilon-greedy action selection."""
   if np.random.random() < epsilon:
       return env.action_space.sample()
   else:
       return np.argmax(Q_table[state])
SARSA-Aktualisierungsregel, die Q-Tabelle, aktuellen Zustand, gewählte Aktion, Belohnung, nächsten Zustand und nächste Aktion benötigt:
def sarsa_update(Q_table, state, action, reward, next_state, next_action, alpha, gamma):
   """Perform SARSA update on Q-table."""
   Q_table[state, action] += alpha * (
       reward + gamma * Q_table[next_state, next_action] - Q_table[state, action]
   )
Schließlich eine größere Funktion, um den Agenten mit SARSA zu trainieren. Erforderlich sind Umgebung, Episodenanzahl sowie die Parameter alpha, gamma und epsilon:
def train_sarsa(env, n_episodes=20000, alpha=0.1, gamma=0.99, epsilon=0.1):
   """Train the agent using SARSA algorithm."""
   Q_table = initialize_q_table(env)
   episode_rewards = []
   episode_lengths = []
   for episode in range(n_episodes):
       state, _ = env.reset()
       action = epsilon_greedy(env, Q_table, state, epsilon)
       done = False
       total_reward = 0
       steps = 0
       while not done:
           next_state, reward, terminated, truncated, _ = env.step(action)
           done = terminated or truncated
           next_action = epsilon_greedy(env, Q_table, next_state, epsilon)
           sarsa_update(
               Q_table, state, action, reward, next_state, next_action, alpha, gamma
           )
           state = next_state
           action = next_action
           total_reward += reward
           steps += 1
       episode_rewards.append(total_reward)
       episode_lengths.append(steps)
   return Q_table, episode_rewards, episode_lengths
Außerdem eine Funktion, um die Performance-Metriken zu plotten:
def plot_learning_curve(episode_rewards, episode_lengths):
   """Plot the learning curve."""
   plt.figure(figsize=(12, 5))
   plt.subplot(1, 2, 1)
   plt.plot(episode_rewards)
   plt.title("Episode Rewards")
   plt.xlabel("Episode")
   plt.ylabel("Total Reward")
   plt.subplot(1, 2, 2)
   plt.plot(episode_lengths)
   plt.title("Episode Lengths")
   plt.xlabel("Episode")
   plt.ylabel("Number of Steps")
   plt.tight_layout()
   plt.show()
Unsere zuvor definierte Funktion create_gif():
def create_gif(frames, filename, fps=5):
   """Creates a GIF animation from a list of frames."""
   clip = ImageSequenceClip(frames, fps=fps)
   clip.write_gif(filename, fps=fps)
Und eine weitere Funktion, um eine einzelne Episode mit einer gelernten Q-Tabelle zu rendern (für die Animation):
def run_episode(env, Q_table, epsilon=0):
   """Run a single episode using the learned Q-table."""
   state, _ = env.reset()
   done = False
   total_reward = 0
   frames = [env.render()]
   while not done:
       action = epsilon_greedy(env, Q_table, state, epsilon)
       next_state, reward, terminated, truncated, _ = env.step(action)
       done = terminated or truncated
       frames.append(env.render())
       total_reward += reward
       state = next_state
   return frames, total_reward
Führen wir jetzt alles aus:
if __name__ == "__main__":
   env = create_environment()

   Q_table, episode_rewards, episode_lengths = train_sarsa(env, n_episodes=20000)
   plot_learning_curve(episode_rewards, episode_lengths)

   frames, total_reward = run_episode(env, Q_table)
   create_gif(frames, "images/sarsa_final_animation.gif", fps=1)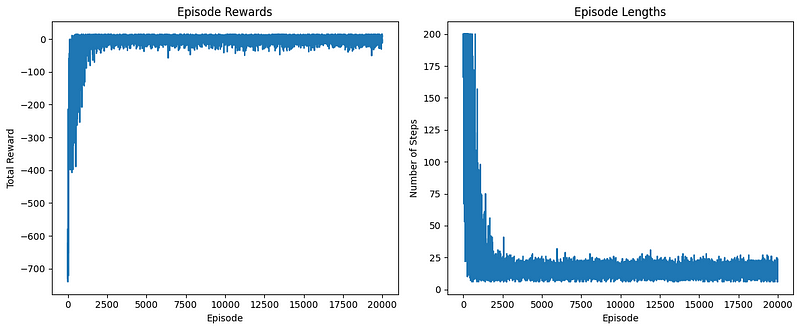
Die Performance-Plots sehen gut aus. Schauen wir uns nun das erzeugte GIF an:
Juhu! Das Taxi nimmt den Fahrgast am blauen Quadrat korrekt auf und setzt ihn am gelben Quadrat ab.
Ich habe den kompletten, strukturierten SARSA-Code in ein GitHub-Gist gepackt, damit du jederzeit darauf zurückgreifen kannst.
Im Kern von SARSA steht die Aktualisierungsregel, die steuert, wie der Agent aus Erfahrungen lernt. Zerlegen wir sie und schauen uns die Intuition dahinter an:
Q(s, a) = Q(s, a) + α [R + γ Q(s', a') - Q(s, a)]
Die Aktualisierungsregel verfeinert das Verständnis des Agenten, indem Q-Werte anhand neuer Erfahrungen angepasst werden. Konkret:
Der Term [R + γ · Q(s’, a’) − Q(s, a)] ist der Temporal-Difference-(TD)-Fehler. Du kannst ihn dir als Überraschungsmaß vorstellen:
Dieser Fehler hilft dem Agenten, seine Schätzungen kontinuierlich zu verfeinern – der Motor auf dem Weg zu einer optimalen Policy.
1. Lernrate (α):
2. Diskontfaktor (γ):
3. Explorationsrate (ε):
Die SARSA-Regel lässt den Agenten aus Erfahrungen lernen, indem sie die Schätzer für Zustands-Aktions-Werte laufend anpasst. Mit jeder Interaktion wird der Agent ein Stückchen „klüger“ über seine Umgebung. Über viele Episoden hinweg entsteht so eine optimale Policy für die Navigation in der Umgebung.
Durch das Tuning der Hyperparameter kannst du den Lernprozess steuern und SARSA an verschiedenste Probleme und Umgebungen anpassen. Diese Flexibilität und die intuitive Aktualisierungsregel machen SARSA zu einem starken und weit verbreiteten RL-Algorithmus.
Obwohl SARSA und Q-Learning weit verbreitet sind, gibt es wichtige Unterschiede – und die sind entscheidend, um zu wissen, wann welcher Algorithmus passt.
SARSA ist On-Policy und lernt den Wert der tatsächlich verfolgten Policy – inklusive der Schritte während der Exploration. Q-Learning ist Off-Policy; es lernt den Wert der optimalen Policy, selbst wenn es ihr aktuell nicht folgt, und zieht letztlich den Optimalwert am Episodenende heran. Darum sagten wir eingangs: SARSA eignet sich, wenn der Lernweg genauso wichtig ist wie das Ergebnis. Q-Learning kümmert sich weniger um den Weg dorthin.
Der Schlüsselunterschied: SARSA nutzt den Q-Wert der tatsächlich gewählten nächsten Aktion (a’), während Q-Learning den maximalen Q-Wert des nächsten Zustands (max(Q(s’, a’))) verwendet.
SARSA ignoriert die Explorationspolicy beim Updaten nicht und ist daher konservativer. Q-Learning nimmt künftig stets die optimale Aktion an und ist dadurch aggressiver.
Beide Algorithmen konvergieren letztlich zur optimalen Policy, Q-Learning lernt jedoch in deterministischen Umgebungen oft schneller.
Wo Exploration riskant ist, lernt SARSA tendenziell sicherere Policies, da es die tatsächlich befolgte Policy berücksichtigt.
Im klassischen „Cliff-Walking“-Problem meidet SARSA meist die Klippenkante, während Q-Learning einen riskanteren Weg an der Kante entlang wählt.
In stochastischen Umgebungen kann SARSA stabiler sein, da es die tatsächliche nächste Aktion berücksichtigt – auch wenn sie explorativ und suboptimal ist.
Q-Learning reagiert oft empfindlicher auf Lernrate und Explorationsrate, vor allem bei hoher Stochastik.
In Robotik oder anderen physischen Systemen, wo Exploration teuer ist und wir sicherere Policies bevorzugen, bietet sich der On-Policy-Ansatz SARSA an. In simulierten Welten, Spielen oder anderen Umgebungen mit viel Feedback, in denen wir schnell und ausreichend sicher zur optimalen Policy finden wollen, gefällt Q-Learning oft besser.
Du kannst dir SARSA also als die „sicherere“ Variante und Q-Learning als schnelleren, risikofreudigeren Ansatz vorstellen. In der Praxis hängt es jedoch vom konkreten Problem ab. Beide sind starke Algorithmen – es lohnt sich, ihre Unterschiede zu kennen.
In diesem umfassenden Guide hast du den SARSA-Algorithmus kennengelernt – von den Kernideen über die Implementierung bis hin zu praktischen Anwendungen im Taxi-v3-Environment.
Die wichtigsten Punkte:
Da SARSA sicherere Policies erlernt, eignet es sich für reale Anwendungen mit hohen Explorationskosten. In manchen Szenarien konvergiert es jedoch langsamer als Off-Policy-Methoden wie Q-Learning.
Welche Methode du wählst, hängt von deinem konkreten Problem und der Umgebung ab. Experimentiere und tune die Hyperparameter, um optimale Ergebnisse zu erzielen.
Baue auf dieser Grundlage auf: Erkunde komplexere Umgebungen, implementiere SARSA mit Funktionsapproximation oder tauche in andere RL-Algorithmen ein.
Hier sind verwandte Ressourcen, die dir weiterhelfen:
Top-DataCamp-Kurse
Kurs
Kurs
Lernpfad