
课程
Python 统计学入门
4 小时
200.6K
离群值常常会误导您的洞察,让本应有意义的分析走向错误的结论。现实世界中的数据难免不完美且含噪,温莎化是一种切实可行的方法,在不丢弃任何数据的前提下,降低离群值的影响。
本文将介绍温莎化均值的工作原理、实际应用场景,以及如何用 Python 计算它的步骤。我们还将了解其优缺点,与修剪均值等其他实用度量进行比较,并探讨其他温莎化统计量。
温莎化均值是一种统计度量,通过将极端值替换为较不极端的百分位值来降低离群值的影响,而不是将其完全移除。 不同于对所有数据点一视同仁的算术平均,温莎化均值限制了可能扭曲整体结果的极端值的影响。
温莎化通过对超过某个百分位阈值的数值进行截顶或替换来实现。例如,在 5% 温莎化中,最低的 5% 数据点被替换为第 5 百分位的值,最高的 5% 被替换为第 95 百分位的值。 这种方法在降低离群值影响的同时,有助于保留数据集的整体结构,使其在包含极端值的数据集中成为标准均值的稳健替代方案。
在统计分析中,温莎化均值在数据容易出现偏态分布的领域尤为有用。以下是一些关键领域:
在以上各类应用中,温莎化均值都是标准均值的稳健替代方案,使分析者在保留重要数据模式的同时,获得更少受离群值影响的洞察。
在 Python 中计算温莎化均值涉及将极端值(离群值)替换为特定百分位的值。开始之前,先快速概览一下步骤:
导入所需的库和数据集。
温莎化数据集,使用scipy.winsorize()。
计算均值,使用numpy.mean()。
下面通过一个示例来具体说明。
首先,导入计算均值所需的库。
import numpy as np
from scipy.stats.mstats import winsorize
接着加载数据集,可以来自 CSV 文件或其他数据源。为简化示例,我们将使用numpy创建一个样本数据集。
data = np.array([10, 12, 14, 15, 16, 18, 20, 22, 24, 25, 30, 35, 40, 45, 50, 60, 70, 80, 82, 85, 90, 200])基于初步分析,200在该数据集中可能被视为离群值。
scipy库中的winsorize()函数允许您指定从上下尾部各温莎化的百分比。 代码如下:
# Winsorize 5% from both the lower and upper tails
winsorized_data = winsorize(data, limits=[0.05, 0.05])在上述代码中,传入winsorize()函数的参数limits=[0.05, 0.05]会将最小的 5% 和最大的 5% 数值分别替换为第 5 和第 95 百分位的值。 我们现在可以查看生成的温莎化数据。
print("Original data: ", data)
print("Winsorized data: ", winsorized_data)
输出将显示离群值已被替换:
Original data: [ 10 12 14 15 16 18 20 22 24 25 30 35 40 45 50 60 70 80 82 90 200]
Winsorized data: [ 12 12 14 15 16 18 20 22 24 25 30 35 40 45 50 60 70 80 82 90 90]这里,最大值200被替换为90;类似地,较低端的极端值10被替换为12。
最后,计算温莎化数据的均值:
winsorized_mean = np.mean(winsorized_data)
print("Winsorized mean: ", winsorized_mean)
输出如下:
Winsorized mean: 42.5与常规均值相比,温莎化均值降低了极高值的影响。作为对比,我们可以如下计算原始均值:
original_mean = np.mean(data)
print("Original mean: ", original_mean)
输出如下:
Original mean: 47.40909090909091原始均值47.40受到离群值的强烈影响而显著偏高。对极端值进行温莎化后,温莎化均值降至42.5,极端值的影响更小。
温莎化均值和修剪均值都是用于降低离群值对均值影响的统计方法,但它们处理极端值的方式不同:
当您希望保留数据结构(即保持样本量不变)但仍要降低极端值影响时,优先考虑温莎化均值;当数据集中存在明确的离群值需要完全移除,且接受修剪后样本量变小的情况时,修剪均值更合适。
让我们看看两种方法如何影响数据集,并比较它们的结果。
from scipy.stats import trim_mean

# Calculate the Trimmed mean by removing 5% from both tails
trimmed_mean = trim_mean(data, proportiontocut=0.05)

# Print the results
print("Original mean: ", np.mean(data))
print("Winsorized mean (5%): ", winsorized_mean)
print("Trimmed mean (5%): ", trimmed_mean)
输出如下:
Original mean: 47.40909090909091
Winsorized mean (5%): 42.5
Trimmed mean (5%): 41.65原始均值为47.4,受离群值影响较大。温莎化均值42.5是在将离群值替换为较不极端的值后得到的。修剪均值在完全移除离群值后为41.65。
当您想保留所有数据点但减少极端值影响时,请使用温莎化均值。这是一条不错的经验法则:当您认为离群值是真实存在但希望尽量降低其影响时,温莎化均值很有用。
当您希望将离群值彻底从数据集中移除时,请使用修剪均值。若您怀疑离群值是错误的或不具代表性,修剪均值更合适。
关键差异可汇总如下表:
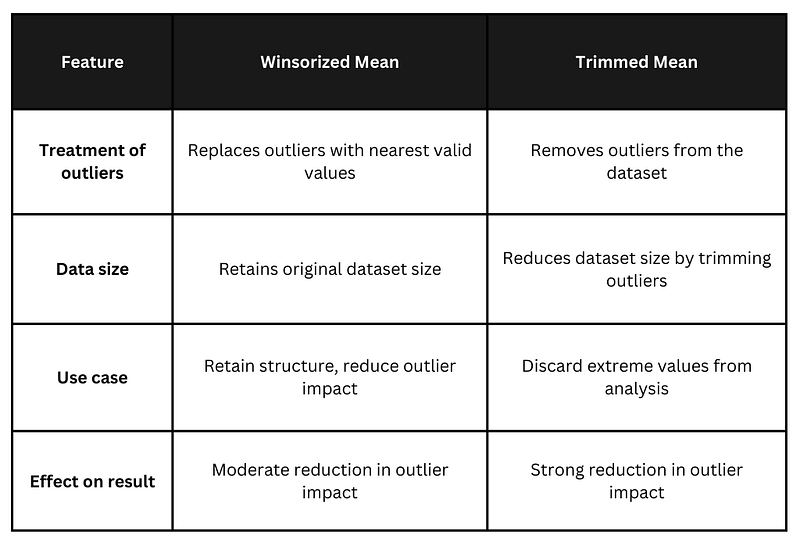 温莎化均值与修剪均值的关键差异。图片来源:作者。
温莎化均值与修剪均值都能帮助处理离群值,但选择取决于您是否希望保留或丢弃数据集中的极端值。
尽管温莎化是处理离群值的一种稳健方法,但修改极端值可能引发关于数据操纵的担忧。以下是该技术的优缺点:
因此,在将该技术纳入数据分析项目之前,务必权衡其利弊。
由于温莎化是对度量应用的一种统计技术,它也可扩展到其他常见统计量。下面介绍一些可进行温莎化的度量:
上述每一种温莎化度量在处理非正态数据或包含极端值的数据集时,都有助于降低离群值对分析的影响。
本教程介绍了一种处理离群值的统计度量:温莎化均值。我们学习了温莎化的概念、实际应用,以及在样本数据集上的动手实现。 此外,教程还讲解了修剪均值、其实现方式,以及它与温莎化均值的差异,并探讨了基于温莎化的优缺点及其他统计概念。
正如我们所见,温莎化均值在丢弃离群值与保留它们之间取得平衡,使其在偏态数据集中能得到更可靠的结果。我们鼓励您在数据分析项目中尝试该技术,并针对具体数据集试验不同的温莎化水平,找到最佳方案。
欢迎查看我们的Intermediate Predictive Analytics in Python课程,进一步学习如何使用 Python 处理数据集中的离群值(包括温莎化)。您也可以探索我们的Machine Learning Scientist with Python职业路径,通过构建实际模型进行练习。