
Last chance! 50% off DataCamp Premium
Sale ends in
Outlier sering kali dapat menyesatkan wawasan Anda, mengubah analisis yang seharusnya bermakna menjadi kesimpulan yang menyesatkan. Data yang tidak sempurna dan berisik adalah hal yang wajar dalam skenario dunia nyata, dan winsorisasi adalah solusi praktis untuk mengurangi dampak outlier tanpa membuang data apa pun.
Artikel ini akan membahas cara kerja rata-rata winsorized, penerapannya dalam praktik, serta langkah-langkah menghitungnya menggunakan Python. Kita juga akan memahami kelebihan dan kekurangannya, membandingkannya dengan ukuran lain yang bermanfaat seperti trimmed mean, serta meninjau ukuran statistik winsorisasi lainnya.
Rata-rata winsorized adalah ukuran statistik yang mengurangi dampak outlier dengan mengganti nilai-nilai ekstrem dengan persentil yang kurang ekstrem alih-alih menghapusnya sepenuhnya. Berbeda dengan mean aritmetika, yang mempertimbangkan semua titik data secara setara, rata-rata winsorized membatasi pengaruh nilai ekstrem yang dapat mendistorsi hasil keseluruhan.
Winsorisasi bekerja dengan membatasi atau mengganti nilai di luar ambang persentil tertentu. Misalnya, pada winsorisasi 5%, 5% data terendah diganti dengan nilai pada persentil ke-5, dan 5% tertinggi diganti dengan nilai pada persentil ke-95. Metode ini membantu mempertahankan struktur keseluruhan dataset sambil mengurangi efek outlier, menjadikannya alternatif yang tahan terhadap mean standar pada dataset yang mengandung nilai ekstrem.
Relevansi rata-rata winsorized dalam analisis statistik terutama terlihat pada bidang-bidang yang datanya rentan terhadap distribusi yang menyimpang. Berikut beberapa area utama di mana rata-rata winsorized terbukti membantu:
Dalam setiap aplikasi ini, rata-rata winsorized adalah alternatif yang tangguh terhadap mean standar, memungkinkan analis memperoleh wawasan yang kurang terpengaruh oleh outlier sambil mempertahankan pola data penting.
Menghitung rata-rata winsorized di Python melibatkan penggantian nilai ekstrem (outlier) dengan nilai pada persentil tertentu. Sebelum mulai, berikut ringkasan cepat langkah-langkah yang akan kita ikuti:
Impor pustaka dan dataset yang diperlukan.
Lakukan winsorisasi pada dataset menggunakan scipy.winsorize().
Hitung mean menggunakan numpy.mean().
Mari kita bahas detailnya dengan sebuah contoh.
Pertama, kita akan mengimpor pustaka yang diperlukan untuk menghitung mean.
import numpy as np
from scipy.stats.mstats import winsorize
Berikutnya, kita memuat dataset, yang bisa berasal dari file CSV atau sumber data lainnya. Untuk memudahkan contoh, kita akan membuat dataset sampel menggunakan numpy.
data = np.array([10, 12, 14, 15, 16, 18, 20, 22, 24, 25, 30, 35, 40, 45, 50, 60, 70, 80, 82, 85, 90, 200])Nilai 200 mungkin dianggap sebagai outlier dalam dataset ini berdasarkan analisis awal.
Fungsi winsorize() dari pustaka scipy memungkinkan Anda menentukan persentase data yang akan diwinsorisasi dari kedua ekor distribusi. Kodenya sebagai berikut:
# Winsorize 5% from both the lower and upper tails
winsorized_data = winsorize(data, limits=[0.05, 0.05])
Pada kode di atas, parameter limits=[0.05, 0.05] yang diberikan ke fungsi winsorize() mengganti 5% nilai terkecil dan 5% nilai terbesar dengan nilai pada persentil ke-5 dan ke-95, masing-masing. Kita sekarang dapat meninjau data hasil winsorisasi yang telah dibuat.
print("Original data: ", data)
print("Winsorized data: ", winsorized_data)
Keluaran akan menunjukkan bahwa outlier telah diganti:
Original data: [ 10 12 14 15 16 18 20 22 24 25 30 35 40 45 50 60 70 80 82 90 200]
Winsorized data: [ 12 12 14 15 16 18 20 22 24 25 30 35 40 45 50 60 70 80 82 90 90]
Di sini, nilai maksimum 200 telah diganti dengan 90; demikian pula, nilai ekstrem dari sisi bawah, 10, telah diganti dengan 12.
Terakhir, mari kita hitung mean dari data yang telah diwinsorisasi:
winsorized_mean = np.mean(winsorized_data)
print("Winsorized mean: ", winsorized_mean)
Keluaran sebagai berikut:
Winsorized mean: 42.5Rata-rata winsorized telah mengurangi pengaruh nilai yang sangat tinggi dibandingkan mean biasa. Sebagai pembanding, kita dapat menghitung mean asli sebagai berikut:
original_mean = np.mean(data)
print("Original mean: ", original_mean)
Keluaran sebagai berikut:
Original mean: 47.40909090909091Mean asli pada 47,40 sangat dipengaruhi oleh outlier, sehingga menjadi jauh lebih tinggi. Setelah melakukan winsorisasi pada nilai ekstrem, rata-rata winsorized menjadi jauh lebih rendah, yaitu 42,5, dengan pengaruh nilai ekstrem yang lebih kecil.
Rata-rata winsorized dan trimmed mean sama-sama merupakan metode statistik untuk mengurangi efek outlier pada mean, tetapi berbeda dalam cara menangani nilai ekstrem:
Rata-rata winsorized lebih disukai ketika Anda ingin mempertahankan struktur data (yaitu, menjaga ukuran sampel tetap sama) tetapi tetap mengurangi efek nilai ekstrem. Trimmed mean lebih disukai ketika dataset mengandung outlier jelas yang ingin Anda hapus sepenuhnya dan ketika ukuran sampel yang lebih kecil setelah pemangkasan dapat diterima.
Mari kita lihat bagaimana kedua metode memengaruhi dataset dan membandingkan hasilnya.
from scipy.stats import trim_mean

# Calculate the Trimmed mean by removing 5% from both tails
trimmed_mean = trim_mean(data, proportiontocut=0.05)

# Print the results
print("Original mean: ", np.mean(data))
print("Winsorized mean (5%): ", winsorized_mean)
print("Trimmed mean (5%): ", trimmed_mean)
Keluaran sebagai berikut:
Original mean: 47.40909090909091
Winsorized mean (5%): 42.5
Trimmed mean (5%): 41.65
Mean asli adalah 47,4, sangat dipengaruhi oleh outlier. Rata-rata winsorized, 42,5, dihitung dengan outlier yang diganti dengan nilai yang kurang ekstrem. Trimmed mean, ketika outlier dihapus sepenuhnya, adalah 41,65.
Gunakan rata-rata winsorized saat Anda ingin mempertahankan semua titik data tetapi mengurangi dampak nilai ekstrem. Ini adalah heuristik yang baik karena rata-rata winsorized berguna ketika Anda yakin outlier itu valid tetapi ingin meminimalkan pengaruhnya.
Gunakan trimmed mean saat Anda ingin menghapus outlier dari dataset sepenuhnya. Trimmed mean paling berguna ketika Anda menduga outlier bersifat keliru atau tidak mewakili distribusi data.
Perbedaan yang diringkas dapat ditabelkan seperti di bawah ini:
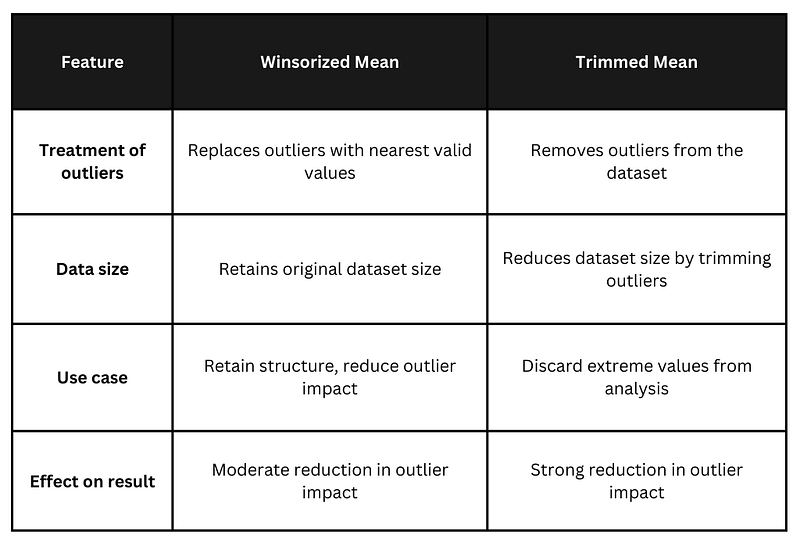 Perbedaan utama antara rata-rata winsorized vs. trimmed mean. Gambar oleh Penulis.
Rata-rata winsorized dan trimmed mean membantu menangani outlier, tetapi pilihan bergantung pada apakah Anda ingin mempertahankan atau membuang nilai ekstrem dari dataset.
Walaupun proses winsorisasi merupakan pendekatan yang tangguh untuk menangani outlier, memodifikasi nilai ekstrem dapat menimbulkan kekhawatiran terkait manipulasi data. Berikut beberapa kelebihan dan kekurangan teknik ini:
Karena itu, penting untuk mempertimbangkan pro dan kontra penggunaan teknik ini sebelum memasukkannya ke dalam proyek analisis data kita.
Karena winsorisasi adalah teknik statistik yang diterapkan pada suatu ukuran, teknik ini dapat diperluas ke ukuran statistik umum lainnya. Mari kita jelajahi beberapa ukuran lain yang dapat diterapkan winsorisasi:
Masing-masing ukuran winsorized ini membantu mengurangi pengaruh outlier pada analisis saat bekerja dengan data non-normal atau dataset dengan nilai ekstrem.
Tutorial ini memperkenalkan ukuran statistik untuk menangani outlier: rata-rata winsorized. Kita mempelajari konsep winsorisasi, penerapan praktisnya, dan implementasi langsung pada dataset sampel. Selanjutnya, tutorial membahas trimmed mean, implementasinya, dan bagaimana perbedaannya dengan rata-rata winsorized. Tutorial juga mengeksplorasi pro, kontra, dan konsep statistik lain yang berbasis winsorisasi.
Seperti yang telah kita lihat, rata-rata winsorized menyeimbangkan antara membuang outlier dan mempertahankannya, sehingga menghasilkan hasil yang lebih andal pada dataset yang menyimpang. Kami mendorong Anda untuk menggunakan teknik ini dalam proyek analisis data Anda, bereksperimen dengan tingkat winsorisasi yang berbeda untuk menemukan yang paling sesuai dengan dataset tertentu.
Lihat kursus Intermediate Predictive Analytics in Python kami untuk mempelajari lebih lanjut tentang penanganan outlier dalam dataset menggunakan Python, termasuk winsorisasi. Anda juga dapat menjelajahi jalur karier Machine Learning Scientist with Python, yang merupakan cara yang bagus untuk berlatih dengan membangun beberapa model nyata.
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



