
Cours
Introduction aux statistiques en Python
4 h
197.2K
Les valeurs aberrantes peuvent souvent vous induire en erreur et transformer une analyse pertinente en conclusion trompeuse. Dans les cas concrets, des données imparfaites et bruyantes sont la norme ; la winsorisation est une solution pratique pour atténuer l’impact des valeurs aberrantes sans supprimer de données.
Cet article explique le fonctionnement de la moyenne winsorisée, ses applications concrètes et les étapes pour la calculer avec Python. Nous en verrons les avantages et limites, la comparerons à d’autres mesures utiles comme la moyenne tronquée et explorerons d’autres statistiques winsorisées.
La moyenne winsorisée est une mesure statistique qui réduit l’impact des valeurs aberrantes en remplaçant les valeurs extrêmes par des percentiles moins extrêmes plutôt que de les supprimer totalement. Contrairement à la moyenne arithmétique, qui pondère également tous les points, la moyenne winsorisée limite l’influence des valeurs extrêmes susceptibles de fausser le résultat global.
La winsorisation consiste à plafonner ou remplacer les valeurs au-delà d’un seuil de percentile. Par exemple, avec une winsorisation à 5 %, les 5 % des plus petites valeurs sont remplacées par la valeur au 5e percentile et les 5 % des plus grandes par la valeur au 95e percentile. Cette méthode permet de conserver la structure d’ensemble du jeu de données tout en réduisant l’effet des valeurs aberrantes ; elle constitue une alternative robuste à la moyenne classique lorsque des extrêmes sont présents.
La pertinence de la moyenne winsorisée apparaît particulièrement dans les domaines où les distributions sont asymétriques. Voici quelques cas d’usage clés :
Dans tous ces cas, la moyenne winsorisée est une alternative robuste à la moyenne standard : elle éclaire l’analyse en limitant l’effet des extrêmes tout en préservant les motifs importants des données.
Calculer une moyenne winsorisée en Python revient à remplacer les valeurs extrêmes par les valeurs aux percentiles choisis. Avant de commencer, voici les étapes :
Importer les bibliothèques et le jeu de données.
Winsoriser le jeu de données avec scipy.winsorize().
Calculer la moyenne avec numpy.mean().
Passons aux détails avec un exemple.
Nous importons d’abord les bibliothèques nécessaires au calcul de la moyenne.
import numpy as np
from scipy.stats.mstats import winsorize
Ensuite, nous chargeons le jeu de données depuis un CSV ou une autre source. Pour simplifier, nous allons créer un échantillon avec numpy.
data = np.array([10, 12, 14, 15, 16, 18, 20, 22, 24, 25, 30, 35, 40, 45, 50, 60, 70, 80, 82, 85, 90, 200])La valeur 200 pourrait être considérée comme aberrante au vu d’une première analyse.
La fonction winsorize() de scipy permet de spécifier le pourcentage de données à winsoriser dans les queues inférieure et supérieure. Le code est le suivant :
# Winsoriser 5 % des deux côtés
winsorized_data = winsorize(data, limits=[0.05, 0.05])
Ici, le paramètre limits=[0.05, 0.05] passé à winsorize() remplace les 5 % des plus petites et des plus grandes valeurs par les valeurs aux 5e et 95e percentiles, respectivement. Nous pouvons maintenant examiner les données winsorisées obtenues.
print("Original data: ", data)
print("Winsorized data: ", winsorized_data)
La sortie montre que les valeurs aberrantes ont été remplacées :
Original data: [ 10 12 14 15 16 18 20 22 24 25 30 35 40 45 50 60 70 80 82 90 200]
Winsorized data: [ 12 12 14 15 16 18 20 22 24 25 30 35 40 45 50 60 70 80 82 90 90]
Ici, la valeur maximale 200 est remplacée par 90 ; de même, la valeur basse extrême, 10, est remplacée par 12.
Calculons enfin la moyenne des données winsorisées :
winsorized_mean = np.mean(winsorized_data)
print("Winsorized mean: ", winsorized_mean)
La sortie est la suivante :
Winsorized mean: 42.5La moyenne winsorisée réduit l’influence des valeurs très élevées par rapport à une moyenne classique. Pour comparer, calculons la moyenne initiale :
original_mean = np.mean(data)
print("Original mean: ", original_mean)
La sortie est la suivante :
Original mean: 47.40909090909091La moyenne originale à 47,40 est fortement tirée par les extrêmes, donc plus élevée. Après winsorisation, la moyenne tombe à 42,5, moins influencée par ces valeurs.
La moyenne winsorisée et la moyenne tronquée visent toutes deux à limiter l’effet des valeurs aberrantes sur la moyenne, mais elles diffèrent dans leur traitement des extrêmes :
On privilégiera la moyenne winsorisée lorsqu’il s’agit de préserver la structure des données (taille d’échantillon inchangée) tout en réduisant l’effet des extrêmes. La moyenne tronquée est préférable quand des outliers manifestes doivent être retirés et qu’une taille d’échantillon plus faible est acceptable.
Voyons l’effet des deux méthodes sur le jeu de données et comparons leurs résultats.
from scipy.stats import trim_mean

# Calculer la moyenne tronquée en retirant 5 % de chaque côté
trimmed_mean = trim_mean(data, proportiontocut=0.05)

# Afficher les résultats
print("Original mean: ", np.mean(data))
print("Winsorized mean (5%): ", winsorized_mean)
print("Trimmed mean (5%): ", trimmed_mean)
La sortie est la suivante :
Original mean: 47.40909090909091
Winsorized mean (5%): 42.5
Trimmed mean (5%): 41.65
La moyenne initiale est 47,4, fortement influencée par les outliers. La moyenne winsorisée à 42,5 est calculée après remplacement des extrêmes par des valeurs moins extrêmes. La moyenne tronquée, où les extrêmes sont supprimés, vaut 41,65.
Utilisez la moyenne winsorisée si vous souhaitez conserver tous les points tout en atténuant l’impact des valeurs extrêmes. C’est une bonne heuristique lorsque vous pensez que les outliers sont plausibles mais que vous voulez limiter leur influence.
Utilisez la moyenne tronquée si vous souhaitez retirer complètement les outliers du jeu de données. Elle est adaptée lorsque vous suspectez des erreurs ou des valeurs non représentatives de la distribution.
On peut résumer les différences comme suit :
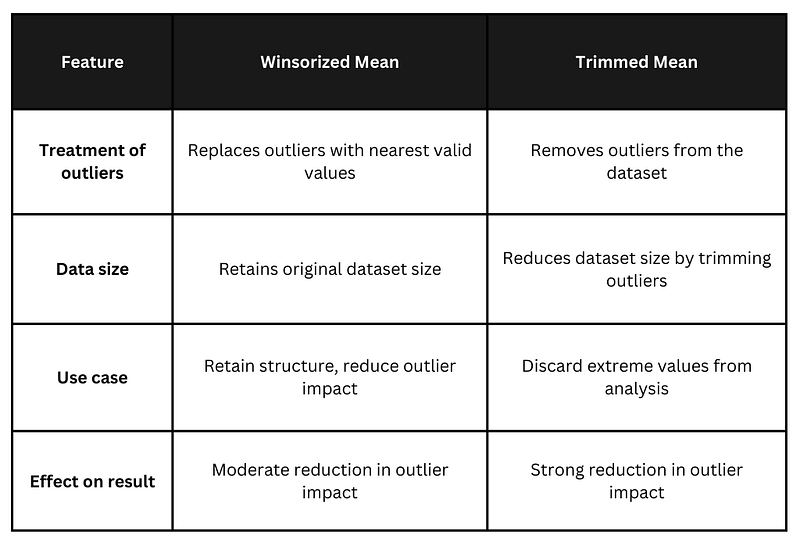 Principales différences entre moyenne winsorisée et moyenne tronquée. Image de l’auteur.
Winsorisation et troncature aident toutes deux à gérer les outliers ; le choix dépend de votre intention de conserver ou d’éliminer les valeurs extrêmes.
Bien que robuste pour traiter les outliers, la modification des valeurs extrêmes peut soulever des questions de manipulation. Voici ses atouts et ses limites :
Il est donc essentiel de peser le pour et le contre avant d’intégrer cette technique à vos analyses.
La winsorisation étant une technique applicable à différentes mesures, on peut l’étendre à d’autres statistiques usuelles. Voici quelques exemples :
Chacune de ces mesures aide à limiter l’influence des valeurs aberrantes lors d’analyses avec des données non normales ou comportant des extrêmes.
Ce tutoriel a présenté une mesure statistique pour traiter les valeurs aberrantes : la moyenne winsorisée. Nous avons défini la winsorisation, vu ses usages concrets et réalisé une mise en pratique sur un échantillon. Nous avons également couvert la moyenne tronquée, sa mise en œuvre et ses différences avec la moyenne winsorisée, ainsi que les avantages, limites et autres concepts statistiques fondés sur la winsorisation.
Comme nous l’avons vu, la moyenne winsorisée trouve un juste milieu entre écarter et conserver les outliers, offrant des résultats plus fiables sur des jeux de données asymétriques. Nous vous encourageons à l’utiliser dans vos projets d’analyse, en testant différents niveaux de winsorisation pour identifier ce qui convient le mieux à chaque jeu de données.
Découvrez notre cours Intermediate Predictive Analytics in Python pour approfondir le traitement des valeurs aberrantes en Python, dont la winsorisation. Explorez aussi notre Machine Learning Scientist with Python career track, idéal pour vous exercer en construisant de vrais modèles.
Apprenez avec DataCamp
Cours
Cours
Cours