programa
Científico especializado en machine learning en Python
85 h
Para sacarle todo el partido a este artículo sobre Falcon 40B, conviene tener unas nociones básicas de aprendizaje automático y de procesamiento del lenguaje natural. También ayuda estar familiarizado con los modelos transformer y sus componentes, como los mecanismos de atención y los embeddings posicionales.
Si estás empezando en IA y quieres aprender los fundamentos, sigue nuestro itinerario de habilidades AI Fundamentals. Conocerás ChatGPT, machine learning, LLMs, IA generativa y ética de la IA.
Falcon 40B forma parte de la familia Falcon de modelos de lenguaje grandes (LLMs) desarrollados por el Technology Innovation Institute (TII), que también incluye Falcon 7B y Falcon 180B. Como modelo causal solo decodificador, Falcon 40B está diseñado para distintas tareas de generación de lenguaje natural.
Falcon 40B es multilingüe: cubre inglés, alemán, español y francés, y tiene competencia limitada en otros idiomas como italiano, portugués, polaco, neerlandés, rumano, checo y sueco.
La arquitectura de Falcon 40B está adaptada de GPT-3 con modificaciones clave para mejorar el rendimiento. Emplea embeddings posicionales rotatorios para una mejor comprensión de secuencias. Los mecanismos de atención se enriquecen con multi-query attention y FlashAttention. El bloque decodificador incorpora atención en paralelo y estructuras MLP (Multi-Layer Perceptron) con un esquema de normalización en dos capas, equilibrando eficiencia computacional.
Falcon 40B se entrenó con 1 billón de tokens del corpus RefinedWeb, un conjunto de datos de internet filtrado por calidad, además de otros conjuntos curados. En lugar de recopilar múltiples fuentes curadas dispersas, TII mejoró la calidad de los datos web mediante deduplicación a gran escala y filtros estrictos, logrando así un dataset de entrenamiento de alta calidad que impulsa el gran rendimiento de los modelos Falcon.
Falcon 40B se entrenó en AWS SageMaker con 384 GPUs A100 de 40 GB, utilizando una estrategia de paralelismo 3D (TP=8, PP=4, DP=12) junto con ZeRO. El entrenamiento comenzó en diciembre de 2022 y duró dos meses.
Aprende a entrenar LLMs con PyTorch, desde la preparación inicial hasta la implementación final, con el tutorial How to Train a Large Language Model with PyTorch.
A diferencia del esquema tradicional de atención multi-cabeza, Falcon 40B emplea Multi-Query Attention, donde una misma clave y valor se comparten entre todas las cabezas de atención. Este mecanismo innovador apenas afecta al preentrenamiento, pero mejora enormemente la escalabilidad en inferencia.
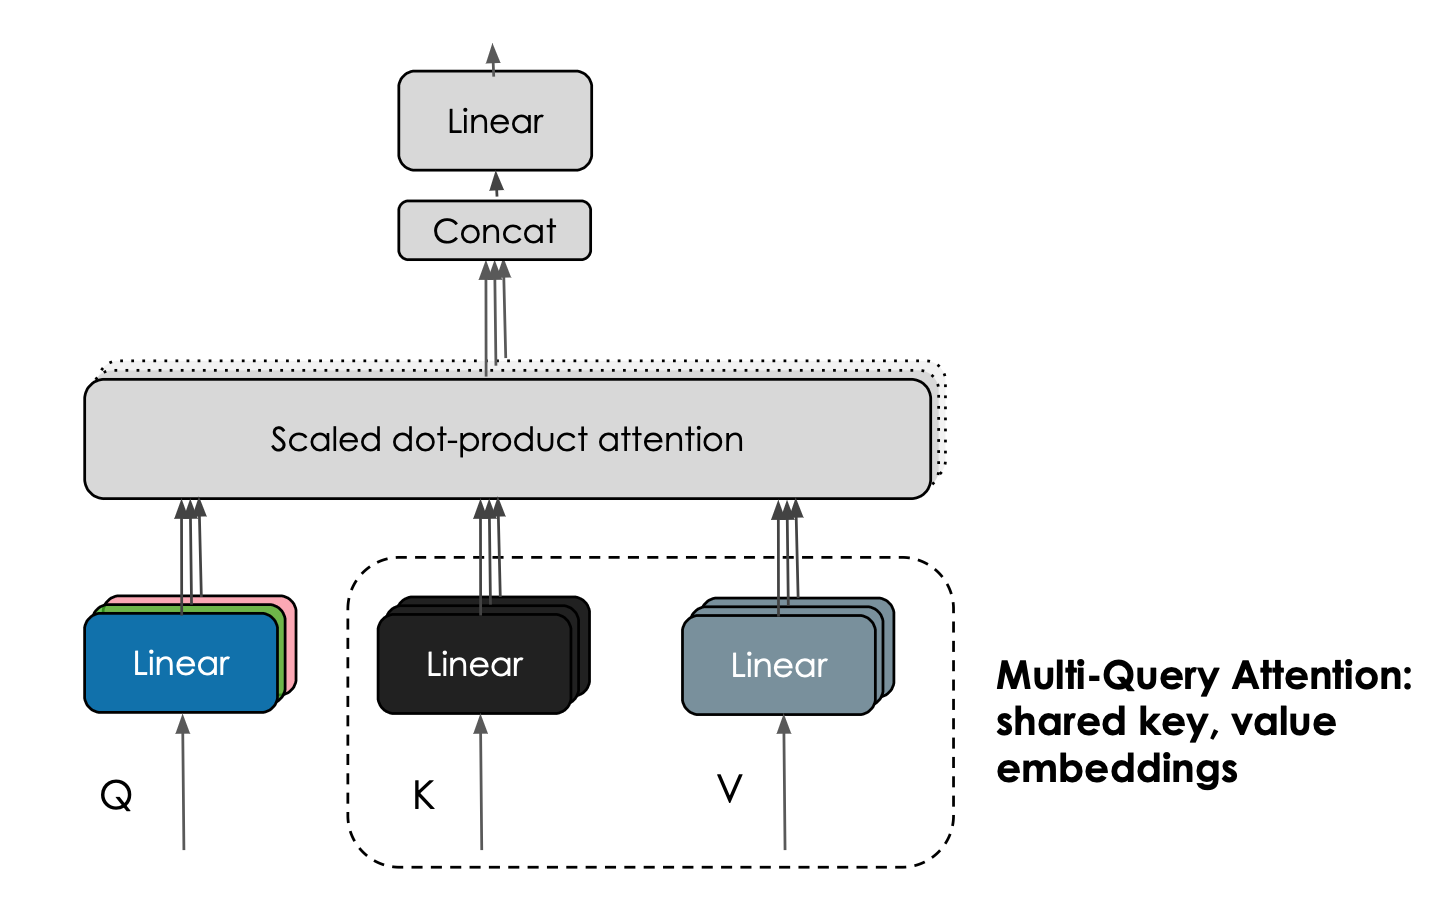
Imagen del blog de Falcon
TII también ha presentado versiones instruct de los modelos, Falcon-7B-Instruct y Falcon 40B-Instruct, afinadas con instrucciones y datos conversacionales para rendir mejor en tareas tipo asistente.
Aunque Falcon 40B requiere mucha memoria de GPU, siempre puedes recurrir a la cuantización para hacerlo viable en GPUs más económicas o incluso ejecutar la versión más pequeña Falcon-7B en Google Colab.
Falcon 40B supera a otros modelos de código abierto como LLaMA, StableLM, RedPajama y MPT, como se ve en el OpenLLM Leaderboard. Su rendimiento superior lo convierte en una de las mejores opciones entre los modelos open source disponibles.
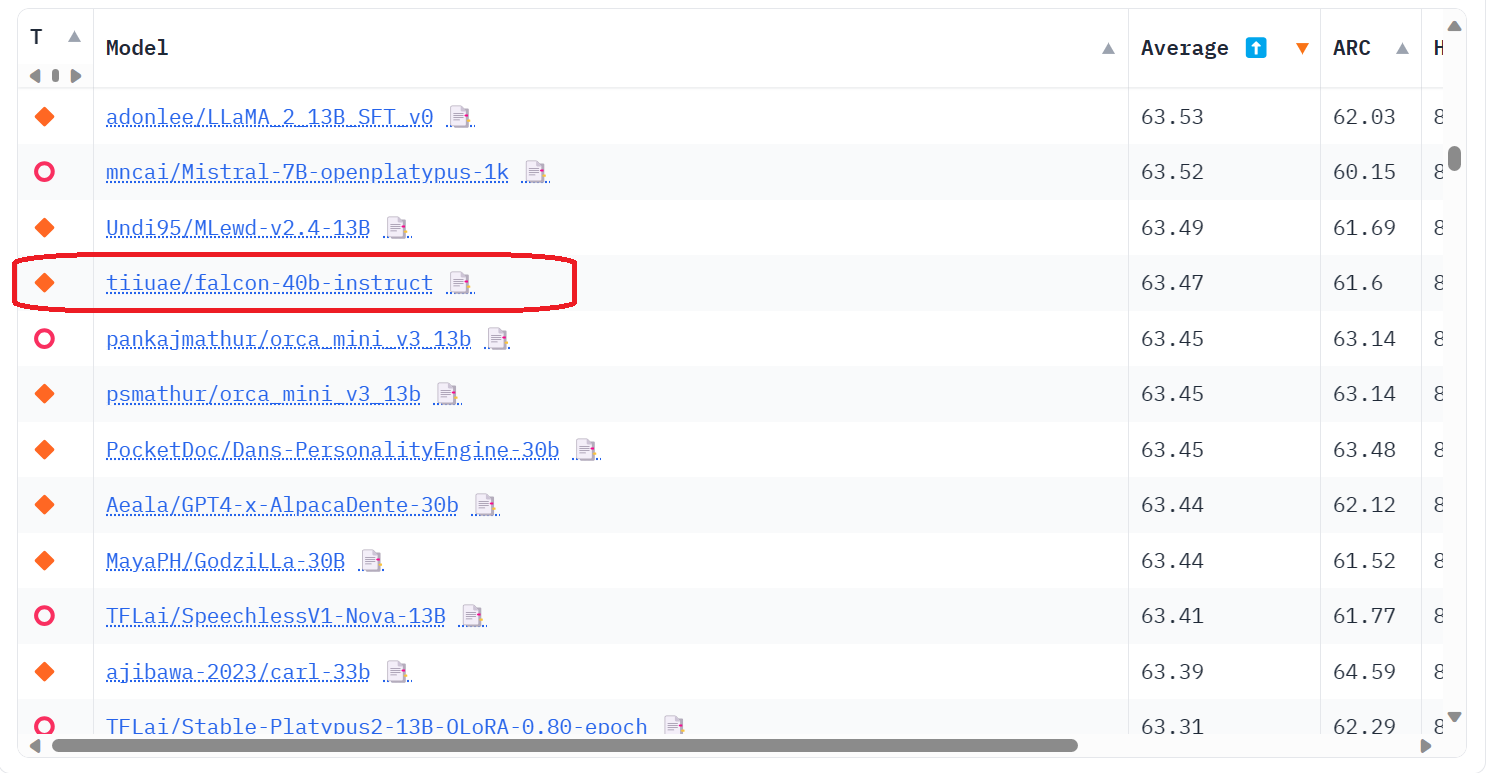
Imagen de Open LLM Leaderboard
La arquitectura de Falcon 40B está optimizada para una inferencia eficiente gracias a funciones como FlashAttention y multi-query attention, lo que se traduce en mayor velocidad y escalabilidad. Es un modelo de lenguaje preentrenado en crudo que, en la mayoría de casos, requiere un ajuste fino adicional.
Falcon 40B se publica bajo licencia Apache 2.0, que te permite usar el modelo y el dataset con fines comerciales sin cánones ni restricciones.
En esta sección veremos cómo cargar el modelo Falcon 40B y ejecutar la inferencia. Además, exploraremos cómo ejecutar la inferencia de la versión más pequeña, Falcon 7B, en Google Colab usando cuantización a 4 bits. Por último, aprenderemos a usar QLoRA y SFT Trainer para hacer fine-tuning del modelo en un nuevo conjunto de datos.
Ejecutar Falcon 40B, con 40.000 millones de parámetros, plantea retos de memoria. El modelo supera la capacidad de una única GPU NVIDIA A100 con 80 GB de RAM, incluso usando precisión reducida en modo de 8 bits, que necesita aproximadamente 45 GB de RAM.
Cargando en precisión de 4 bits con las últimas versiones de las librerías bitsandbytes, transformers y accelerate, la huella de memoria puede reducirse a unos 27 GB de RAM. Esto permite cargar Falcon-40B en GPUs A100 de 40 GB.
from transformers import AutoTokenizer, AutoModelForCausalLM
import transformers
import torch

model = "tiiuae/falcon-40b"

tokenizer = AutoTokenizer.from_pretrained(model)
pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.bfloat16,
    load_in_8bit=True,
    trust_remote_code=True,
    device_map="auto",
)

prompt = "What are the main benefits of enrolling in a DataCamp career track?"

sequences = pipeline(
    prompt,
    max_length=100,
    do_sample=True,
    top_k=10,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
)
for seq in sequences:
print(f"Result: {seq['generated_text']}")Cargar Falcon 40B y ejecutar la inferencia con cuantización de 4 bits no es viable en GPUs de consumo. Por ello, usaremos la versión más pequeña, Falcon 7B, que puede ejecutarse fácilmente en la versión gratuita de Google Colab.
Instalaremos todas las librerías de Python necesarias.
%pip install transformers bitsandbytes accelerate -qDespués cargaremos los módulos necesarios para cargar el modelo y ejecutar la inferencia.
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
import transformers
import torch
Usamos BitsAndBytes para crear una cuantización de 4 bits con configuración de tipo NF4. Esto reduce la memoria necesaria y nos permite cargar el modelo en la GPU de Colab. Lee más sobre la cuantización de 4 bits y QLoRA.
compute_dtype = getattr(torch, "float16")

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=compute_dtype,
    bnb_4bit_use_double_quant=False,
)
Cargaremos el modelo y el tokenizer de Falcon 7B y crearemos un pipeline de generación de texto con Transformers para ejecutar la inferencia.
model_name = "tiiuae/falcon-7b"

tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.bfloat16,
    trust_remote_code=True,
    quantization_config=bnb_config,
    device_map="auto",
)

pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
)
Al pasar el prompt al pipeline, podemos generar la respuesta.
prompt = "What are the main benefits of enrolling in a DataCamp career track?"
sequences = pipeline(
    prompt,
    max_length=100,
    do_sample=True,
    top_k=20,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
)
for seq in sequences:
    print(f"Result: {seq['generated_text']}")
El resultado es muy bueno. Puedes probar distintos parámetros del pipeline para mejorar aún más la respuesta del modelo.
Result: What are the main benefits of enrolling in a DataCamp career track? A: When you enroll in a DataCamp career track you have the opportunity to: - Build a solid foundation in one specific topic. - Learn new data science skills. - Gain valuable job search and interview prep tools. - Build a project portfolio that you can easily showcase to potential employers. - Network with thousands of like-minded people from diverse backgrounds.Si te cuesta ejecutar Falcon 7B en Colab, puedes usar este Colab Notebook como guía.
Con la librería TRL y QLoRA, podemos ajustar el modelo. El siguiente código forma parte del proceso de fine-tuning y permite ejecutar SFTTrainer sin PEFT.
from datasets import load_dataset
from trl import SFTTrainer

dataset = load_dataset("timdettmers/openassistant-guanaco
", split="train")

trainer = SFTTrainer(
    model,
    tokenizer=tokenizer,
    train_dataset=dataset,
    dataset_text_field="text",
    max_seq_length=512,
)
trainer.train()
Puedes consultar el notebook Falcon-Guanaco.ipynb para ver el código de fine-tuning de Falcon-7B en el dataset Guanaco. Para entrenar el modelo con Guanaco —un subconjunto de alta calidad del dataset Open Assistant con unos 10.000 diálogos— podemos usar la librería PEFT junto con el enfoque reciente QLoRA para afinar adaptadores, que se colocan sobre el modelo congelado de 4 bits.
Con Low Rank Adapters (LoRA), solo se entrena una fracción muy pequeña del modelo, lo que reduce de forma notable el número de parámetros aprendidos y el tamaño del artefacto entrenado. Esto permite un fine-tuning más rápido ahorrando memoria.
También puedes saltarte el fine-tuning y usar Retrieval Augmented Generation (RAG) para personalizar la respuesta dando acceso a tus documentos privados. Puedes hacerlo siguiendo el tutorial LlamaIndex: un marco de datos para aplicaciones basadas en LLMs.
Además, puedes crear aplicaciones LLM con LangChain usando tu modelo recién afinado, de forma similar a LlamaIndex.
Falcon-180B se entrenó con 3.500B tokens del dataset RefinedWeb. Es un modelo causal solo decodificador de 180.000 millones de parámetros con licencia Falcon-180B TII que supera a LLaMA-2, StableLM, RedPajama, MPT y otros modelos destacados en el OpenLLM Leaderboard.
La desventaja de Falcon 180B es que para ejecutar la inferencia necesita al menos 400 GB de memoria. En resumen, aproximadamente 8×A100 de 80 GB.
La parte positiva es que TII también ha lanzado Falcon-180B-Chat, afinado con una combinación de los datasets Ultrachat, Platypus y Airoboros. Ha ganado mucha popularidad en la comunidad de IA. También puedes probar la demo en Hugging Face Spaces y comprobar la alta calidad de las respuestas.
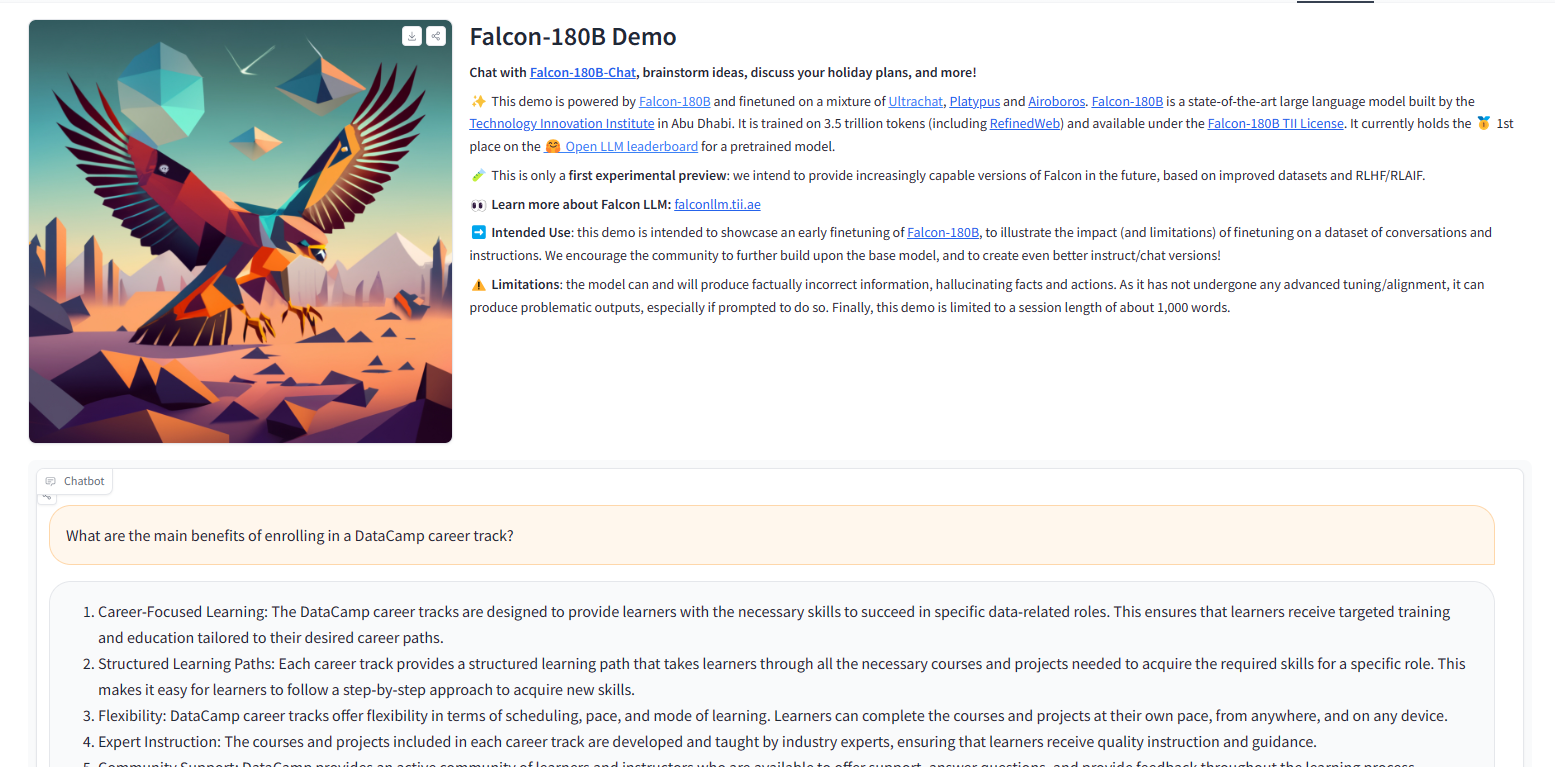
Imagen de la demo de Falcon-180B
Falcon 40B de TII demuestra un rendimiento impresionante como modelo generativo de lenguaje de código abierto. Con 40.000 millones de parámetros y entrenado con datos web filtrados de alta calidad, alcanza resultados de vanguardia en el OpenLLM Leaderboard.
Aunque el modelo completo Falcon 40B requiere muchos recursos de cómputo, la versión 7B puede ejecutarse en GPUs gratuitas de Colab usando cuantización de 4 bits. El fine-tuning es posible con QLoRA, PEFT y SFT Trainer. La nueva versión Falcon 180B eleva aún más el listón, pero necesita 400 GB solo para la inferencia.
Si te interesa desarrollar tu carrera profesional en machine learning y quieres construir tu propio LLM, plantéate seguir el itinerario de carrera Machine Learning Scientist with Python.
¡Empieza hoy tu camino en machine learning!
programa
Curso
blog
Abid Ali Awan
7 min
Tutorial
Zoumana Keita
15 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Kurtis Pykes
13 min
Tutorial
Zoumana Keita
14 min
Tutorial
Joanne Xiong
11 min