
Kursus
Menerapkan AI ke Produksi dengan FastAPI
4 jam
5.5K
Google baru-baru ini merilis Gemma 3 270M, model ultra-kompak dengan 270 juta parameter yang mewakili paradigma baru dalam penerapan AI yang efisien. Berbeda dengan model general-purpose berukuran besar, Gemma 3 270M dirancang untuk fine-tuning khusus tugas sambil tetap mempertahankan kemampuan mengikuti instruksi langsung dari awal.
Dalam tutorial ini, saya akan menunjukkan cara memulai dengan Gemma 3 270M dan mendemonstrasikan mengapa ini pilihan yang tepat bagi pengembang yang memerlukan:
Kami terus memperbarui pembaca tentang perkembangan terbaru AI melalui The Median, buletin gratis setiap Jumat yang merangkum berita utama pekan ini. Berlangganan dan tetap up-to-date hanya dalam beberapa menit per minggu:
Gemma 3 270M adalah model fondasi kompak, dirancang untuk menghadirkan kemampuan mengikuti instruksi yang kuat dan generasi teks terstruktur, semuanya hanya dengan 270 juta parameter. Ini adalah anggota terkecil dari keluarga Gemma 3, namun mewarisi arsitektur dan resep pelatihan yang sama seperti varian yang lebih besar seperti Gemma 3 1B dan 4B.
Berbeda dengan model besar serbaguna, Gemma 3 270M berfokus pada efisiensi dan spesialisasi. Berikut beberapa poin penting tentang model ini:
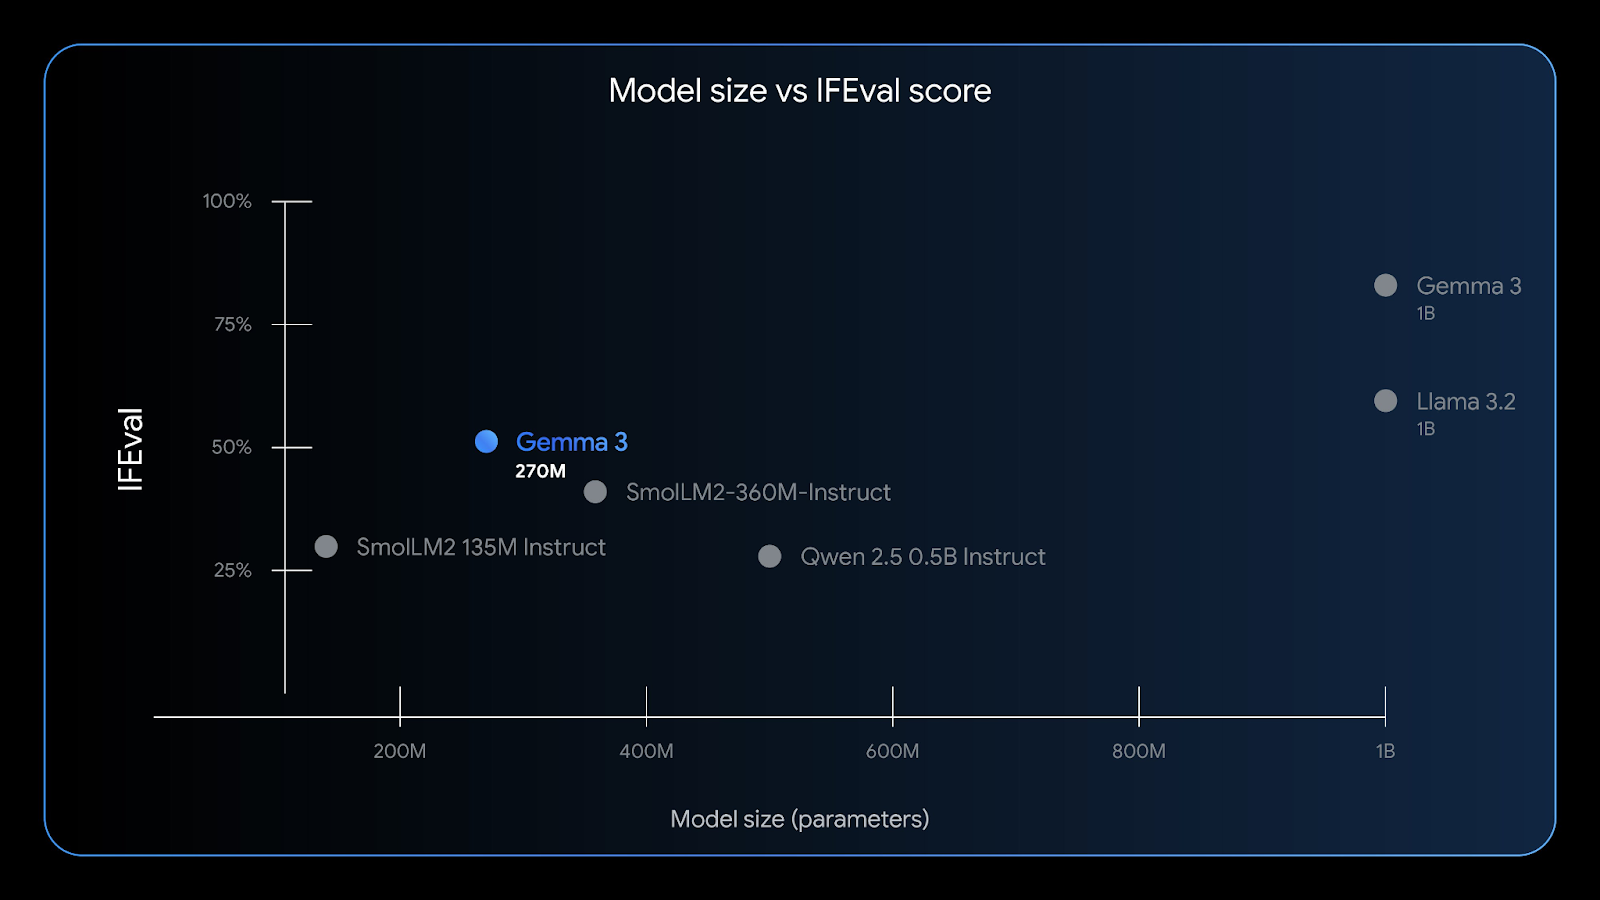
Gemma 3 270M memiliki kemampuan mengikuti instruksi yang baik—tolok ukur IFEval menguji kemampuan model untuk mengikuti informasi yang dapat diverifikasi. Sumber: Google
Dengan jendela konteks 32K, penggunaan memori rendah, dan akurasi andal pada tugas seperti ekstraksi entitas, klasifikasi, dan pemeriksaan kepatuhan ringan, Gemma 3 270M sempurna bagi pengembang edge AI yang mencari privasi, kecepatan, dan efisiensi biaya.
Ada beberapa cara mudah untuk memulai dengan Gemma 3 270M, bergantung pada platform pilihan Anda:
Anda dapat menerapkan Gemma 3 di Google Cloud Run menggunakan container akselerasi GPU siap pakai untuk inferensi yang dapat diskalakan. Untuk Gemma 3 270M, Anda perlu membangun container dari repo GitHub Gemma-on-CloudRun, karena hanya varian yang lebih besar (1B+) yang sudah tersedia. Ikuti petunjuk pada panduan resmi Google Cloud Run untuk mengaktifkan inferensi yang cepat, aman, dan hemat biaya untuk aplikasi web atau backend.
Pengalaman pengguna terbaik adalah di perangkat, menggunakan versi terkuantisasi Gemma 3 270M (gemma3-270m-it-q8) dan Gemma Gallery App resmi dari Google. Pendekatan ini menghadirkan inferensi offline yang sangat cepat, privasi kuat, dan penggunaan baterai minimal.
Anda juga dapat menjalankan Gemma 3 270M di laptop menggunakan alat seperti:
.gguf atau .litertlm di lingkungan LM Studio Anda dan jalankan langsung di antarmuka chat-nya atau host secara lokal.ollama run gemma3:270m untuk menjalankan model ini secara lokal di mesin Anda.Gemma 3 270M juga tersedia di Hugging Face Transformers, JAX, atau Unsloth untuk fine-tune pada data khusus domain Anda. Ukuran model yang kecil membuatnya ideal untuk eksperimen yang cepat dan hemat biaya, dan checkpoint QAT memungkinkan penerapan INT4 langsung setelah finetuning.
Selanjutnya, saya akan memandu Anda membangun aplikasi Android yang berfungsi menggunakan model Gemma 3 270M untuk memproses prompt teks. Kita akan menggunakan repositori Gallery resmi Google sebagai basis dan melakukan kustomisasi.
Mari mulai dengan menyiapkan proyek baru dan meng-clone repositori asli dari Google.
Di laptop Anda, buka proyek sebagai proyek baru di Android Studio dan pilih Empty Activity.
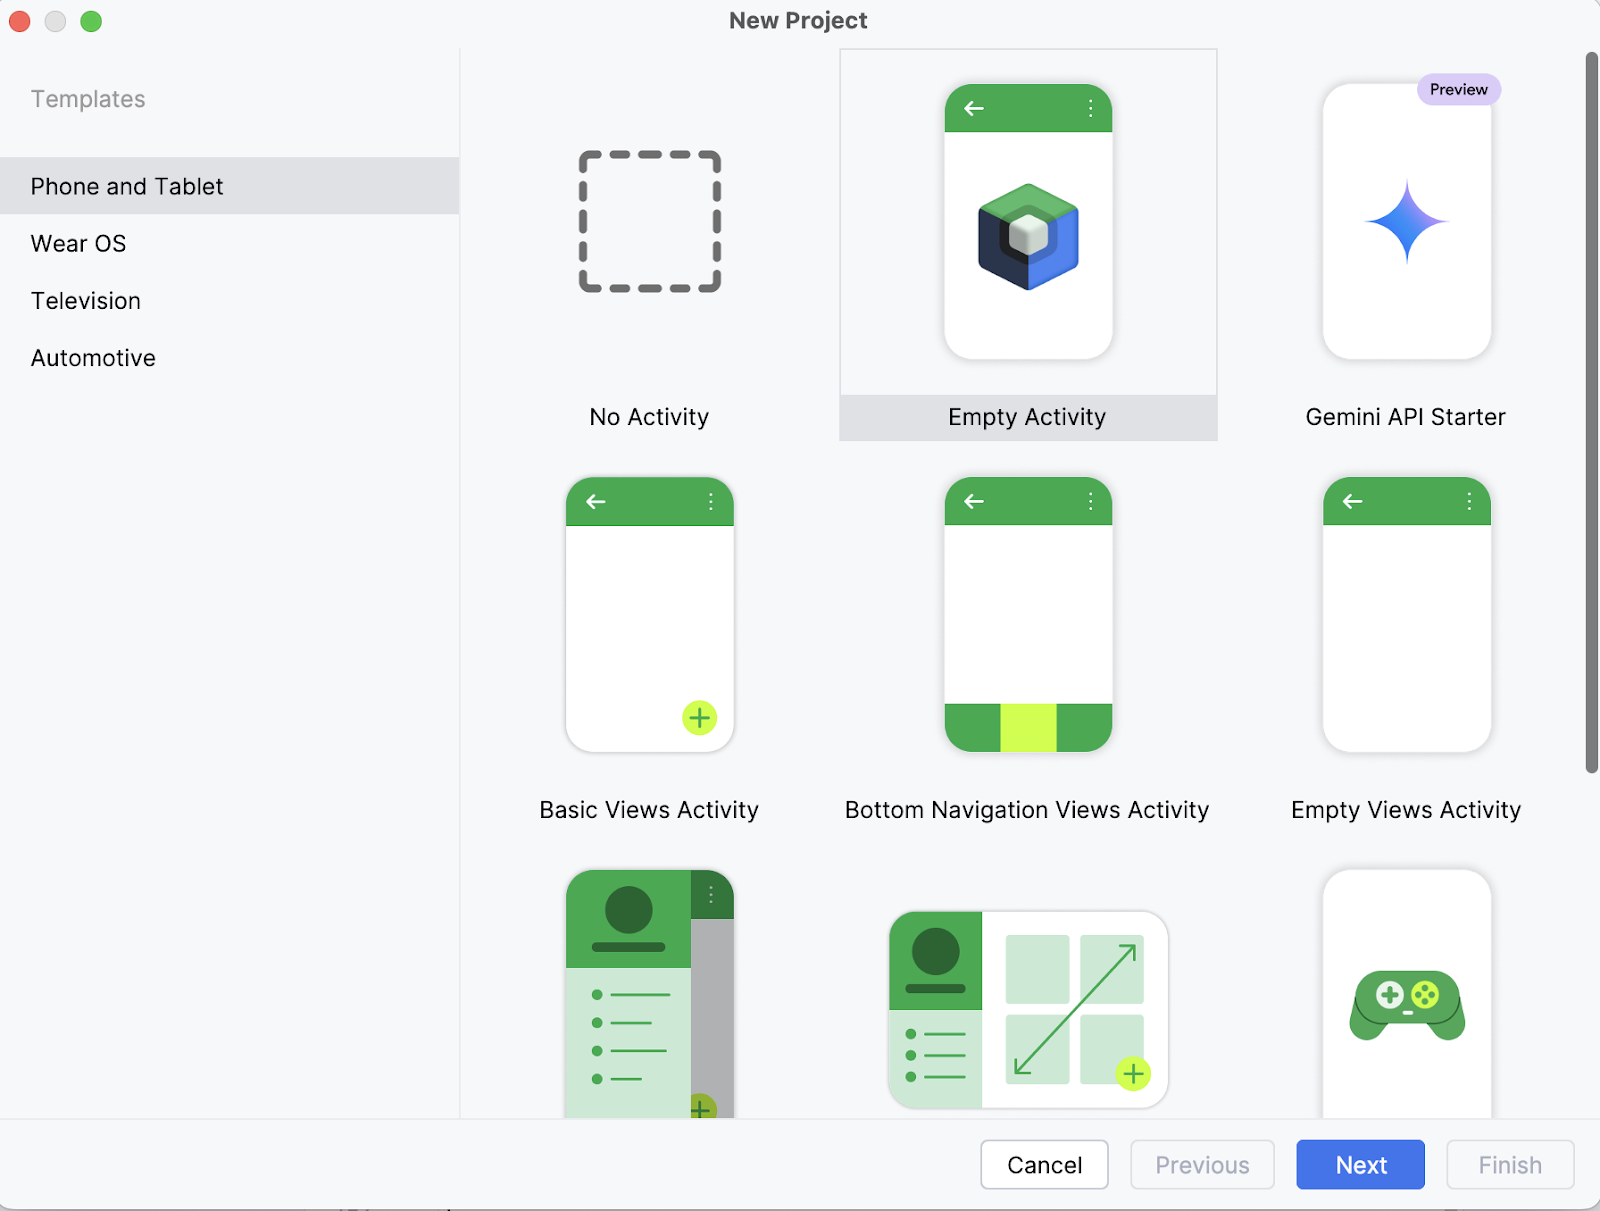
Selanjutnya, isi nama activity Anda (misalnya, “Gemma 3 270M”) dan biarkan yang lain apa adanya. Lalu, klik Finish.
Sekarang, buka terminal di Android Studio (pojok kiri bawah) dan jalankan perintah bash berikut:
git clone https://github.com/google-ai-edge/gallery
cd gallery/android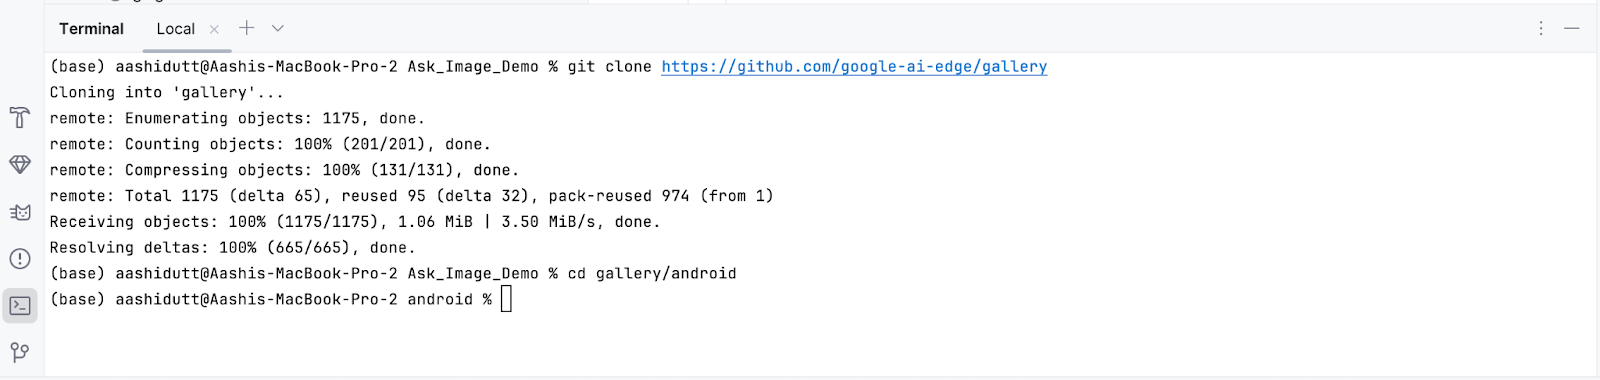
Ini akan membuka proyek Anda. Anda dapat melihat semua file proyek di sisi kiri tab.
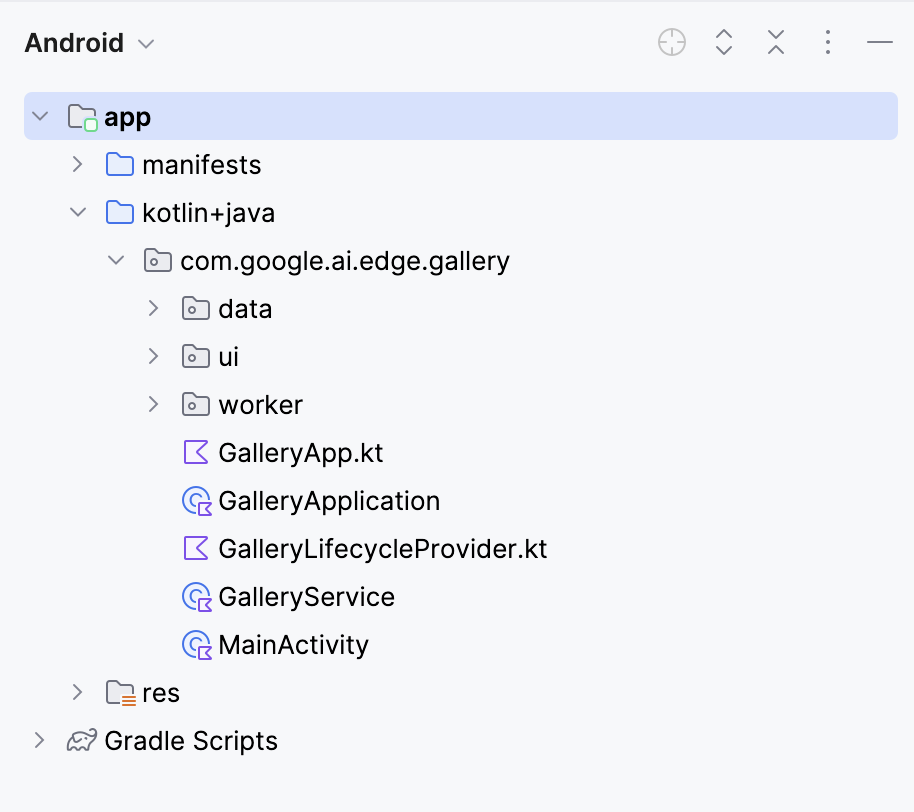
Untuk menghubungkan model Gemma 3 270M dengan aplikasi Android Anda, Anda perlu mendaftarkannya sebagai tugas baru di file Tasks.kt aplikasi.
Arahkan ke folder data/ dan buka file Tasks.kt. Di sana, Anda akan mendefinisikan entri tugas baru khusus untuk varian model terkuantisasi Q8 gemma3-270m-it-q8, yang dioptimalkan untuk memori rendah dan inferensi di perangkat. Format ini cocok untuk perangkat seluler dengan RAM terbatas.
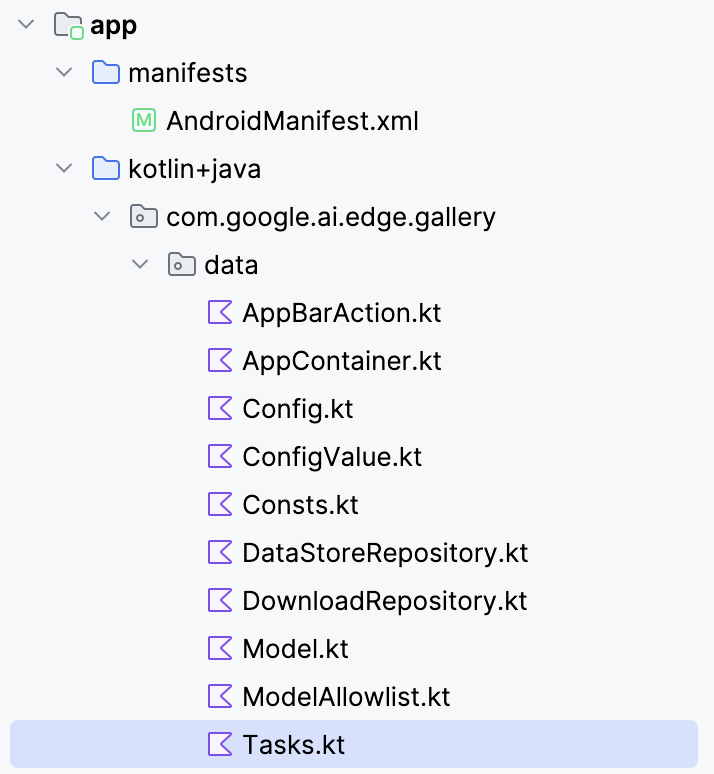
Catatan: Untuk tutorial ini, saya akan menggunakan konfigurasi model Q8, yang membutuhkan memori lebih sedikit. Anda dapat mengakses model ini di sini: https://huggingface.co/litert-community/gemma-3-270m-it
val TASK_GEMMA_3_270M = Task(
  type = TaskType.LLM_PROMPT_LAB,
  icon = Icons.Outlined.Widgets,
  models = mutableListOf(
    Model(
      name = "gemma3-270m-it-q8",
      downloadFileName = "gemma3-270m-it-q8.task",
      url = "https://huggingface.co/litert-community/gemma-3-270m-it/resolve/main/gemma3-270m-it-q8.task",
      sizeInBytes = 318_767_104L
    )
  ),
  description = "Gemma 3 270M (Q8): On-device instruction-following LLM",
  docUrl = "https://ai.google.dev/gemma",
  sourceCodeUrl = "https://github.com/google-ai-edge/gallery",
  textInputPlaceHolderRes = R.string.chat_textinput_placeholder
)
Lalu, daftarkan tugas baru ini di aplikasi dengan memasukkannya ke dalam daftar tugas utama:
/** All tasks */
val TASKS: List<Task> = listOf(
  TASK_LLM_ASK_IMAGE,
  TASK_LLM_CHAT,
  TASK_LLM_PROMPT_LAB,
  TASK_IMAGE_CLASSIFICATION,
  TASK_TEXT_CLASSIFICATION,
  TASK_IMAGE_GENERATION,
  TASK_GEMMA_3_270M
)
Berikut penjelasan tentang apa yang dilakukan definisi tugas LiteRT baru di kode:
TASK_GEMMA_3_270M mendaftarkan Gemma 3 270M sebagai opsi yang dapat dipilih di file Tasks.kt aplikasi agar muncul di daftar tugas..task: Kode di atas menunjuk ke bundel gemma3-270m-it-q8.task yang di-host di Hugging Face, yang akan diunduh dalam aplikasi dan digunakan saat runtime..task berisi bobot model terkuantisasi, tokenizer, metadata, dan konfigurasi yang diperlukan agar LiteRT menjalankan model secara efisien.TASK_GEMMA_3_270M.Secara default, aplikasi Gallery mengisi daftar modelnya dari allowlist JSON jarak jauh. Jika entri Gemma 3 270M kustom Anda tidak termasuk di sana, entri tersebut tidak akan muncul di UI, meskipun Anda telah menambahkan TASK_GEMMA_3_270M di kode. Langkah ini menyisipkan model 270M Anda ke dalam tugas LLM Prompt Lab setelah allowlist dimuat, memastikan model tersebut selalu dapat dipilih.
Buka modelmanager/ModelManagerViewModel.kt, temukan fungsi loadModelAllowlist(), dan (setelah loop yang mengonversi model allowlist) tambahkan:
Log.d(TAG, "Adding TASK_GEMMA_3_270M models to LLM_PROMPT_LAB")
            for (gemmaModel in TASK_GEMMA_3_270M.models) {
              if (!TASK_LLM_PROMPT_LAB.models.any { it.name == gemmaModel.name }) {
                Log.d(TAG, "Adding model ${gemmaModel.name} to LLM_PROMPT_LAB")
                TASK_LLM_PROMPT_LAB.models.add(gemmaModel)
              }
Alasan kode ini diperlukan:
TASK_LLM_PROMPT_LAB.models dari allowlist server saat startup. Model lokal Anda akan terhapus kecuali Anda menyuntikkannya kembali.any { it.name == gemmaModel.name } mencegah duplikasi saat fungsi loadModelAllowlist() berjalan lagi.Berikut fungsi lengkapnya:
fun loadModelAllowlist() {
    _uiState.update {
      uiState.value.copy(
        loadingModelAllowlist = true, loadingModelAllowlistError = ""
      )
    }
    viewModelScope.launch(Dispatchers.IO) {
      try {
        withTimeoutOrNull(30000L) { // 30 second timeout
          // Load model allowlist json.
          Log.d(TAG, "Loading model allowlist from internet...")
          val data = getJsonResponse<ModelAllowlist>(url = MODEL_ALLOWLIST_URL)
          var modelAllowlist: ModelAllowlist? = data?.jsonObj
          if (modelAllowlist == null) {
            Log.d(TAG, "Failed to load model allowlist from internet. Trying to load it from disk")
            modelAllowlist = readModelAllowlistFromDisk()
          } else {
            Log.d(TAG, "Done: loading model allowlist from internet")
            saveModelAllowlistToDisk(modelAllowlistContent = data?.textContent ?: "{}")
          }
          if (modelAllowlist == null) {
            Log.e(TAG, "Failed to load model allowlist from both internet and disk")
            _uiState.update {
              uiState.value.copy(
                loadingModelAllowlist = false,
                loadingModelAllowlistError = "Failed to load model list"
              )
            }
            return@withTimeoutOrNull
          }
          Log.d(TAG, "Allowlist: $modelAllowlist")
          // Convert models in the allowlist.
          TASK_LLM_CHAT.models.clear()
          TASK_LLM_PROMPT_LAB.models.clear()
          TASK_LLM_ASK_IMAGE.models.clear()
          try {
            for (allowedModel in modelAllowlist.models) {
              if (allowedModel.disabled == true) {
                continue
              }
              val model = allowedModel.toModel()
              if (allowedModel.taskTypes.contains(TASK_LLM_CHAT.type.id)) {
                TASK_LLM_CHAT.models.add(model)
              }
              if (allowedModel.taskTypes.contains(TASK_LLM_PROMPT_LAB.type.id)) {
                TASK_LLM_PROMPT_LAB.models.add(model)
              }
              if (allowedModel.taskTypes.contains(TASK_LLM_ASK_IMAGE.type.id)) {
                TASK_LLM_ASK_IMAGE.models.add(model)
              }
            }
            // Add models from TASK_GEMMA_3_270M to LLM_PROMPT_LAB
            Log.d(TAG, "Adding TASK_GEMMA_3_270M models to LLM_PROMPT_LAB")
            for (gemmaModel in TASK_GEMMA_3_270M.models) {
              if (!TASK_LLM_PROMPT_LAB.models.any { it.name == gemmaModel.name }) {
                Log.d(TAG, "Adding model ${gemmaModel.name} to LLM_PROMPT_LAB")
                TASK_LLM_PROMPT_LAB.models.add(gemmaModel)
              }
            }
          } catch (e: Exception) {
            Log.e(TAG, "Error processing model allowlist", e)
          }
          // Pre-process all tasks.
          try {
            processTasks()
          } catch (e: Exception) {
            Log.e(TAG, "Error processing tasks", e)
          }
          // Update UI state.
          val newUiState = createUiState()
          _uiState.update {
            newUiState.copy(
              loadingModelAllowlist = false,
            )
          }
          // Process pending downloads.
          try {
            processPendingDownloads()
          } catch (e: Exception) {
            Log.e(TAG, "Error processing pending downloads", e)
          }
        } ?: run {
          // Timeout occurred
          Log.e(TAG, "Model allowlist loading timed out")
          _uiState.update {
            uiState.value.copy(
              loadingModelAllowlist = false,
              loadingModelAllowlistError = "Model list loading timed out"
            )
          }
        }
      } catch (e: Exception) {
        Log.e(TAG, "Error in loadModelAllowlist", e)
        _uiState.update {
          uiState.value.copy(
            loadingModelAllowlist = false,
            loadingModelAllowlistError = "Failed to load model list: ${e.message}"
          )
        }
      }
    }
}Secara default, aplikasi mengasumsikan tugas yang saat ini dipilih cocok dengan model yang diklik. Setelah Anda menyuntikkan Gemma 3 270M ke dalam tugas Prompt Lab (Langkah 3), asumsi itu bisa tidak berlaku. Langkah ini membuat navigasi sadar model, sehingga ketukan, deep link, dan state yang dipulihkan selalu mengarah ke layar yang benar.
Buka navigation/GalleryNavGraph.kt dan perbarui logika kontrol navigasi model sebagai berikut:
Sebelum:
onModelClicked = { model ->
  navigateToTaskScreen(
    navController = navController, taskType = curPickedTask.type, model = model
  )
}
Sesudah:
onModelClicked = { model ->
  Log.d("GalleryNavGraph", "Model clicked: ${model.name}, current task: ${curPickedTask.type}")
  val actualTask = when {
    TASK_LLM_CHAT.models.any { it.name == model.name } -> TASK_LLM_CHAT
    TASK_LLM_PROMPT_LAB.models.any { it.name == model.name } -> TASK_LLM_PROMPT_LAB
    TASK_LLM_ASK_IMAGE.models.any { it.name == model.name } -> TASK_LLM_ASK_IMAGE
    TASK_TEXT_CLASSIFICATION.models.any { it.name == model.name } -> TASK_TEXT_CLASSIFICATION
    TASK_IMAGE_CLASSIFICATION.models.any { it.name == model.name } -> TASK_IMAGE_CLASSIFICATION
    TASK_IMAGE_GENERATION.models.any { it.name == model.name } -> TASK_IMAGE_GENERATION
    else -> curPickedTask
  }
  Log.d("GalleryNavGraph", "Navigating to task: ${actualTask.type} for model: ${model.name}")
  navigateToTaskScreen(
    navController = navController, taskType = actualTask.type, model = model
  )
}
Jika sebuah model muncul (atau disuntikkan) di tugas yang berbeda dari yang saat ini dipilih, kode ini memastikan layar sesuai dengan kemampuan model.
Saat menangani deep link atau state yang dipulihkan, aplikasi mungkin mencoba membuka model yang tidak lagi tersedia. Tanpa penanganan yang tepat, ini akan menghasilkan layar kosong. Untuk menghindarinya, kita menambahkan pemeriksaan keselamatan: jika model tidak ada, kita mencatat peringatan dan mengarahkan ulang pengguna. Begini caranya:
// Added error handling for model not found:
if (model != null) {
  Log.d("GalleryNavGraph", "Model found for LlmChat: ${model.name}")
  modelManagerViewModel.selectModel(model)
  LlmChatScreen(/* ... */)
} else {
  Log.w("GalleryNavGraph", "Model not found for LlmChat, modelName: ${it.arguments?.getString("modelName")}")
  // Handle case where model is not found
  androidx.compose.runtime.LaunchedEffect(Unit) {
    navController.navigateUp()
  }
}
Kode ini memastikan aplikasi tetap fungsional. Alih-alih macet atau menampilkan layar kosong, aplikasi menavigasi kembali dengan aman menggunakan navController. Dengan demikian, meski model tidak ada, alur pengguna tetap berjalan mulus tanpa merusak pengalaman keseluruhan.
Menjalankan model bahasa besar di perangkat seluler berbeda dengan menjalankannya di komputer desktop. Penyimpanan bisa tidak andal, anggaran memori lebih ketat, dan kegagalan inisialisasi perlu ditangani untuk menghindari crash aplikasi. Untuk membuat Gemma 3 270M (Q8, ~304MB) stabil di Android, saya menambahkan pemeriksaan keamanan tambahan dan strategi failover.
Sebelum memuat model, aplikasi melakukan pemeriksaan kewarasan pada file .task. Ini memastikan file model ada, dapat dibaca, dan mendekati ukuran yang diharapkan (dalam ±10%). Toleransi ini memperhitungkan perbedaan kecil karena kompresi atau pengemasan, sekaligus menangkap unduhan yang rusak atau parsial.
// File validation and logging
Log.d(TAG, "Checking model file: $modelPath")
Log.d(TAG, "Model file exists: ${modelFile.exists()}")
Log.d(TAG, "Model file can read: ${modelFile.canRead()}")
Log.d(TAG, "Model file size: ${modelFile.length()} bytes")
Log.d(TAG, "Model file absolute path: ${modelFile.absolutePath}")
// Size validation with tolerance (10%)
val expectedSize = model.sizeInBytes
val fileSize = modelFile.length()
val sizeDifference = kotlin.math.abs(fileSize - expectedSize)
val sizeTolerance = (expectedSize * 0.1).toLong()
if (!modelFile.exists() || !modelFile.canRead() || sizeDifference > sizeTolerance) {
  onDone("Model file invalid (missing/unreadable/wrong size).")
  return
}
Potongan kode ini memvalidasi file model sebelum memuatnya. Ia mencatat detail dasar seperti path, keterbacaan, dan ukuran, lalu memeriksa apakah file ada, dapat dibaca, dan sesuai dengan ukuran yang diharapkan. Jika ada pemeriksaan yang gagal, fungsi dihentikan lebih awal melalui metode onDone() alih-alih mencoba inferensi dan berisiko crash.
Model besar dapat menimbulkan error Out-Of-Memory (OOM) jika Anda mulai agresif (keluaran panjang, lonjakan alokasi GPU). Untuk menguranginya, saya menambahkan logika untuk secara dinamis memilih backend yang paling aman (CPU vs GPU/NPU) berdasarkan ukuran file dan konfigurasi perangkat, sekaligus memangkas token maksimal untuk binary berukuran besar.
val preferredBackend = when {
  fileSize > 200_000_000L -> {
    Log.d(TAG, "Model is large (${fileSize / 1024 / 1024}MB), using CPU backend for safety")
    LlmInference.Backend.CPU
  }
  accelerator == Accelerator.CPU.label -> LlmInference.Backend.CPU
  accelerator == Accelerator.GPU.label -> LlmInference.Backend.GPU
  else -> LlmInference.Backend.CPU
}
val baseMaxTokens = 1024 // your default; tune to taste
val maxTokens = if (fileSize > 200_000_000L) {
  kotlin.math.min(baseMaxTokens, 512)
} else {
  baseMaxTokens
}
Ini memastikan model besar default ke CPU (lebih aman namun lebih lambat). Kode memeriksa ukuran byte file .task (fileSize) dan membandingkannya dengan ambang (maxTokens). Jika melebihi 200 MB, ia mengalihkan inferensi ke CPU dan mengurangi separuh batas token. Ini melindungi dari lonjakan memori (dari alokasi GPU simultan) dan permintaan generasi berukuran berlebihan.
Saat menginisialisasi LiteRT, penting untuk membedakan antara pembuatan runtime dan pembuatan sesi. Jika pembuatan sesi gagal tetapi runtime dibiarkan terbuka, Anda bisa membocorkan resource dan mengunci memori, menyebabkan kegagalan beruntun. Untuk mengatasinya, saya membungkus kode dalam blok try/catch dengan pembersihan eksplisit.
val llmInference = try {
  LlmInference.createFromOptions(context, options)
} catch (e: Exception) {
  Log.e(TAG, "Failed to create LlmInference instance", e)
  onDone("Failed to create model instance: ${e.message}")
  return
}
val session = try {
  LlmInferenceSession.createFromOptions(/* ... */)
} catch (e: Exception) {
  Log.e(TAG, "Failed to create LlmInferenceSession", e)
  try {
    llmInference.close()
  } catch (closeException: Exception) {
    Log.e(TAG, "Failed to close LlmInference after session creation failure", closeException)
  }
  onDone("Failed to create model session: ${e.message}")
  return
}
Try/catch ini menjamin rollback yang bersih, yaitu jika pembuatan runtime gagal, tidak ada hal lain yang dilanjutkan, tetapi jika pembuatan sesi gagal, runtime ditutup secara eksplisit. Ini memastikan objek llmInference yang dialokasikan di heap dibuang melalui .close(), melepaskan memori dan file handle. Tanpa ini, Anda berisiko memiliki referensi JNI yang crash pada pemuatan model berikutnya.
Bahkan jika model berhasil dimuat, inferensi dapat gagal karena race condition, referensi null, atau instance yang tidak terinisialisasi. Untuk memperkuat langkah ini, saya menambahkan pemeriksaan null dan menangkap pengecualian di sekitar blok inferensi penuh.
try {
  Log.d(TAG, "Starting inference for model '${model.name}' with input: '${input.take(50)}...'")
  val instance = model.instance as LlmModelInstance? ?: run {
    Log.e(TAG, "Model instance is null for '${model.name}'")
    resultListener("Error: Model not initialized", true)
    return
  }
} catch (e: Exception) {
  Log.e(TAG, "Error during inference for model '${model.name}'", e)
  resultListener("Error during inference: ${e.message}", true)
}
Kode di atas memastikan inferensi hanya dilanjutkan dengan instance model yang valid dan menangkap error runtime dengan rapi. Casting as LlmModelInstance? memeriksa apakah instance model bertipe benar dan fallback ala Elvis memutus eksekusi jika null. Membungkus blok dalam try/catch memastikan pengecualian ditangkap dan dikirim kembali sebagai pesan error yang terlihat oleh pengguna.
Setelah Anda melakukan semua perubahan yang diperlukan, kita akan menjalankan aplikasi. Untuk menjalankan aplikasi di perangkat Android lokal, pasangkan perangkat Android Anda dengan Android Studio menggunakan wireless debugging melalui langkah-langkah berikut.
Masuk ke aplikasi Pengaturan di perangkat Android Anda dan aktifkan Opsi pengembang. Lalu aktifkan Debugging nirkabel. Anda akan melihat layar dengan dua opsi pairing.
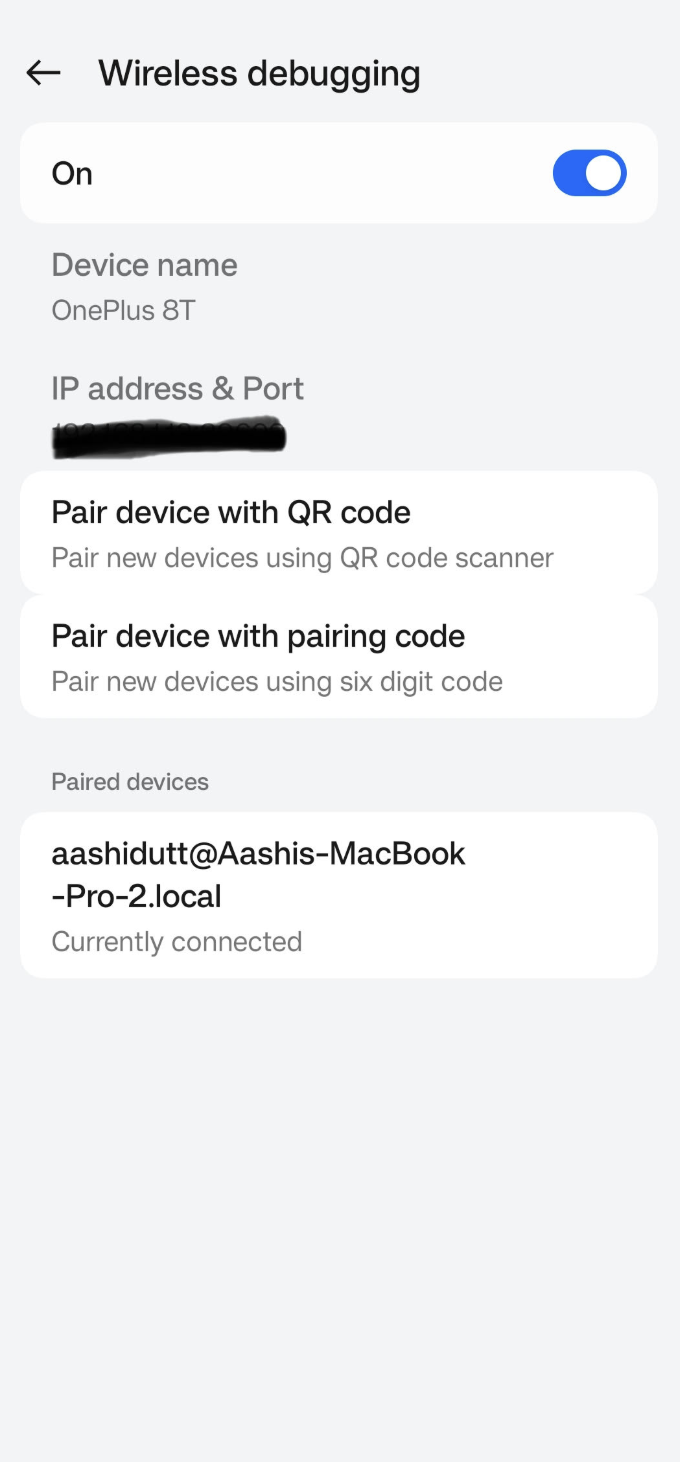
Di Android Studio, buka Device Manager (ikonnya menyerupai ponsel dengan logo Android) dan klik Pair using QR code.
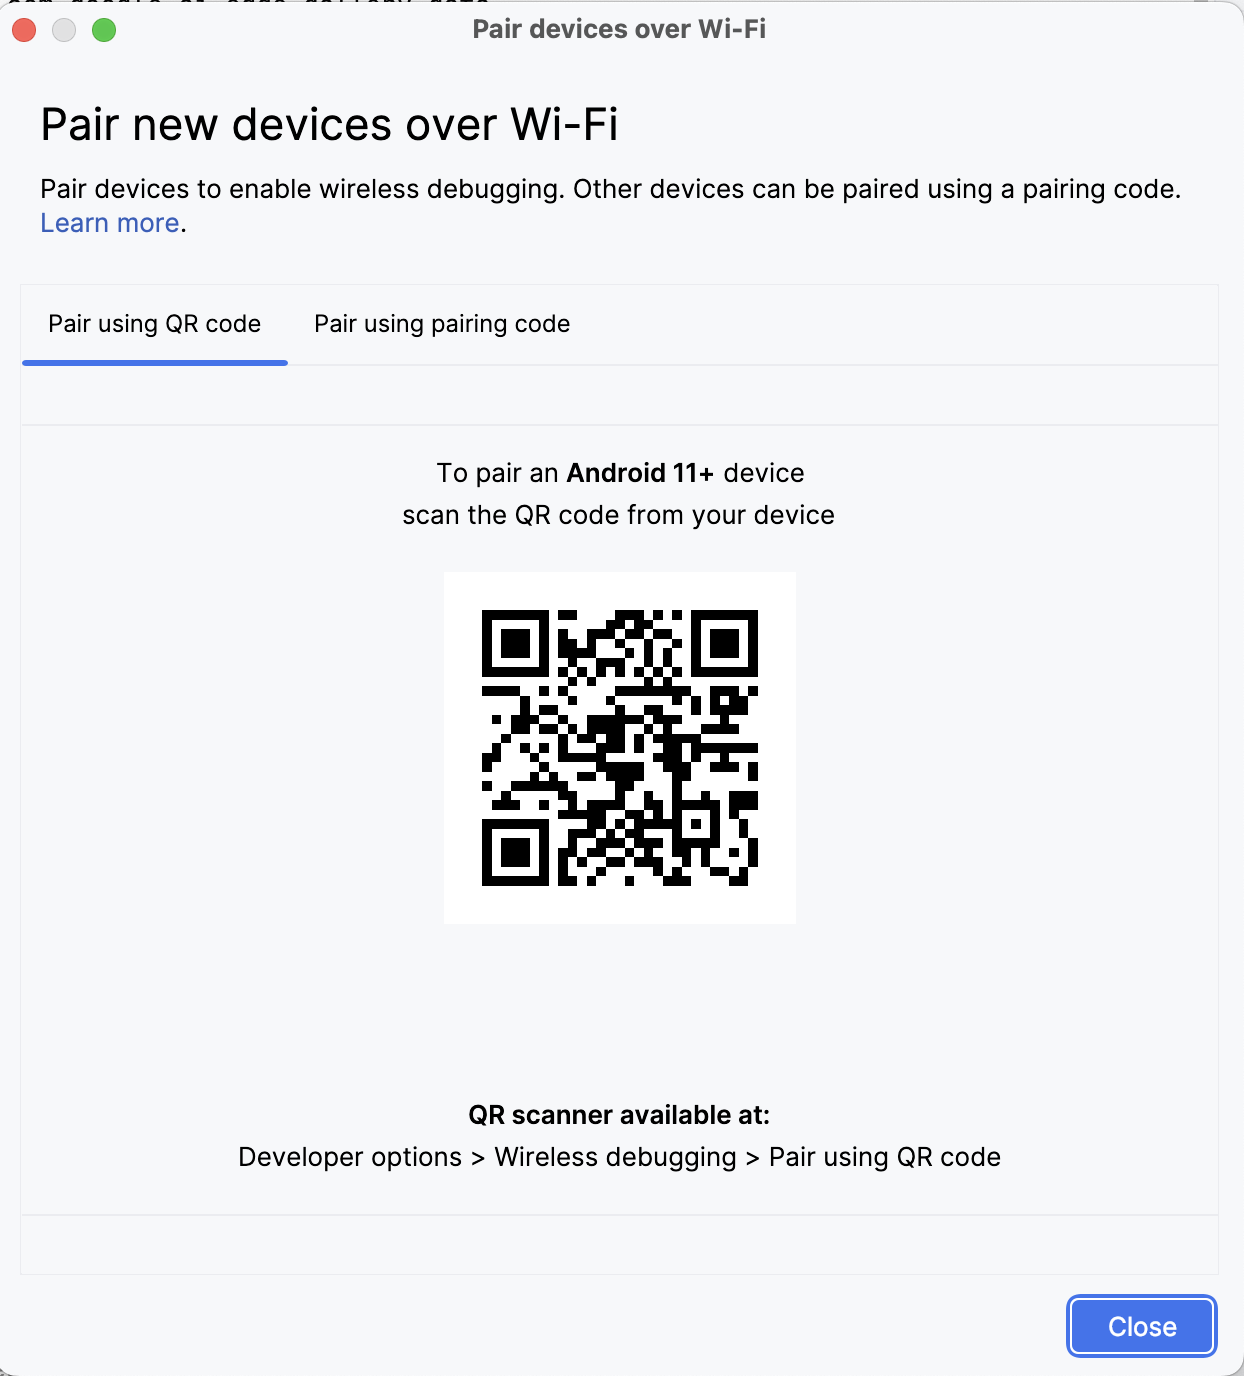
Pindai kode QR menggunakan perangkat Anda dan selesaikan pengaturan pairing. Setelah perangkat terhubung, Anda akan melihat nama perangkat di Device Manager. Pastikan sistem dan perangkat Android Anda terhubung ke jaringan WiFi yang sama.
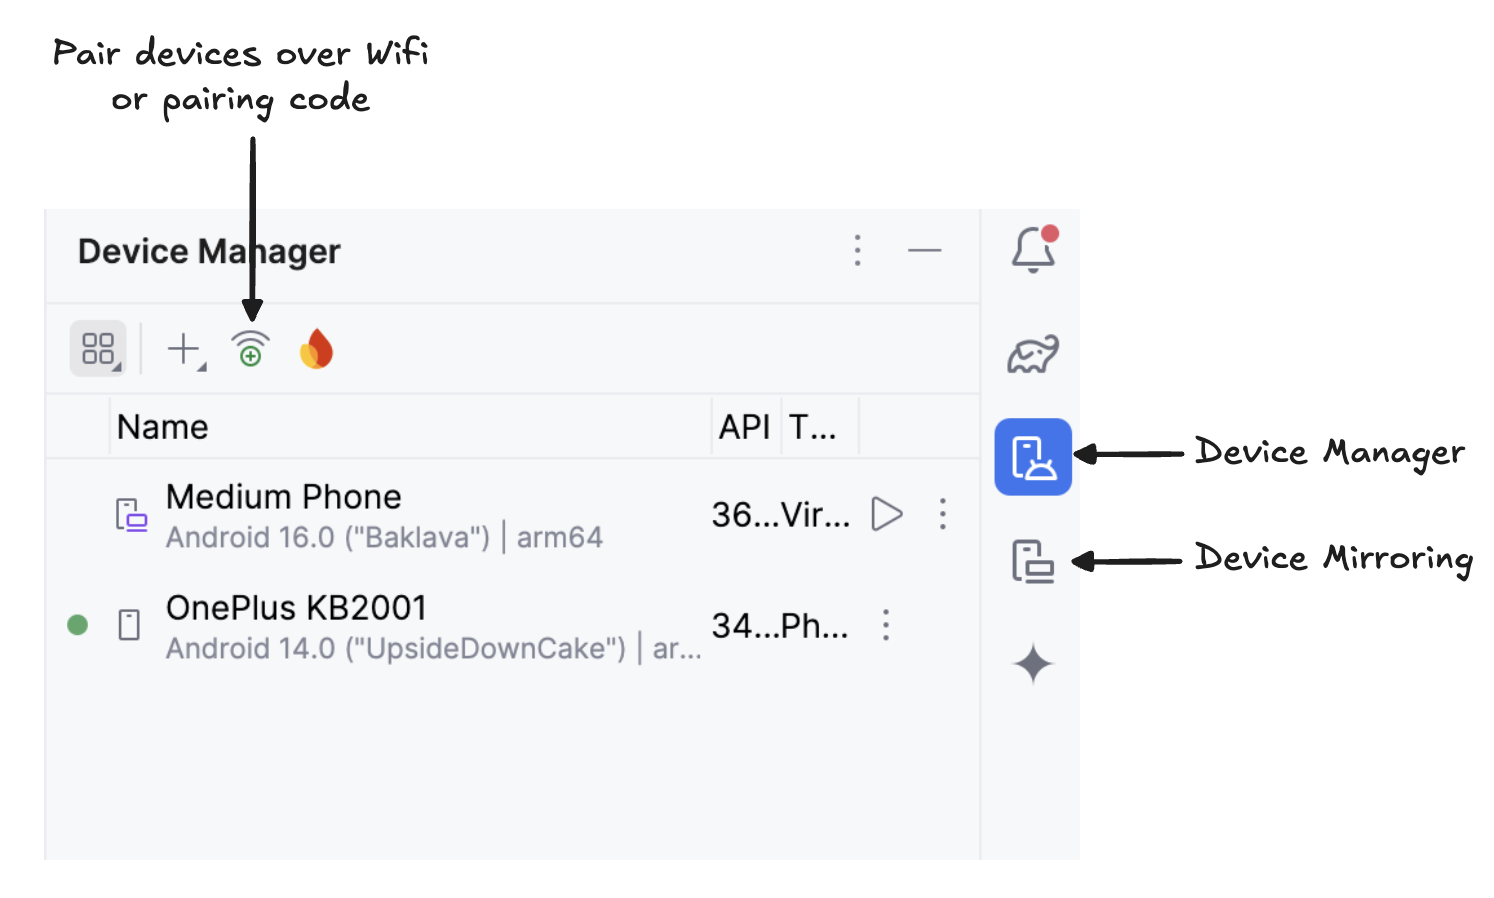
Mulai mirroring perangkat Android Anda dengan mengklik ikon Device Mirroring (yang menggambarkan layar desktop dan layar ponsel). Setelah Anda melihat layar perangkat tercermin, klik ikon hijau Run untuk menerapkan aplikasi ke perangkat Anda.
Aplikasi akan diluncurkan, dan jendela browser akan terbuka, meminta Anda masuk ke Hugging Face menggunakan token write untuk mengunduh file model secara aman.
Setelah Anda masuk ke HuggingFace, klik start download pada model pilihan, dan model Anda akan mulai diunduh. Untuk contoh ini, saya menggunakan model gemma3-270m-it-q8 secara default. Sekarang Anda dapat mulai bereksperimen dengan model ini.
Demi tutorial ini, saya menjalankan empat eksperimen:
Dalam eksperimen ini, saya meminta model untuk menulis cerita bebas, dan berikut hasilnya:
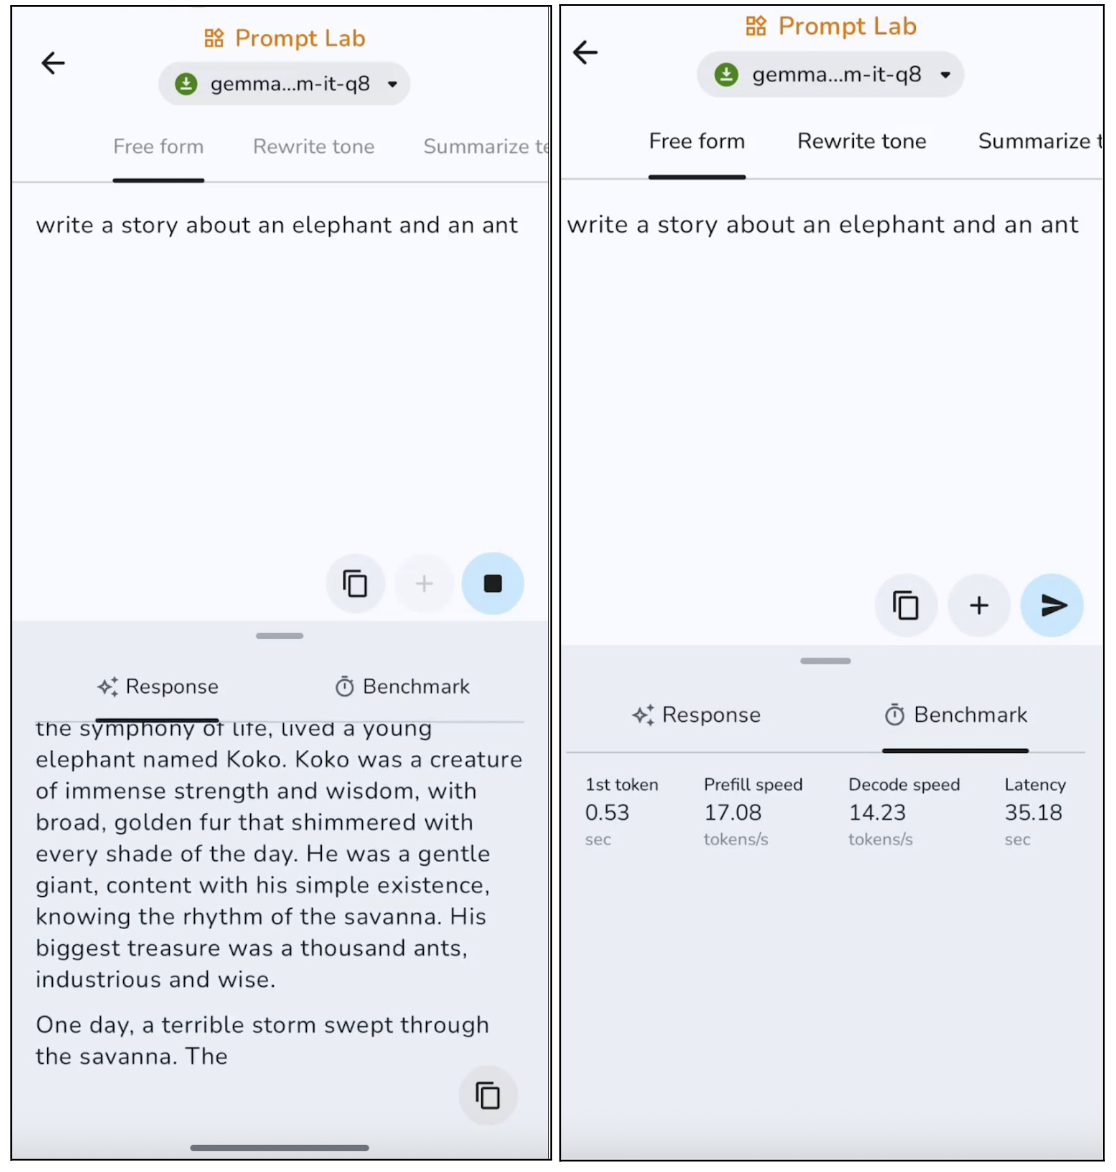
Model menghasilkan teks yang sesuai topik dengan struktur jelas, meski cenderung bermain aman dan terdengar agak generik. Pada keluaran yang lebih panjang, model biasanya mengulang beberapa kalimat. Ini membuatnya paling cocok untuk posting singkat, deskripsi, dan kerangka. Namun, generasi token pertama cukup cepat sekitar 0,53 detik, dan kecepatan decode juga baik untuk inferensi di perangkat.
Berikutnya, saya menggunakan paragraf yang sudah ditulis dan meminta Gemma 3 270M untuk menulis ulang paragraf tersebut dengan nada ramah.
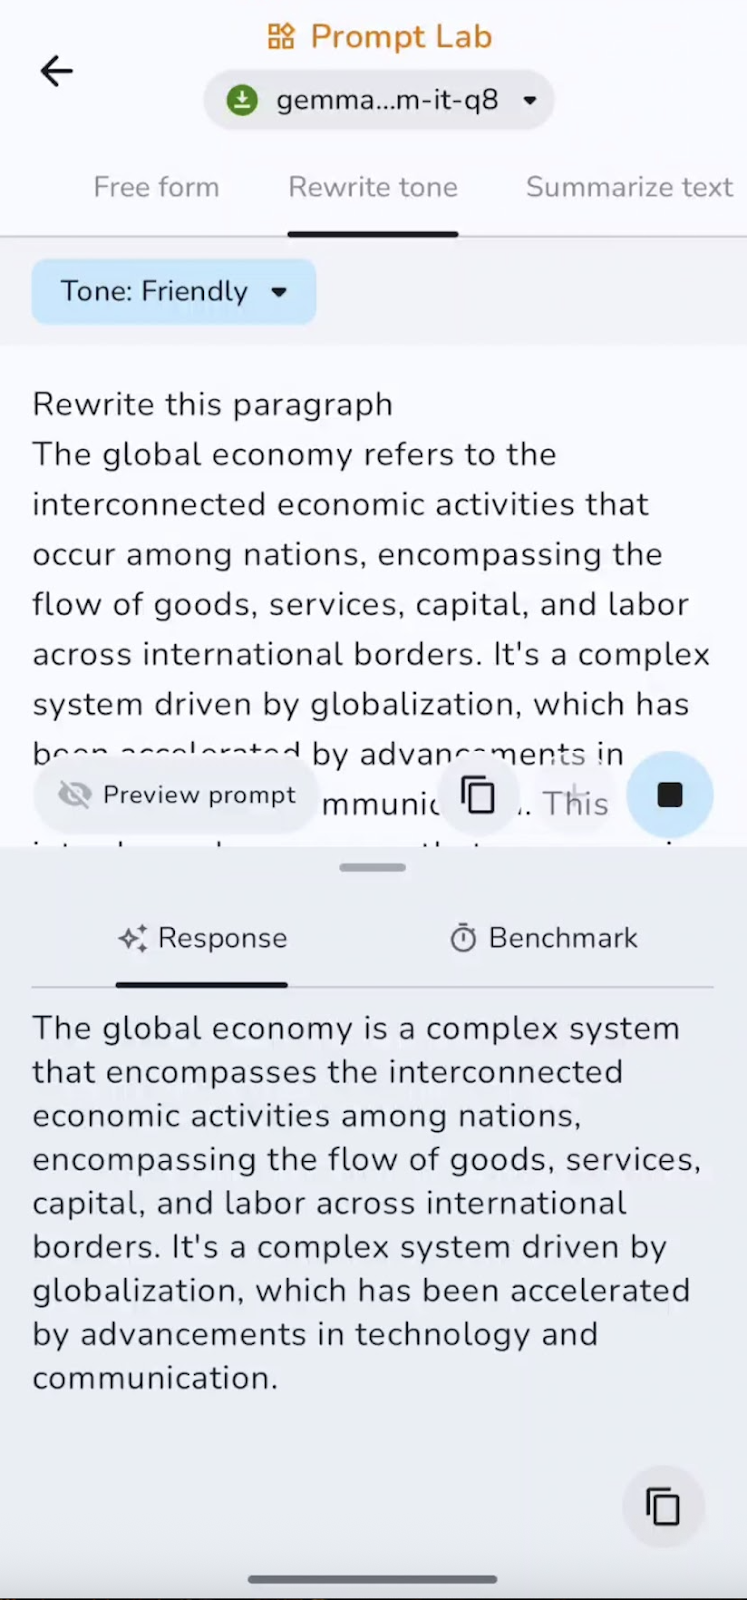
Kemampuan mengikuti instruksi kuat, dengan peralihan jelas antara nada formal, kasual, dan ramah sambil mempertahankan makna. Kecepatannya nyaris instan untuk potongan pendek, sehingga cocok untuk memoles email atau mengonversi teks antargaya.
Saya juga merangkum teks yang sudah ditulis menjadi poin-poin. Anda dapat bereksperimen dengan ringkasan, poin, hal-hal penting, dan lainnya.
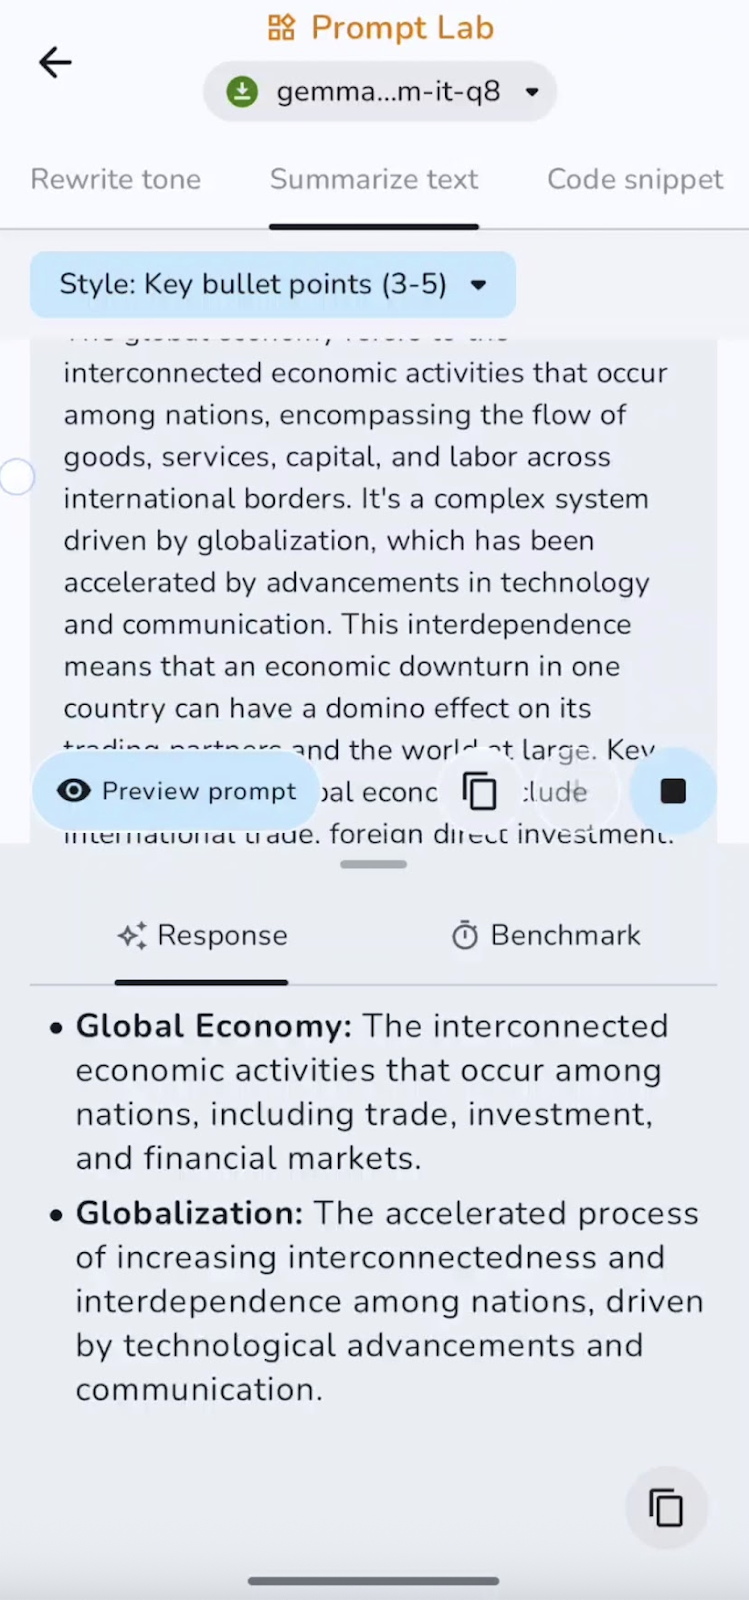
Dalam eksperimen ini, model merangkum dan menangkap poin-poin kunci. Kecepatannya sangat baik untuk dokumen pendek dan menengah. Beberapa use case-nya adalah ringkasan eksekutif, sorotan poin, atau TL;DR.
Terakhir, saya meminta model menulis cuplikan kode kecil. Berikut temuan saya:
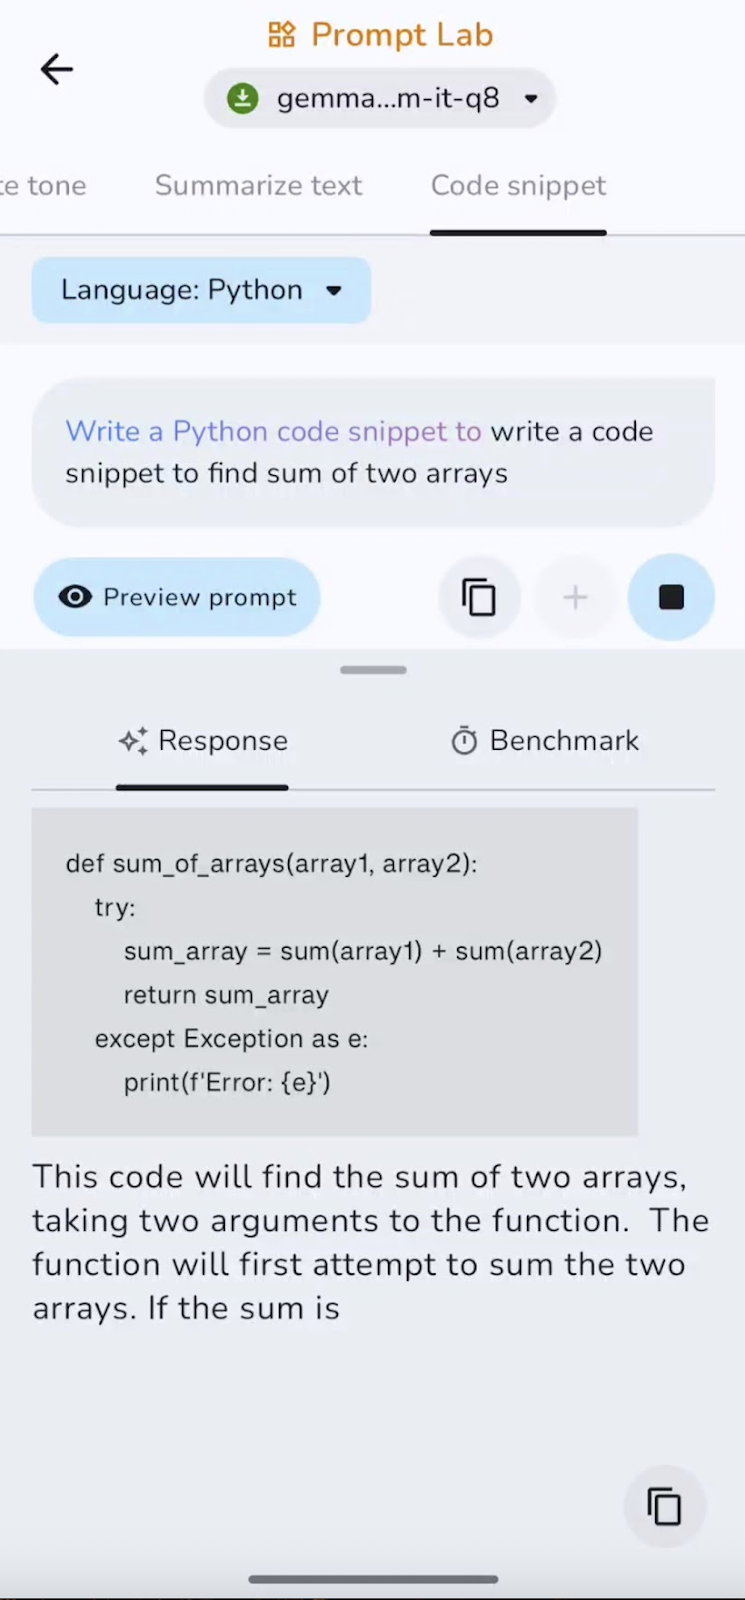
Model efektif dalam menghasilkan boilerplate dan utilitas kecil, meski dapat melewatkan impor, edge case, atau logika kompleks tanpa pengarahan. Cuplikan pendek dihasilkan dengan cepat, sementara penyelesaian yang lebih panjang sedikit melambat seiring bertambahnya konteks. Paling cocok untuk fungsi pembantu dan konfigurasi.
Saya telah menyiapkan repositori GitHub ini jika Anda ingin menjelajahi kode proyek lengkap.
Dalam panduan ini, kita melangkah selangkah demi selangkah menjalankan model Gemma 3 270M, mulai dari mengunduh dan menyambungkan model ke aplikasi Android kustom, hingga menangani navigasi, keandalan, dan keamanan saat inferensi.
Gemma 3 menawarkan inferensi cepat dengan beban komputasi rendah, sangat hemat daya, mendukung kuantisasi INT4 dengan dampak minimal pada kinerja, dan berjalan sepenuhnya di perangkat untuk menjaga privasi.
Pelajari AI dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt



