{count, plural, one {Kursus} other {Kursus}}
Membangun Agen AI dengan Google ADK
{hours} jam
7.6K
GPT-OSS adalah seri model open-weight pertama dari OpenAI, dan Anda dapat menjalankannya langsung di komputer Anda sendiri. Dirancang untuk penalaran yang kuat, tugas agen, dan kasus penggunaan pengembang yang fleksibel, GPT-OSS menonjol karena upaya penalaran yang dapat dikonfigurasi dan kemampuan chain-of-thought yang transparan.
Dalam tutorial ini, saya akan memandu Anda menyiapkan model GPT-OSS OpenAI secara lokal menggunakan Ollama dan menunjukkan cara membangun demo interaktif yang menampilkan kemampuan penalaran unik model tersebut. Kita akan mengeksplorasi fitur chain-of-thought yang dapat dikonfigurasi dan membangun aplikasi Streamlit yang memvisualisasikan proses berpikir model.
Kami terus memperbarui pembaca tentang perkembangan terbaru AI melalui The Median, buletin gratis setiap Jumat yang merangkum berita-berita utama pekan ini. Berlangganan dan tetap up-to-date hanya dalam beberapa menit setiap minggu:
Seri GPT-OSS dari OpenAI menandai rilis open-weight pertama mereka sejak GPT-2, yang memberikan akses ke model penalaran berkinerja tinggi di bawah lisensi Apache 2.0. Model bahasa mutakhir ini memberikan kinerja kuat dengan biaya rendah dan mengungguli model open-source berukuran serupa pada tugas penalaran.
Ada dua varian: gpt-oss-120b dan gpt-oss-20b.
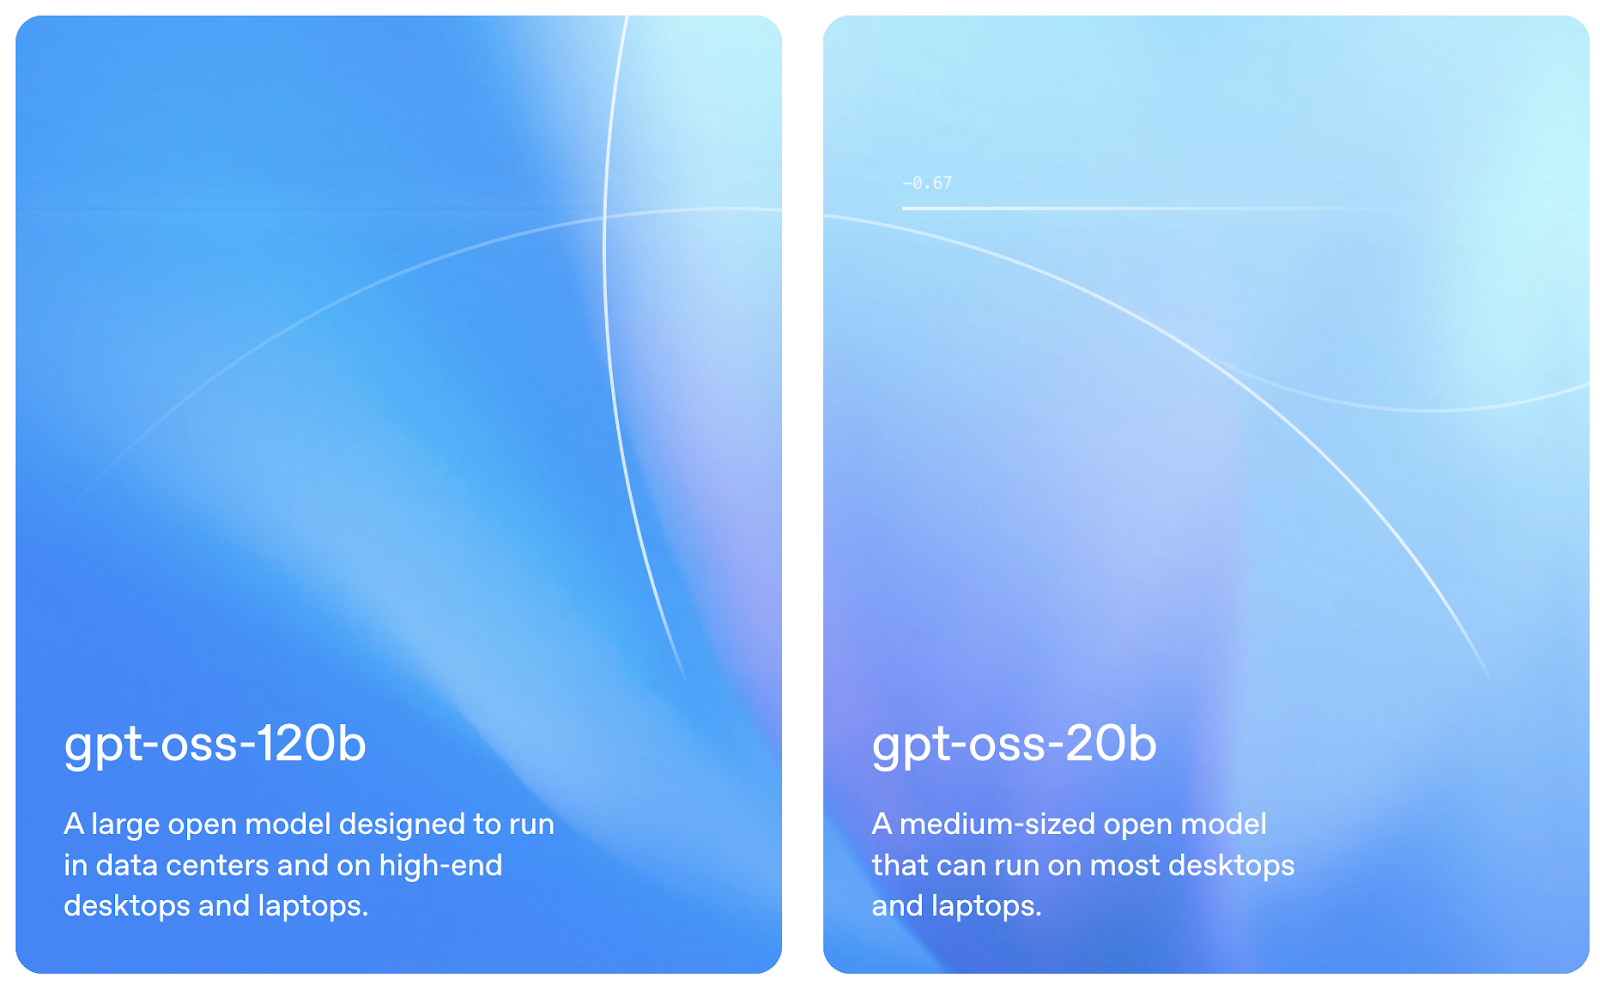
Sumber: OpenAI
gpt-oss-120b adalah model open-weight unggulan OpenAI, dengan performa yang menyaingi sistem proprieter seperti o4‑mini pada tolok ukur penalaran yang sulit. Meskipun berukuran 117 miliar parameter, model ini dioptimalkan untuk berjalan pada satu GPU 80 GB. Ini membuatnya realistis untuk laboratorium riset dan tim perusahaan yang ingin meng-host model bahasa yang kuat secara lokal.
Model ini dirancang untuk mendukung alur kerja kompleks seperti penggunaan alat, penalaran multi-langkah, dan kontrol terperinci atas seberapa banyak upaya “berpikir” yang dicurahkan untuk setiap tugas. Sifat open-weight dan lisensi Apache 2.0 menjadikannya pilihan fleksibel bagi tim yang ingin menelaah secara mendalam, menyesuaikan, atau melakukan fine-tuning pada model.
gpt-oss-20b menghadirkan kekuatan penalaran yang mengesankan dalam jejak yang muat di laptop konsumen. Dengan hanya 21 miliar parameter, model ini tetap mengungguli o3-mini milik OpenAI pada beberapa tolok ukur dan berjalan efisien pada perangkat dengan memori 16 GB. Model ini telah dikuantisasi dan disiapkan untuk penerapan lokal yang cepat, serta kompatibel dengan alat seperti Ollama, vLLM, dan bahkan platform Metal dari Apple.
Model ini ideal bagi pengembang yang ingin membangun aplikasi AI yang responsif dan privat tanpa bergantung pada infrastruktur cloud. Seperti kakaknya yang lebih besar, model ini mendukung kedalaman penalaran yang dapat diatur dan langkah-langkah perantara yang jelas—sangat cocok untuk eksperimen, asisten ringan, dan aplikasi perangkat edge.
Menjalankan GPT-OSS secara lokal menawarkan beberapa keunggulan kuat dibandingkan alternatif berbasis cloud:
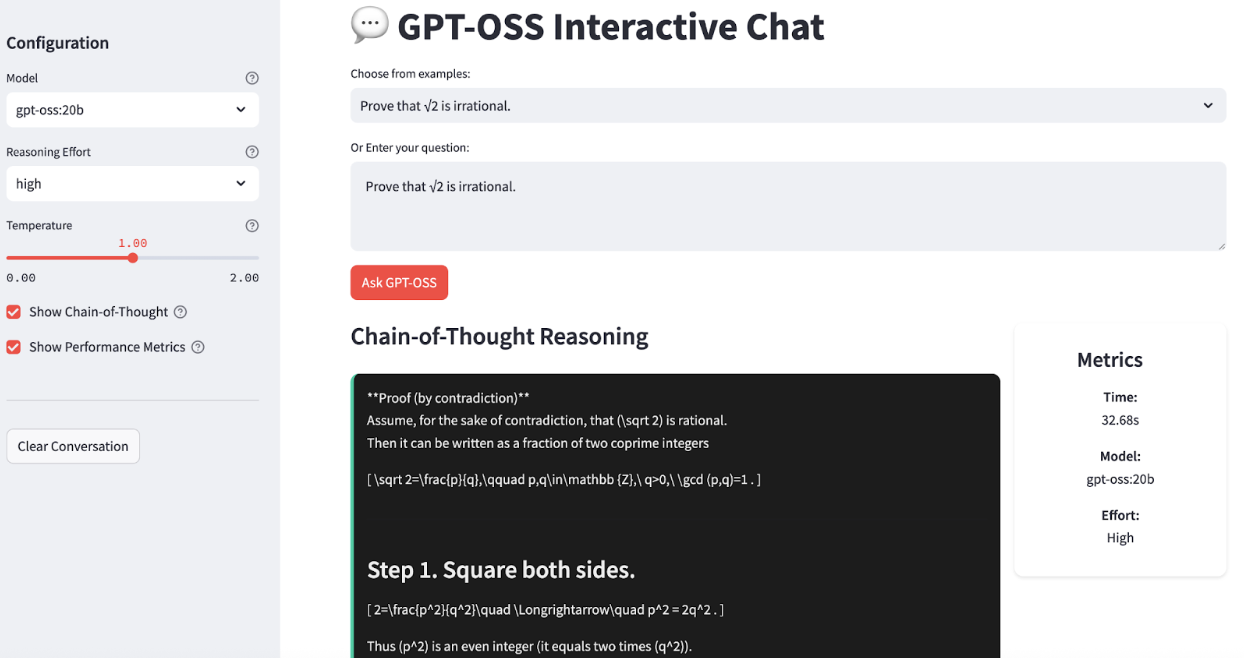
Ollama mempermudah menjalankan model bahasa besar secara lokal dengan menangani unduhan, kuantisasi, dan eksekusi. Saya akan memandu Anda langkah demi langkah menyiapkan GPT-OSS di sistem Anda. Pada akhirnya, aplikasi kita akan tampak seperti ini:
Pertama, unduh dan instal Ollama dari situs resmi.
Setelah terpasang, Anda dapat memverifikasi instalasi dengan membuka terminal dan mengetik:
ollama --versionPerintah ini akan menampilkan versi Ollama terbaru yang terpasang di sistem Anda.
OpenAI menyediakan dua varian GPT-OSS yang dioptimalkan untuk kasus penggunaan berbeda, tetapi untuk keperluan demo ini, kita akan mengambil hanya varian model gpt-oss-20b:
# Untuk produksi dan tugas penalaran tingkat tinggi
ollama pull gpt-oss:120b
# Untuk latensi lebih rendah dan penerapan lokal
ollama pull gpt-oss:20b
Model 20B sangat cocok untuk pengembangan lokal dan dapat berjalan pada sistem dengan memori 16GB+, sedangkan model 120B menawarkan kemampuan lebih tetapi memerlukan memori 80GB+.
Mari verifikasi semuanya berfungsi dengan benar:
ollama run gpt-oss:20bAnda akan melihat prompt tempat Anda bisa berinteraksi langsung dengan model. Coba ajukan: "Buktikan bahwa √2 itu irasional."
Sekarang mari kita cepat membangun aplikasi sederhana yang menampilkan kemampuan penalaran GPT-OSS. Aplikasi kita akan memiliki fitur:
Jalankan perintah berikut untuk memasang dependensi yang diperlukan:
pip install streamlit ollamaCuplikan kode di atas memasang Streamlit untuk membangun antarmuka web dan klien Python Ollama untuk interaksi model GPT-OSS lokal.
Sebelum masuk ke logika inti chat, kita perlu membawa semua alat dan menyiapkan antarmuka pengguna.
import streamlit as st
import json
import ollama
import time
from typing import Dict, Any, List
import re
from datetime import datetime

# Configure page
st.set_page_config(
    page_title="GPT-OSS Chat Demo",
    layout="wide",
    page_icon="💬"
)
# Custom CSS for UI
st.markdown("""
<style>
.reasoning-box {
    background-


    border-radius: 10px;
    border-left: 4px solid #00d4aa;

}
.answer-box {
    background-

    border-radius: 10px;
    border-left: 4px solid #007bff;

}
.metric-card {
    background-

    border-radius: 10px;
    box-shadow: 0 2px 4px rgba(0,0,0,0.1);
    text-align: center;

}
.chat-message {


    border-radius: 10px;
}
.user-message {
    background-
    border-left: 4px solid #2196f3;
}
.assistant-message {
    background-
    border-left: 4px solid #9c27b0;
}
</style>
""", unsafe_allow_html=True)
Kita mengimpor beberapa paket inti seperti Streamlit untuk antarmuka web, Ollama untuk memanggil model GPT-OSS lokal, beserta modul utilitas seperti json, time, typing, dan re. Lalu kita menggunakan st.set_page_config() untuk memberi judul halaman, tata letak lebar, dan ikon, serta menyuntikkan CSS ringan agar langkah penalaran dan jawaban tampil pada panel yang berbeda.
Dengan kerangka UI siap, mari bangun fungsi integrasi model inti call_model():
def call_model(messages: List[Dict], model_name: str = "gpt-oss:20b", temperature: float = 1.0) -> Dict[str, Any]:
    try:
        start_time = time.time()
        # Prepare options for Ollama
        options = {
            'temperature': temperature,
            'top_p': 1.0,
        }
        response = ollama.chat(
            model=model_name,
            messages=messages,
            options=options
        )
        end_time = time.time()
        if isinstance(response, dict) and 'message' in response:
            content = response['message'].get('content', '')
        elif hasattr(response, 'message'):
            content = getattr(response.message, 'content', '')
        else:
            content = str(response)
        return {
            'content': content,
            'response_time': end_time - start_time,
            'success': True
        }
    except Exception as e:
        return {
            'content': f"Error: {e}",
            'response_time': 0,
            'success': False
        }
Kode di atas:
start_time dan end_time di sekitar pemanggilan ollama.chat() untuk melaporkan waktu respons kembali ke pengguna.call_model() membungkus seluruh pemanggilan dalam blok try/except untuk menangkap kesalahan.Agar demo benar-benar transparan, kita perlu memisahkan “monolog internal” model dari kesimpulan akhirnya. Fungsi parse_reasoning_response() melakukan hal itu:
def parse_reasoning_response(content: str) -> Dict[str, str]:
    patterns = [
        r"<thinking>(.*?)</thinking>",
        r"Let me think.*?:(.*?)(?=\n\n|\nFinal|Answer:)",
        r"Reasoning:(.*?)(?=\n\n|\nAnswer:|\nConclusion:)",
    ]
    reasoning = ""
    answer = content
    for pat in patterns:
        m = re.search(pat, content, re.DOTALL | re.IGNORECASE)
        if m:
            reasoning = m.group(1).strip()
            answer = content.replace(m.group(0), "").strip()
            break
    if not reasoning and len(content.split('\n')) > 3:
        lines = content.split('\n')
        for i, l in enumerate(lines):
            if any(k in l.lower() for k in ['therefore', 'in conclusion', 'final answer', 'answer:']):
                reasoning = '\n'.join(lines[:i]).strip()
                answer = '\n'.join(lines[i:]).strip()
                break
    return {
        'reasoning': reasoning or "No explicit reasoning detected.",
        'answer': answer or content
    }
Kita memisahkan “pemikiran” tersembunyi model dari kesimpulan akhirnya sehingga pengguna dapat secara opsional meninjau setiap langkah penalaran. Begini cara respons diurai:
<thinking>…</thinking> atau frasa seperti “Reasoning:” dan “Let me think through” dengan ekspresi reguler.parse_reasoning_response() selalu mengembalikan jawaban.Sekarang setelah setiap blok penyusun selesai dibuat, berikutnya kita merangkainya menjadi aplikasi chat interaktif.
# Initialize history
if 'history' not in st.session_state:
    st.session_state.history = []
# Sidebar for settings
with st.sidebar:
    st.header("Configuration")
    model_choice = st.selectbox(
        "Model",
        ["gpt-oss:20b", "gpt-oss:120b"],
        help="Choose between 20B (faster) or 120B (more capable)"
    )
    effort = st.selectbox(
        "Reasoning Effort",
        ["low", "medium", "high"],
        index=1,
        help="Controls depth of reasoning shown"
    )
    temperature = st.slider(
        "Temperature",
        0.0, 2.0, 1.0, 0.1,
        help="Controls response randomness"
    )
    show_reasoning = st.checkbox(
        "Show Chain-of-Thought",
        True,
        help="Display model's thinking process"
    )
    show_metrics = st.checkbox(
        "Show Performance Metrics",
        True,
        help="Display response time and model info"
    )
    st.markdown("---")
    if st.button("Clear Conversation"):
        st.session_state.history = []
        st.rerun()
# Main Chat Interface
st.title("💬 GPT-OSS Interactive Chat")
examples = [
    "",
    "If a train travels 120km in 1.5 hours, then 80km in 45 minutes, what's its average speed?",
    "Prove that √2 is irrational.",
    "Write a function to find the longest palindromic substring.",
    "Explain quantum entanglement in simple terms.",
    "How would you design a recommendation system?",
]
selected_from_dropdown = st.selectbox("Choose from examples:", examples)
# Get the question text
question_value = ""
if hasattr(st.session_state, 'selected_example'):
    question_value = st.session_state.selected_example
    del st.session_state.selected_example
elif selected_from_dropdown:
    question_value = selected_from_dropdown
question = st.text_area(
    "Or Enter your question:",
    value=question_value,
    height=100,
    placeholder="Ask anything! Try different reasoning effort levels to see how the model's thinking changes..."
)
# Submit button
col1, col2 = st.columns([1, 4])
with col1:
    submit_button = st.button("Ask GPT-OSS", type="primary")
if submit_button and question.strip():
    # System prompts
    system_prompts = {
        'low': 'You are a helpful assistant. Provide concise, direct answers.',
        'medium': f'You are a helpful assistant. Show brief reasoning before your answer. Reasoning effort: {effort}',
        'high': f'You are a helpful assistant. Show complete chain-of-thought reasoning step by step. Think through the problem carefully before providing your final answer. Reasoning effort: {effort}'
    }
    # Message history
    msgs = [{'role': 'system', 'content': system_prompts[effort]}]
    msgs.extend(st.session_state.history[-6:])
    msgs.append({'role': 'user', 'content': question})
    with st.spinner(f"GPT-OSS thinking ({effort} effort)..."):
        res = call_model(msgs, model_choice, temperature)
    if res['success']:
        parsed = parse_reasoning_response(res['content'])
        st.session_state.history.append({'role': 'user', 'content': question})
        st.session_state.history.append({'role': 'assistant', 'content': res['content']})
        col1, col2 = st.columns([3, 1] if show_metrics else [1])
        with col1:
            if show_reasoning and parsed['reasoning'] != 'No explicit reasoning detected.':
                st.markdown("### Chain-of-Thought Reasoning")
                st.markdown(f"<div class='reasoning-box'>{parsed['reasoning']}</div>", unsafe_allow_html=True)
            st.markdown("### Answer")
            st.markdown(f"<div class='answer-box'>{parsed['answer']}</div>", unsafe_allow_html=True)
        if show_metrics:
            with col2:
                st.markdown(f"""
                <div class="metric-card">
                    <h4> Metrics</h4>
                    <p><strong>Time:</strong><br>{res['response_time']:.2f}s</p>
                    <p><strong>Model:</strong><br>{model_choice}</p>
                    <p><strong>Effort:</strong><br>{effort.title()}</p>
                </div>
                """, unsafe_allow_html=True)
    else:
        st.error(f"{res['content']}")
if st.session_state.history:
    st.markdown("---")
    st.subheader("Conversation History")
    recent_history = st.session_state.history[-8:]  # Last 8 messages (4 exchanges)
    for i, msg in enumerate(recent_history):
        if msg['role'] == 'user':
            st.markdown(f"""
            <div class="chat-message user-message">
                <strong>You:</strong> {msg['content']}
            </div>
            """, unsafe_allow_html=True)
        else:
            parsed_hist = parse_reasoning_response(msg['content'])
            with st.expander(f"GPT-OSS Response", expanded=False):
                if parsed_hist['reasoning'] != 'No explicit reasoning detected.':
                    st.markdown("**Reasoning Process:**")
                    st.code(parsed_hist['reasoning'], language='text')
                st.markdown("**Final Answer:**")
                st.markdown(parsed_hist['answer'])
# Footer
st.markdown("---")
st.markdown("""
<div style='text-align: center;'>
    <p><strong>Powered by GPT-OSS-20B via Ollama</strong></p>
</div>
""", unsafe_allow_html=True)
Pada langkah terakhir ini, kita menyatukan semua bagian aplikasi, termasuk session state, kontrol sidebar, contoh prompt, perakitan pesan, pemanggilan model, parsing, dan penayangan dalam satu loop:
st.session_state.history untuk menyimpan setiap pertukaran pengguna–asisten di setiap rerun.call_model(), yang:parse_reasoning_response(), kita membagi keluaran model menjadi respons chain-of-thought yang disebut “reasoning” dan respons yang dibersihkan yang disebut “answer”.st.session_state.history, sehingga pada run berikutnya keduanya disertakan untuk konteks.Untuk mencoba sendiri, simpan kode sebagai gpt_oss_demo.py dan jalankan:
streamlit run gpt_oss_demo.pyPelajari AI dengan kursus-kursus ini!
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt



