
Kursus
Mengembangkan Aplikasi LLM dengan LangChain
3 jam
52K
Pernahkah Anda bermimpi menjalankan ChatGPT versi Anda sendiri langsung di laptop?
Dengan kemajuan pesat Large Language Models (LLM), kemungkinan membawa model-model bertenaga besar tersebut ke perangkat konsumen semakin menjadi kenyataan.
Kunci untuk membuka potensi ini terletak pada kuantisasi, sebuah teknik yang memungkinkan pengurangan ukuran model yang kian membesar agar dapat berjalan di perangkat sehari-hari dengan degradasi kinerja minimal — jika diimplementasikan dengan benar!
Dalam panduan ini, kita akan membahas konsep kuantisasi, menjelaskan cara kerjanya, dan berbagai kemungkinan untuk mengkuantisasi LLM. Terakhir, kita akan mengkuantisasi model kita dalam dua langkah sederhana menggunakan pustaka Quanto dari Hugging Face.
Mari kita menyelam lebih dalam! Anda dapat mengikutinya menggunakan DataCamp DataLab.
Seiring perkembangan LLM, kompleksitasnya tumbuh secara eksponensial, yang menyebabkan peningkatan signifikan pada jumlah parameternya. Misalnya, model GPT pertama yang diluncurkan pada 2018 memiliki 0,11 miliar parameter. Pada akhir 2019, GPT-2 meningkat menjadi 1,5 miliar, dan GPT-3 yang dirilis pada akhir 2020 melonjak hingga 175 miliar parameter.
Saat ini, GPT-4 memiliki lebih dari 1 triliun parameter. Peningkatan besar ini menghadirkan tantangan: seiring bertambahnya ukuran model, kebutuhan memorinya juga meningkat, sering kali melampaui kapasitas akselerator perangkat keras canggih seperti GPU.
Permintaan memori yang terus meningkat ini membatasi pelatihan dan hosting model untuk inferensi, sehingga membatasi aksesibilitas dan adopsi solusi berbasis LLM.
Pertumbuhan ini menimbulkan kebutuhan mendesak untuk membuat model lebih mudah diakses dengan mengurangi ukurannya. Dengan mengubah presisi beberapa komponen model, kuantisasi mengurangi jejak memori model sambil mempertahankan tingkat kinerja yang serupa.
Kuantisasi adalah teknik kompresi model yang mengonversi bobot (weights) dan aktivasi dalam sebuah large language model dari nilai berpresisi tinggi ke nilai berpresisi lebih rendah. Ini berarti mengubah data dari tipe yang dapat memuat lebih banyak informasi ke tipe yang memuat lebih sedikit. Contoh yang umum adalah mengonversi data dari bilangan floating-point 32-bit ke integer 8-bit.
Mengurangi jumlah bit yang dibutuhkan untuk setiap bobot atau aktivasi model menghasilkan penurunan signifikan pada ukuran keseluruhannya. Akibatnya, kuantisasi mengecilkan LLM agar mengonsumsi lebih sedikit memori, memerlukan ruang penyimpanan lebih kecil, dan membuatnya lebih hemat energi.
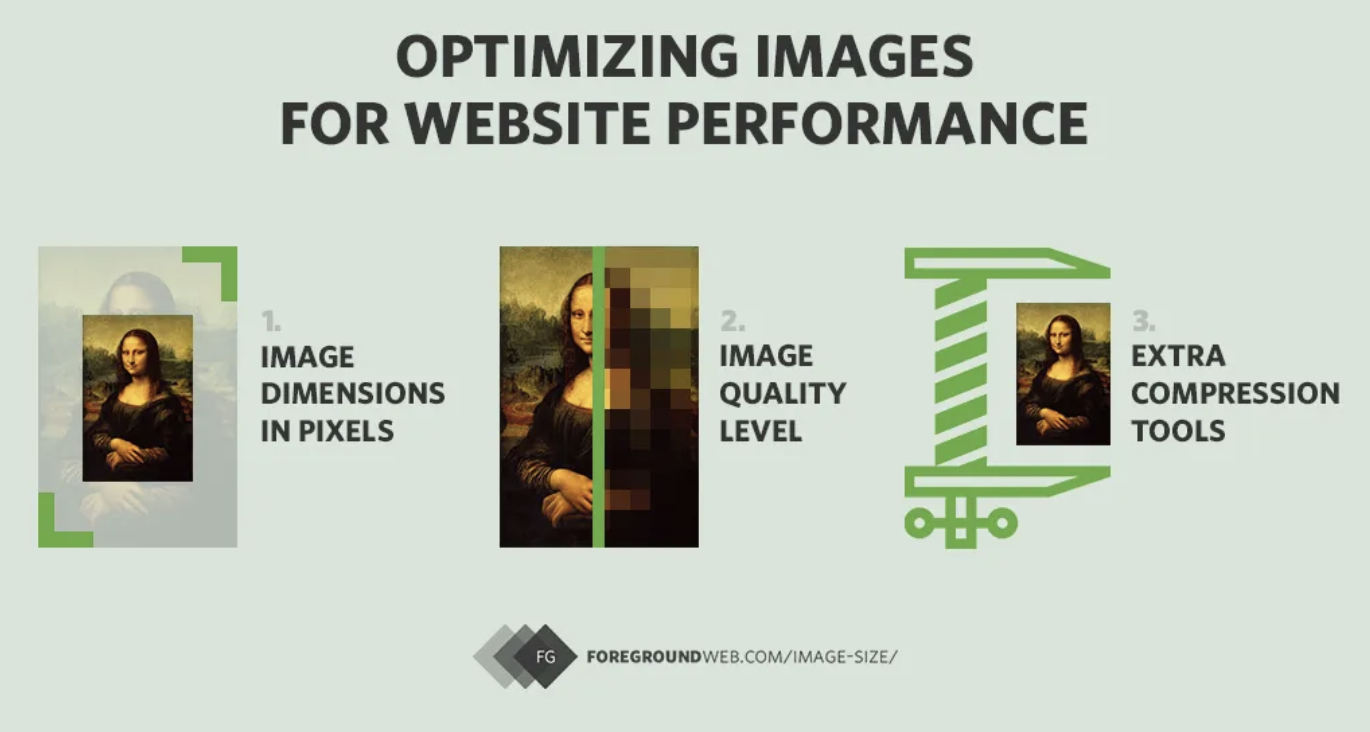
Analogi yang efektif untuk memahami kuantisasi adalah kompresi gambar. Gambar beresolusi tinggi sering dikompresi untuk digunakan di situs web. Ini melibatkan pengurangan ukuran gambar dengan menghapus sebagian data atau bit informasi. Meski biasanya menurunkan kualitas gambar hingga tingkat tertentu, langkah ini juga mengurangi dimensi dan ukuran berkas, sehingga laman web memuat lebih cepat sambil tetap memberikan pengalaman visual yang memadai.
Skema kompresi gambar untuk pemuatan lebih cepat di aplikasi seperti laman web.
Demikian pula, mengkuantisasi sebuah LLM mengurangi kebutuhan komputasinya, memungkinkan model berjalan pada perangkat keras yang kurang bertenaga namun tetap memberikan kinerja yang memadai. Gambar terkompresi lebih mudah ditangani, sebagaimana model terkuantisasi lebih mudah dipasang di berbagai platform, meski ada sedikit kompromi pada detail atau presisi. Seperti yang akan kita lihat, proses kuantisasi juga memperkenalkan sejumlah noise.
Kuantisasi biasanya diterapkan pada bobot model bahasa besar, meskipun juga dapat diterapkan pada aktivasi. Bobot model adalah parameter dalam sebuah jaringan saraf yang menentukan kekuatan koneksi antar-neuron di berbagai lapisan. Bobot pada dasarnya adalah koefisien yang dipelajari untuk mentransformasikan data masukan saat melewati jaringan.
Bobot awalnya diatur ke nilai acak yang tidak bermakna dan disesuaikan selama pelatihan berdasarkan kesalahan antara keluaran prediksi dan target sebenarnya. Proses penyesuaian ini dipandu oleh algoritma optimisasi seperti gradient descent.
Jika Anda ingin mempelajari lebih jauh seluk-beluk LLM, kursus Developing Large Language Models cocok untuk Anda!
Salah satu opsi untuk mengkuantisasi model adalah mengurangi presisi bobot modelnya. Untuk mengilustrasikannya, mari fokus pada matriks di sebelah kiri pada gambar di bawah, yang merepresentasikan matriks bobot 3x3 dengan presisi empat desimal:
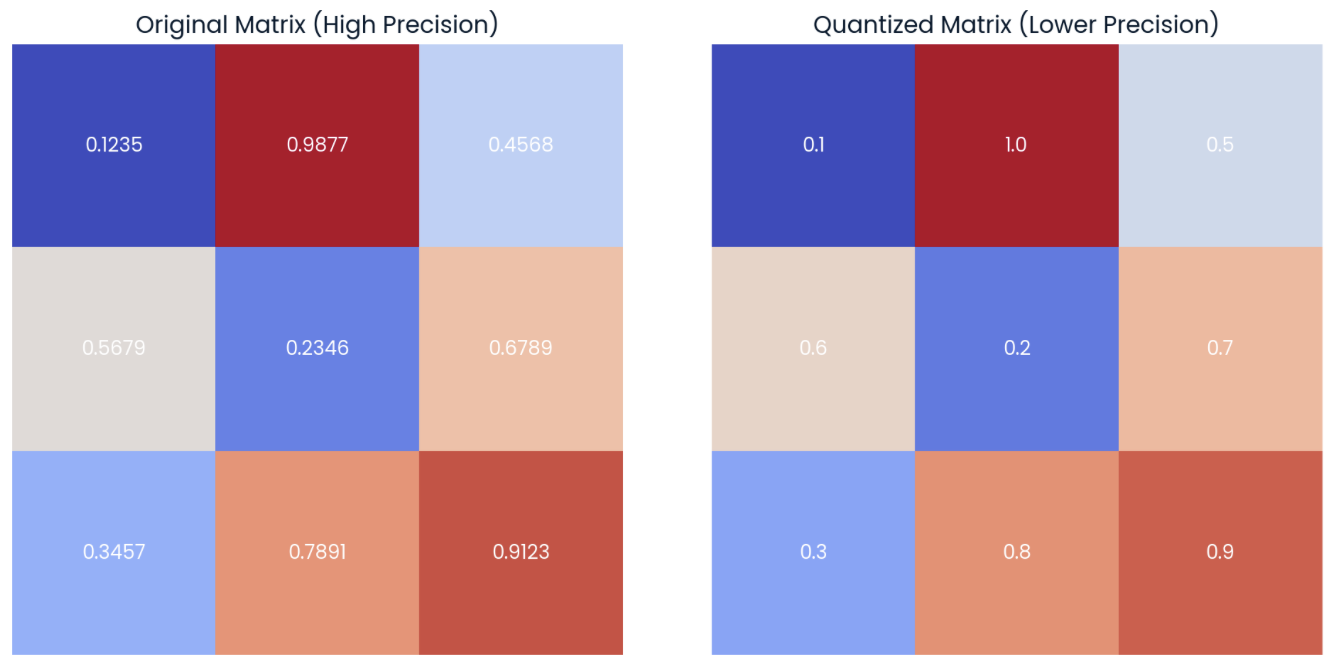
Contoh matriks acak bobot dengan presisi empat desimal (kiri) beserta bentuk terkuantisasi (kanan) dengan pembulatan ke presisi satu desimal.
Pada matriks di sebelah kanan, kita dapat melihat versi terkuantisasi dari matriks asli. Matriks “terkuantisasi” ini dihitung dengan membulatkan elemen dari matriks asli menjadi satu desimal.
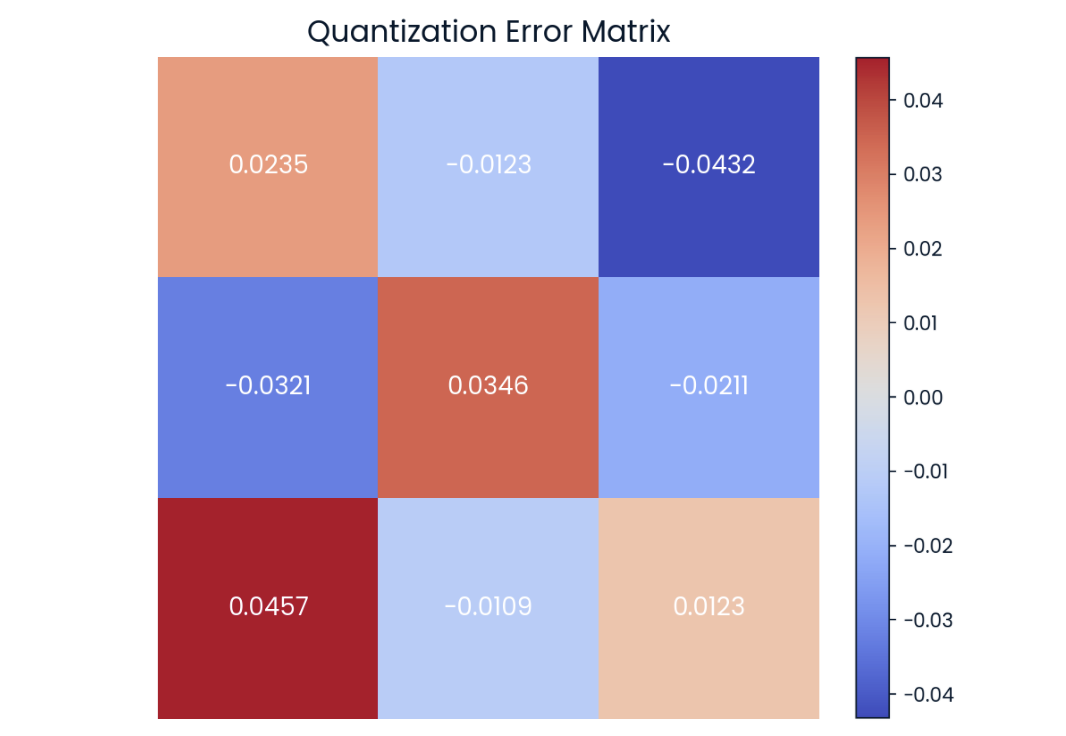
Kita dapat mengamati bahwa kedua matriks di atas tidak sepenuhnya sama tetapi sangat mirip. Perbedaan nilai demi nilai ini dikenal sebagai kesalahan kuantisasi, yang juga dapat kita representasikan dalam bentuk matriks:
Kesalahan kuantisasi dalam bentuk matriks. Semakin gelap warnanya, semakin besar kesalahannya.
Riset terkini dalam kuantisasi berfokus pada upaya mengurangi perbedaan ini sebisa mungkin untuk menghindari degradasi kinerja.
Dalam contoh sederhana ini, kita hanya membulatkan elemen matriks. Dalam praktiknya, kuantisasi dilakukan dengan mengonversi nilai numerik ke tipe data yang berbeda, misalnya dari tipe data berpresisi lebih tinggi ke yang lebih rendah. Sebagai contoh, tipe data penyimpanan bawaan untuk kebanyakan model adalah float32.
Dalam kasus ini, kita perlu mengalokasikan 4 byte per parameter (4 kali presisi 8-bit). Oleh karena itu, untuk matriks 3x3 seperti pada contoh, jejak memori total matriks ini adalah 36 byte.
Dengan mengubah tipe data — juga dikenal sebagai downcasting — ke int8, kita hanya memerlukan satu byte per parameter. Dengan demikian, jejak memori total matriks menjadi 9 byte.
Tipe data yang dipilih untuk bobot model menentukan seberapa besar kita dapat mengurangi model. Tipe floating-point tradisional, seperti float32 dan float16, telah menjadi standar dalam banyak aplikasi pembelajaran mesin, memberikan keseimbangan antara akurasi dan efisiensi komputasi. Secara khusus, sementara float32 menawarkan presisi tinggi dan rentang dinamis yang luas, ia memerlukan lebih banyak memori dan daya komputasi. Sebaliknya, float16 menawarkan presisi dan rentang yang lebih rendah, sehingga secara signifikan mempercepat komputasi.
float32 yang luas dan efisiensi float16. Hal ini mengarah pada terciptanya Brain Floating Point (bfloat16), yang mempertahankan rentang dinamis float32 namun dengan presisi yang dikurangi.
Downcasting adalah istilah formal untuk mengonversi tipe data berpresisi lebih tinggi ke tipe data berpresisi lebih rendah. Dengan menggunakan downcasting, kita mengurangi jejak memori dan meningkatkan kecepatan karena komputasi dengan presisi lebih rendah juga memerlukan memori yang lebih sedikit.
Pada bagian ini, kita akan menelusuri cara kerja downcasting dari float32— tipe data penyimpanan bawaan untuk sebagian besar model — ke bfloat16 dari Google, dan kita akan mengamati bagaimana ini biasanya mengakibatkan hilangnya sebagian data.
Mari mulai dengan mendefinisikan tensor acak di PyTorch dengan elemen bertipe float32 dan menampilkan lima elemen pertama:
import torch
# random pytorch tensor: float32, size=1000
tensor_fp32 = torch.rand(1000, dtype = torch.float32)
print(tensor_fp32[:5])
>> tensor([0.2257, 0.0480, 0.8520, 0.3115, 0.1373])
Kini kita dapat melakukan downcast tensor ke bfloat16 menggunakan metode .to(dtype) dan mengamati 5 elemen barunya:
# downcast the tensor to bfloat16 using the "to" method
tensor_fp32_to_bf16 = tensor_fp32.to(dtype = torch.bfloat16)
print(tensor_fp32_to_bf16[:5])
>> tensor([0.2256, 0.0481, 0.8516, 0.3105, 0.1377], dtype=torch.bfloat16)
Seperti yang terlihat, nilainya sangat berdekatan, meski tidak sama. Perbedaannya menjadi lebih nyata saat kita mulai melakukan operasi pada nilai-nilai tersebut. Misalnya, saat mengalikan tensor asli dengan dirinya sendiri:
# tensor_fp32 x tensor_fp32
m_float32 = torch.dot(tensor_fp32, tensor_fp32)
print(m_float32)
>> tensor(322.1082)
Jika kita melakukan komputasi yang sama dengan tensor terkuantisasi, kita melihat perbedaannya lebih besar:
# tensor_fp32_to_bf16 x tensor_fp32_to_bf16
m_bfloat16 = torch.dot(tensor_fp32_to_bf16, tensor_fp32_to_bf16)
print(m_bfloat16)
>> tensor(256., dtype=torch.bfloat16)
Kita dapat mengamati perbedaan yang jelas antara hasil akhir karena propagasi kesalahan.
Efek propagasi kesalahan yang sama saat beroperasi dengan tensor terkuantisasi terjadi ketika melakukan downcasting LLM, yang mengarah pada hilangnya informasi. Seperti yang telah kita lihat, menggunakan lebih sedikit memori menyiratkan komputasi bisa menjadi kurang presisi. Efek perkalian mirip dengan propagasi kesalahan nyata dari lapisan ke lapisan, yang terakumulasi dan pada akhirnya memengaruhi beberapa prediksi token.
Dengan downcasting, kinerja tetap dapat diterima saat menggunakan tipe bfloat16, tetapi tidak berlaku untuk tipe data yang lebih kecil.
Downcasting tidak umum digunakan sebagai teknik kuantisasi yang efektif karena pembatasan pada tipe data ini. Sebagai gantinya, metode lain yang mempertahankan kinerja lebih dekat ke model asli dengan mengonversi kembali ke float32 selama inferensi digunakan.
Ada beberapa jenis kuantisasi, dan masing-masing kami jelaskan secara rinci di bawah ini:
Kuantisasi linear adalah salah satu skema kuantisasi paling populer untuk LLM. Secara sederhana, ini melibatkan pemetaan rentang nilai floating-point dari bobot asli ke rentang nilai fixed-point secara merata, menggunakan tipe data berpresisi tinggi untuk inferensi.
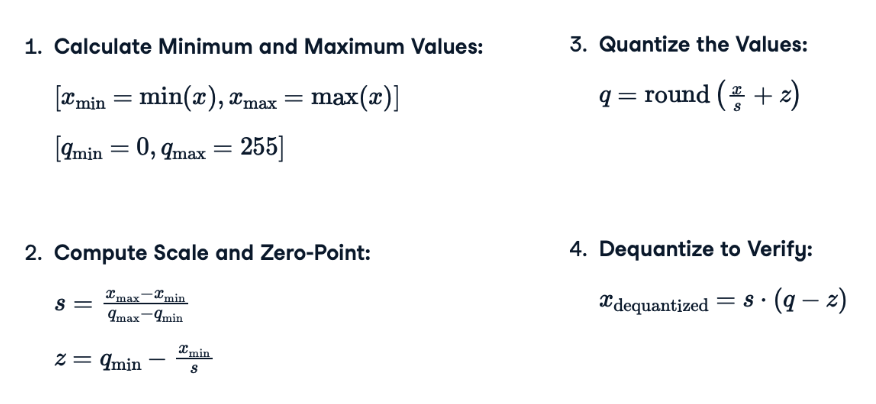
Untuk memudahkan, mari tinjau langkah-langkah yang diperlukan untuk menerapkan kuantisasi linear pada model. Perhatikan bahwa rumus sebenarnya ditampilkan pada gambar di bawah:
s) dan titik nol (s): Skala menyesuaikan rentang nilai floating-point agar sesuai dengan rentang integer. Titik nol memastikan bahwa nol pada rentang floating-point terwakili secara akurat oleh sebuah integer, menjaga akurasi dan stabilitas numerik, terutama untuk nilai yang mendekati nol.q): Langkah ini melibatkan pemetaan nilai floating-point ke rentang integer berpresisi lebih rendah menggunakan faktor skala s dan titik nol s yang dihitung pada langkah sebelumnya. Operasi pembulatan memastikan hasil akhir berupa integer diskret, cocok untuk penyimpanan dan komputasi dalam format berpresisi lebih rendah.Mari kaitkan setiap langkah di atas dengan rumusnya masing-masing:
Persamaan kuantisasi yang digunakan untuk menerapkan kuantisasi linear pada matriks bobot apa pun.
Sulit membayangkan bagaimana menerapkan rumus-rumus ini? Mari praktik langsung!
Jika kita menerapkan rumus-rumus ini pada tensor bobot 3x3 di sebelah kiri pada gambar di bawah, kita akan mendapatkan matriks terkuantisasi yang ditunjukkan di sebelah kanan. Saya sarankan meluangkan beberapa menit untuk menghitung nilai maksimum dan minimum dari rentang terkuantisasi dan beberapa nilai terkuantisasinya:
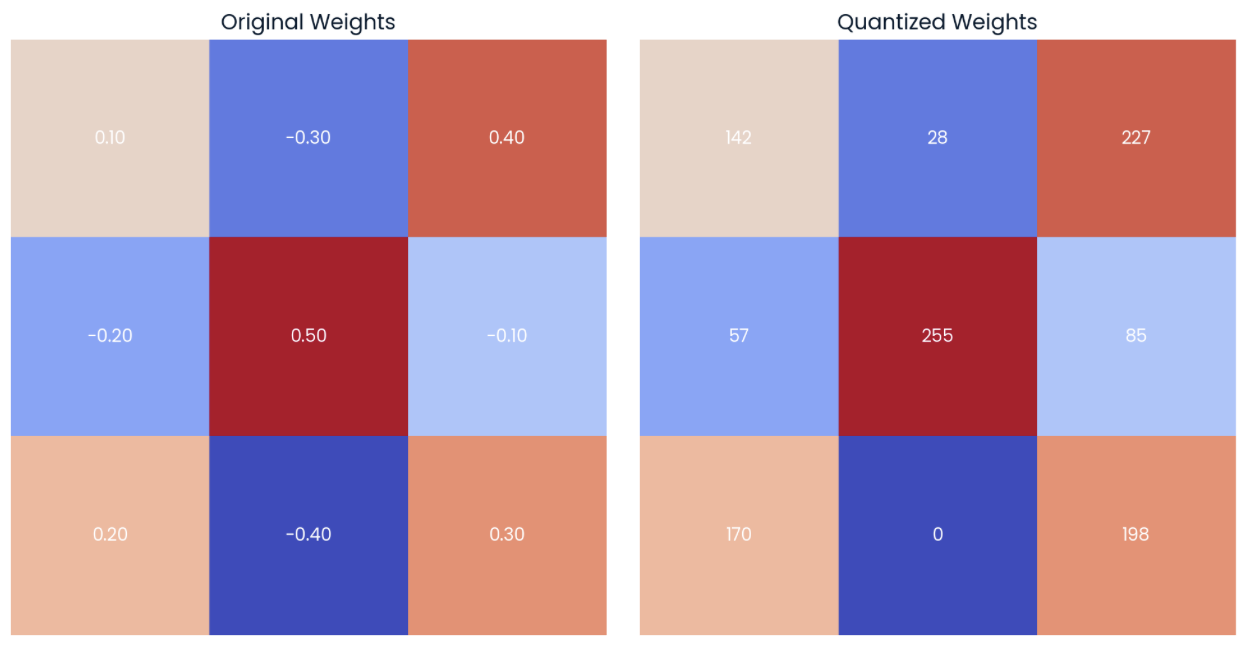
Contoh matriks acak bobot dengan presisi dua desimal (kiri) beserta bentuk terkuantisasi (kanan) ke tipe data int8.
Kita dapat melihat bahwa batas bawah nilai int8 sesuai dengan nilai terendah dari tensor asli (-0,40 → 0), sementara batas atas sesuai dengan nilai tertinggi dari tensor asli (0,50 → 255).
Jika sekarang kita dekuantisasi nilai menggunakan rumus (4), kita dapat melihat bahwa nilai dekuantisasi mendekati nilai asli (matriks di sebelah kiri). Kita dapat menghitung kesalahan kuantisasi dengan menghitung selisih titik demi titik (matriks di sebelah kanan):
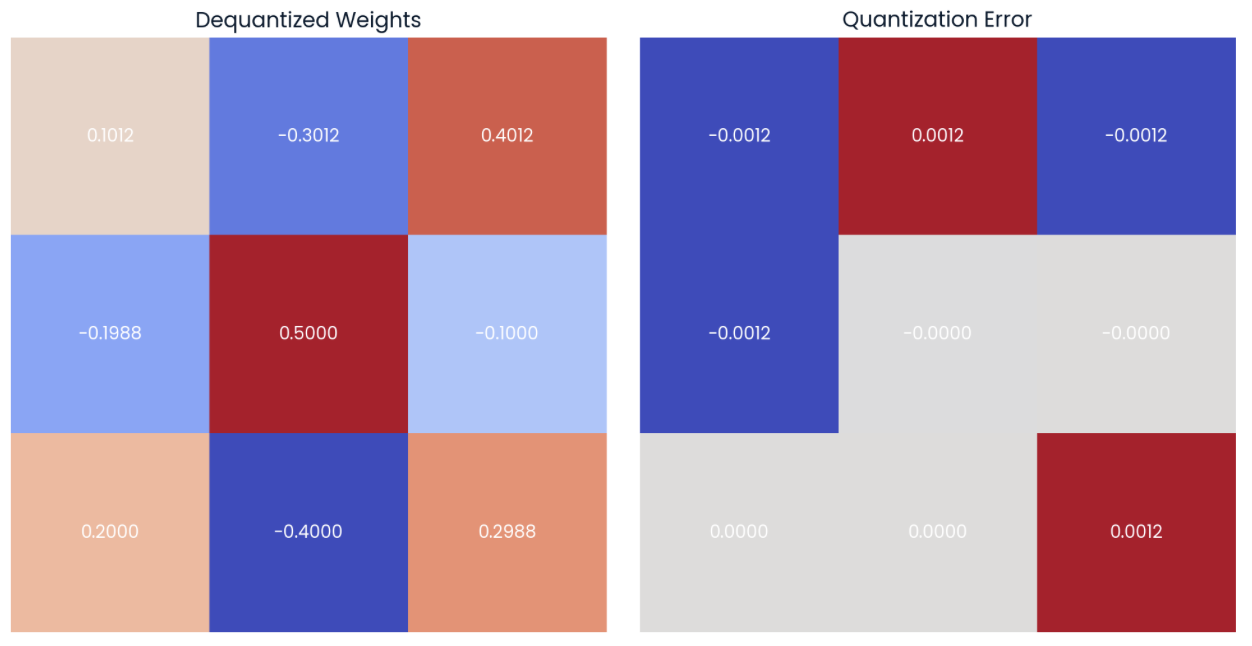
Nilai dapat didekuantisasi menggunakan bobot terkuantisasi dan nilai skala serta titik nol (kiri). Selisih titik demi titik atau kesalahan kuantisasi dapat dihitung (kanan).
Kuantisasi linear mengurangi ukuran model dengan hanya menyimpan bobot terkuantisasi serta nilai skala dan titik nol di memori, sambil menggunakannya untuk menghitung bobot asli saat inferensi dan mempertahankan kinerja.
Kuantisasi linear populer karena kesederhanaannya, tetapi ada banyak cara untuk membangun pemetaan. Metode lain yang cukup populer saat ini adalah kuantisasi berbasis blok, yang lebih akurat daripada kuantisasi linear untuk model dengan distribusi bobot yang tidak seragam.
Kuantisasi berbasis blok adalah metode yang lebih canggih yang melibatkan kuantisasi bobot dalam blok-blok kecil alih-alih pada keseluruhan rentang. Metode ini bergantung pada dua konsep kunci:
Dalam contoh matriks kita, kita terutama berfokus pada proses mengkuantisasi bobot model. Walau kuantisasi bobot merupakan langkah krusial untuk optimisasi model, penting juga untuk mempertimbangkan bahwa aktivasi model juga dapat dikuantisasi.
Kuantisasi aktivasi mengacu pada proses pengurangan presisi keluaran sementara dari setiap lapisan dalam jaringan. Berbeda dengan bobot, yang bersifat statis (konstan) setelah model dilatih, aktivasi bersifat dinamis. Ini berarti aktivasi berubah pada setiap masukan ke jaringan, sehingga rentangnya lebih sulit diprediksi.
Secara umum, kuantisasi aktivasi lebih sulit diimplementasikan daripada kuantisasi bobot. Ini memerlukan kalibrasi yang cermat untuk memastikan rentang dinamis aktivasi tertangkap dengan baik.
Kuantisasi bobot dan kuantisasi aktivasi adalah teknik yang saling melengkapi. Dengan menerapkan keduanya, kita dapat memungkinkan peningkatan signifikan pada ukuran model tanpa mengorbankan kinerja terlalu banyak.
Kuantisasi juga dapat dilakukan pada waktu yang berbeda. Jika kita mengambil model pra-latih dan mengkuantisasi parameter model selama fase inferensi, kita melakukan Post-Training Quantization (PTQ).
Metode ini tidak melibatkan perubahan pada proses pelatihan itu sendiri. Rentang dinamis parameter dihitung ulang saat runtime, mirip dengan cara kita bekerja dengan matriks contoh.
Di sisi lain, ada juga opsi menerapkan Quantization-Aware Training (QAT). Pendekatan ini melibatkan modifikasi proses pelatihan untuk mensimulasikan efek kuantisasi selama pelatihan. Model dilatih agar tahan terhadap noise kuantisasi, sehingga menghasilkan akurasi yang lebih baik.
Selama QAT, status antara dari pelatihan menyimpan baik versi terkuantisasi dari bobot maupun bobot asli yang tidak dikuantisasi (juga di memori!). Oleh karena itu, kita menggunakan versi terkuantisasi dari model untuk inferensi, tetapi versi bobot model yang tidak dikuantisasi akan diperbarui selama backpropagation.
Seperti yang diharapkan, meskipun lebih kompleks dan memakan waktu, QAT umumnya menghasilkan akurasi yang lebih tinggi dibandingkan PTQ.
Beberapa metode kuantisasi memerlukan langkah kalibrasi. Misalnya, kita harus menentukan rentang aktivasi asli dari sebuah model sebelum kuantisasi. Kalibrasi umum biasanya melibatkan menjalankan inferensi pada dataset yang representatif untuk mengoptimalkan parameter kuantisasi dan meminimalkan kesalahan kuantisasi.
Selama proses kalibrasi ini, algoritma kuantisasi mengumpulkan statistik tentang distribusi dan rentang aktivasi serta bobot model. Statistik ini membantu menentukan parameter kuantisasi terbaik. Menghitung skala dan titik nol saat mengkuantisasi bobot juga merupakan semacam kalibrasi, tetapi ada jenis lainnya:
Namun, metode kuantisasi seperti QLoRA dapat digunakan tanpa langkah kalibrasi apa pun.
Metode-metode ini biasanya mengganti semua lapisan linear dalam model dengan lapisan linear terkuantisasi (QLinear). Lapisan QLinear dirancang untuk menangani kuantisasi secara internal, sehingga menghilangkan kebutuhan akan langkah kalibrasi tambahan. Ini membuat proses kuantisasi lebih mudah diimplementasikan sambil tetap mempertahankan kinerja model.
Beberapa alat dan pustaka di Python mendukung kuantisasi, menyediakan alat untuk PTQ dan QAT. Misalnya, pytorch dan tensorflow menyediakan metode kuantisasi, meski mengintegrasikan kuantisasi secara mulus pada model yang ada memerlukan pemahaman mendalam tentang pustaka dan internal model. Lihat opsi kuantisasi di dokumentasi resmi PyTorch.
Jika Anda tertarik mempelajari kerangka kerja yang kuat tersebut, saya merekomendasikan kursus Deep Learning in Python.
Pilihan favorit saya untuk menerapkan kuantisasi dalam langkah-langkah mudah sejauh ini adalah pustaka Quanto dari Hugging Face, yang dirancang untuk menyederhanakan proses kuantisasi untuk model PyTorch.
Alur kerja kuantisasi khas menggunakan pustaka Quanto dari Hugging Face terdiri dari langkah-langkah berikut:
1. Pilih dan muat model pra-latih beserta tokenizer yang sesuai. Dalam kasus ini, kita akan menggunakan model Pythia 410M dari EuletherAI:
from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "EleutherAI/pythia-410m"
model = AutoModelForCausalLM.from_pretrained(model_name,
low_cpu_mem_usage=True)
tokenizer = AutoTokenizer.from_pretrained(model_name)
Metode model.gpt_neox dapat membantu memvisualisasikan berbagai lapisan model yang dimuat:
print(model.gpt_neox)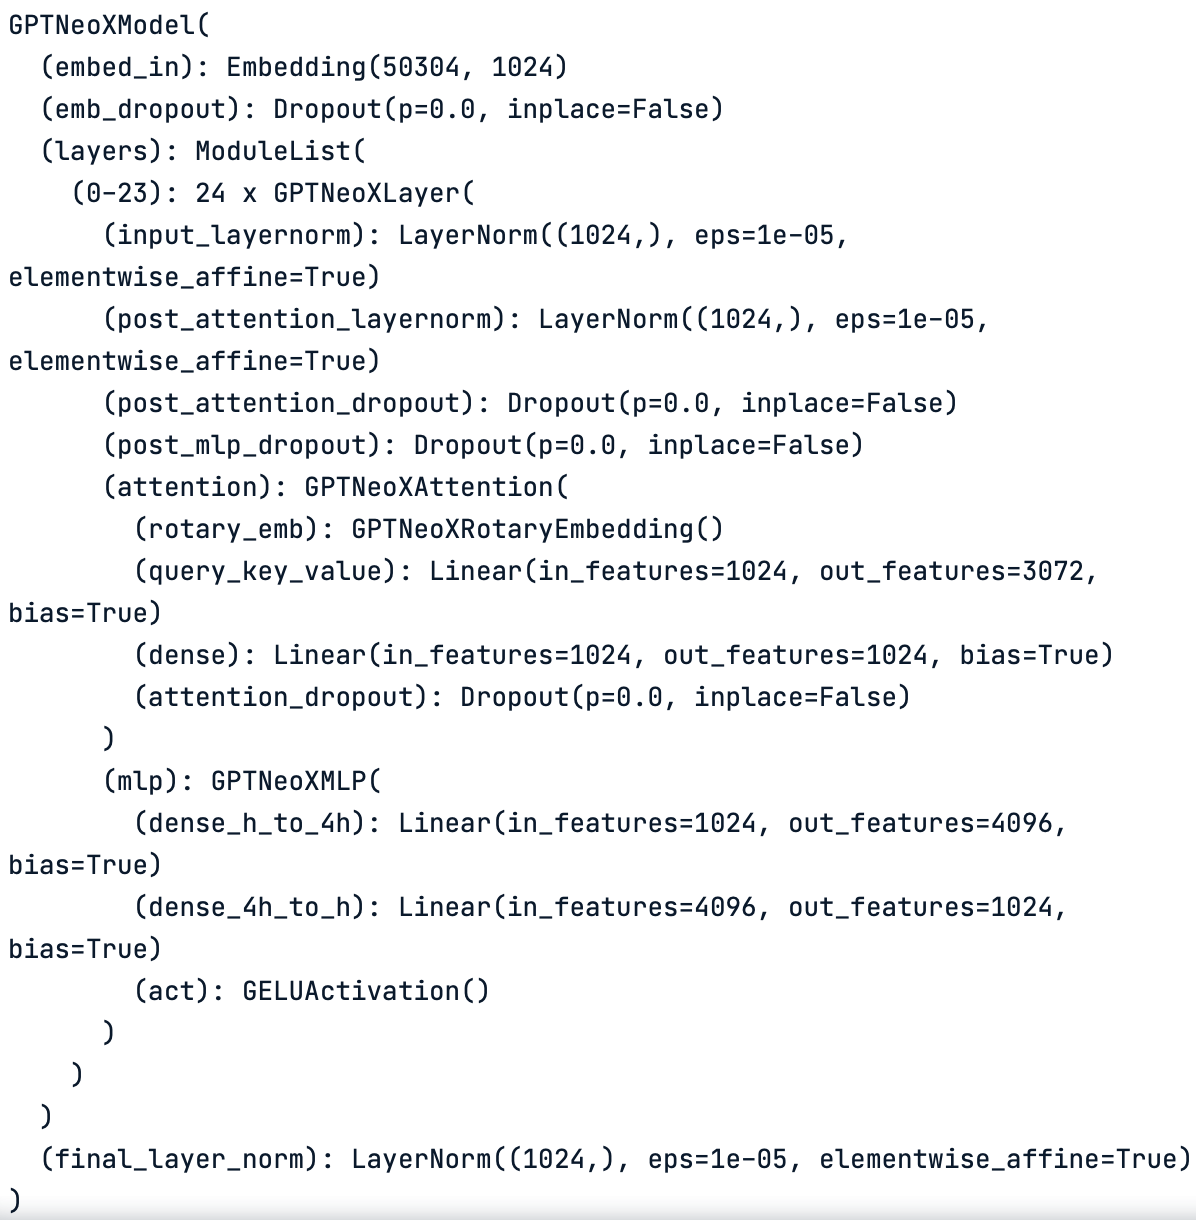
Skema lapis demi lapis dari model asli. Model terdiri dari berbagai jenis lapisan seperti lapisan linear dan lapisan normalisasi.
Kita dapat memastikan model bekerja dengan baik dengan menjalankan beberapa inferensi uji. Misalnya,
text = "Once upon a time, there was a"
inputs = tokenizer(text, return_tensors="pt")
outputs = model.generate(**inputs, max_new_tokens=10)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))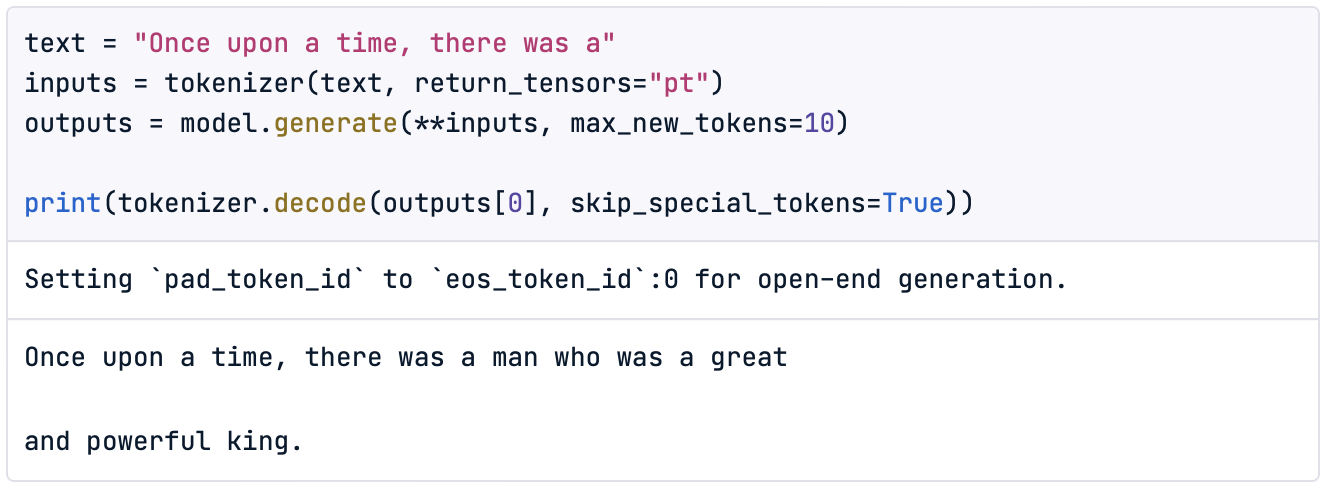
Selain itu, karena mengkuantisasi model akan memungkinkan kita mengurangi ukurannya, menarik juga untuk memeriksa ukuran model asli sebelum memulai proses:
import torch
module_sizes = compute_module_sizes(model)
print(f"The model size is {module_sizes[''] * 1e-9} GB")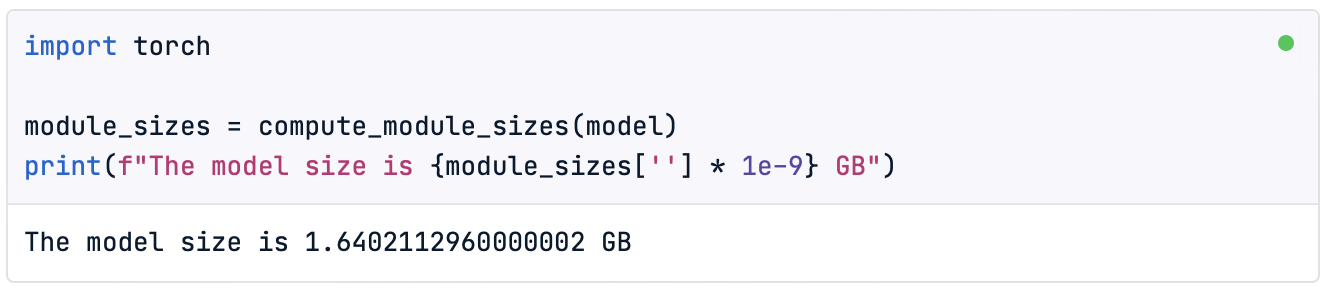
Catatan: Di DataCamp DataLab kita dapat menemukan metode compute_module_sizes() yang telah diimplementasikan.
Terakhir, kita juga dapat memvisualisasikan tensor padat dari model asli sebagai berikut:
print(model.gpt_neox.layers[0].attention.dense.weight)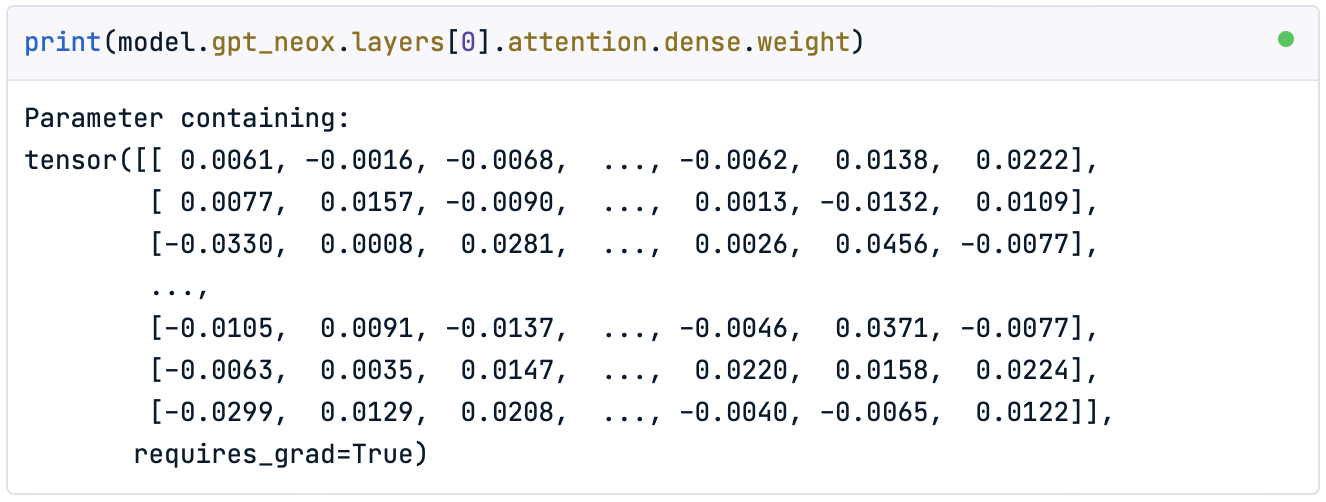
Seperti yang dapat kita amati, ini memang menyerupai matriks yang tidak dikuantisasi yang kita gunakan selama artikel ini.
2. Kuantisasi. Metode quantize() memungkinkan konversi model float standar bawaan menjadi model terkuantisasi secara langsung.
from quanto import quantize, freeze
quantize(model, weights=torch.int8, activations=None)
Dalam kasus ini, kita hanya mengkuantisasi bobot model ke tipe data int8. Metode ini mengonversi model untuk menggunakan aritmetika berpresisi lebih rendah termasuk langkah kalibrasi.
Jika sekarang kita mencetak lapisan model, kita akan melihat bahwa lapisan linear asli (Linear) telah diganti dengan lapisan linear terkuantisasi (QLinear):
print(model)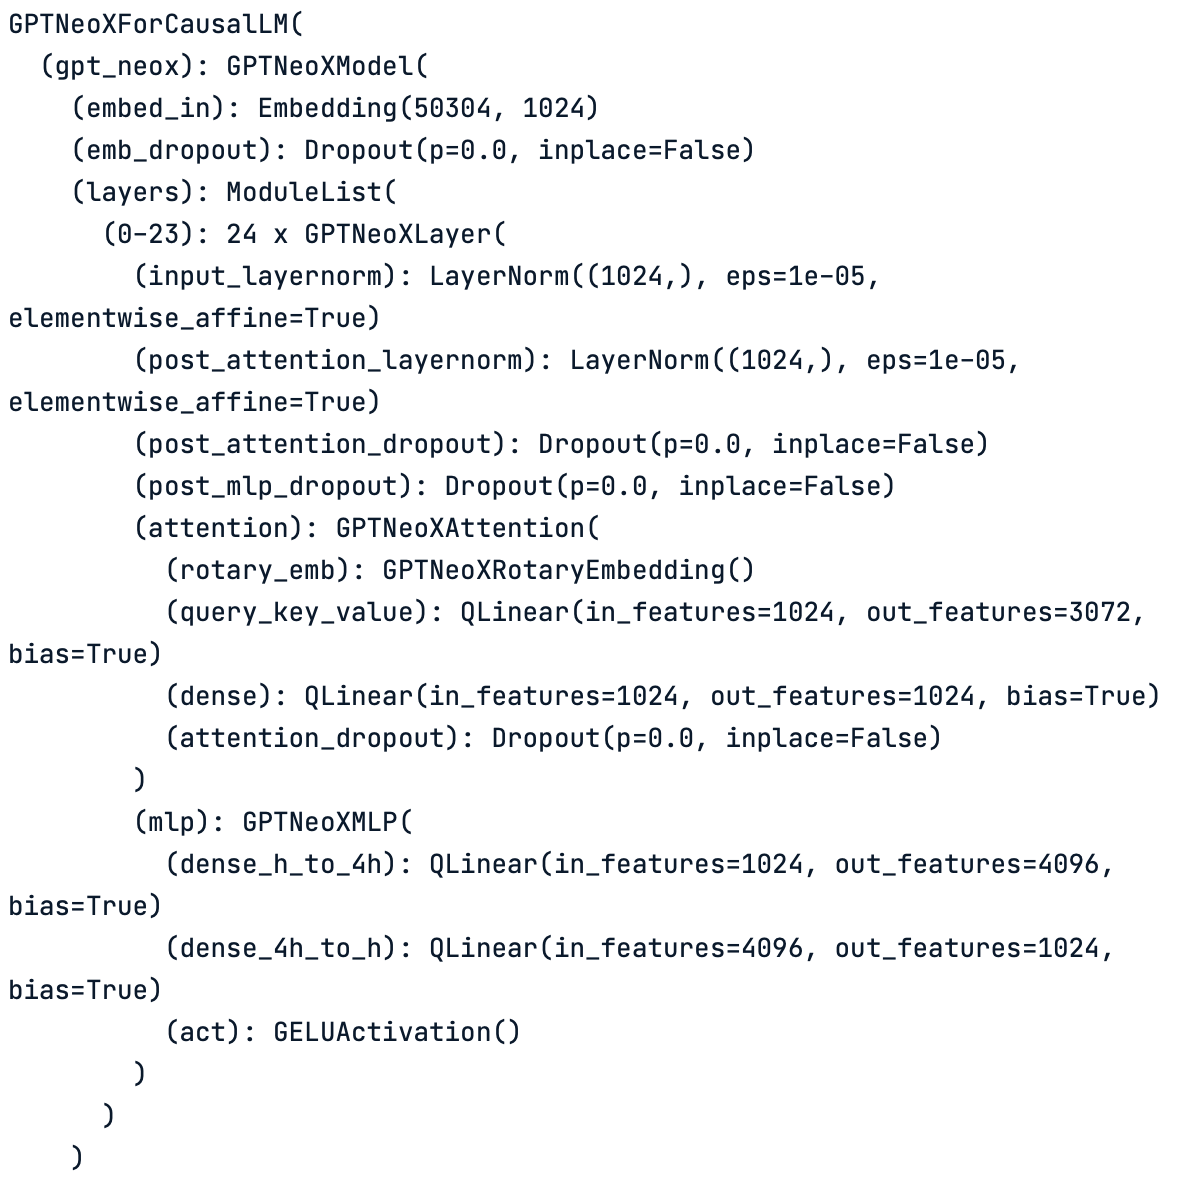
Skema lapis demi lapis dari model terkuantisasi. Perhatikan bagaimana semua lapisan linear asli berubah menjadi lapisan linear terkuantisasi (QLinear).
Meski demikian, jika kita mencetak matriks bobot, kita akan melihat bahwa bobot tersebut belum ditransformasikan:
print(model.gpt_neox.layers[0].attention.dense.weight)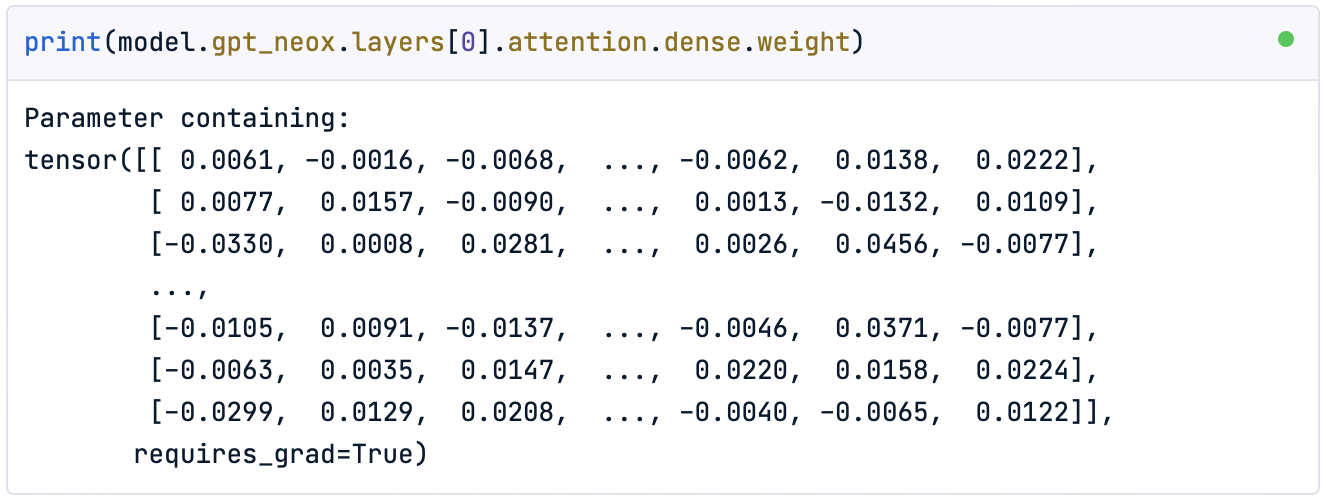
3. Freeze. Untuk menerapkan efek kuantisasi pada bobot, kita perlu menggunakan metode freeze().
freeze(model)Metode ini menanamkan parameter kuantisasi ke dalam model, secara efektif mengonversi bobot ke tipe data target. Mari amati sekarang parameter model yang terkuantisasi:
print(model.gpt_neox.layers[0].attention.dense.weight)
Seperti terlihat, bobot kini berada dalam rentang tipe data int8 Pytorch.
4. Pemeriksaan akhir. Setelah model dikuantisasi, kita dapat memeriksa ukuran model baru yang telah diperkecil:
module_sizes = compute_module_sizes(model)
print(f"The model size is {module_sizes[''] * 1e-9} GB")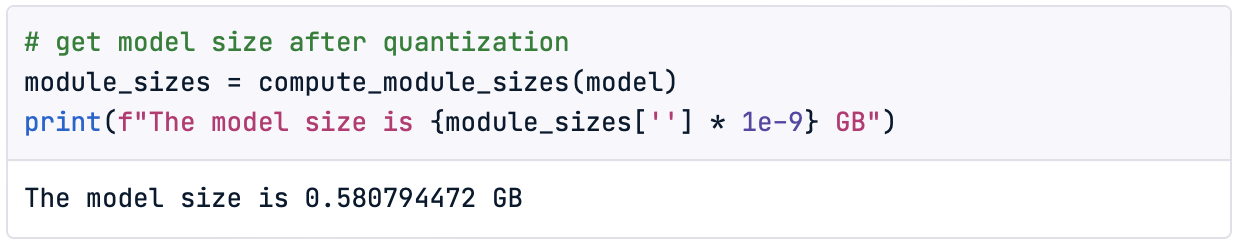
Kita telah mendapatkan model yang hanya 35% dari ukuran aslinya!
Terakhir, mari periksa kinerja baru model dengan inferensi sederhana:
outputs = model.generate(**inputs, max_new_tokens=10)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))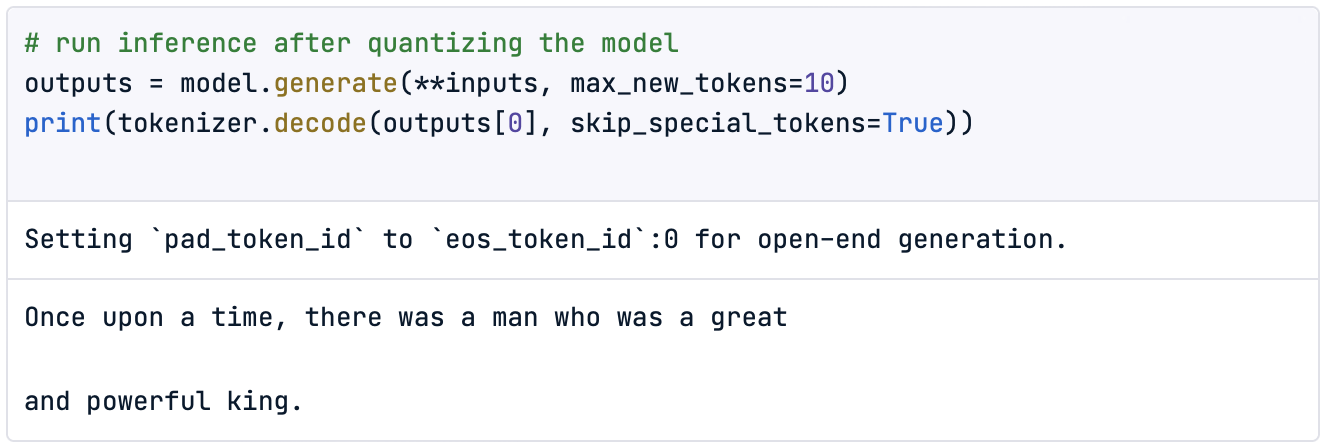
Tentu saja, memeriksa kinerja dengan satu inferensi saja tidaklah bermakna, jadi sebaiknya tetapkan metode kuantitatif untuk mengevaluasinya.
Sekarang giliran Anda untuk mencoba!
Tuntutan memori LLM yang meningkat membatasi pelatihan dan hosting untuk inferensi, sehingga membatasi aksesibilitas dan adopsi aplikasi berbasis LLM.
Dalam artikel ini, kami memperkenalkan konsep kuantisasi, yang melibatkan pengurangan presisi bobot dan aktivasi model untuk menurunkan jejak memori dan kebutuhan komputasi. Proses ini membantu membuat model lebih efisien dan mudah diakses, khususnya untuk penerapan pada perangkat dengan sumber daya terbatas.
Kami mendekati teknik ini dengan menggunakan beberapa contoh, membulatkan nilai numerik dari bobot. Lalu, kami berlanjut ke jenis kuantisasi sederhana yang dikenal sebagai downcasting. Saat melakukan downcasting pada model, parameter dikonversi ke tipe data yang lebih ringkas, seperti bfloat16, untuk inferensi. Meskipun ini memungkinkan model melakukan perhitungan dan aktivasi dalam tipe data yang lebih kecil ini, kinerja biasanya menurun seiring ukuran tipe data, dan menjadi tidak efektif dengan tipe integer seperti int8.
Untuk mengatasinya, kami memperkenalkan kuantisasi linear, yang mempertahankan kinerja lebih dekat dengan model asli dengan mengonversi kembali ke float32 selama inferensi. Ini memungkinkan penggunaan tipe data yang bahkan lebih kecil, seperti int8.
Kami menelusuri langkah numerik penerapan kuantisasi linear dan mengimplementasikan kuantisasi bobot menggunakan pustaka Quanto dari Hugging Face. Perlu dicatat, dengan pustaka Quanto, kita dapat mengkuantisasi model PyTorch apa pun, termasuk yang tersedia di Hugging Face.
Bagi yang tertarik mencoba model yang lebih berat seperti LLaMa 2 atau Mistral, pertimbangkan untuk meningkatkan ruang DataCamp Anda ke premium untuk daya komputasi lebih besar.

Untuk model yang lebih besar, kita mungkin memerlukan sumber daya tambahan yang dapat diakses di DataCamp Premium Plan.
Dengan menguasai teknik kuantisasi, kita dapat membuka potensi penuh Large Language Models dengan memerlukan lebih sedikit sumber daya, sehingga AI tingkat lanjut menjadi lebih efisien, mudah diakses, dan serbaguna.
Semoga artikel ini membantu Anda praktik langsung dengan kuantisasi untuk LLM!
Kursus LLM Teratas
Kursus
Program
Kursus
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt




