
Kursus
Bekerja dengan OpenAI API
3 jam
184.8K
Setelah peluncuran DeepSeek R1, OpenAI merespons dengan model penalaran mutakhirnya sendiri, o3-mini. Model baru ini dirancang lebih kecil, lebih cepat, dan lebih efisien daripada pendahulunya, model o1, sekaligus unggul dalam tugas-tugas terkait coding, STEM, dan pemecahan masalah logis.
OpenAI membuat model ini tersedia secara gratis untuk semua pengguna, termasuk pengguna ChatGPT dan platform lainnya, sehingga kemampuan penalaran tingkat lanjut kini semakin mudah diakses.
Untuk detail lebih lanjut tentang o3-mini, Anda dapat merujuk ke postingan blog, OpenAI’s O3: Features, O1 Comparison, Release Date & More.
Sumber: ChatGPT
Dalam tutorial ini, kita akan mengeksplorasi kapabilitas teknis model o3-mini. Secara khusus, kita akan menguji kemampuannya menangani tugas teknis yang kompleks, menghasilkan kode yang akurat, dan memberikan instruksi yang jelas untuk membangun, menguji, dan mendistribusikan model machine learning yang layak. Pada akhirnya, kita ingin menentukan apakah o3-mini memenuhi janjinya sebagai model penalaran mutakhir untuk tugas teknis dan pemecahan masalah logis.
Gambar oleh Penulis
Kita akan meminta o3-mini menggunakan dataset Placement Prediction untuk membangun aplikasi machine learning yang dapat menentukan apakah seorang mahasiswa memenuhi syarat untuk penempatan kerja atau tidak. Dari perencanaan hingga deployment solusi, kita akan meminta bantuan model o3-mini di ChatGPT.
Pada tahap perencanaan proyek, kita akan memberikan semua informasi yang diperlukan kepada model o3-mini dan menguraikan tujuan kita. Kita akan memintanya membuat semua folder dan file yang diperlukan untuk membangun, melatih, dan mendistribusikan aplikasi Placement Prediction.
Secara khusus, kita akan:
Berikut prompt-nya:
“I want to build a machine learning project to predict whether a student will be placed or not based on their academic and extracurricular data. The dataset contains the following columns:

- **StudentID**: Unique identifier for each student.

- **CGPA**: The overall grades achieved by the student.

- **Internships**: Number of internships a student has completed.

- **Projects**: Number of projects a student has completed.

- **Workshops/Certifications**: Indicates whether the student has attended workshops or completed certifications to upskill themselves.

- **AptitudeTestScore**: Score achieved in an aptitude test, which evaluates quantitative and logical thinking.

- **SoftSkillRating**: A rating of the student’s communication and interpersonal skills.

- **ExtraCurricularActivities**: Indicates whether the student is active in extracurricular activities (Yes/No).

- **PlacementTraining**: Indicates whether the student has undergone placement training (Yes/No).

- **SSC and HSC**: Senior Secondary and Higher Secondary marks.

- **PlacementStatus**: The target column, which has two classes: "Placed" and "Not Placed."

Here is a sample dataset row:

StudentID,CGPA,Internships,Projects,Workshops/Certifications,AptitudeTestScore,SoftSkillsRating,ExtracurricularActivities,PlacementTraining,SSC_Marks,HSC_Marks,PlacementStatus

1,7.5,1,1,1,65,4.4,No,No,61,79,NotPlaced

I need help creating a structured project with the following components:

1. **Data Analysis**: Perform exploratory data analysis (EDA) to understand the dataset, visualize trends, and identify correlations between features and the target variable.

2. **Model Building**: Create a machine learning pipeline to preprocess the data and train a model to predict the placement status.

3. **Experiment Tracking**: Set up a system to track experiments, including model performance metrics, hyperparameters, and results.

4. **Model Training**: Train the model using appropriate algorithms and evaluate its performance using metrics like accuracy, precision, recall, and F1-score.

5. **Hyperparameter Tuning**: Optimize the model’s performance by tuning hyperparameters using techniques like grid search or random search.

6. **Model Inference Application**: Build an application (e.g., a web app or API) to allow users to input student data and get predictions on placement status.

7. **Dockerfile for Containerization**: Create a Dockerfile to containerize the application for easy deployment.

8. **Cloud Deployment**: Deploy the application on a cloud platform (e.g., AWS, Azure, or Google Cloud) to make it accessible online.

9. **Accessing the Model**: Provide a way to access the deployed model via an API or web interface.

Please provide the following:

- A folder structure for organizing the project files. (Also provide bash command for creating the folders and files.)

- Python scripts or code snippets for each of the above components.

- Suggestions for tools and libraries to use (e.g., pandas, scikit-learn, Flask, Docker, etc.).

- Guidance on setting up experiment tracking (using MLflow).

- Steps for deploying the model on a Hugging Face Space.”
Sebagai balasannya, Anda akan menerima respons terperinci tentang struktur proyek dan cara membangun semuanya dari awal.
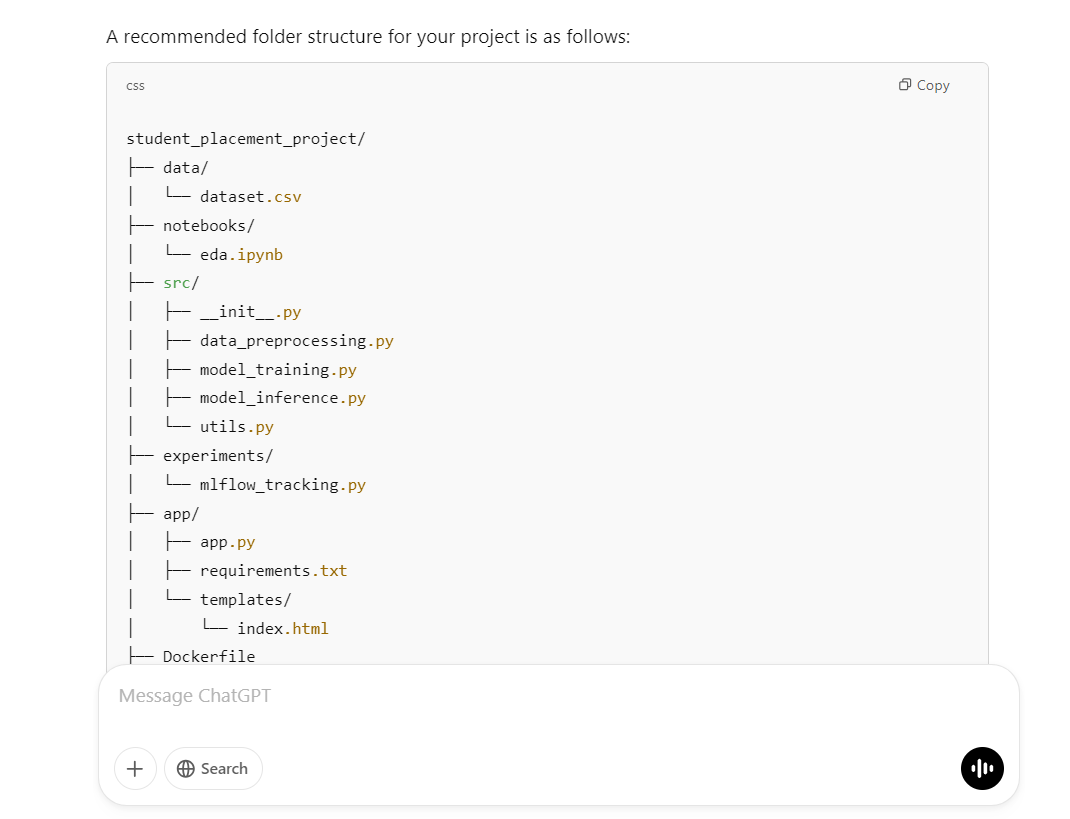
Skrip yang disediakan akan membuat direktori proyek, folder, dan semua file yang diperlukan:
mkdir -p student_placement_project/{data,notebooks,src,experiments,app/templates}
touch student_placement_project/data/dataset.csv \
      student_placement_project/notebooks/eda.ipynb \
      student_placement_project/src/{__init__.py,data_preprocessing.py,model_training.py,model_inference.py,utils.py} \
      student_placement_project/experiments/mlflow_tracking.py \
      student_placement_project/app/{app.py,requirements.txt} \
      student_placement_project/app/templates/index.html \
      student_placement_project/{Dockerfile,requirements.txt,README.md}
Seperti yang kita lihat, skrip ini telah menyelesaikan semua tugas yang diperlukan untuk kita.
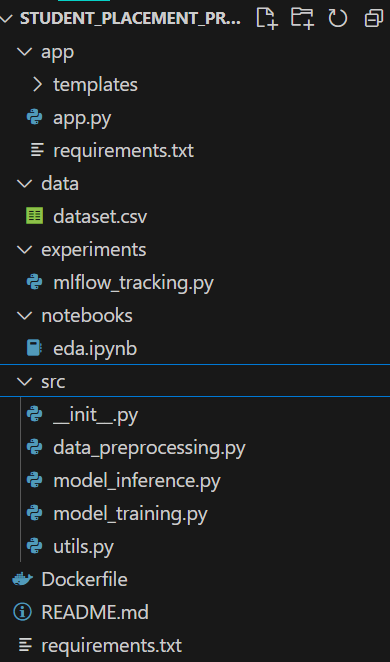
Responsnya telah menyediakan kode untuk file Jupyter notebook. Yang perlu Anda lakukan hanyalah menempelkan kodenya satu per satu dan menjalankannya untuk melihat output.
# notebooks/eda.ipynb
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
import numpy as np

# Load dataset
df = pd.read_csv('../data/dataset.csv')

# Basic info and descriptive statistics
print(df.info())
print(df.describe())

# Visualize distributions
sns.histplot(df['CGPA'], bins=20, kde=True)
plt.title('Distribution of CGPA')
plt.show()

# Correlation matrix
plt.figure(figsize=(10, 8))

# Compute correlation matrix only on numeric columns
numeric_df = df.select_dtypes(include=[np.number])
plt.figure(figsize=(10, 8))
corr = numeric_df.corr()
sns.heatmap(corr, annot=True, cmap="coolwarm")
plt.title("Feature Correlation Matrix")


# Count plot for PlacementStatus
sns.countplot(x='PlacementStatus', data=df)
plt.title('Placement Status Count')
plt.show()
Seperti inilah tampilannya. Semua analitik data dan grafik ada dalam satu file agar siapa pun dapat meninjau.
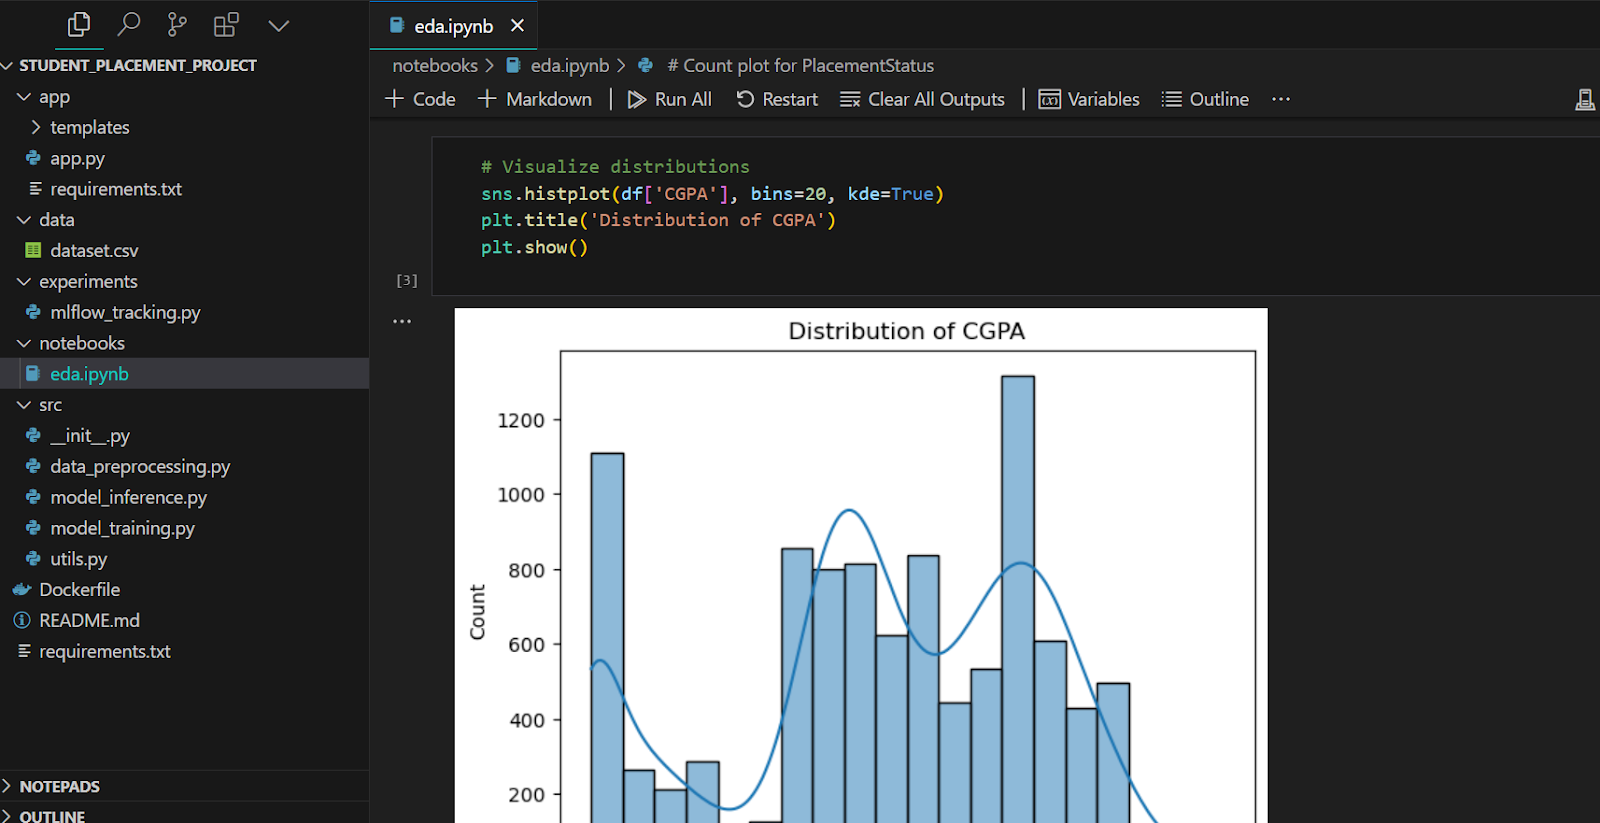
Selanjutnya, kita akan membuat file praproses data. Selain beberapa perubahan kecil, kode ini berjalan mulus.
# src/data_preprocessing.py
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler


def load_and_preprocess_data(filepath):
    df = pd.read_csv(filepath)

    # Convert categorical columns
    df["ExtracurricularActivities"] = df["ExtracurricularActivities"].map(
        {"Yes": 1, "No": 0}
    )
    df["PlacementTraining"] = df["PlacementTraining"].map({"Yes": 1, "No": 0})
    df["Workshops/Certifications"] = df["Workshops/Certifications"].astype(
        int
    )  # assuming it's already 0/1

    # Convert target column to binary
    df["PlacementStatus"] = df["PlacementStatus"].map({"Placed": 1, "NotPlaced": 0})

    # Feature selection (excluding StudentID)
    X = df.drop(["StudentID", "PlacementStatus"], axis=1)
    y = df["PlacementStatus"]

    # Split dataset
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42
    )

    # Scaling numeric features (optional)
    scaler = StandardScaler()
    X_train_scaled = scaler.fit_transform(X_train)
    X_test_scaled = scaler.transform(X_test)

return X_train_scaled, X_test_scaled, y_train, y_test, scalerSkrip pelatihan mengimpor fungsi pemrosesan data, memproses data terlebih dahulu, lalu melatih model random forest. Di akhir, skrip menampilkan metrik kinerja model.
# src/model_training.py
import joblib
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
from data_preprocessing import load_and_preprocess_data


def train_model(data_path):
    X_train, X_test, y_train, y_test, scaler = load_and_preprocess_data(data_path)

    # Initialize and train classifier
    clf = RandomForestClassifier(n_estimators=100, random_state=42)
    clf.fit(X_train, y_train)

    # Predictions and evaluation
    y_pred = clf.predict(X_test)
    metrics = {
        "accuracy": accuracy_score(y_test, y_pred),
        "precision": precision_score(y_test, y_pred),
        "recall": recall_score(y_test, y_pred),
        "f1_score": f1_score(y_test, y_pred),
    }
    print("Model Evaluation Metrics:", metrics)

    # Save model and scaler
    joblib.dump(clf, "model_rf.joblib")
    joblib.dump(scaler, "scaler.joblib")

    return clf, scaler, metrics


if __name__ == "__main__":
    train_model("data/dataset.csv")
Akurasi 78% tidak terlalu buruk.
$ python .\src\model_training.py

Model Evaluation Metrics: {'accuracy': 0.781, 'precision': 0.7462121212121212, 'recall': 0.7137681159420289, 'f1_score': 0.7296296296296296}
Jika Anda ingin mempelajari lebih banyak topik di area ini, lihat tutorial LLM populer kami, Fine-Tuning DeepSeek R1 (Reasoning Model). Tutorial ini membahas fine-tuning model penalaran open-source pertama di dunia pada dataset medical chain of thought untuk mengembangkan AI dokter yang lebih baik di masa depan.
Kita tidak ingin menyimpan skrip Python di folder yang berbeda. Kita akan memindahkan file mlflow_tracking.py ke folder src dan menghapus folder experiments. Harap dicatat bahwa Anda perlu melakukan beberapa perubahan kecil secara manual alih-alih meminta model o3-mini.
# src/mlflow_tracking.py
import mlflow
import mlflow.sklearn
from model_training import train_model


def run_experiment(data_path):
    mlflow.set_experiment("Student_Placement_Prediction")

    with mlflow.start_run():
        # Train the model
        clf, scaler, metrics = train_model(data_path)

        # Log parameters (example)
        mlflow.log_param("model_type", "RandomForest")
        mlflow.log_param("n_estimators", 100)

        # Log metrics
        mlflow.log_metric("accuracy", metrics["accuracy"])
        mlflow.log_metric("precision", metrics["precision"])
        mlflow.log_metric("recall", metrics["recall"])
        mlflow.log_metric("f1_score", metrics["f1_score"])

        # Log the model
        mlflow.sklearn.log_model(clf, "model")

        print("Experiment logged in MLflow.")


if __name__ == "__main__":
    run_experiment("data/dataset.csv")
Skrip Python berjalan mulus dan menghasilkan semua informasi.
$ python .\src\mlflow_tracking.py
Model Evaluation Metrics: {'accuracy': 0.781, 'precision': 0.7462121212121212, 'recall': 0.7137681159420289, 'f1_score': 0.7296296296296296}
2025/02/17 00:03:34 WARNING mlflow.models.model: Model logged without a signature and input example. Please set `input_example` parameter when logging the model to auto infer the model signature.
Experiment logged in MLflow.
Semua eksperimen machine learning disimpan secara lokal, yang dapat Anda visualisasikan menggunakan MLflow UI.
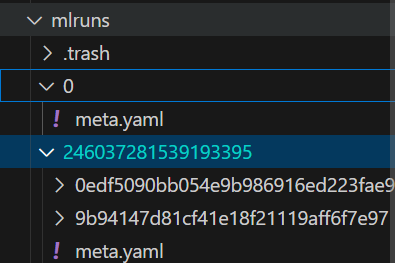
Respons o3-mini juga menyediakan langkah opsional yang dapat Anda tambahkan ke skrip model_training.py. Kami memasukkan langkah ini untuk melihat apakah kinerja model Anda akan meningkat atau tidak.
# src/model_training.py
import joblib
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
from data_preprocessing import load_and_preprocess_data
from sklearn.model_selection import GridSearchCV


def tune_model(X_train, y_train):
    param_grid = {"n_estimators": [50, 100, 150], "max_depth": [None, 5, 10]}
    clf = RandomForestClassifier(random_state=42)
    grid_search = GridSearchCV(clf, param_grid, cv=5, scoring="f1")
    grid_search.fit(X_train, y_train)
    print("Best parameters:", grid_search.best_params_)
    return grid_search.best_estimator_

def train_model(data_path):
    X_train, X_test, y_train, y_test, scaler = load_and_preprocess_data(data_path)

    # Initialize and train classifier
    clf = tune_model(X_train, y_train)

    # Predictions and evaluation
    y_pred = clf.predict(X_test)
    metrics = {
        "accuracy": accuracy_score(y_test, y_pred),
        "precision": precision_score(y_test, y_pred),
        "recall": recall_score(y_test, y_pred),
        "f1_score": f1_score(y_test, y_pred),
    }
    print("Model Evaluation Metrics:", metrics)

    # Save model and scaler
    joblib.dump(clf, "model_rf.joblib")
    joblib.dump(scaler, "scaler.joblib")

    return clf, scaler, metrics


if __name__ == "__main__":
    train_model("data/dataset.csv")
Seperti yang Anda lihat, kinerja model kami sedikit meningkat menggunakan optimasi hiperparameter.
$ python .\src\model_training.py
Best parameters: {'max_depth': 5, 'n_estimators': 150}
Model Evaluation Metrics: {'accuracy': 0.791, 'precision': 0.7493917274939172, 'recall': 0.7439613526570048, 'f1_score': 0.7466666666666667}Saatnya membuat inferensi model. Kita akan mengembangkan aplikasi web Flask.
Pertama, kita perlu memuat model dan scaler. Setelah itu, kita akan memproses masukan pengguna dan memberikannya ke model untuk menghasilkan prediksi. Ini adalah aplikasi yang cukup sederhana.
import joblib
import numpy as np

app = Flask(__name__)

# Load the trained model and scaler (update paths as necessary)
model = joblib.load("model_rf.joblib")
scaler = joblib.load("scaler.joblib")


@app.route("/")
def home():
    return render_template("index.html")


@app.route("/predict", methods=["POST"])
def predict():
    try:
        # Expecting form data from the HTML template
        CGPA = float(request.form.get("CGPA"))
        Internships = int(request.form.get("Internships"))
        Projects = int(request.form.get("Projects"))
        Workshops_Certifications = int(request.form.get("Workshops_Certifications"))
        AptitudeTestScore = float(request.form.get("AptitudeTestScore"))
        SoftSkillRating = float(request.form.get("SoftSkillRating"))
        ExtracurricularActivities = request.form.get("ExtracurricularActivities")
        PlacementTraining = request.form.get("PlacementTraining")
        SSC_Marks = float(request.form.get("SSC_Marks"))
        HSC_Marks = float(request.form.get("HSC_Marks"))

        # Convert categorical fields to numerical
        extra_act = 1 if ExtracurricularActivities.lower() == "yes" else 0
        placement_training = 1 if PlacementTraining.lower() == "yes" else 0

        # Construct feature vector
        features = [
            CGPA,
            Internships,
            Projects,
            Workshops_Certifications,
            AptitudeTestScore,
            SoftSkillRating,
            extra_act,
            placement_training,
            SSC_Marks,
            HSC_Marks,
        ]

        # Scale features and make prediction
        features_scaled = scaler.transform(np.array(features).reshape(1, -1))
        prediction = model.predict(features_scaled)
        result = "Placed" if prediction[0] == 1 else "Not Placed"

        return render_template("index.html", prediction=result)
    except Exception as e:
        return render_template("index.html", prediction=f"Error: {e}")


if __name__ == "__main__":
    app.run(host='0.0.0.0', port=5000, debug=True)
Untuk membuat antarmuka pengguna aplikasi, kami menempelkan kode HTML ke file index.html. Semuanya disediakan oleh model o3-mini. Anda bahkan dapat meminta model o3-mini untuk menyempurnakan antarmuka pengguna.
<!-- app/templates/index.html -->
<!DOCTYPE html>
<html>
<head>
    <title>Student Placement Prediction</title>
</head>
<body>
    <h1>Student Placement Prediction</h1>
    <form action="/predict" method="post" id="predictForm">
        <!-- Create inputs for each feature. Example for CGPA: -->
        <label for="CGPA">CGPA:</label>
        <input type="number" step="0.1" id="CGPA" name="CGPA" required><br><br>
        <!-- Add more inputs as per features -->
        <button type="submit">Predict</button>
    </form>
    <div id="result"></div>
    <script>
      document.getElementById('predictForm').addEventListener('submit', async (e) => {
          e.preventDefault();
          const formData = new FormData(e.target);
          const data = Object.fromEntries(formData.entries());
          // Adjust keys to match what the API expects
          data.ExtracurricularActivities = data.ExtracurricularActivities || 'No';
          data.PlacementTraining = data.PlacementTraining || 'No';

          const response = await fetch('/predict', {
              method: 'POST',
              headers: {'Content-Type': 'application/json'},
              body: JSON.stringify(data)
          });
          const result = await response.json();
          document.getElementById('result').innerText = JSON.stringify(result);
      });
    </script>
</body>
</html>
Setelah semuanya siap, jalankan aplikasi dan klik URL yang dihasilkan oleh Flask.
$ python .\app\app.py

 * Running on all addresses (0.0.0.0)
 * Running on http://127.0.0.1:5000
 * Running on http://192.168.100.41:5000
Aplikasi web kami berjalan mulus.
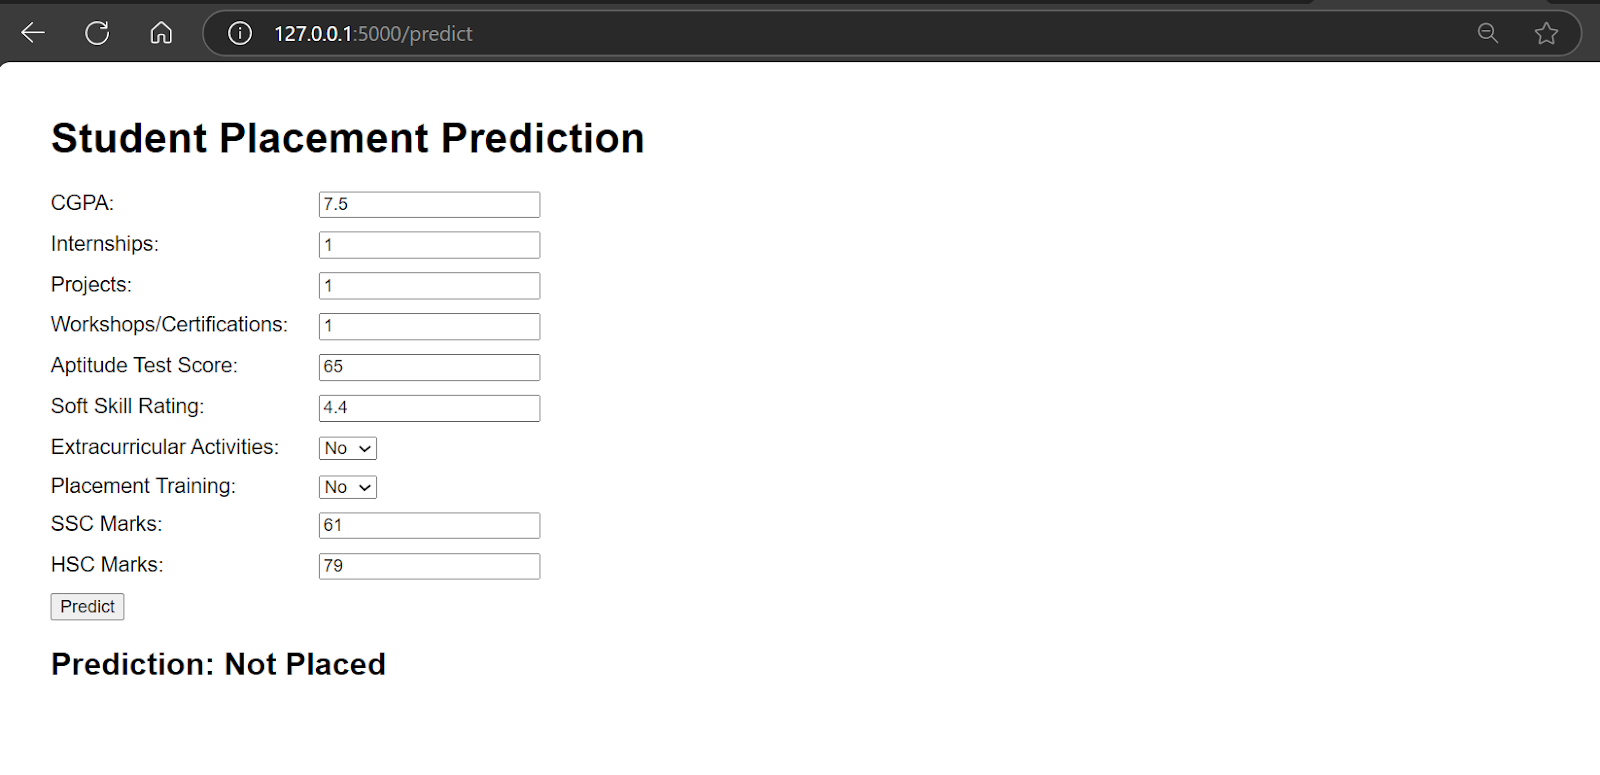
Model o3-mini juga telah menyediakan Dockerfile, dan yang perlu kita lakukan adalah membangunnya secara lokal dan mengujinya sebelum mendistribusikannya ke cloud.
# Use an official Python runtime as a parent image
FROM python:3.12-slim

# Set the working directory in the container
WORKDIR /app

# Copy the requirements file and install dependencies
COPY requirements.txt ./
RUN pip install --upgrade pip && pip install -r requirements.txt

# Copy the entire project
COPY . .

# Expose port (adjust as necessary)
EXPOSE 5000

# Command to run the Flask app
CMD ["python", "app/app.py"]
Bangun image Docker menggunakan perintah berikut.
$ docker build -t kingabzpro/student_placement . 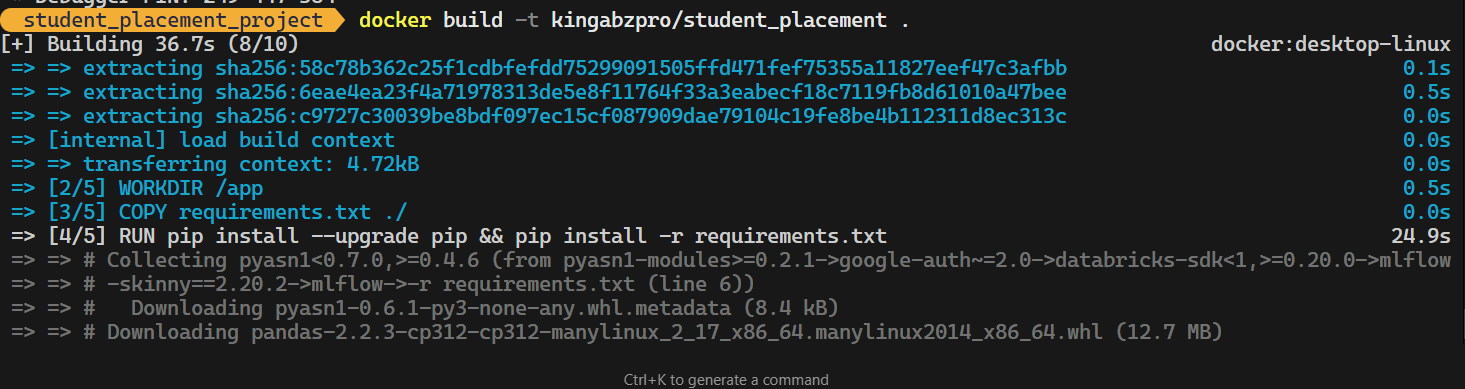
Jalankan Image Docker secara lokal.
$ docker run -p 5000:5000 kingabzpro/student_placementAnda dapat melihat bahwa Docker kita berjalan dengan sempurna.
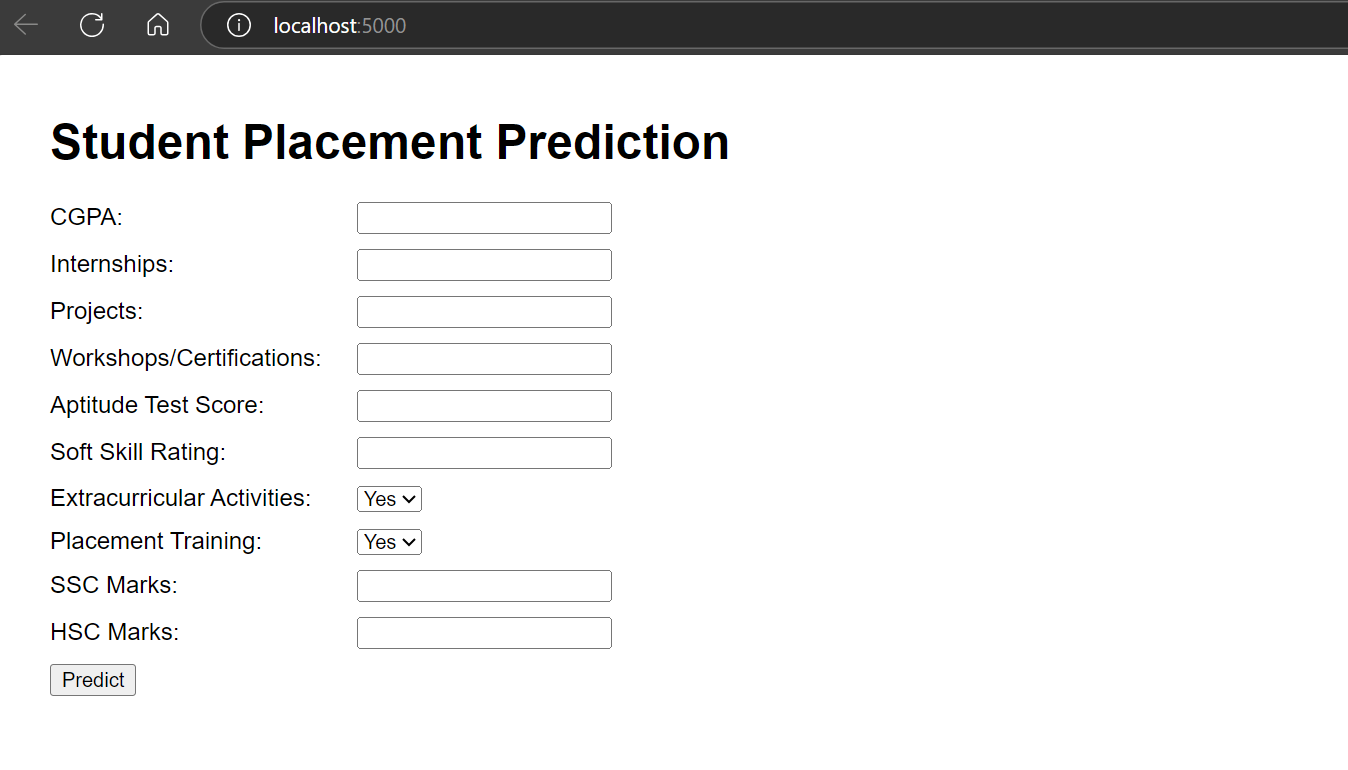
Saatnya mendistribusikan aplikasi machine learning kita di Hugging Face Cloud (Space).
Untuk memulai, Anda dapat membuat space baru. Tambahkan semua informasi yang diperlukan tentang aplikasi dan pilih Docker sebagai SDK.
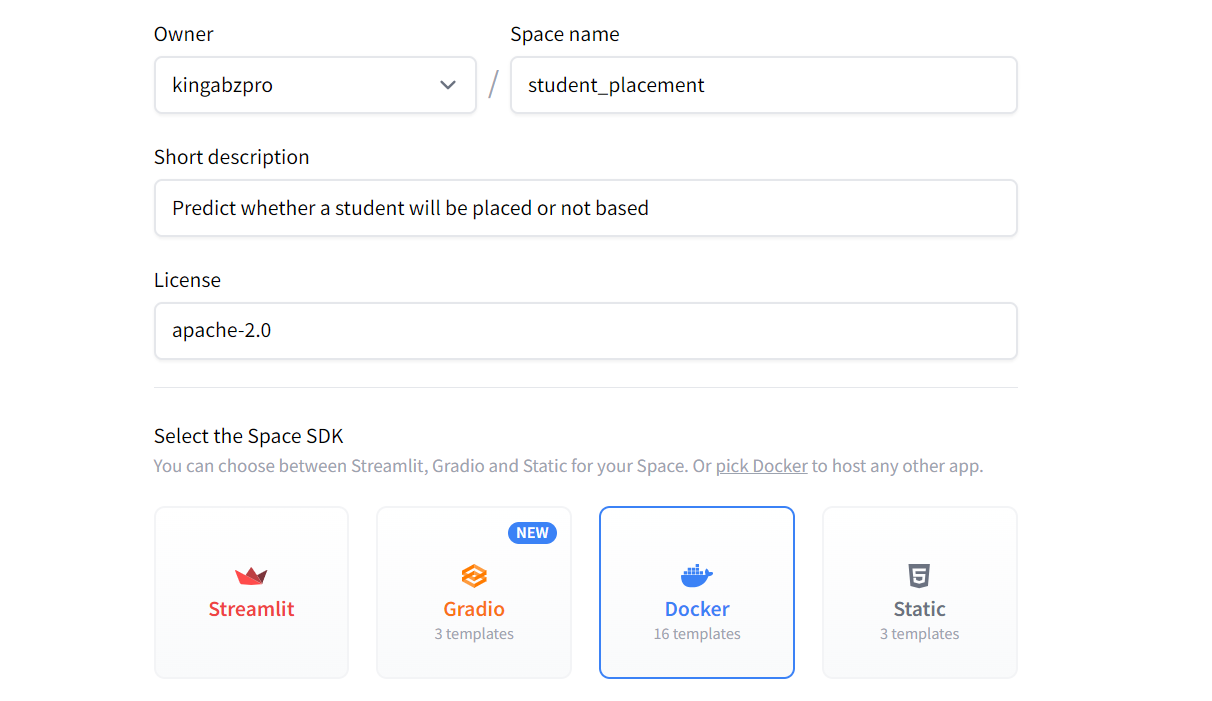
Setelah itu, akan dihasilkan URL untuk Anda kloning aplikasinya secara lokal.
$ git clone https://huggingface.co/spaces/kingabzpro/student_placementSelanjutnya, pindahkan model, scaler, folder app, Dockerfile, dan requirements.txt ke repositori aplikasi.
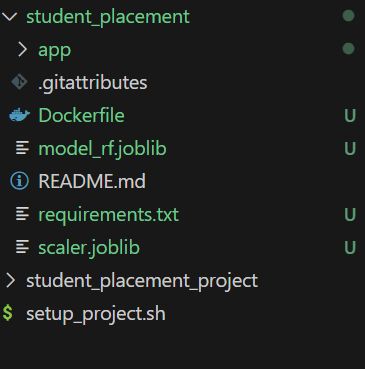
Anda dapat mengubah file app.py dengan memperbarui baris terakhir menjadi:
app.run(host="0.0.0.0", port=7860, debug=True)Periksa port yang diekspos di Dockerfile. Kita perlu melakukan ini untuk menghindari kesalahan atau masalah port:
# Expose port (adjust as necessary)
EXPOSE 7860
Setelah Anda melakukan semua perubahan, commit pembaruan dan dorong ke repositori remote:
$ cd .\student_placement\
$ git add .
$ git commit -m "Initial commit of Dockerized student placement app"
$ git push
Segera setelah Anda mendorong perubahan, proses build akan dimulai dan kemudian men-deploy antarmuka pengguna untuk aplikasi Anda.
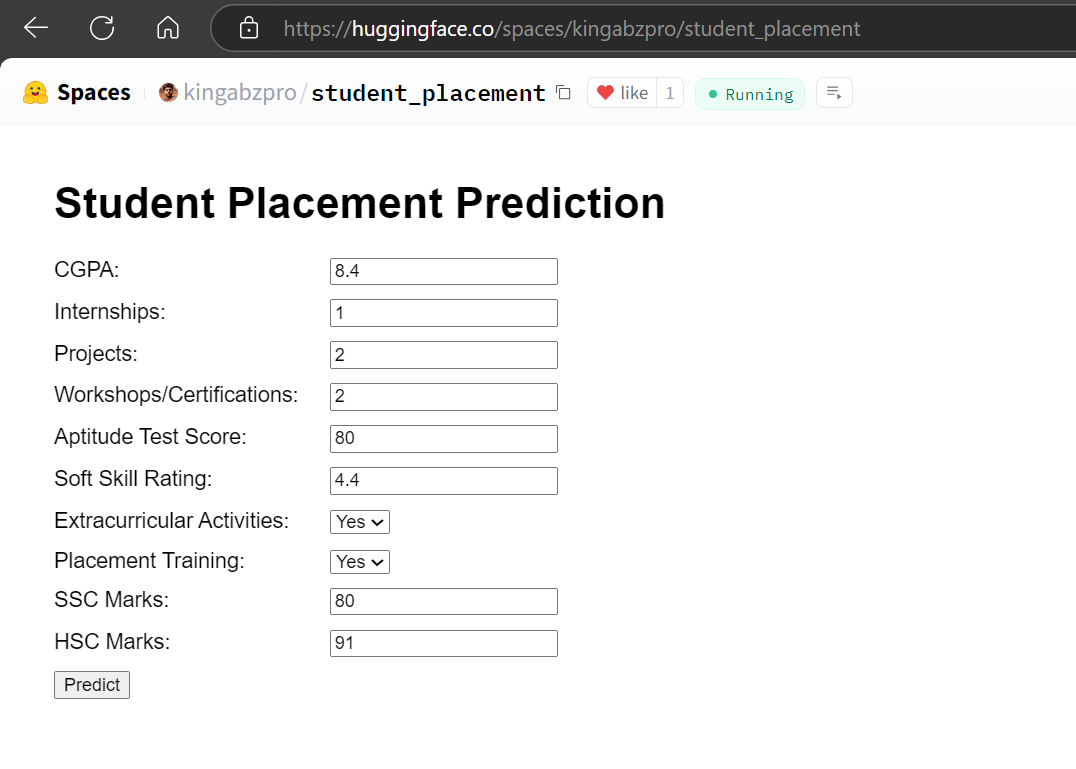
Sumber: Student Placement
o3-mini melakukan pekerjaan yang luar biasa, dari pengelolaan direktori proyek hingga berhasil mendistribusikan aplikasi web ke cloud.
Anda juga dapat membaca tentang model mutakhir Google dan mempelajari cara membangun aplikasi AI Anda sendiri dengan mengikuti tutorial Building Multimodal AI Application with Gemini 2.0 Pro.
Model o3-mini itu unik, yang berarti Anda perlu berhati-hati saat membuat permintaan lanjutan dan melakukan debug kode. Berikut beberapa tips agar Anda dapat bekerja efektif dengannya:
Saat memberikan instruksi, pastikan jelas dan konsisten. Jika Anda memberikan beberapa perintah, o3-mini akan memprioritaskan instruksi yang paling baru. Artinya, perintah terbaru dalam rantai prompt yang panjang akan diutamakan, yang berpotensi menimpa perintah sebelumnya.
Beberapa masalah kode mungkin perlu diselesaikan secara manual alih-alih mengandalkan model untuk memperbaikinya. Jika Anda meminta o3-mini untuk memperbaiki bagian kode tertentu, ia hanya akan mengubah bagian tersebut. Namun, ini bisa menyebabkan bagian terkait kode lainnya rusak, karena model tidak selalu memperhitungkan dependensi atau konteks yang lebih luas.
Sertakan semua detail yang relevan dalam prompt Anda, seperti data mentah, baris dan kolom yang didefinisikan dengan jelas, serta konteks tambahan apa pun. Ini membantu model memahami permintaan Anda dengan lebih akurat dan menghasilkan hasil yang lebih baik.
Uraikan dengan jelas apa yang Anda ingin model kembalikan. Misalnya, tentukan apakah Anda memerlukan folder, file, perintah Docker, atau panduan langkah demi langkah tentang cara menerapkan solusi. Ini memastikan output selaras dengan ekspektasi Anda.
Mulailah dengan base prompt yang terstruktur baik dan mencakup 90% dari kebutuhan Anda. Setelah dasarnya terbentuk, Anda dapat memberikan perintah lanjutan untuk menyempurnakan, memperbaiki, atau menambahkan lebih banyak langkah pada prosesnya.
Model o3-mini menonjol sebagai pilihan unggul dibandingkan GPT-4o, menawarkan performa lebih cepat daripada o1 dan unggul dalam tugas seperti coding Python dan HTML. Menariknya, kode Python yang dihasilkan o3-mini berjalan mulus hampir sepanjang waktu tanpa masalah. Model ini bahkan dapat menyempurnakan kode HTML, membantu Anda meningkatkan antarmuka pengguna dan membuatnya lebih menarik secara visual.
Dalam tutorial ini, kami mengeksplorasi kekuatan model o3-mini dalam konteks proyek machine learning. Model o3-mini terbukti menjadi alat yang sangat baik bagi data scientist, machine learning engineer, dan profesional teknis. Kemampuannya menangani tugas kompleks secara efisien menjadikannya aset berharga dalam alur kerja apa pun.
Untuk mendapatkan hasil terbaik, yang perlu Anda lakukan hanyalah memberikan konteks komprehensif, termasuk semua konten dan deliverable yang relevan, dalam prompt awal Anda. Setelah model menghasilkan output, Anda dapat beralih ke editor kode, mulai menjalankan skrip, dan menerapkan kode yang disediakan beserta instruksinya.
Selanjutnya, Anda perlu mempelajari cara mendistribusikan LLM mutakhir Anda sendiri di cloud. Alih-alih bergantung pada OpenAI, ini memberi Anda kontrol penuh atas harga, akurasi, dan aksesibilitas data Anda. Ikuti tutorial How to Deploy LLMs with BentoML untuk mempelajari semua hal tentang proses ini.
Kursus Teratas DataCamp
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt



