Kursus
Pengantar R
4 jam
3.1M
Machine learning adalah cabang ilmu komputer yang mempelajari perancangan algoritma yang dapat belajar. Tugas machine learning yang umum adalah pembelajaran konsep, pembelajaran fungsi atau “pemodelan prediktif”, pengelompokan, dan menemukan pola prediktif. Tugas-tugas ini dipelajari melalui data yang tersedia yang diamati melalui pengalaman atau instruksi, misalnya. Machine learning berharap bahwa memasukkan pengalaman ke dalam tugas-tugasnya pada akhirnya akan meningkatkan proses pembelajaran. Tujuan akhirnya adalah meningkatkan pembelajaran sedemikian rupa sehingga menjadi otomatis, sehingga manusia seperti kita tidak perlu lagi ikut campur.
Tutorial singkat ini bertujuan memperkenalkan Anda pada dasar-dasar machine learning di R: lebih khusus lagi, ini akan menunjukkan cara menggunakan R untuk bekerja dengan algoritma machine learning yang terkenal bernama “KNN” atau k-nearest neighbors.
Jika Anda tertarik mengikuti kursus, pertimbangkan untuk melihat Introduction to Machine Learning with R atau kursus DataCamp Unsupervised Learning in R!
Algoritma KNN atau k-nearest neighbors adalah salah satu algoritma machine learning yang paling sederhana dan merupakan contoh pembelajaran berbasis instance, di mana data baru diklasifikasikan berdasarkan instance berlabel yang tersimpan.
Secara lebih spesifik, jarak antara data yang tersimpan dan instance baru dihitung menggunakan semacam ukuran kesamaan. Ukuran kesamaan ini biasanya dinyatakan sebagai ukuran jarak seperti jarak Euclidean, kemiripan kosinus, atau jarak Manhattan.
Dengan kata lain, kesamaan terhadap data yang sudah ada di dalam sistem dihitung untuk setiap titik data baru yang Anda masukkan ke dalam sistem.
Kemudian, Anda menggunakan nilai kesamaan ini untuk melakukan pemodelan prediktif. Pemodelan prediktif bisa berupa klasifikasi, yaitu memberikan label atau kelas pada instance baru, atau regresi, yaitu memberikan nilai pada instance baru. Apakah Anda mengklasifikasikan atau memberikan nilai pada instance baru tentu saja bergantung pada bagaimana Anda menyusun model KNN Anda.
Algoritma k-nearest neighbor menambahkan pada algoritma dasar ini bahwa setelah jarak titik baru ke semua titik data yang tersimpan dihitung, nilai jarak diurutkan dan ditentukan k tetangga terdekat. Label dari para tetangga ini dikumpulkan dan pemungutan suara mayoritas atau pemungutan suara berbobot digunakan untuk keperluan klasifikasi atau regresi.
Dengan kata lain, semakin tinggi skor untuk suatu titik data yang sudah tersimpan, semakin besar kemungkinan instance baru akan menerima klasifikasi yang sama dengan tetangganya. Dalam kasus regresi, nilai yang akan diberikan pada titik data baru adalah rata-rata dari k tetangga terdekatnya.
Machine learning biasanya dimulai dari data yang diamati. Anda dapat menggunakan set data Anda sendiri atau menelusuri sumber lain untuk menemukannya.
Tutorial ini menggunakan set data Iris, yang sangat terkenal di bidang machine learning. Dataset ini sudah tersedia di R, jadi Anda dapat melihat dataset ini dengan mengetik berikut ini di konsol Anda:
Jika Anda ingin mengunduh set data alih-alih menggunakan yang sudah ada di R, Anda dapat membuka UC Irvine Machine Learning Repository dan mencari set data Iris.
Tip: jangan hanya melihat folder data dari set data Iris, tetapi juga lihat halaman deskripsi datanya!
Kemudian, gunakan perintah berikut untuk memuat data:
Perintah tersebut membaca berkas .csv atau “Comma Separated Value” dari situs web. Argumen header diatur ke FALSE, yang berarti set data Iris dari sumber ini tidak memberikan nama atribut dari datanya.
Alih-alih nama atribut, Anda mungkin akan melihat nama kolom yang aneh seperti “V1” atau “V2” saat Anda memeriksa atribut iris dengan fungsi seperti head(). Nama-nama tersebut ditetapkan secara acak.
Untuk memudahkan bekerja dengan set data, ada baiknya Anda membuat sendiri nama kolomnya: Anda dapat melakukannya melalui fungsi names(), yang mengambil atau menetapkan nama suatu objek. Gabungkan nama atribut seperti yang Anda inginkan. Pada potongan kode di atas, Anda telah mencantumkan Sepal.Length, Sepal.Width, Petal.Length, Petal.Width, dan Species.
Sekali lagi, nama-nama ini bukan muncul begitu saja: lihat deskripsi set data yang ditautkan di atas; Biasanya Anda akan melihat semua nama ini tercantum.
Sekarang setelah Anda memuat set data Iris ke RStudio, Anda harus mencoba memahami secara menyeluruh tentang apa isi data Anda. Hanya melihat atau membaca tentang data Anda jelas tidak cukup untuk memulai!
Anda perlu terjun langsung, mengeksplorasi dan memvisualisasikan set data Anda, dan bahkan menambah pengetahuan domain jika Anda merasa datanya terlalu sulit.
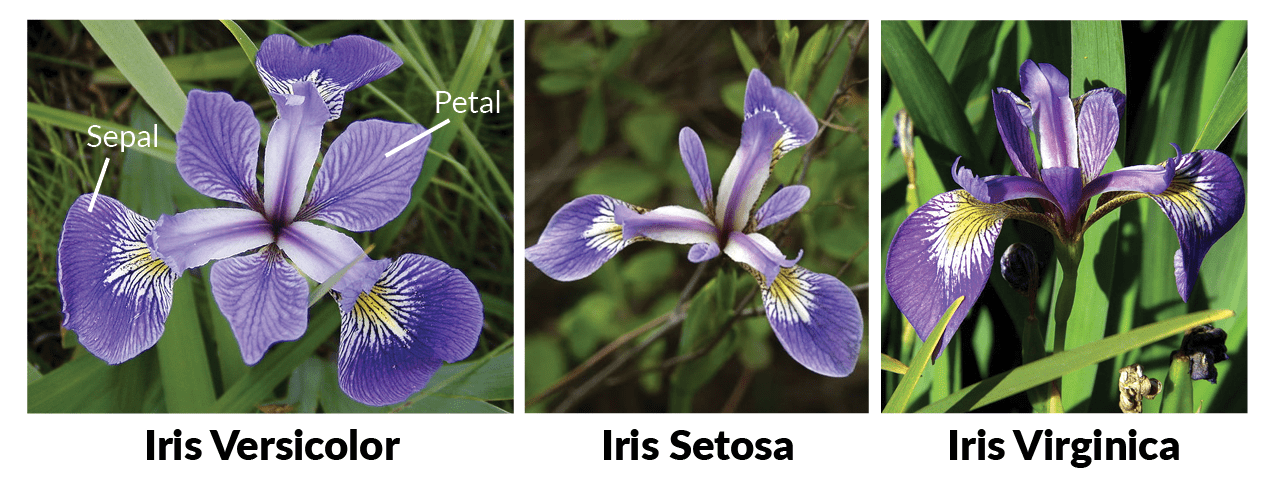
Mungkin Anda sudah memiliki pengetahuan domain yang diperlukan, tetapi sebagai pengingat, semua bunga memiliki sepal dan petal (mahkota). Sepal membungkus petal dan biasanya berwarna hijau dan mirip daun, sedangkan petal biasanya berupa daun berwarna. Untuk bunga iris, ini sedikit berbeda, seperti yang dapat Anda lihat pada gambar berikut:
Pertama, Anda sudah dapat mencoba mendapatkan gambaran tentang data Anda dengan membuat beberapa grafik, seperti histogram atau boxplot. Namun, dalam kasus ini, scatter plot dapat memberi Anda gambaran yang bagus tentang apa yang Anda hadapi: menarik untuk melihat seberapa besar satu variabel dipengaruhi oleh variabel lainnya.
Dengan kata lain, Anda ingin melihat apakah ada korelasi antara dua variabel.
Anda dapat membuat scatterplot dengan paket ggvis, misalnya.
Catatan bahwa Anda perlu memuat paket ggvis terlebih dahulu:
# Load in `ggvis`
library(ggvis)

# Iris scatter plot
iris %>% ggvis(~Sepal.Length, ~Sepal.Width, fill = ~Species) %>% layer_points()
Anda melihat bahwa terdapat korelasi yang tinggi antara panjang sepal dan lebar sepal pada bunga iris Setosa, sementara korelasi agak kurang tinggi untuk bunga Virginica dan Versicolor: titik-titik data lebih tersebar di grafik dan tidak membentuk kluster seperti yang Anda lihat pada bunga Setosa.
Scatter plot yang memetakan panjang petal dan lebar petal menceritakan kisah yang serupa:
iris %>% ggvis(~Petal.Length, ~Petal.Width, fill = ~Species) %>% layer_points()
Anda melihat bahwa grafik ini menunjukkan korelasi positif antara panjang petal dan lebar petal untuk semua spesies yang termasuk dalam set data Iris. Tentu saja, Anda mungkin perlu menguji hipotesis ini lebih lanjut jika ingin benar-benar yakin:
Anda melihat bahwa ketika Anda menggabungkan ketiga spesies, korelasinya sedikit lebih kuat daripada saat Anda melihat masing-masing spesies secara terpisah: korelasi keseluruhan adalah 0,96, sedangkan untuk Versicolor adalah 0,79. Setosa dan Virginica, di sisi lain, memiliki korelasi antara panjang dan lebar petal masing-masing 0,31 dan 0,32 ketika dibulatkan.
Tip: penasaran dengan ggvis, grafik, atau histogram secara khusus? Lihat tutorial histogram dan/atau kursus ggvis kami.
Setelah gambaran umum data secara visual, Anda juga dapat melihat set data dengan memasukkan
Namun, seperti yang akan Anda lihat dari hasil perintah ini, ini bukan cara terbaik untuk memeriksa set data Anda secara menyeluruh: set data memakan banyak ruang di konsol, yang akan menghambat Anda membentuk gambaran yang jelas tentang data Anda. Karena itu, lebih baik memeriksa set data dengan menjalankan head(iris) atau str(iris).
Perhatikan bahwa perintah terakhir akan membantu Anda membedakan dengan jelas tipe data num dan tiga level dari atribut Species, yang merupakan faktor. Ini sangat berguna, karena banyak pengklasifikasi machine learning R mengharuskan fitur target dikodekan sebagai faktor.
Ingat bahwa variabel faktor merepresentasikan variabel kategorikal di R. Jadi, nilainya terbatas pada sejumlah nilai yang berbeda.
Sekilas melihat atribut Species menunjukkan bahwa pembagian spesies bunga adalah 50-50-50. Di sisi lain, jika Anda ingin memeriksa pembagian persentase dari atribut Species, Anda dapat meminta tabel proporsi:
Catatan bahwa argumen round membulatkan nilai dari argumen pertama, prop.table(table(iris$Species))*100 ke jumlah digit yang ditentukan, yaitu satu digit setelah koma. Anda dapat dengan mudah menyesuaikannya dengan mengubah nilai argumen digits.
Jangan berhenti pada gambaran tingkat tinggi ini! R memberi Anda kesempatan untuk masuk lebih dalam dengan fungsi summary(). Ini akan memberikan nilai minimum, kuartil pertama, median, mean, kuartil ketiga, dan nilai maksimum dari set data Iris untuk tipe data numerik. Untuk variabel kelas, jumlah faktor akan dikembalikan:
Seperti yang Anda lihat, fungsi c() ditambahkan ke perintah asli: kolom petal width dan sepal width digabungkan dan kemudian diminta ringkasan hanya untuk dua kolom ini dari set data Iris.
Setelah Anda memahami data dengan baik, Anda harus memutuskan kasus penggunaan apa yang relevan untuk set data Anda. Dengan kata lain, Anda memikirkan apa yang dapat diajarkan set data Anda atau apa yang menurut Anda dapat dipelajari dari data Anda. Dari sana, Anda dapat memikirkan algoritma apa yang dapat Anda terapkan pada set data Anda untuk mendapatkan hasil yang Anda perkirakan.
Tip: ingatlah bahwa semakin akrab Anda dengan data Anda, semakin mudah menilai kasus penggunaan untuk set data spesifik Anda. Hal yang sama juga berlaku untuk menemukan algoritma machine learning yang sesuai.
Untuk tutorial ini, set data Iris akan digunakan untuk klasifikasi, yang merupakan contoh pemodelan prediktif. Atribut terakhir dari set data, Species, akan menjadi variabel target atau variabel yang ingin Anda prediksi pada contoh ini.
Catatan bahwa Anda juga dapat mengambil salah satu kelas numerik sebagai variabel target jika Anda ingin menggunakan KNN untuk melakukan regresi.
Banyak algoritma yang digunakan dalam machine learning tidak secara bawaan disertakan dalam R. Kemungkinan besar Anda perlu mengunduh paket yang ingin Anda gunakan saat mulai melakukan machine learning.
Tip: sudah ada gambaran tentang algoritma pembelajaran yang mungkin Anda gunakan, tetapi belum tahu paket mana yang Anda inginkan atau butuhkan? Anda dapat menemukan gambaran yang cukup lengkap tentang semua paket yang digunakan di R di sini.
Untuk mengilustrasikan algoritma KNN, tutorial ini bekerja dengan paket class:
Jika Anda belum memiliki paket ini, Anda dapat melakukannya dengan cepat dan mudah dengan mengetik baris kode berikut:
install.packages("<package name>")Ingat tip nerd: jika Anda tidak yakin apakah Anda memiliki paket ini, Anda dapat menjalankan perintah berikut untuk mengetahuinya!
any(grepl("<name of your package>", installed.packages()))Setelah mengeksplorasi data Anda dan menyiapkan workspace, Anda akhirnya dapat kembali fokus pada tugas yang ada: membuat model machine learning. Namun, sebelum melakukannya, penting juga untuk menyiapkan data Anda. Bagian berikut akan menguraikan dua cara untuk melakukannya: dengan menormalisasi data Anda (jika perlu) dan dengan membagi data Anda menjadi set pelatihan dan pengujian.
Sebagai bagian dari persiapan data Anda, Anda mungkin perlu menormalisasi data agar konsisten. Untuk tutorial pengantar ini, cukup ingat bahwa normalisasi memudahkan algoritma KNN untuk belajar. Ada dua jenis normalisasi:
Lalu kapan Anda perlu menormalisasi dataset Anda?
Singkatnya: ketika Anda curiga bahwa datanya tidak konsisten.
Anda dapat dengan mudah melihat ini saat meninjau hasil fungsi summary(). Lihat nilai minimum dan maksimum dari semua atribut (numerik). Jika Anda melihat satu atribut memiliki rentang nilai yang lebar, Anda perlu menormalisasi dataset, karena ini berarti jarak akan didominasi oleh fitur tersebut.
Misalnya, jika dataset Anda hanya memiliki dua atribut, X dan Y, dan X memiliki nilai berkisar dari 1 hingga 1000, sementara Y hanya dari 1 hingga 100, maka pengaruh Y pada fungsi jarak biasanya akan kalah oleh pengaruh X.
Saat Anda menormalisasi, Anda sebenarnya menyesuaikan rentang semua fitur, sehingga jarak antara variabel dengan rentang yang lebih besar tidak diberi penekanan berlebihan.
Tip: kembali ke hasil summary(iris) dan coba tentukan apakah normalisasi diperlukan.
Set data Iris tidak perlu dinormalisasi: atribut Sepal.Length memiliki nilai dari 4,3 hingga 7,9 dan Sepal.Width berisi nilai dari 2 hingga 4,4, sementara nilai Petal.Length berkisar dari 1 hingga 6,9 dan Petal.Width dari 0,1 hingga 2,5. Semua nilai dari semua atribut berada dalam rentang 0,1 hingga 7,9, yang dapat dianggap dapat diterima.
Meski begitu, tetap merupakan ide yang baik untuk mempelajari normalisasi dan efeknya, terutama jika Anda baru dalam machine learning. Anda dapat melakukan normalisasi fitur, misalnya, dengan terlebih dahulu membuat fungsi normalize() Anda sendiri.
Kemudian Anda dapat menggunakan argumen ini dalam perintah lain, di mana Anda menempatkan hasil normalisasi ke dalam data frame melalui as.data.frame() setelah fungsi lapply() mengembalikan daftar dengan panjang yang sama seperti set data yang Anda berikan. Setiap elemen daftar tersebut adalah hasil penerapan argumen normalize pada set data yang menjadi input:
YourNormalizedDataSet <- as.data.frame(lapply(YourDataSet, normalize))Uji ini pada potongan DataCamp Light di bawah!
Untuk dataset Iris, Anda akan menerapkan argumen normalize pada keempat atribut numerik dari set data Iris (Sepal.Length, Sepal.Width, Petal.Length, Petal.Width) dan menempatkan hasilnya dalam data frame.
Tip: untuk lebih mengilustrasikan efek normalisasi pada set data, bandingkan hasil berikut dengan ringkasan set data Iris yang diberikan pada langkah dua.
Untuk menilai kinerja model Anda nanti, Anda perlu membagi set data menjadi dua bagian: set pelatihan dan set uji.
Yang pertama digunakan untuk melatih sistem, sedangkan yang kedua digunakan untuk mengevaluasi sistem yang telah dipelajari atau dilatih. Dalam praktiknya, pembagian set data Anda menjadi set uji dan pelatihan bersifat saling lepas: pilihan pemisahan yang paling umum adalah mengambil 2/3 dari set data asli sebagai set pelatihan, sementara 1/3 sisanya menjadi set uji.
Sekilas terakhir pada set data mengajarkan Anda bahwa jika Anda melakukan pembagian kedua set pada data apa adanya, Anda akan mendapatkan kelas pelatihan dengan semua spesies “Setosa” dan “Versicolor”, tetapi tidak ada “Virginica”. Oleh karena itu, model akan mengklasifikasikan semua instance yang tidak dikenal sebagai “Setosa” atau “Versicolor”, karena tidak menyadari adanya spesies bunga ketiga dalam data.
Singkatnya, Anda akan mendapatkan prediksi yang keliru untuk set uji.
Anda perlu memastikan bahwa ketiga kelas spesies hadir dalam model pelatihan. Lebih dari itu, jumlah instance dari ketiga spesies harus kurang lebih setara sehingga Anda tidak memihak satu kelas dibanding yang lain dalam prediksi Anda.
Untuk membuat set pelatihan dan uji, pertama-tama tetapkan seed. Ini adalah angka untuk pembangkit bilangan acak R. Keuntungan utama menetapkan seed adalah Anda dapat memperoleh urutan bilangan acak yang sama setiap kali Anda memberikan seed yang sama pada pembangkit bilangan acak.
set.seed(1234)Kemudian, Anda ingin memastikan bahwa set data Iris Anda teracak dan bahwa Anda memiliki jumlah setiap spesies yang setara dalam set pelatihan dan uji.
Anda menggunakan fungsi sample() untuk mengambil sampel dengan ukuran yang ditetapkan sebagai jumlah baris dari set data Iris, yaitu 150. Anda melakukan sampling dengan pengembalian: Anda memilih dari vektor 2 elemen dan menetapkan 1 atau 2 ke 150 baris set data Iris. Penetapan elemen tunduk pada bobot probabilitas 0,67 dan 0,33.
ind <- sample(2, nrow(iris), replace=TRUE, prob=c(0.67, 0.33))Catatan bahwa argumen replace diatur ke TRUE: ini berarti Anda menetapkan 1 atau 2 ke baris tertentu dan kemudian mengatur ulang vektor 2 ke kondisi semula. Ini berarti bahwa, untuk baris berikutnya dalam set data Anda, Anda dapat menetapkan 1 atau 2, setiap saat lagi. Probabilitas memilih 1 atau 2 tidak boleh sebanding dengan bobot di antara item yang tersisa, jadi Anda menetapkan bobot probabilitas. Perhatikan juga bahwa, meskipun Anda tidak melihatnya di potongan DataCamp Light, seed tetap diatur ke 1234.
Ingat bahwa Anda menginginkan set pelatihan berukuran 2/3 dari set data asli: itulah mengapa Anda menetapkan “1” dengan probabilitas 0,67 dan “2” dengan probabilitas 0,33 ke 150 baris sampel.
Anda kemudian dapat menggunakan sampel yang disimpan dalam variabel ind untuk mendefinisikan set pelatihan dan uji Anda:
Catatan bahwa, selain proporsi 2/3 dan 1/3 yang ditentukan di atas, Anda tidak mempertimbangkan semua atribut untuk membentuk set pelatihan dan uji. Secara khusus, Anda hanya mengambil Sepal.Length, Sepal.Width, Petal.Length, dan Petal.Width. Ini karena Anda sebenarnya ingin memprediksi atribut kelima, Species: itu adalah variabel target Anda. Namun, Anda memang ingin memasukkannya ke dalam algoritma KNN, jika tidak maka tidak akan ada prediksi untuknya.
Karena itu Anda perlu menyimpan label kelas dalam vektor faktor dan membaginya ke set pelatihan dan uji:
Setelah semua langkah persiapan ini, Anda telah memastikan bahwa semua data (pelatihan) yang diketahui tersimpan. Hingga saat ini belum ada model atau pembelajaran yang benar-benar dilakukan. Sekarang, Anda ingin mencari k tetangga terdekat dari set pelatihan Anda.
Cara mudah untuk melakukan dua langkah ini adalah dengan menggunakan fungsi knn(), yang menggunakan ukuran jarak Euclidean untuk menemukan k tetangga terdekat untuk instance baru yang tidak dikenal. Di sini, parameter k adalah yang Anda tentukan sendiri.
Seperti disebutkan sebelumnya, instance baru diklasifikasikan dengan melihat suara mayoritas atau suara berbobot. Dalam kasus klasifikasi, titik data dengan skor tertinggi memenangkan “pertarungan” dan instance yang tidak dikenal menerima label dari titik data pemenang tersebut. Jika ada jumlah pemenang yang sama, klasifikasi dilakukan secara acak.
Catatan: parameter k seringkali berupa angka ganjil untuk menghindari seri dalam perolehan suara.
Untuk membangun classifier Anda, Anda perlu menggunakan fungsi knn() dan cukup menambahkan beberapa argumen, seperti pada contoh ini:
Anda menyimpan ke dalam iris_pred fungsi knn() yang mengambil argumen set pelatihan, set uji, label pelatihan, dan jumlah tetangga yang ingin Anda temukan dengan algoritma ini. Hasil fungsi ini adalah vektor faktor dengan kelas prediksi untuk setiap baris data uji.
Catatan bahwa Anda tidak ingin memasukkan label uji: ini akan digunakan untuk melihat apakah model Anda bagus dalam memprediksi kelas aktual dari instance Anda!
Anda melihat bahwa saat Anda memeriksa hasilnya, iris_pred, Anda akan mendapatkan kembali vektor faktor dengan kelas prediksi untuk setiap baris data uji.
Langkah penting berikutnya dalam machine learning adalah evaluasi kinerja model Anda. Dengan kata lain, Anda ingin menganalisis tingkat ketepatan prediksi model.
Untuk pandangan yang lebih abstrak, Anda dapat membandingkan hasil iris_pred dengan label uji yang telah Anda definisikan sebelumnya:
Anda melihat bahwa model membuat prediksi yang cukup akurat, kecuali satu klasifikasi yang salah pada baris ke-29, di mana “Versicolor” diprediksi sementara label uji adalah “Virginica”.
Ini sudah merupakan indikasi kinerja model Anda, tetapi Anda mungkin ingin menyelami analisis lebih jauh. Untuk tujuan ini, Anda dapat mengimpor paket gmodels:
install.packages("package name")Namun, jika Anda sudah menginstal paket ini, Anda cukup memasukkan
library(gmodels)Kemudian Anda dapat membuat tabulasi silang atau tabel kontingensi. Jenis tabel ini sering digunakan untuk memahami hubungan antara dua variabel. Dalam kasus ini, Anda ingin memahami bagaimana kelas data uji Anda, yang disimpan dalam iris.testLabels berhubungan dengan model Anda yang disimpan dalam iris_pred:
CrossTable(x = iris.testLabels, y = iris_pred, prop.chisq=FALSE)
Catatan bahwa argumen terakhir prop.chisq menunjukkan apakah kontribusi chi-square dari setiap sel disertakan atau tidak. Statistik chi-square adalah jumlah kontribusi dari masing-masing sel dan digunakan untuk memutuskan apakah perbedaan antara nilai yang diamati dan yang diharapkan signifikan.
Dari tabel ini, Anda dapat mengetahui jumlah prediksi yang benar dan salah: satu instance dari set pengujian diberi label Versicolor oleh model, padahal sebenarnya merupakan bunga spesies Virginica. Anda dapat melihat ini di baris pertama spesies “Virginica” pada kolom iris.testLabels. Dalam semua kasus lain, prediksi yang benar dibuat. Anda dapat menyimpulkan bahwa kinerja model sudah cukup baik dan Anda tidak perlu memperbaikinya!
caretDi bagian sebelumnya, Anda telah mulai dengan supervised learning di R melalui algoritma KNN. Seperti yang mungkin Anda perhatikan, machine learning di R bisa menjadi sangat kompleks, karena ada berbagai algoritma dengan berbagai sintaks, parameter yang berbeda, dan sebagainya. Mungkin Anda akan setuju ketika saya mengatakan bahwa mengingat nama paket yang berbeda untuk setiap algoritma bisa cukup sulit atau menerapkan sintaks untuk setiap algoritma spesifik terasa terlalu banyak.
Di sinilah paket caret berguna: singkatan dari “Classification and Regression Training” dan menawarkan semua yang perlu Anda ketahui untuk menyelesaikan masalah supervised machine learning: paket ini menyediakan antarmuka seragam untuk banyak algoritma machine learning. Jika Anda sedikit akrab dengan machine learning di Python, Anda mungkin melihat kemiripan dengan scikit-learn!
Pada bagian berikut, Anda akan melalui langkah-langkah seperti yang telah diuraikan di atas, tetapi kali ini, Anda akan menggunakan caret untuk mengklasifikasikan data Anda. Perhatikan bahwa Anda telah melakukan banyak pekerjaan jika Anda mengikuti langkah-langkah seperti yang diuraikan di atas: Anda sudah memahami data Anda, telah mengeksplorasinya, menyiapkan workspace, dan sebagainya. Sekarang saatnya memproses awal data Anda dengan caret!
Seperti yang telah Anda lakukan sebelumnya, Anda dapat mempelajari efek normalisasi, tetapi Anda akan melihatnya nanti dalam tutorial.
Anda sudah tahu langkah berikutnya! Mari membagi data menjadi set pelatihan dan uji. Namun, dalam kasus ini, Anda menanganinya sedikit berbeda: Anda membagi data berdasarkan label yang Anda temukan di iris$Species. Selain itu, rasionya ditetapkan 75-25 untuk set pelatihan dan uji.
Anda siap untuk melatih model sekarang! Namun, seperti yang mungkin Anda ingat, caret adalah proyek yang sangat besar yang mencakup banyak algoritma. Jika Anda ragu algoritma apa saja yang termasuk dalam proyek ini, Anda dapat mendapatkan daftar semuanya. Tampilkan daftar tersebut dengan menjalankan names(getModelInfo()), seperti yang ditunjukkan potongan kode di bawah. Selanjutnya, pilih algoritma dan latih model dengan fungsi train():
Perhatikan bahwa membuat model lain sangatlah mudah ketika Anda sudah sampai sejauh ini; Anda hanya perlu mengubah argumen method, seperti pada contoh ini:
model_cart <- train(iris.training[, 1:4], iris.training[, 5], method='rpart2')Sekarang setelah Anda melatih model, saatnya memprediksi label set uji yang baru saja Anda buat dan mengevaluasi bagaimana kinerja model pada data Anda:
Selain itu, Anda dapat mencoba melakukan pengujian yang sama seperti sebelumnya, untuk meneliti efek prapemrosesan, seperti skala dan pemusatan, pada model Anda. Jalankan potongan kode berikut:
Selamat! Anda telah menyelesaikan tutorial ini!
Tutorial ini terutama berfokus pada penerapan algoritma machine learning dasar KNN dengan bantuan R. Set data Iris yang digunakan kecil dan mudah diikuti; Anda tidak hanya melihat bagaimana Anda dapat melakukan semua langkah sendiri, tetapi Anda juga melihat bagaimana Anda dapat dengan mudah memanfaatkan antarmuka seragam, seperti yang ditawarkan caret, untuk memulai machine learning Anda.
Tetapi Anda bisa melakukan jauh lebih banyak!
Jika Anda sudah cukup bereksperimen dengan dasar-dasar yang disajikan dalam tutorial ini dan algoritma machine learning lainnya, Anda mungkin tertarik untuk melangkah lebih jauh ke R dan analisis data.
Kursus R
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



