Kurs
Einführung in R
4 Std.
3.1M
Machine Learning ist ein Teilgebiet der Informatik, das sich mit der Entwicklung von Algorithmen befasst, die aus Daten lernen. Typische Aufgaben sind Konzepterkennung, Funktionslernen bzw. „Predictive Modeling“, Clustering sowie das Auffinden vorhersagerelevanter Muster. Das Lernen erfolgt auf Basis vorhandener Daten, die zum Beispiel durch Erfahrung oder Anweisungen erhoben wurden. Die Idee: Mit wachsender Erfahrung verbessert sich die Lernleistung. Das Ziel ist, das Lernen so weit zu automatisieren, dass wir Menschen nicht mehr eingreifen müssen.
Dieses kurze Tutorial führt dich in die Grundlagen des Machine Learnings in R ein. Konkret zeigt es dir, wie du in R mit dem bekannten Algorithmus „KNN“ bzw. k-Nearest Neighbors arbeitest.
Wenn du lieber einem Kurs folgen willst, schau dir unseren Kurs Introduction to Machine Learning with R oder DataCamps Unsupervised Learning in R an!
Der KNN-Algorithmus gehört zu den einfachsten Machine-Learning-Verfahren und ist ein Beispiel für instanzbasiertes Lernen: Neue Datenpunkte werden auf Basis gespeicherter, gelabelter Instanzen klassifiziert.
Genauer gesagt wird die Distanz zwischen den gespeicherten Daten und der neuen Instanz über ein Ähnlichkeitsmaß berechnet. Üblich sind Abstandsmaße wie die euklidische oder Manhattan-Distanz sowie die Kosinus-Ähnlichkeit.
Anders formuliert: Für jeden neuen Datenpunkt, den du ins System gibst, wird seine Ähnlichkeit zu den bereits vorhandenen Daten berechnet.
Mit diesem Ähnlichkeitswert führst du dann Predictive Modeling durch. Das kann Klassifikation sein, also das Zuweisen eines Labels bzw. einer Klasse, oder Regression, also das Zuweisen eines numerischen Werts. Ob Klassifikation oder Regression, hängt davon ab, wie du dein KNN-Modell aufsetzt.
Der k-Nearest-Neighbors-Algorithmus erweitert das Grundprinzip: Nachdem die Distanzen des neuen Punkts zu allen gespeicherten Punkten berechnet wurden, werden sie sortiert und die k nächsten Nachbarn bestimmt. Deren Labels werden eingesammelt, und für Klassifikation oder Regression wird eine Mehrheits- oder gewichtete Abstimmung verwendet.
Heißt: Je höher der Score eines bereits gespeicherten Nachbarn, desto wahrscheinlicher erhält die neue Instanz dessen Klassifikation. Bei Regression ist der zugewiesene Wert der Mittelwert der k nächsten Nachbarn.
Machine Learning startet in der Regel mit beobachteten Daten. Du kannst deinen eigenen Datensatz verwenden oder in anderen Quellen stöbern.
In diesem Tutorial nutzen wir den Iris-Datensatz, einen Klassiker im Machine Learning. Er ist in R enthalten, du kannst ihn dir in der Konsole mit folgendem Befehl ansehen:
Wenn du den Datensatz lieber separat herunterladen möchtest, findest du ihn im UC Irvine Machine Learning Repository unter „Iris“.
Tipp: Schau dir nicht nur den Datenordner an, sondern auch die Datenbeschreibung!
Mit folgendem Befehl lädst du die Daten anschließend ein:
Dieser Befehl liest die .csv- („Comma Separated Values“-)Datei von der Website ein. Das Argument header steht auf FALSE, da in dieser Quelle keine Spaltennamen mitgeliefert werden.
Statt Attributnamen siehst du beim Inspizieren des iris-Objekts mit head() eventuell „V1“, „V2“ usw. Diese werden automatisch vergeben.
Um die Arbeit zu erleichtern, vergibst du eigene Spaltennamen über names(), das die Namen eines Objekts liest oder setzt. Füge die gewünschten Attributnamen zusammen. Im obigen Code sind das Sepal.Length, Sepal.Width, Petal.Length, Petal.Width und Species.
Diese Namen kommen nicht aus dem Nichts: In der verlinkten Beschreibung des Datensatzes sind sie aufgeführt.
Nachdem du den Iris-Datensatz in RStudio geladen hast, verschaffe dir ein gründliches Verständnis deiner Daten. Nur anschauen oder darüber lesen reicht zum Start nicht aus!
Werde praktisch: Erkunde und visualisiere den Datensatz und eigne dir bei Bedarf zusätzliches Domänenwissen an.
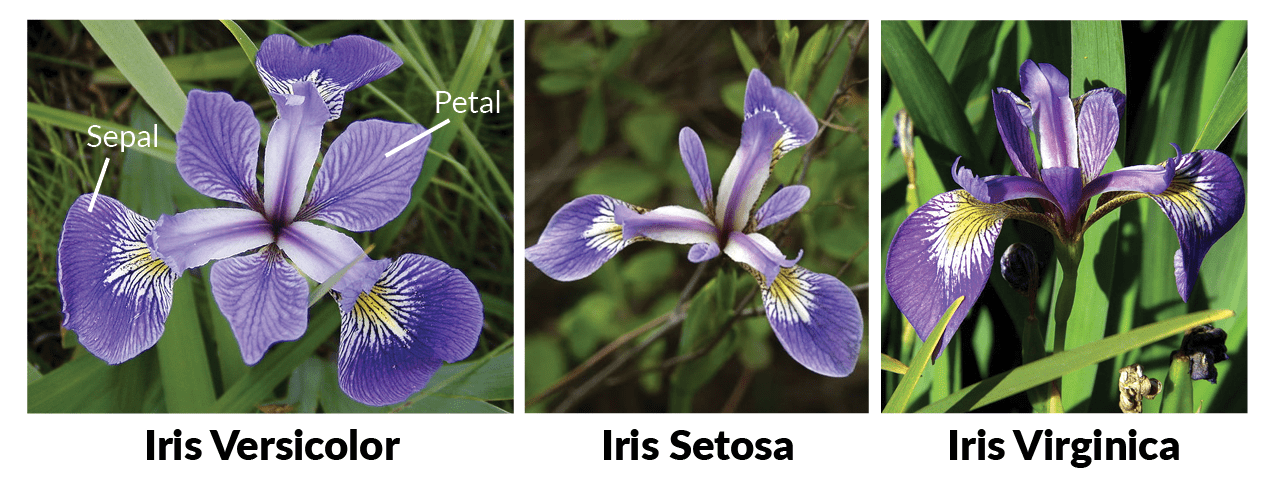
Wahrscheinlich bringst du das nötige Fachwissen schon mit. Zur Erinnerung: Jede Blüte hat Kelch- und Blütenblätter. Die Kelchblätter umschließen die Blütenblätter und sind meist grün und laubartig, die Blütenblätter sind in der Regel farbig. Bei Irisblüten ist das etwas anders, wie das folgende Bild zeigt:
Verschaffe dir zunächst mit Diagrammen wie Histogrammen oder Boxplots ein Bild. Besonders aufschlussreich sind hier jedoch Scatterplots: So erkennst du, wie stark eine Variable von einer anderen beeinflusst wird.
Mit anderen Worten: Du prüfst, ob zwischen zwei Variablen Korrelationen bestehen.
Scatterplots kannst du zum Beispiel mit dem ggvis-Paket erstellen.
Hinweis: Lade zuerst das Paket ggvis:
# Load in `ggvis`
library(ggvis)

# Iris scatter plot
iris %>% ggvis(~Sepal.Length, ~Sepal.Width, fill = ~Species) %>% layer_points()
Du siehst eine starke Korrelation zwischen Kelchblatt-Länge und -Breite bei Setosa, während sie bei Virginica und Versicolor schwächer ausfällt: Die Punkte sind stärker gestreut und bilden – anders als bei Setosa – keinen dichten Cluster.
Der Scatterplot für Blütenblatt-Länge und -Breite zeigt ein ähnliches Bild:
iris %>% ggvis(~Petal.Length, ~Petal.Width, fill = ~Species) %>% layer_points()
Hier deutet der Plot auf eine positive Korrelation zwischen Blütenblatt-Länge und -Breite für alle im Iris-Datensatz enthaltenen Arten hin. Um diese Hypothese abzusichern, kannst du weiter testen:
Kombiniert man alle drei Arten, ist die Korrelation etwas stärker als getrennt betrachtet: Insgesamt liegt sie bei 0,96, für Versicolor bei 0,79. Setosa und Virginica weisen – gerundet – Korrelationen von 0,31 bzw. 0,32 zwischen Blütenblatt-Länge und -Breite auf.
Tipp: Interessiert dich ggvis, Visualisierung oder speziell Histogramme? Sieh dir unser Histogramm-Tutorial und/oder den ggvis-Kurs an.
Nach der visuellen Übersicht kannst du dir den Datensatz auch direkt ausgeben lassen, indem du Folgendes eingibst:
Wie du an der Ausgabe siehst, ist das keine ideale Methode: Der Datensatz flutet die Konsole und erschwert den Überblick. Besser prüfst du ihn mit head(iris) oder str(iris).
Mit dem letzten Befehl siehst du klar den Datentyp num und die drei Ausprägungen des Attributs Species als Faktor. Das ist praktisch, denn viele ML-Klassifikatoren in R erwarten, dass das Zielmerkmal als Faktor kodiert ist.
Merke: Faktorvariablen repräsentieren kategoriale Merkmale in R und können nur eine begrenzte Zahl an Werten annehmen.
Ein schneller Blick auf Species zeigt eine 50-50-50-Verteilung. Willst du die prozentuale Verteilung sehen, lass dir eine Proportionstabelle ausgeben:
Hinweis: round rundet die Werte des ersten Arguments prop.table(table(iris$Species))*100 auf die angegebene Stellenzahl, hier eine Nachkommastelle. Passe das über digits an.
Bleib nicht beim High-Level-Überblick! R bietet dir mit summary() eine kompakte Statistik: Minimum, 1. Quartil, Median, Mittelwert, 3. Quartil und Maximum für numerische Spalten; für die Klassenvariable die Faktorhäufigkeiten:
Wie du siehst, wurde der Befehl um c() ergänzt: Die Spalten petal width und sepal width werden zusammengefasst, und es wird nur für diese beiden eine Zusammenfassung angefordert.
Nun, da du deine Daten gut verstehst, definierst du sinnvolle Use Cases. Was könnten dir die Daten beibringen, welche Erkenntnisse sind realistisch? Daraus leitest du ab, welche Algorithmen sich eignen, um die gewünschten Ergebnisse zu erzielen.
Tipp: Je besser du deine Daten kennst, desto leichter schätzt du passende Use Cases und wählst den geeigneten Algorithmus.
In diesem Tutorial nutzen wir Iris für eine Klassifikation, also ein Beispiel für Predictive Modeling. Das letzte Attribut Species ist die Zielvariable, die du vorhersagen willst.
Hinweis: Du kannst für eine Regression mit KNN auch eine der numerischen Spalten als Zielvariable wählen.
Viele ML-Algorithmen sind in R nicht standardmäßig enthalten. Du wirst in der Regel passende Pakete installieren müssen, bevor du loslegst.
Tipp: Du weißt, welchen Algorithmus du verwenden willst, aber nicht, welches Paket? Eine recht vollständige Übersicht der ML-Pakete in R findest du hier.
Für KNN nutzen wir in diesem Tutorial das Paket class:
Falls du es noch nicht installiert hast, geht das schnell mit:
install.packages("<package name>")Merke – Nerd-Tipp: Ob ein Paket installiert ist, prüfst du so:
any(grepl("<name of your package>", installed.packages()))Nach der Exploration und dem Setup geht es an die Modellierung. Vorher solltest du die Daten vorbereiten. Zwei wichtige Schritte: falls nötig normalisieren und in Trainings- und Testdaten aufteilen.
Als Teil der Vorbereitung kann es nötig sein, die Daten zu normalisieren, um sie konsistent zu machen. Für den Einstieg reicht: Normalisierung erleichtert KNN das Lernen. Es gibt zwei Arten:
Wann normalisieren?
Kurz: Wenn du vermutest, dass die Skalen nicht vergleichbar sind.
Das siehst du leicht in der Ausgabe von summary(). Schau dir die Min- und Max-Werte aller numerischen Attribute an. Hat ein Attribut einen deutlich größeren Wertebereich, dominiert es die Distanzberechnung – dann normalisieren.
Beispiel: Hast du nur X und Y, X reicht von 1 bis 1000, Y von 1 bis 100, dann überwiegt X in der Distanzfunktion.
Durch Normalisierung bringst du alle Merkmale in einen vergleichbaren Bereich, sodass Variablen mit großem Range die Distanz nicht übermäßig beeinflussen.
Tipp: Sieh dir summary(iris) an und prüfe, ob eine Normalisierung nötig ist.
Beim Iris-Datensatz ist sie nicht nötig: Sepal.Length liegt zwischen 4,3 und 7,9, Sepal.Width zwischen 2 und 4,4, Petal.Length zwischen 1 und 6,9 und Petal.Width zwischen 0,1 und 2,5. Alles bewegt sich grob zwischen 0,1 und 7,9 – akzeptabel.
Trotzdem lohnt es sich, Normalisierung und ihre Wirkung zu verstehen – besonders, wenn du neu im ML bist. Eine Feature-Normalisierung kannst du z. B. mit einer eigenen Funktion normalize() umsetzen.
Danach nutzt du sie in einem weiteren Befehl: lapply() wendet normalize auf jede Spalte an und liefert eine Liste, die du mit as.data.frame() in ein Dataframe verwandelst:
YourNormalizedDataSet <- as.data.frame(lapply(YourDataSet, normalize))Probier das im DataCamp-Light-Block unten aus!
Für Iris würdest du normalize auf die vier numerischen Attribute (Sepal.Length, Sepal.Width, Petal.Length, Petal.Width) anwenden und das Ergebnis in ein Dataframe schreiben.
Tipp: Vergleiche zur Veranschaulichung den Normalisierungs-Output mit der Zusammenfassung aus Schritt zwei.
Um die Modellleistung zu bewerten, teilst du den Datensatz in zwei Teile: Training und Test.
Mit dem ersten trainierst du das System, mit dem zweiten evaluierst du es. Üblich ist eine disjunkte Aufteilung, z. B. 2/3 Training und 1/3 Test.
Ein letzter Blick zeigt: Wenn du blind aufteilst, riskierst du, dass im Training nicht alle drei Arten vertreten sind, z. B. keine „Virginica“. Dann würde das Modell unbekannte Instanzen nur als „Setosa“ oder „Versicolor“ einstufen – ohne Kenntnis einer dritten Art.
Ergebnis: falsche Vorhersagen im Test.
Sorge also dafür, dass alle drei Klassen im Training vorkommen und in etwa gleich häufig sind, damit du keine Klasse bevorzugst.
Für die Aufteilung setzt du zuerst einen Seed – die Startzahl für R’s Zufallszahlengenerator. Vorteil: Mit demselben Seed erhältst du dieselbe Zufallsfolge und damit reproduzierbare Ergebnisse.
set.seed(1234)Dann mischst du den Datensatz und stellst sicher, dass Training und Test je Anteile aller Arten enthalten.
Mit sample() ziehst du eine Stichprobe in der Größe der Zeilenzahl (150). Du ziehst mit Zurücklegen aus einem Vektor mit zwei Elementen und weist jeder Zeile eine 1 oder 2 zu – mit den Wahrscheinlichkeiten 0,67 bzw. 0,33.
ind <- sample(2, nrow(iris), replace=TRUE, prob=c(0.67, 0.33))Hinweis: replace ist TRUE, d. h. nach jeder Ziehung wird der Ursprungsvektor wiederhergestellt. So kann für jede weitere Zeile erneut 1 oder 2 zugewiesen werden. Die Auswahlwahrscheinlichkeiten legst du über prob fest. Der Seed ist weiterhin auf 1234 gesetzt.
Merke: Da 2/3 Training und 1/3 Test vorgesehen sind, vergibst du 1 mit 0,67 und 2 mit 0,33 Wahrscheinlichkeit.
Mit der in ind gespeicherten Stichprobe definierst du dann Trainings- und Testdaten:
Hinweis: Neben der 2/3–1/3-Aufteilung nimmst du nicht alle Attribute in die Feature-Matrix auf. Konkret nutzt du Sepal.Length, Sepal.Width, Petal.Length und Petal.Width. Species ist die Zielvariable. Sie wird nicht als Feature genutzt, aber natürlich für die Bewertung benötigt.
Speichere daher die Klassenlabels als Faktorvektoren und teile sie ebenfalls in Training und Test auf:
Nach der Vorbereitung sind alle Trainingsdaten bereit – gelernt wurde bisher noch nicht. Jetzt suchst du die k nächsten Nachbarn für deine Testinstanzen.
Am einfachsten gelingt das mit knn(), das standardmäßig die euklidische Distanz nutzt, um die k nächsten Nachbarn zu einem neuen, unbekannten Punkt zu finden. k legst du selbst fest.
Wie erwähnt, erfolgt die Klassifikation per Mehrheits- oder gewichteter Abstimmung. Bei Klassifikation „gewinnt“ der Datenpunkt mit dem höchsten Score, und die unbekannte Instanz erhält dessen Label. Bei Stimmengleichheit wird zufällig entschieden.
Hinweis: k ist oft ungerade, um Tie-Breaks zu vermeiden.
Für den Classifier ergänzt du knn() um die nötigen Argumente, z. B. so:
In iris_pred speicherst du die Ausgabe von knn(), das Trainingsdaten, Testdaten, Trainingslabels und die gewünschte Zahl an Nachbarn entgegennimmt. Das Ergebnis ist ein Faktorvektor mit den vorhergesagten Klassen für jede Zeile der Testdaten.
Hinweis: Die Testlabels gibst du nicht mit – sie dienen zur Bewertung der Vorhersagen.
Beim Inspizieren von iris_pred siehst du die vorhergesagten Klassen für jede Testzeile.
Ein zentraler Schritt ist die Bewertung der Modellleistung. Du analysierst also, wie korrekt die Vorhersagen sind.
Für eine erste Einschätzung vergleichst du iris_pred einfach mit den zuvor definierten Testlabels:
Das Modell trifft recht genaue Vorhersagen, bis auf eine Fehlklassifikation in Zeile 29: „Versicolor“ statt „Virginica“.
Das ist ein erster Hinweis auf die Leistung. Für eine tiefergehende Analyse kannst du das Paket gmodels nutzen:
install.packages("package name")Falls bereits installiert, einfach laden:
library(gmodels)Anschließend erstellst du eine Kreuztabelle (Contingency Table), um die Beziehung zwischen den echten Klassen (iris.testLabels) und den Modellvorhersagen (iris_pred) zu untersuchen:
CrossTable(x = iris.testLabels, y = iris_pred, prop.chisq=FALSE)
Hinweis: Das Argument prop.chisq steuert, ob der Chi-Quadrat-Beitrag jeder Zelle ausgegeben wird. Die Summe dieser Beiträge ergibt die Chi-Quadrat-Statistik, mit der man prüft, ob die Differenz zwischen beobachteten und erwarteten Werten signifikant ist.
Aus der Tabelle liest du die Zahl richtiger und falscher Vorhersagen ab: Eine Testinstanz wurde als Versicolor vorhergesagt, war aber tatsächlich Virginica (erste Zeile der „Virginica“-Spalte bei iris.testLabels). In allen anderen Fällen lag das Modell richtig. Fazit: Die Leistung ist gut, eine Verbesserung ist nicht zwingend nötig!
caretDu hast KNN als Beispiel für überwachtes Lernen in R kennengelernt. Wie du gesehen hast, kann ML in R komplex werden: viele Algorithmen, unterschiedliche Syntax, etliche Parameter. Paketnamen und jeweilige Syntax zu merken, kann mühsam sein.
Hier hilft caret („Classification and Regression Training“): ein einheitliches Interface zu einer Vielzahl von ML-Algorithmen – ähnlich wie scikit-learn in Python.
Im Folgenden gehst du die gleichen Schritte wie oben, nutzt diesmal aber caret für die Klassifikation. Vieles hast du bereits erledigt: Daten verstehen, explorieren, Workspace vorbereiten. Jetzt geht’s ans Preprocessing mit caret!
Wie zuvor kannst du die Wirkung der Normalisierung untersuchen – später im Tutorial folgt ein Beispiel.
Als Nächstes teilst du die Daten in Training und Test auf. Diesmal gehst du etwas anders vor: Du splittest anhand der Labels in iris$Species. Außerdem nutzt du ein 75/25-Verhältnis.
Jetzt kannst du Modelle trainieren! caret umfasst sehr viele Algorithmen. Wenn du unsicher bist, welche verfügbar sind, liste sie mit names(getModelInfo()) auf. Wähle dann einen Algorithmus und trainiere mit train():
Andere Modelle zu trainieren ist jetzt simpel: Ändere nur das Argument method, z. B. so:
model_cart <- train(iris.training[, 1:4], iris.training[, 5], method='rpart2')Nachdem das Modell trainiert ist, sagst du die Labels des Testsets vorher und bewertest die Leistung:
Zudem kannst du – wie zuvor – testen, welchen Effekt Preprocessing wie Skalierung und Zentrierung hat. Führe dazu diesen Code aus:
Glückwunsch! Du hast das Tutorial erfolgreich abgeschlossen.
Im Fokus stand der grundlegende KNN-Algorithmus in R. Der verwendete Iris-Datensatz ist klein und überschaubar. Du hast gesehen, wie du jeden Schritt selbst durchführst, aber auch, wie dir eine einheitliche Schnittstelle wie caret die Arbeit erleichtert.
Und es geht noch viel mehr!
Wenn du mit den Grundlagen und weiteren ML-Algorithmen experimentiert hast, lohnt es sich, tiefer in R und Datenanalyse einzusteigen.
R-Kurse
Kurs
Kurs
Kurs