Cours
Introduction à R
4 h
3.1M
L’apprentissage automatique est un domaine de l’informatique qui étudie la conception d’algorithmes capables d’apprendre. Les tâches typiques incluent l’apprentissage de concepts, l’apprentissage de fonctions (ou « modélisation prédictive »), le clustering et la recherche de motifs prédictifs. Ces tâches s’appuient sur des données disponibles, observées via l’expérience ou l’instruction, par exemple. L’idée est que l’intégration de l’expérience améliore progressivement l’apprentissage. L’objectif ultime est d’automatiser suffisamment le processus pour qu’il n’exige plus d’intervention humaine.
Ce court tutoriel a pour but de vous initier aux fondamentaux de l’apprentissage automatique en R : plus précisément, il vous montrera comment utiliser R avec l’algorithme bien connu « KNN », ou k plus proches voisins.
Si vous souhaitez suivre un cours, jetez un œil à notre Introduction to Machine Learning with R ou au cours Unsupervised Learning in R de DataCamp !
L’algorithme KNN, ou des k plus proches voisins, est l’un des plus simples en apprentissage automatique. C’est un exemple d’apprentissage à base d’instances : de nouvelles données sont classées à partir d’exemples étiquetés et mémorisés.
Plus précisément, on calcule la distance entre les données stockées et la nouvelle instance au moyen d’une mesure de similarité. Cette similarité est généralement exprimée par une mesure de distance telle que la distance euclidienne, la similarité cosinus ou la distance de Manhattan.
Autrement dit, pour chaque nouveau point que vous soumettez au système, on évalue sa similarité avec les données déjà présentes.
Vous utilisez ensuite cette similarité pour effectuer de la modélisation prédictive. Celle-ci peut être : soit de la classification (attribuer une étiquette ou une classe à la nouvelle instance), soit de la régression (attribuer une valeur). Le choix entre classification et régression dépend bien sûr de la façon dont vous paramétrez votre modèle KNN.
L’algorithme des k plus proches voisins complète ce principe de base : une fois les distances entre le nouveau point et toutes les observations stockées calculées, on trie ces valeurs et on retient les k voisins les plus proches. Leurs étiquettes sont rassemblées, puis un vote majoritaire (ou pondéré) est utilisé pour la classification ou la régression.
En d’autres termes, plus un point stocké obtient un score élevé, plus la nouvelle instance a de chances de recevoir la même classe que ce voisin. En régression, la valeur attribuée au nouveau point est la moyenne de ses k plus proches voisins.
L’apprentissage automatique commence généralement par des données observées. Vous pouvez utiliser votre propre jeu de données ou parcourir d’autres sources pour en trouver un.
Ce tutoriel utilise le jeu de données Iris, très connu en apprentissage automatique. Il est intégré à R ; vous pouvez l’inspecter en tapant ceci dans votre console :
Si vous préférez télécharger le jeu de données plutôt que d’utiliser celui intégré à R, rendez-vous sur le UC Irvine Machine Learning Repository et recherchez « Iris ».
Astuce : ne vous contentez pas du dossier « data » d’Iris ; consultez aussi la page de description du jeu de données !
Ensuite, utilisez la commande suivante pour charger les données :
Cette commande lit le fichier .csv (« Comma Separated Values ») depuis le site. L’argument header est fixé à FALSE, ce qui signifie que, dans cette source, Iris ne fournit pas de noms d’attributs.
À la place, lorsque vous inspectez l’objet iris avec une fonction comme head(), vous pouvez voir des noms de colonnes du type « V1 », « V2 », etc. Ceux-ci sont affectés automatiquement.
Pour faciliter le travail, il est judicieux de nommer vous‑même les colonnes : utilisez la fonction names(), qui récupère ou définit les noms d’un objet. Concaténez les noms d’attributs tels que vous souhaitez les voir apparaître. Dans l’exemple de code ci‑dessus, vous avez listé Sepal.Length, Sepal.Width, Petal.Length, Petal.Width et Species.
Encore une fois, ces noms ne sortent pas de nulle part : consultez la description du jeu de données liée ci‑dessus ; vous y trouverez normalement tous ces noms.
Maintenant que vous avez chargé Iris dans RStudio, il est temps de comprendre en profondeur ce que contiennent vos données. Se contenter de regarder ou lire à leur sujet n’est pas suffisant pour démarrer !
Mettez les mains dans le cambouis : explorez, visualisez, et si nécessaire, complétez votre connaissance métier si les données vous semblent obscures.
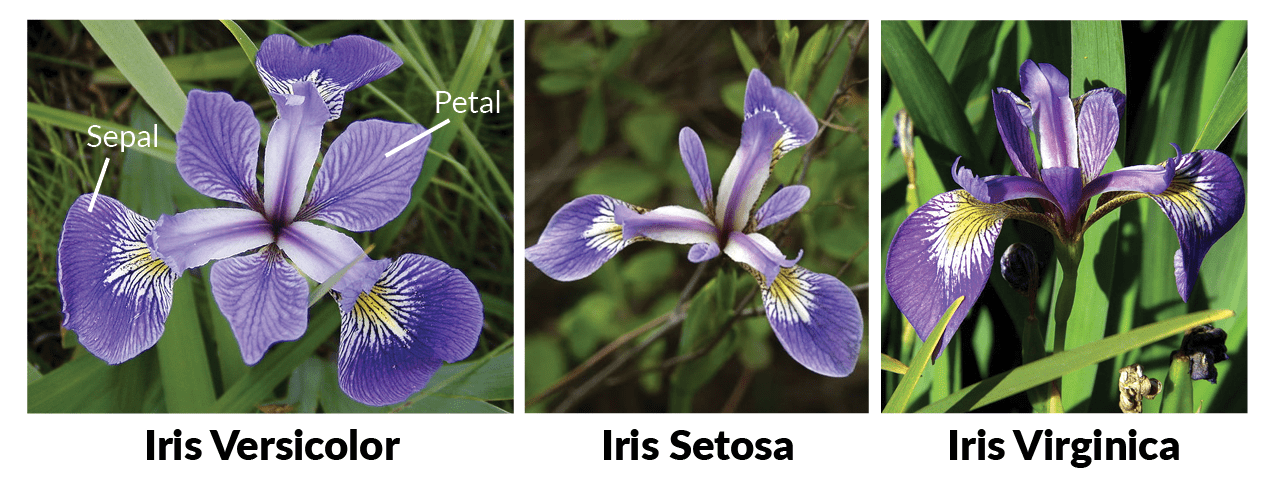
Vous avez probablement déjà la connaissance métier utile, mais pour mémoire, toutes les fleurs ont un sépale et un pétale. Le sépale entoure les pétales et est généralement vert et foliacé, tandis que les pétales sont des feuilles colorées. Pour les iris, c’est un peu différent, comme le montre l’illustration suivante :
Commencez par vous faire une idée via quelques graphiques, tels que des histogrammes ou des boîtes à moustaches. Ici, des nuages de points sont particulièrement parlants : il est intéressant de voir dans quelle mesure une variable influence une autre.
Autrement dit, vous cherchez à détecter une éventuelle corrélation entre deux variables.
Vous pouvez tracer des nuages de points avec le package ggvis, par exemple.
Remarque : commencez par charger le package ggvis :
# Load in `ggvis`
library(ggvis)

# Iris scatter plot
iris %>% ggvis(~Sepal.Length, ~Sepal.Width, fill = ~Species) %>% layer_points()
On observe une forte corrélation entre la longueur et la largeur du sépale pour la variété Setosa, alors qu’elle est un peu moins marquée pour Virginica et Versicolor : les points sont plus dispersés et ne forment pas un amas compact comme chez Setosa.
Le nuage de points qui met en regard la longueur et la largeur des pétales raconte une histoire similaire :
iris %>% ggvis(~Petal.Length, ~Petal.Width, fill = ~Species) %>% layer_points()
Ce graphique indique une corrélation positive entre la longueur et la largeur des pétales pour toutes les espèces présentes dans Iris. Bien sûr, pour en avoir le cœur net, vous pouvez tester davantage cette hypothèse :
Vous constatez qu’en combinant les trois espèces, la corrélation est un peu plus forte que lorsqu’on les considère séparément : la corrélation globale est de 0,96, tandis que pour Versicolor elle est de 0,79. Setosa et Virginica affichent des corrélations de 0,31 et 0,32 respectivement (après arrondi) entre longueur et largeur des pétales.
Astuce : curieux de ggvis, des graphiques ou des histogrammes en particulier ? Consultez notre tutoriel histogrammes et/ou le cours ggvis.
Après cet aperçu visuel général, vous pouvez aussi afficher les données en tapant
Vous verrez toutefois que ce n’est pas la meilleure manière d’inspecter vos données : l’ensemble occupe trop d’espace dans la console, ce qui gêne la compréhension. Il est préférable d’utiliser head(iris) ou str(iris).
Notez que la dernière commande vous aide à distinguer clairement le type num et les trois modalités de l’attribut Species, qui est un facteur. Pratique, car de nombreux classifieurs R exigent que la variable cible soit de type facteur.
Rappelez‑vous : les facteurs représentent des variables catégorielles en R. Ils ne prennent qu’un nombre limité de valeurs.
Un rapide coup d’œil à Species montre une répartition 50‑50‑50 des espèces. Pour vérifier la répartition en pourcentage, demandez un tableau de proportions :
Remarque : round arrondit les valeurs du premier argument, prop.table(table(iris$Species))*100, au nombre de décimales indiqué, ici une décimale. Adaptez‑le via l’argument digits.
Ne restez pas sur une vue trop macro ! R vous permet d’aller plus loin avec la fonction summary(). Pour les variables numériques, elle renvoie minimum, premier quartile, médiane, moyenne, troisième quartile et maximum. Pour la variable de classe, elle renvoie le nombre d’occurrences de chaque modalité :
Comme vous le voyez, la fonction c() est ajoutée à la commande : on concatène les colonnes petal width et sepal width, puis on demande un résumé sur ces deux colonnes du jeu Iris.
Une fois vos données bien comprises, identifiez des cas d’usage pertinents. En d’autres termes, déterminez ce que vous pouvez apprendre de vos données et quels résultats vous souhaitez obtenir. À partir de là, choisissez les algorithmes adaptés pour y parvenir.
Astuce : plus vous connaissez vos données, plus il sera facile de définir des cas d’usage pertinents et de sélectionner l’algorithme adéquat.
Dans ce tutoriel, Iris sera utilisé pour de la classification, un cas de modélisation prédictive. Le dernier attribut, Species, sera la variable cible, c’est‑à‑dire celle que vous souhaitez prédire.
Remarque : vous pouvez aussi choisir une variable numérique comme cible si vous souhaitez utiliser KNN en régression.
Beaucoup d’algorithmes d’apprentissage automatique ne sont pas inclus par défaut dans R. Vous devrez probablement installer les packages nécessaires avant de vous lancer.
Astuce : vous avez une idée de l’algorithme à utiliser, mais pas du package ? Retrouvez une vue d’ensemble assez complète des packages R dédiés ici.
Pour illustrer KNN, ce tutoriel utilise le package class :
Si vous ne l’avez pas encore, installez‑le simplement avec :
install.packages("<package name>")Mémo geek : si vous n’êtes pas sûr de l’avoir, exécutez la commande suivante pour vérifier !
any(grepl("<name of your package>", installed.packages()))Après l’exploration des données et la préparation de l’environnement, revenons à l’objectif : construire un modèle d’apprentissage automatique. Avant cela, préparez aussi les données. Deux étapes sont détaillées ci‑dessous : normaliser (si nécessaire) et scinder en ensembles d’entraînement et de test.
Dans votre préparation, il peut être nécessaire de normaliser les données pour les rendre cohérentes. Pour cette introduction, retenez que la normalisation facilite l’apprentissage de KNN. Il existe deux types de normalisation :
Quand faut‑il normaliser ?
En bref : lorsque vous suspectez une incohérence d’échelle.
Repérez‑la dans les résultats de summary(). Comparez les min/max des attributs numériques. Si l’un d’eux présente une plage très large, normalisez, sinon la distance sera dominée par cette variable.
Exemple : si votre jeu n’a que deux attributs, X et Y, avec X variant de 1 à 1000 et Y de 1 à 100, l’influence de Y sur la distance sera généralement écrasée par celle de X.
La normalisation ajuste l’échelle des variables, afin que les distances ne surpondèrent pas les variables à grande amplitude.
Astuce : revenez au résultat de summary(iris) pour juger si une normalisation s’impose.
Le jeu Iris n’a pas besoin d’être normalisé : Sepal.Length va de 4,3 à 7,9 ; Sepal.Width de 2 à 4,4 ; Petal.Length de 1 à 6,9 ; Petal.Width de 0,1 à 2,5. Toutes les valeurs sont comprises entre 0,1 et 7,9 ; c’est acceptable.
Il reste néanmoins utile d’étudier la normalisation et ses effets, surtout si vous débutez. Vous pouvez, par exemple, réaliser une normalisation par variable en commençant par écrire votre propre fonction normalize().
Vous pourrez ensuite l’appliquer et stocker les résultats dans un data frame via as.data.frame() après que lapply() a renvoyé une liste de même longueur que votre jeu d’entrée. Chaque élément de cette liste est le résultat de l’application de la fonction normalize au jeu fourni :
YourNormalizedDataSet <- as.data.frame(lapply(YourDataSet, normalize))Testez‑le dans le bloc DataCamp Light ci‑dessous !
Avec Iris, vous auriez appliqué normalize aux quatre attributs numériques (Sepal.Length, Sepal.Width, Petal.Length, Petal.Width) et placé les résultats dans un data frame.
Astuce : pour illustrer l’effet de la normalisation, comparez le résultat obtenu avec le résumé d’Iris donné à l’étape 2.
Pour évaluer la performance du modèle, divisez le jeu de données en deux : un ensemble d’entraînement et un ensemble de test.
Le premier sert à entraîner le système, le second à l’évaluer. En pratique, on choisit souvent une division disjointe 2/3 pour l’entraînement et 1/3 pour le test.
Un dernier coup d’œil au jeu montre que si vous scindiez tel quel, vous pourriez obtenir un ensemble d’entraînement avec seulement des espèces « Setosa » et « Versicolor », mais aucune « Virginica ». Le modèle classerait alors toutes les instances inconnues en « Setosa » ou « Versicolor », ignorant la troisième espèce.
En bref, vous obtiendriez des prédictions erronées sur le test.
Vous devez donc vous assurer que les trois classes sont présentes dans l’ensemble d’entraînement et, autant que possible, en proportions équilibrées pour éviter de favoriser une classe.
Pour créer vos ensembles, commencez par fixer une graine aléatoire, c’est‑à‑dire la valeur du générateur de nombres aléatoires de R. L’avantage : avec la même graine, vous obtenez la même séquence de nombres à chaque exécution.
set.seed(1234)Ensuite, mélangez le jeu Iris et assurez‑vous d’avoir des proportions équivalentes d’espèces dans l’entraînement et le test.
Utilisez sample() pour tirer un échantillon de taille égale au nombre de lignes d’Iris, soit 150. Vous échantillonnez avec remise : à partir d’un vecteur de 2 éléments, vous assignez 1 ou 2 aux 150 lignes, avec des probabilités 0,67 et 0,33.
ind <- sample(2, nrow(iris), replace=TRUE, prob=c(0.67, 0.33))Remarque : l’argument replace est à TRUE : après chaque tirage (1 ou 2), le vecteur est réinitialisé. La probabilité d’obtenir 1 ou 2 à chaque ligne est donc fixée par les poids spécifiés. Notez aussi que, même si cela n’apparaît pas dans le bloc, la graine reste 1234.
Rappel : l’ensemble d’entraînement doit représenter 2/3 du total ; c’est pourquoi vous assignez « 1 » avec une probabilité de 0,67 et « 2 » avec 0,33.
Vous pouvez ensuite utiliser l’échantillon stocké dans ind pour définir vos ensembles d’entraînement et de test :
Remarque : en plus des proportions 2/3–1/3, vous n’utilisez pas tous les attributs pour former les ensembles. Vous ne prenez que Sepal.Length, Sepal.Width, Petal.Length et Petal.Width. En effet, vous souhaitez prédire le cinquième attribut, Species : c’est votre cible. Vous l’inclurez bien sûr dans KNN pour permettre la prédiction.
Stockez donc les étiquettes de classe dans des vecteurs facteurs et répartissez‑les sur entraînement et test :
Après la préparation, toutes vos données d’entraînement sont prêtes. Aucun apprentissage n’a encore été réalisé. Vous allez maintenant rechercher les k plus proches voisins pour votre ensemble d’entraînement.
Une façon simple d’effectuer ces deux étapes est d’utiliser la fonction knn(), qui exploite la distance euclidienne pour trouver les k plus proches voisins d’une nouvelle instance inconnue. Le paramètre k est à définir par vous‑même.
Comme indiqué plus haut, les nouvelles instances sont classées via un vote majoritaire ou pondéré. En classification, le point ayant le score le plus élevé « l’emporte » et l’instance inconnue reçoit son étiquette. En cas d’égalité, la classification est aléatoire.
Remarque : on choisit souvent un k impair pour éviter les ex æquo.
Pour construire votre classifieur, utilisez knn() avec les bons arguments, comme dans cet exemple :
Vous stockez dans iris_pred l’appel à knn() qui prend en arguments l’ensemble d’entraînement, l’ensemble de test, les étiquettes d’entraînement et le nombre de voisins k. Le résultat est un vecteur facteur avec la classe prédite pour chaque ligne du test.
Remarque : n’indiquez pas les étiquettes du test ; elles serviront à évaluer la qualité de vos prédictions.
En inspectant iris_pred, vous retrouvez bien les classes prédites pour chaque ligne du test.
Évaluer la performance est essentiel. En d’autres termes, vous mesurez la justesse des prédictions du modèle.
Pour une première vue, comparez les résultats de iris_pred aux étiquettes de test définies plus tôt :
Le modèle fournit des prédictions globalement correctes, à l’exception d’une mauvaise classification à la ligne 29, où « Versicolor » est prédit alors que l’étiquette réelle est « Virginica ».
Cela donne déjà une indication de performance, mais vous pouvez aller plus loin. Pour cela, importez le package gmodels :
install.packages("package name")Si le package est déjà installé, exécutez simplement
library(gmodels)Puis créez un tableau croisé (contingence) pour analyser la relation entre deux variables. Ici, vous souhaitez comprendre comment les classes de votre test, stockées dans iris.testLabels, se comparent aux prédictions de iris_pred :
CrossTable(x = iris.testLabels, y = iris_pred, prop.chisq=FALSE)
Remarque : l’argument prop.chisq indique si la contribution au chi‑deux de chaque cellule est incluse. La statistique du chi‑deux, somme des contributions cellule par cellule, permet de juger si l’écart entre valeurs observées et attendues est significatif.
À partir de ce tableau, vous déduisez le nombre de prédictions correctes et incorrectes : une instance de l’ensemble de test a été étiquetée Versicolor par le modèle alors qu’il s’agissait d’une fleur Virginica. Vous le voyez dans la première ligne de l’espèce « Virginica » dans la colonne iris.testLabels. Dans tous les autres cas, les prédictions sont correctes. Vous pouvez conclure que la performance du modèle est satisfaisante et qu’il n’est pas nécessaire de l’améliorer !
caretDans les sections précédentes, vous avez abordé l’apprentissage supervisé en R via KNN. Comme vous avez pu le deviner, le machine learning en R peut vite se complexifier : multiples algorithmes, syntaxes et paramètres… Se souvenir de chaque package pour chaque algorithme peut devenir difficile, et appliquer la syntaxe propre à chacun l’est tout autant.
C’est là que le package caret est utile : « Classification and Regression Training », il fournit une interface unifiée couvrant une multitude d’algorithmes pour résoudre vos problèmes d’apprentissage supervisé. Si vous connaissez un peu le machine learning en Python, vous y verrez des similitudes avec scikit-learn !
Nous allons reprendre les étapes vues ci‑dessus, mais cette fois avec caret pour classifier les données. Si vous avez suivi jusqu’ici, vous avez déjà bien avancé : compréhension des données, exploration, préparation de l’environnement, etc. Passons maintenant au prétraitement avec caret !
Comme précédemment, vous pourrez étudier l’effet de la normalisation ; cela viendra un peu plus loin.
Vous connaissez la suite ! Scindons les données en entraînement et test. Cette fois, on procède légèrement différemment : on sépare en fonction des étiquettes iris$Species, et on adopte un ratio 75–25.
Vous êtes prêt à entraîner des modèles ! Mais souvenez‑vous : caret est un projet très vaste couvrant un grand nombre d’algorithmes. En cas de doute, listez‑les avec names(getModelInfo()), comme ci‑dessous. Choisissez ensuite un algorithme et entraînez un modèle avec train() :
Créer d’autres modèles devient alors trivial : changez simplement l’argument method, comme ici :
model_cart <- train(iris.training[, 1:4], iris.training[, 5], method='rpart2')Une fois le modèle entraîné, prédisez les étiquettes de l’ensemble de test et évaluez ses performances :
Vous pouvez également reproduire le test précédent pour mesurer l’effet du prétraitement (centrage et mise à l’échelle) sur votre modèle. Exécutez le bloc suivant :
Félicitations ! Vous êtes arrivé au bout de ce tutoriel !
Nous nous sommes concentrés sur la mise en œuvre de KNN en R. Le jeu de données Iris étant petit et facile à explorer, vous avez vu comment enchaîner les étapes manuellement, puis comment accélérer avec une interface unifiée comme celle de caret.
Mais vous pouvez aller bien plus loin !
Après avoir expérimenté les bases présentées ici et d’autres algorithmes, vous aurez sans doute envie d’approfondir R et l’analyse de données.
Cours R
Cours
Cours
Cours