Curso
Introdução ao R
4 h
3.1M
Machine learning é uma área da ciência da computação que estuda o design de algoritmos capazes de aprender. Tarefas típicas incluem aprendizado de conceitos, aprendizado de funções ou “modelagem preditiva”, clustering e descoberta de padrões preditivos. Esses aprendizados acontecem a partir de dados disponíveis, observados por experiências ou instruções, por exemplo. A ideia é que, ao incorporar experiência às tarefas, o aprendizado melhore com o tempo. O objetivo final é tornar esse aprendizado automático, de modo que pessoas como nós não precisem mais interferir.
Este tutorial rápido apresenta os fundamentos de machine learning em R: mais especificamente, mostra como usar R para trabalhar com o conhecido algoritmo “KNN”, ou k-vizinhos mais próximos.
Se você quer seguir um curso, confira nossa Introduction to Machine Learning with R ou o curso de Unsupervised Learning in R da DataCamp!
O algoritmo KNN, ou k-vizinhos mais próximos, é um dos mais simples em machine learning e é um exemplo de aprendizado baseado em instâncias, em que novos dados são classificados com base em exemplos rotulados armazenados.
Mais especificamente, calcula-se a distância entre os dados armazenados e a nova instância por meio de alguma medida de similaridade. Normalmente, essa similaridade é expressa por uma medida de distância, como a distância euclidiana, a similaridade do cosseno ou a distância de Manhattan.
Em outras palavras, para cada novo ponto de dados que você coloca no sistema, calcula-se a semelhança com os dados que já estavam lá.
Depois, você usa esse valor de similaridade para fazer modelagem preditiva. A modelagem preditiva pode ser classificação, atribuindo um rótulo ou classe à nova instância, ou regressão, atribuindo um valor à nova instância. Se você vai classificar ou prever um valor depende de como você constrói seu modelo com KNN.
O algoritmo de k-vizinhos mais próximos acrescenta a isso que, após calcular a distância do novo ponto para todos os pontos armazenados, os valores são ordenados e os k vizinhos mais próximos são determinados. Reúnem-se os rótulos desses vizinhos e usa-se uma votação por maioria ou ponderada para fins de classificação ou regressão.
Em outras palavras, quanto maior a pontuação de um ponto de dados já armazenado, maior a chance de a nova instância receber a mesma classificação do vizinho. No caso de regressão, o valor atribuído ao novo ponto é a média de seus k vizinhos mais próximos.
Machine learning geralmente começa a partir de dados observados. Você pode usar seu próprio conjunto de dados ou buscar em outras fontes para encontrar um.
Este tutorial usa o conjunto Iris, muito conhecido em machine learning. Esse dataset já vem no R, então você pode inspecioná-lo digitando o seguinte no console:
Se preferir baixar o conjunto de dados em vez de usar o que já vem no R, acesse o UC Irvine Machine Learning Repository e procure pelo conjunto Iris.
Dica: não veja só a pasta de dados do conjunto Iris — dê uma olhada também na página de descrição!
Depois, use o comando abaixo para carregar os dados:
Esse comando lê o arquivo .csv (Comma Separated Value) do site. O argumento header foi definido como FALSE, indicando que a fonte do Iris não traz os nomes das colunas.
Em vez dos nomes de atributos, você pode ver nomes estranhos como “V1” ou “V2” ao inspecionar o objeto iris com uma função como head(). Eles são atribuídos automaticamente.
Para facilitar o trabalho, vale a pena definir você mesmo os nomes das colunas com a função names(), que obtém ou define os nomes de um objeto. Concatene os nomes dos atributos como gostaria que aparecessem. No trecho acima, você listou Sepal.Length, Sepal.Width, Petal.Length, Petal.Width e Species.
Esses nomes não surgem do nada: confira a descrição do conjunto de dados no link acima; normalmente, todos eles aparecem ali.
Agora que você carregou o conjunto Iris no RStudio, é hora de entender de verdade do que seus dados tratam. Só olhar ou ler sobre eles não basta para começar!
Coloque a mão na massa: explore e visualize o dataset e aprofunde o conhecimento de domínio, se achar que os dados estão além do seu alcance.
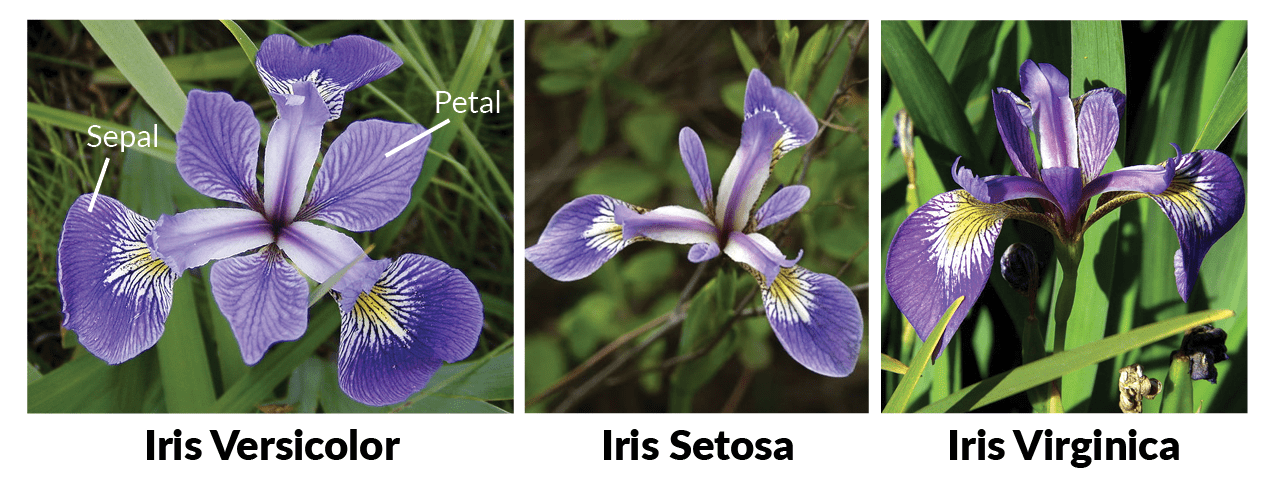
Provavelmente você já tem o conhecimento de domínio necessário, mas vale lembrar: toda flor tem sépalas e pétalas. As sépalas envolvem as pétalas e costumam ser verdes e parecer folhas, enquanto as pétalas são as “folhas” coloridas. No caso das íris, isso é um pouco diferente, como você vê na imagem a seguir:
Para começar, você pode ter uma ideia dos dados criando alguns gráficos, como histogramas ou boxplots. Neste caso, porém, gráficos de dispersão ajudam muito: é interessante ver quanto uma variável é afetada por outra.
Em outras palavras, você quer ver se há correlação entre duas variáveis.
Você pode fazer scatterplots com o ggvis package, por exemplo.
Observação: primeiro, carregue o pacote ggvis:
# Load in `ggvis`
library(ggvis)

# Iris scatter plot
iris %>% ggvis(~Sepal.Length, ~Sepal.Width, fill = ~Species) %>% layer_points()
Você vê uma alta correlação entre o comprimento e a largura das sépalas das flores Setosa, enquanto a correlação é um pouco menor para Virginica e Versicolor: os pontos ficam mais espalhados e não formam um aglomerado como no caso das Setosa.
O gráfico que cruza comprimento e largura das pétalas conta uma história parecida:
iris %>% ggvis(~Petal.Length, ~Petal.Width, fill = ~Species) %>% layer_points()
Este gráfico indica uma correlação positiva entre comprimento e largura das pétalas para todas as espécies do conjunto Iris. Claro que você deve testar essa hipótese mais a fundo para ter certeza:
Quando você combina as três espécies, a correlação fica um pouco mais forte do que ao olhar separadamente: a correlação geral é 0,96, enquanto para Versicolor é 0,79. Já Setosa e Virginica têm correlações entre comprimento e largura das pétalas de 0,31 e 0,32 (arredondando).
Dica: ficou curioso sobre ggvis, gráficos ou histogramas? Veja nosso tutorial de histograma e/ou o curso de ggvis.
Após uma visão geral visual dos dados, você também pode ver o dataset digitando
Mas, como verá pelo resultado, esse não é o melhor jeito de inspecionar os dados a fundo: o dataset ocupa muito espaço no console e dificulta a análise. É melhor usar head(iris) ou str(iris).
Note que o último comando ajuda a distinguir claramente o tipo num e os três níveis do atributo Species, que é um fator. Isso é útil, já que muitos classificadores de machine learning em R exigem que a variável alvo seja um fator.
Lembre-se: variáveis fator representam variáveis categóricas no R, com número limitado de valores possíveis.
Um olhar rápido para o atributo Species mostra que a divisão das espécies é 50-50-50. Já para ver a divisão percentual, você pode solicitar uma tabela de proporções:
Observação: o round arredonda os valores do primeiro argumento, prop.table(table(iris$Species))*100, para o número de casas definido em digits, aqui 1. Ajuste como preferir.
Não fique só na visão de alto nível! O R permite ir mais fundo com a função summary(). Ela retorna mínimo, 1º quartil, mediana, média, 3º quartil e máximo para os tipos numéricos do Iris. Para a variável de classe, retorna a contagem dos fatores:
Como você vê, a função c() foi adicionada ao comando original: as colunas petal width e sepal width foram concatenadas e foi pedido um resumo só dessas duas colunas do Iris.
Depois de entender bem seus dados, decida quais casos de uso fazem sentido para o seu conjunto. Em outras palavras, pense no que ele pode te ensinar ou no que você pode aprender com ele. A partir daí, defina que tipo de algoritmo aplicar para chegar aos resultados desejados.
Dica: quanto mais familiar você estiver com seus dados, mais fácil será definir casos de uso e escolher o algoritmo adequado.
Neste tutorial, o conjunto Iris será usado para classificação, um exemplo de modelagem preditiva. O último atributo, Species, será a variável alvo — aquela que você quer prever.
Observação: você também pode escolher uma das variáveis numéricas como alvo se quiser usar KNN para regressão.
Muitos algoritmos usados em machine learning não vêm por padrão no R. É bem provável que você precise baixar os pacotes que quer usar ao começar.
Dica: já sabe qual algoritmo usar, mas não qual pacote precisa? Encontre um panorama bem completo dos pacotes de R usados em ML neste link.
Para ilustrar o KNN, este tutorial usa o pacote class:
Se você ainda não tem esse pacote, instale rapidamente com a linha abaixo:
install.packages("<package name>")Lembrete nerd: se não tem certeza se o pacote está instalado, use o comando abaixo para conferir!
any(grepl("<name of your package>", installed.packages()))Depois de explorar os dados e preparar o ambiente, foque na tarefa: construir um modelo de machine learning. Antes, porém, é importante preparar os dados. A seguir, duas formas de fazer isso: normalizando os dados (se necessário) e dividindo em conjuntos de treino e teste.
Na preparação, pode ser preciso normalizar os dados para que fiquem consistentes. Para este tutorial introdutório, lembre-se: a normalização facilita o aprendizado do KNN. Existem dois tipos:
Quando normalizar o dataset?
Resumindo: quando você suspeitar que os dados não são consistentes.
Isso aparece facilmente no resultado do summary(). Observe mínimos e máximos de todos os atributos numéricos. Se um atributo tiver uma faixa de valores muito maior que os demais, normalize — do contrário, a distância será dominada por esse atributo.
Por exemplo, se seu dataset tem apenas X e Y, e X varia de 1 a 1000, enquanto Y vai de 1 a 100, a influência de Y na função de distância tende a ser abafada por X.
Ao normalizar, você ajusta a faixa de todos os atributos, evitando que variáveis com amplitudes maiores dominem as distâncias.
Dica: volte ao resultado de summary(iris) e veja se a normalização é necessária.
O conjunto Iris não precisa de normalização: Sepal.Length varia de 4,3 a 7,9; Sepal.Width, de 2 a 4,4; Petal.Length, de 1 a 6,9; e Petal.Width, de 0,1 a 2,5. Todos os valores ficam entre 0,1 e 7,9 — aceitável.
Mesmo assim, vale estudar a normalização e seu efeito, especialmente se você está começando. Você pode fazer normalização por atributo criando sua própria função normalize().
Depois, use esse argumento em outro comando: a função lapply() retorna uma lista do mesmo tamanho do dataset de entrada, e você coloca os resultados numa data frame com as.data.frame(). Cada elemento dessa lista é o resultado da aplicação de normalize ao dataset de entrada:
YourNormalizedDataSet <- as.data.frame(lapply(YourDataSet, normalize))Teste isso no bloco do DataCamp Light abaixo!
No Iris, você aplicaria normalize aos quatro atributos numéricos (Sepal.Length, Sepal.Width, Petal.Length, Petal.Width) e colocaria o resultado em um data frame.
Dica: para ilustrar o efeito da normalização, compare o resultado abaixo com o summary do passo 2.
Para avaliar o desempenho do modelo depois, divida o dataset em duas partes: treino e teste.
O primeiro treina o sistema; o segundo avalia o que foi aprendido. Na prática, a divisão costuma ser disjunta: a opção mais comum é usar 2/3 dos dados originais para treino e 1/3 para teste.
Um último olhar no dataset mostra que, se você dividisse como está, teria uma classe de treino com Setosa e Versicolor, mas sem Virginica. O modelo então classificaria todas as instâncias desconhecidas como “Setosa” ou “Versicolor”, por não conhecer a terceira espécie.
Resumindo: isso geraria previsões incorretas no conjunto de teste.
Você precisa garantir que as três classes estejam presentes no treino. E mais: a quantidade de instâncias de cada espécie deve ser mais ou menos igual, para não favorecer uma classe nas previsões.
Para montar treino e teste, primeiro defina uma semente. É o número do gerador de aleatoriedade do R. A grande vantagem é poder obter a mesma sequência de números aleatórios sempre que fornecer a mesma semente.
set.seed(1234)Em seguida, garanta que o Iris esteja embaralhado e que haja quantidade equilibrada de cada espécie nos conjuntos.
Use sample() para tirar uma amostra com tamanho igual ao número de linhas do Iris (150). A amostra é com reposição: escolhe-se de um vetor de 2 elementos e atribui-se 1 ou 2 às 150 linhas. A atribuição segue pesos de probabilidade 0,67 e 0,33.
ind <- sample(2, nrow(iris), replace=TRUE, prob=c(0.67, 0.33))Observação: o argumento replace está como TRUE: você atribui 1 ou 2 a uma linha e reinicia o vetor de 2 para o estado original. Assim, para as próximas linhas, você pode novamente atribuir 1 ou 2. A probabilidade de escolher 1 ou 2 segue os pesos especificados. E, mesmo que o bloco não mostre, a semente continua definida como 1234.
Lembre-se: você quer 2/3 de treino — por isso, atribui “1” com probabilidade 0,67 e “2” com 0,33 às 150 linhas.
Use então a amostra em ind para definir treino e teste:
Observação: além das proporções 2/3 e 1/3, você não usa todos os atributos para formar treino e teste. Especificamente, usa apenas Sepal.Length, Sepal.Width, Petal.Length e Petal.Width. Isso porque você quer prever o quinto atributo, Species — sua variável alvo. No entanto, você vai incluí-lo no KNN para que haja previsão para ele.
Portanto, armazene os rótulos de classe em vetores fator e divida-os entre treino e teste:
Depois de toda a preparação, você garantiu que todos os dados (de treino) conhecidos estão armazenados. Até aqui, nenhum modelo/treinamento foi feito. Agora, você quer encontrar os k vizinhos mais próximos do seu conjunto de treino.
Uma forma simples é usar a função knn(), que usa distância euclidiana para encontrar os k vizinhos mais próximos da nova instância desconhecida. Aqui, o parâmetro k é definido por você.
Como dito, novas instâncias são classificadas por maioria simples ou ponderada. Em classificação, o ponto com maior pontuação “vence” e a instância recebe seu rótulo. Em caso de empate, a classificação é aleatória.
Observação: o k costuma ser ímpar para evitar empates.
Para construir o classificador, use knn() e adicione os argumentos, como no exemplo:
Você armazena em iris_pred a chamada a knn() com os argumentos: conjunto de treino, conjunto de teste, rótulos de treino e o número de vizinhos desejado. O resultado é um vetor fator com as classes previstas para cada linha do teste.
Observação: não inclua os rótulos do teste — eles servem para verificar se o modelo está prevendo corretamente!
Ao inspecionar iris_pred, você verá o vetor fator com as classes previstas para cada linha do conjunto de teste.
Uma etapa essencial em machine learning é avaliar o desempenho do modelo, isto é, analisar o quão corretas são as previsões.
De forma mais abstrata, compare os resultados de iris_pred com os rótulos de teste definidos anteriormente:
Você vê que o modelo acerta bem, com exceção de uma classificação errada na linha 29, em que “Versicolor” foi previsto enquanto o rótulo real era “Virginica”.
Isso já indica algo sobre o desempenho, mas você pode ir mais fundo. Para isso, importe o pacote gmodels:
install.packages("package name")Se já o tiver instalado, basta rodar
library(gmodels)Agora crie uma tabela cruzada (contingência). Esse tipo de tabela ajuda a entender a relação entre duas variáveis. Neste caso, você quer entender como as classes do seu teste, em iris.testLabels, se relacionam com o modelo armazenado em iris_pred:
CrossTable(x = iris.testLabels, y = iris_pred, prop.chisq=FALSE)
Observação: o último argumento, prop.chisq, indica se a contribuição do qui-quadrado de cada célula é incluída. A estatística do qui-quadrado é a soma das contribuições das células e serve para decidir se a diferença entre observados e esperados é significativa.
Da tabela, você obtém o número de acertos e erros: uma instância do conjunto de teste foi rotulada como Versicolor pelo modelo, embora fosse Virginica. Isso aparece na primeira linha da espécie “Virginica” na coluna iris.testLabels. Nos demais casos, as previsões foram corretas. Conclusão: o desempenho do modelo é bom o suficiente e você não precisa melhorá-lo!
caretNas seções anteriores, você começou com aprendizado supervisionado em R via KNN. Como deve ter notado, machine learning em R pode ficar complexo: diversos algoritmos, sintaxes diferentes, parâmetros etc. Talvez você concorde que lembrar o nome do pacote para cada algoritmo é difícil, e aplicar a sintaxe específica de cada um pode ser demais.
É aí que o pacote caret ajuda: é a sigla de “Classification and Regression Training” e reúne o que você precisa para resolver problemas de aprendizado supervisionado, oferecendo uma interface uniforme para uma porção de algoritmos. Se você conhece machine learning em Python, vai notar semelhanças com o scikit-learn!
A seguir, vamos repetir os passos acima, mas usando o caret para classificar os dados. Note que, se você seguiu os passos anteriores, já fez boa parte do trabalho: entendeu seus dados, explorou, preparou o ambiente etc. Agora é hora de pré-processar com o caret!
Como antes, você pode estudar o efeito da normalização — veremos isso mais adiante.
Você já sabe o próximo passo! Vamos dividir os dados em treino e teste. Aqui, fazemos diferente: a divisão é baseada nos rótulos em iris$Species. Além disso, a proporção agora é 75-25 para treino e teste.
Tudo pronto para treinar modelos! Mas, como você lembra, o caret é um projeto enorme com muitos algoritmos. Se tiver dúvida sobre o que está incluído, liste todos com names(getModelInfo()), como no bloco abaixo. Depois, escolha um algoritmo e treine um modelo com train():
Perceba como criar outros modelos fica simples a partir daqui: basta mudar o argumento method, como neste exemplo:
model_cart <- train(iris.training[, 1:4], iris.training[, 5], method='rpart2')Agora que o modelo foi treinado, é hora de prever os rótulos do conjunto de teste e avaliar o desempenho:
Além disso, tente repetir o teste anterior para examinar o efeito do pré-processamento, como scaling e centering, no modelo. Rode o bloco a seguir:
Parabéns! Você chegou ao fim deste tutorial!
O foco aqui foi aplicar o algoritmo básico KNN com a ajuda do R. O conjunto Iris é pequeno e fácil de visualizar; além de ver como executar todos os passos manualmente, você também viu como usar uma interface uniforme, como a do caret, para acelerar seu machine learning.
Mas dá para ir muito além!
Se você já experimentou bastante com os fundamentos apresentados e outros algoritmos, talvez ache interessante se aprofundar em R e análise de dados.
Cursos de R
Curso
Curso
Curso
Tutorial
Abid Ali Awan
10 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Eugenia Anello
8 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Kevin Babitz
8 min
Tutorial
Arunn Thevapalan
15 min



