
Last chance! 50% off DataCamp Premium
Sale ends in
OpenCV, atau Open Source Computer Vision Library, adalah pustaka sumber terbuka yang tangguh dan banyak digunakan dalam proyek visi komputer. OpenCV dirancang untuk menyediakan kerangka kerja terintegrasi bagi visi komputer waktu nyata dan menjadi platform yang memfasilitasi berbagai aplikasi analisis gambar dan video.
Pustaka OpenCV berperan penting dalam membantu pengembang dan peneliti memanfaatkan keunggulan pemrosesan data visual. Kemampuannya mencakup beragam aplikasi, dari pemrosesan gambar dasar hingga tugas yang lebih kompleks seperti identifikasi objek dan pengenalan wajah. Dengan menawarkan koleksi algoritma, metode, dan operasi pemrosesan data gambar yang luas, OpenCV memudahkan pengembangan sistem cerdas yang mampu mengenali dan mengklasifikasikan konten visual.
Salah satu aplikasi OpenCV yang menonjol adalah pengenalan objek, di mana algoritmanya memfasilitasi identifikasi dan pelokalan objek di dalam gambar atau aliran video. Kemampuan ini juga meluas ke tugas visi komputer lainnya, seperti pengenalan wajah, pelacakan pergerakan, dan dukungan untuk teknologi augmented reality.
Dalam artikel ini, kita membahas hal-hal berikut:
Untuk mengikuti tutorial OpenCV ini, Anda memerlukan pengetahuan menengah tentang Python dan pemahaman dasar mengenai visi komputer. Keakraban dengan prinsip-prinsip pemrosesan gambar juga akan meningkatkan pengalaman belajar sepanjang tutorial, meskipun konsep-konsep kunci akan didefinisikan saat disebutkan.
!pip install opencv-pythonAnda dapat menggunakan perintah berikut jika Anda menggunakan Anaconda:
!conda install -c conda-forge opencvUntuk memastikan instalasi berhasil, jalankan kode berikut pada Python Interpreter atau Jupyter Notebook:
import cv2
print(cv2.__version__)
Jika instalasi berhasil, ini akan mencetak nomor versi pustaka OpenCV yang terpasang. Jika nomor versi tidak tercetak pada terminal atau konsol, berarti proses instalasi tidak berhasil.
Catatan Penting jika menggunakan Google Colab: Agar kode dapat menampilkan gambar di dalam notebook Google Colab, perlu mengubah fungsi tradisional cv2.imshow menjadi cv2_imshow yang disediakan oleh pustaka spesifik Google Colab. Penyesuaian ini memastikan kompatibilitas dengan lingkungan Colab, yang tidak mendukung cv2.imshow. Untuk menerapkan perubahan ini, impor fungsi cv2_imshow dari patches Google Colab sebagai berikut:
from google.colab.patches import cv2_imshow

# Displaying an image in a window
cv2_imshow(image)
Cuplikan kode di bawah ini memperkenalkan titik masuk dasar untuk memanfaatkan pustaka OpenCV dalam pemrosesan gambar. Memuat gambar ke dalam lingkungan pengembangan dilakukan di berbagai ranah, mulai dari proyek visi komputer sederhana hingga aplikasi deteksi objek waktu nyata yang kompleks di produksi. Menampilkan gambar juga penting untuk mengamati konten gambar atau hasil pemrosesan. Pada kode di bawah, kita membaca JPG dari berkas dan menampilkannya menggunakan pustaka OpenCV.
Cuplikan kode berikut dapat digunakan untuk memuat dan menampilkan gambar di OpenCV:
import cv2

# Loading image from a file
image = cv2.imread('your/image/path.jpg')

# Displaying an image in a window
cv2.imshow('Image', image)
cv2.waitKey(0)
cv2.destroyAllWindows()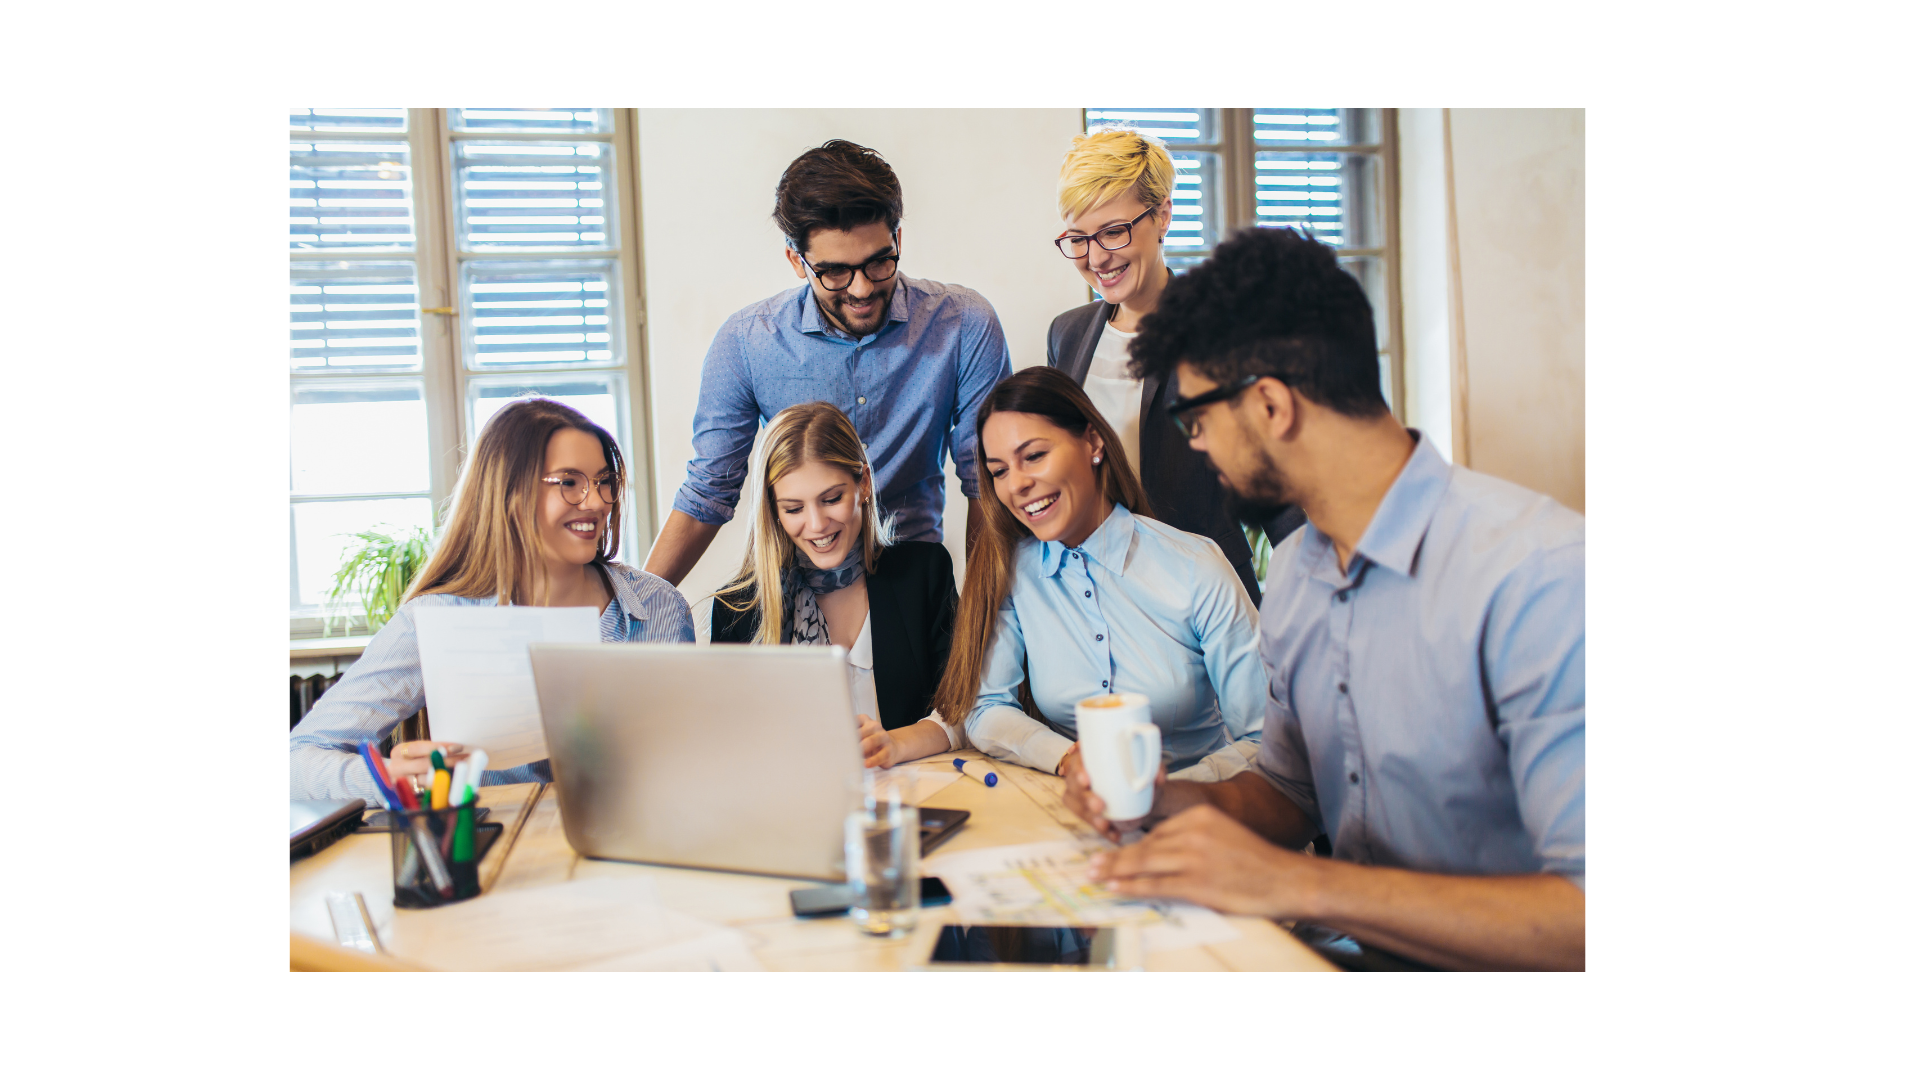
Pegawai kantor mengelilingi sebuah laptop. Sumber: Canva
Pada kode ini, gambar dibaca dari berkas menggunakan ‘cv2.imread’ lalu ditampilkan dalam jendela dengan bantuan ‘imshow’. Fungsi 'cv2.waitKey(0)' memastikan jendela tetap terbuka hingga pengguna menutupnya dengan menekan sebuah tombol.
Pemrosesan gambar adalah memanipulasi data piksel dalam sebuah gambar sedemikian rupa sehingga memodifikasi tampilan visual gambar awal, baik untuk ekstraksi fitur, analisis gambar, atau tugas lain terkait visi komputer. Contoh teknik pemrosesan gambar meliputi pemrosesan warna, penyaringan, segmentasi, deteksi tepi, dan sebagainya.
Cuplikan kode di bawah menunjukkan teknik pemrosesan gambar sederhana pada gambar yang dimuat pada cuplikan kode sebelumnya. Teknik yang ditunjukkan di sini adalah konversi warna sederhana, khususnya konversi ke skala abu-abu. Konversi ke skala abu-abu adalah teknik dasar dalam pemrosesan gambar, yang mereduksi gambar menjadi satu kanal nilai intensitas.
# Converting an image to grayscale form
gray_image = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)

# Displaying the grayscale image
cv2.imshow('Gray Image', gray_image)
cv2.waitKey(0)
cv2.destroyAllWindows()
Di sini, cv2.cvtColor() mengonversi gambar yang dimuat menjadi skala abu-abu.
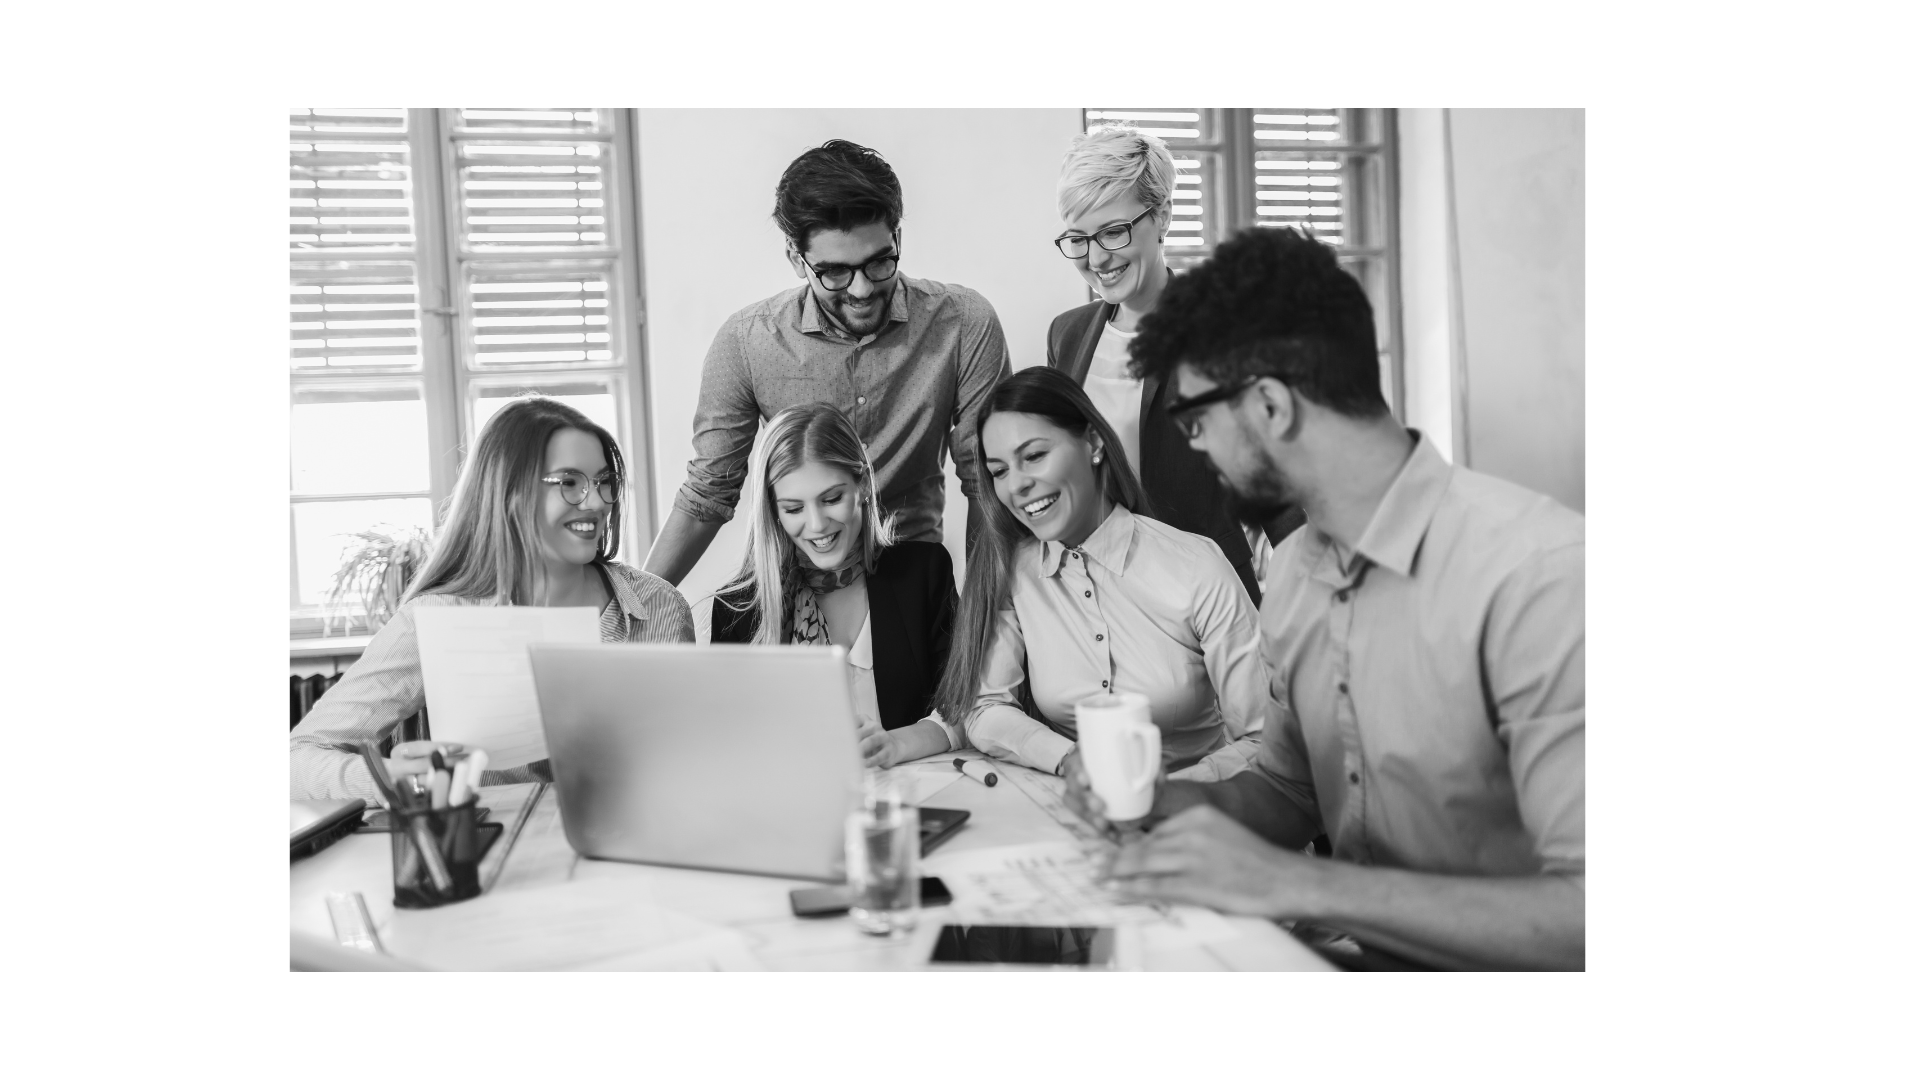
Pegawai kantor mengelilingi sebuah laptop (Skala abu-abu). Sumber: Canva
Deteksi tepi adalah teknik dasar dalam pemrosesan gambar dan visi komputer. Teknik ini mengidentifikasi titik-titik pada gambar di mana kecerahan berubah tajam atau memiliki diskontinuitas. Deteksi tepi sangat penting dalam visi komputer, terutama saat mendeteksi fitur dalam data gambar. Secara umum, deteksi tepi berfungsi dengan mendeteksi perubahan tajam pada intensitas piksel. Dengan menghubungkan titik-titik perubahan tajam pada kecerahan gambar, terbentuk garis dan tepi yang merangkum objek dalam gambar.
Dengan algoritma deteksi tepi, fitur tekstural dan struktural yang sangat kecil dari sebuah objek pada gambar dapat dideteksi.
Beberapa algoritma deteksi tepi, seperti Canny Edge Detector, Metode Sobel, dan metode Fuzzy Logic, digunakan dalam pengenalan objek, segmentasi gambar, dan ekstraksi fitur. Cuplikan kode berikut menunjukkan deteksi tepi dasar menggunakan OpenCV:
# Applying Canny edge detection (a simple edge detection method)
edges = cv2.Canny(gray_image, 50, 150)

# Displaying the edge-detected image
cv2.imshow('Edges', edges)
cv2.waitKey(0)
cv2.destroyAllWindows()
Algoritma deteksi tepi Canny tersedia secara langsung dalam pustaka OpenCV melalui fungsi 'cv2.Canny()' yang diterapkan untuk mendeteksi tepi objek pada gambar skala abu-abu.
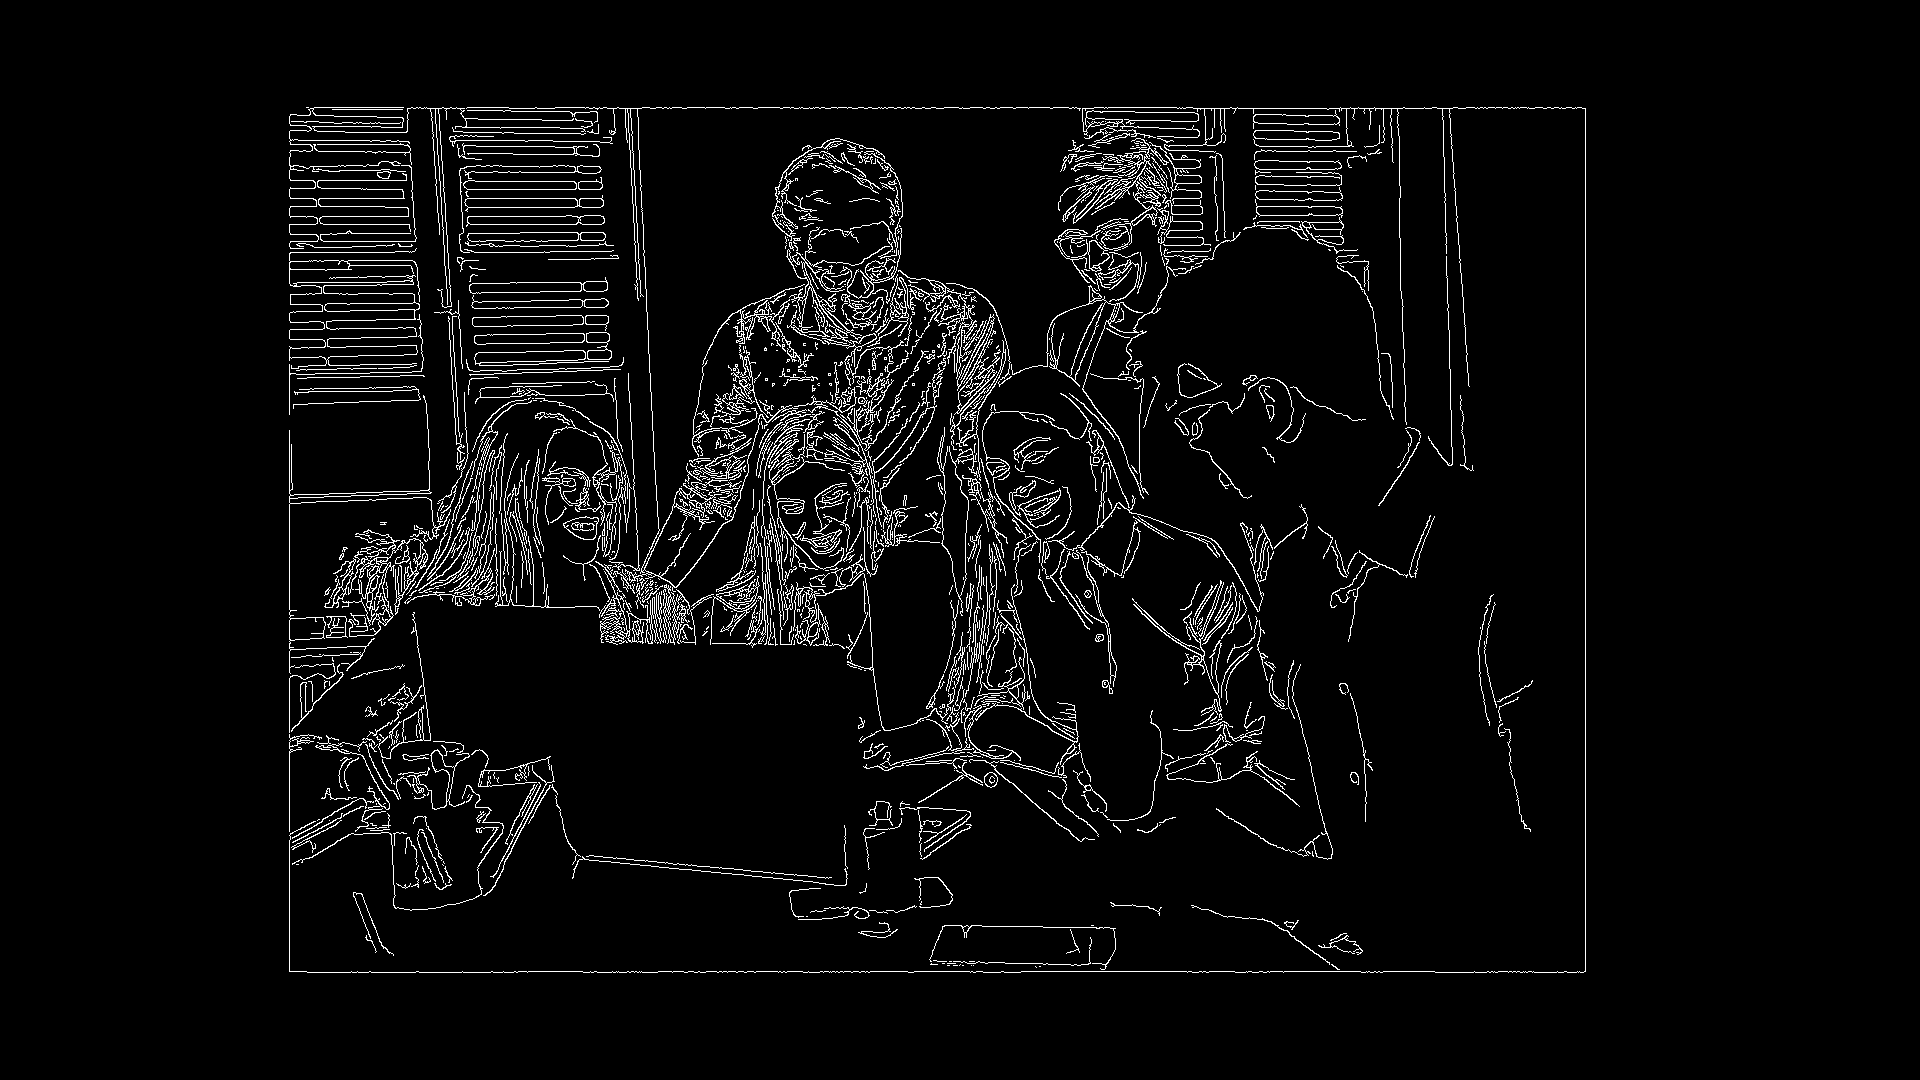
Pegawai kantor mengelilingi sebuah laptop (Skala abu-abu). Sumber: Canva
Mengubah ukuran dan memutar gambar adalah kebutuhan mendasar dalam pemrosesan gambar karena keduanya memfasilitasi adaptasi dan transformasi konten visual. Mengubah ukuran gambar melibatkan perubahan dimensinya, baik memperbesar maupun memperkecil, dan fungsi ini penting untuk penskalaan serta penempatan gambar dalam lingkungan tertentu.
Rotasi adalah penyesuaian yang mengubah sudut pandang gambar menurut sudut rotasi yang ditetapkan. Kedua operasi ini umum diterapkan sebagai langkah prapemrosesan gambar untuk berbagai tujuan, termasuk visi komputer, pembelajaran mesin, dan grafika. Misalnya, dalam pelatihan jaringan saraf dalam, rotasi dan pengubahan ukuran gambar merupakan teknik augmentasi data yang digunakan untuk meningkatkan keragaman dataset pelatihan yang diberikan ke jaringan saat pelatihan. Tujuan augmentasi data adalah melatih jaringan dengan dataset yang cukup bervariasi sehingga jaringan terlatih mampu melakukan generalisasi dengan baik pada data yang belum pernah dilihat.
Untuk mengubah ukuran dan memutar gambar menggunakan OpenCV, Anda dapat menggunakan kode berikut:
# Resizing the image
resized_image = cv2.resize(image, (width, height))

# Rotating the image by 45 degrees
rotation_matrix = cv2.getRotationMatrix2D((width / 2, height / 2), 45, 1)
rotated_image = cv2.warpAffine(resized_image, rotation_matrix, (width, height))

# Displaying the resized and rotated images
cv2.imshow('Resized Image', resized_image)
cv2.imshow('Rotated Image', rotated_image)
cv2.waitKey(0)
cv2.destroyAllWindows()
Sementara 'cv2.resize' digunakan untuk mengubah ukuran gambar, 'cv2.getRotationMatrix2D' bersama 'cv2.warpAffine' digunakan untuk memutar gambar.
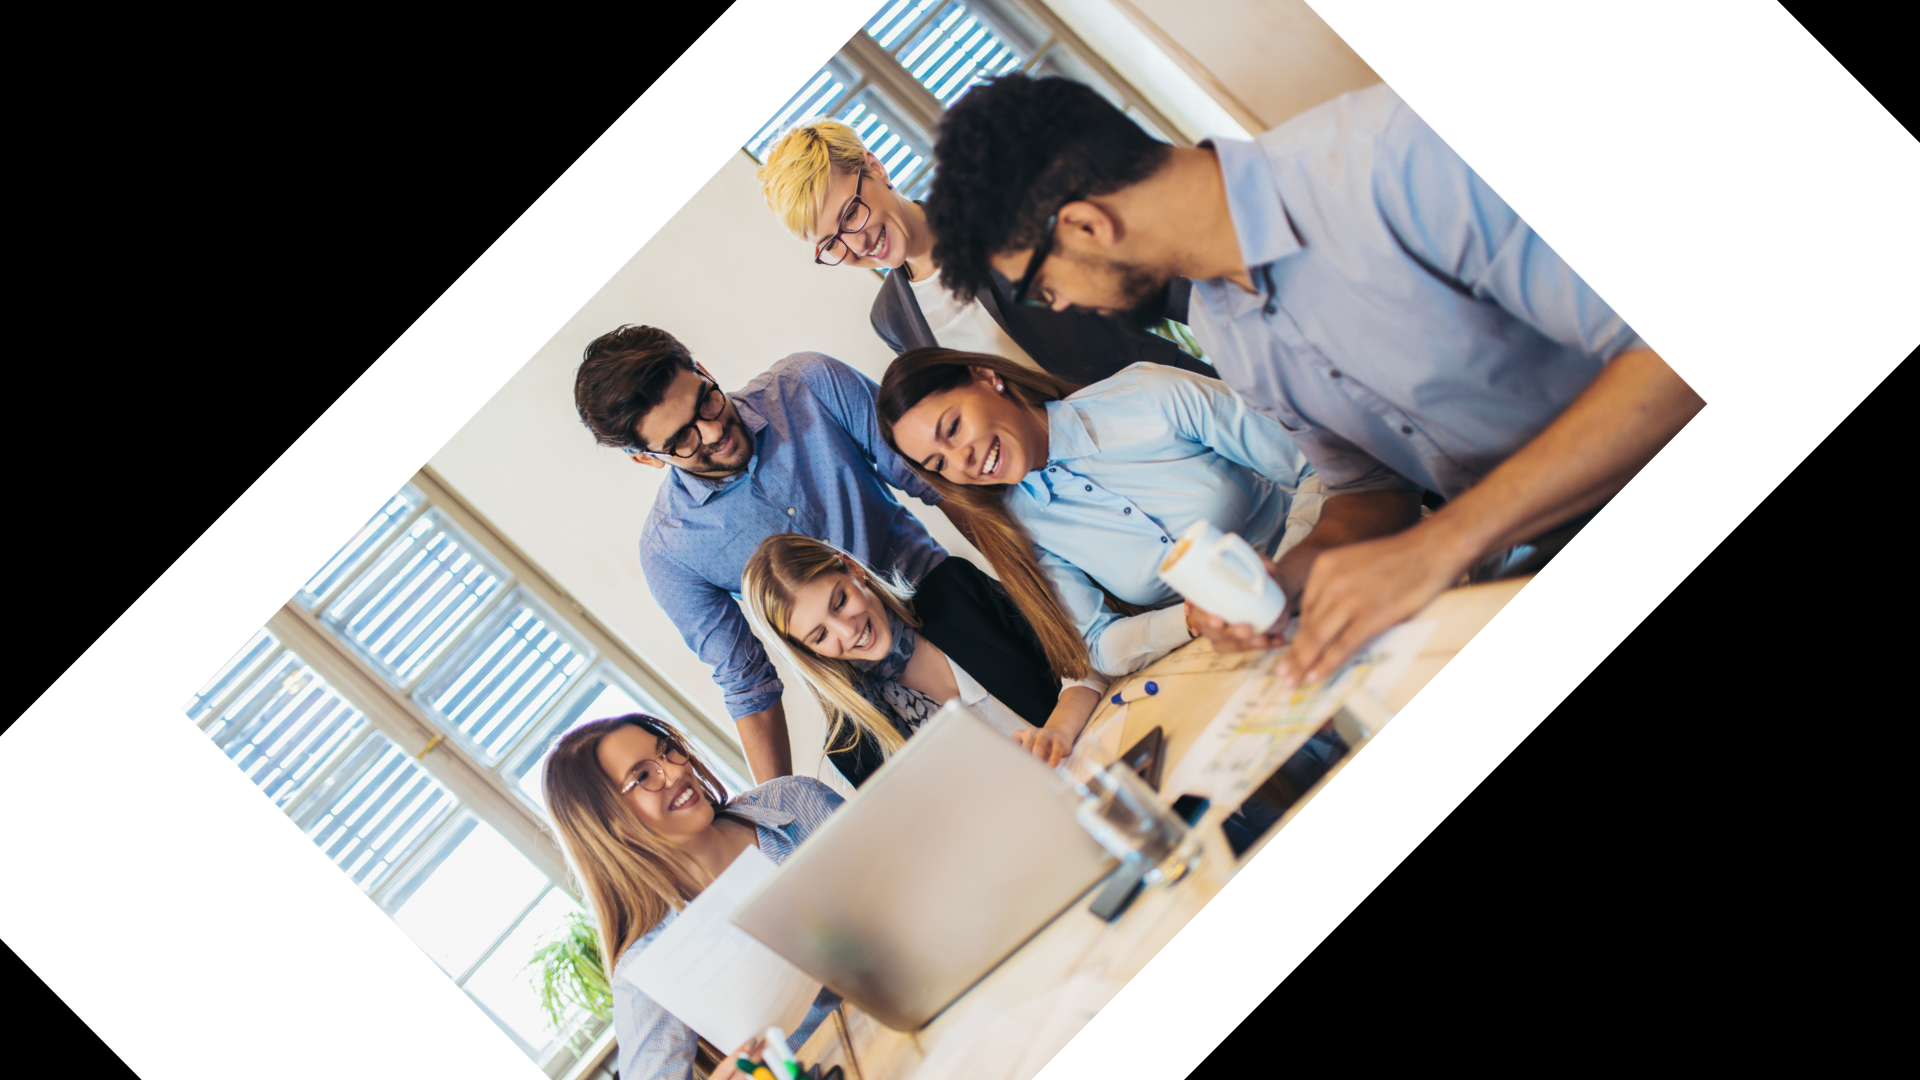
Pegawai kantor mengelilingi sebuah laptop (Diputar). Sumber: Canva
Video adalah rangkaian gambar yang disajikan secara berurutan. Dalam visi komputer, kemampuan pemrosesan video sangat penting untuk mengembangkan dan membangun aplikasi yang memproses data waktu nyata dan rekaman. Berbeda dengan sifat statis gambar, pemrosesan video menangani urutan temporal gambar, memungkinkan analisis gerak, perubahan dari waktu ke waktu, serta ekstraksi pola temporal.
Sifat konten yang dinamis dalam data video menuntut teknik pemrosesan video yang efisien, khususnya pada sistem-sistem kritis, misalnya pada aplikasi seperti pengawasan, mengemudi otonom, pengenalan aktivitas, dan banyak lagi, di mana pemahaman pergerakan dan perubahan sangat penting.
Keunggulan signifikan menggunakan OpenCV untuk tugas pemrosesan video adalah tersedianya rangkaian fitur komprehensif yang dirancang untuk menangani aliran video secara efisien. OpenCV menyediakan alat penangkapan, pemrosesan, dan analisis video sebagaimana halnya pada gambar.
Cuplikan kode berikut dapat digunakan untuk memuat dan memroses video yang berada secara lokal:
import cv2

# Open a video capture object
cap = cv2.VideoCapture("Your video's path.mp4")

# To check if the video has opened successfully of not
if not cap.isOpened():
    print("Error: Couldnot open the video.")
    exit()

# Loop through the video frames
while True:
    # Reading a frame from the video
    ret, frame = cap.read()

    # Break the loop if the video has ended
    if not ret:
        break

    # Display the original frame
    cv2.imshow('Original Video', frame)

    gray_frame = cv2.cvtColor(frame, cv2.COLOR_BGR2GRAY)
    cv2.imshow('Black and White Video', gray_frame)

    # Perform edge detection on the video
    edges_frame = cv2.Canny(gray_frame, 50, 150)
    cv2.imshow('Edges Video', edges_frame)

    # Break the loop if 'q' key is pressed
    if cv2.waitKey(25) & 0xFF == ord('q'):
        break

# Release the video capture object and close all windows
cap.release()
cv2.destroyAllWindows()
Pada kode ini, kelas ‘cv2.VideoCapture’ digunakan untuk mengakses berkas video dan membaca frame melalui metodenya ‘cap.read'. Kode ini terlebih dahulu menampilkan video asli, lalu mengonversinya ke hitam putih, dan akhirnya melakukan deteksi tepi pada setiap frame. Perulangan berjalan hingga video habis atau sebelum menerima input dari papan ketik untuk keluar. ‘cv2.waitKey(25)’ memberikan jeda singkat antarfame untuk menampilkannya, sehingga memastikan pemutaran yang mulus.
Deteksi objek adalah tugas dasar dalam visi komputer yang bertujuan mendeteksi dan melokalisasi objek dalam gambar atau video serta menyediakan hasil pengenalan – daftar label kelas yang terdeteksi dan kotak pembatas yang sesuai. Deteksi orang, sebuah variasi dari pengenalan objek, berfokus pada identifikasi dan pelokalan orang di dalam informasi visual.
Aplikasi deteksi orang mencakup pengawasan, manajemen kerumunan, penghitungan orang, pelacakan, interaksi manusia-komputer, dan lingkungan cerdas. Dalam pengawasan, teknologi ini membantu mendeteksi aktivitas mencurigakan, sementara dalam manajemen kerumunan, teknologi ini mendukung pengenalan gestur dan pelacakan. Deteksi orang memainkan peran penting dalam interaksi manusia-komputer dan juga digunakan di lingkungan cerdas untuk optimisasi sumber daya serta peningkatan keamanan.
YOLO, akronim dari "You Only Look Once," telah muncul sebagai sistem yang umum digunakan dan secara efisien mencapai pengenalan objek waktu nyata. Berbeda dengan metode deteksi objek klasik, YOLO membagi gambar menjadi kisi sel, lalu secara simultan memprediksi kotak pembatas dan probabilitas kelas untuk setiap sel.
Anda dapat membaca lebih lanjut tentang Deteksi Objek YOLO dalam panduan komprehensif kami.
Berikut adalah cuplikan kode yang menggunakan OpenCV dan Yolo untuk deteksi orang pada sebuah gambar:
import cv2

net = cv2.dnn.readNet('yolov3.weights', 'yolov3.cfg')
layer_names = net.getUnconnectedOutLayersNames()

image = cv2.imread('image path.jpg')
height, width = image.shape[:2]

blob = cv2.dnn.blobFromImage(image, 1/255.0, (416, 416), swapRB=True, crop=False)
net.setInput(blob)
outs = net.forward(layer_names)

for out in outs:
    for detection in out:
        scores = detection[5:]
        class_id = np.argmax(scores)
        confidence = scores[class_id]

        if confidence > 0.5 and class_id == 0:  # Class ID for person
            box = detection[:4] * np.array([width, height, width, height])
            (x, y, w, h) = box.astype(int)
            cv2.rectangle(image, (x, y), (x + w, y + h), (0, 255, 0), 2)

cv2.imshow('Person Detection', image)
cv2.waitKey(0)
cv2.destroyAllWindows()Secara serupa, struktur kode mengikuti prinsip yang sama untuk deteksi orang dalam video. Alih-alih memproses satu gambar statis, skrip atau aplikasi secara berkelanjutan memproses frame video.
Prinsip yang sama mendasari identifikasi orang baik dalam gambar maupun klip video, dengan perbedaan utama pada faktor waktu. Pada gambar, tugasnya melibatkan pengenalan dan pelokalan orang pada satu frame statis.
Aplikasi ini paling cocok untuk cuplikan pengawasan dan foto lain yang tidak saling tumpang tindih. Sebaliknya, pada video, tujuannya adalah mengidentifikasi dan melacak individu saat mereka bergerak ke frame-frame berikutnya. Ini terkadang disebut sebagai pelacakan objek dalam video. Aspek temporal sangat penting ketika mempertimbangkan pergerakan dan interaksi manusia dari waktu ke waktu, sehingga deteksi orang berbasis video menjadi alat vital untuk aplikasi waktu nyata, termasuk pengawasan keamanan, pemantauan kerumunan, dan analisis perilaku.
Kasus penggunaan dunia nyata lainnya dari deteksi orang mencakup kota cerdas, analitik ritel, dan keselamatan publik. Namun demikian, ada pertimbangan etika terkait isu privasi, persetujuan, dan penyalahgunaan teknologi. Penerapan yang bertanggung jawab di berbagai domain dicapai dengan menyeimbangkan manfaat dan kekhawatiran etis.
Tutorial ini menunjukkan aspek dasar bekerja dengan pustaka OpenCV untuk berbagai tugas visi komputer. Dimulai dari dasar, tutorial ini menunjukkan cara memasang OpenCV dalam lingkungan Python. Operasi OpenCV untuk memuat dan menampilkan gambar diperlihatkan bersama teknik pemrosesan gambar, seperti mengonversi gambar ke skala abu-abu dan menerapkan deteksi tepi. Secara keseluruhan, jelas bahwa OpenCV dapat melakukan transformasi dan analisis gambar yang canggih, termasuk menerapkan teknik pemrosesan gambar pada frame video.
Perlu dicatat, OpenCV memainkan peran penting dalam visi komputer terapan karena menawarkan fleksibilitas dan kapabilitas yang kuat, memungkinkan insinyur visi komputer dan praktisi pembelajaran mesin menangani banyak tantangan terkait pemrosesan data visual. Keunggulan utama memanfaatkan pustaka OpenCV adalah menyederhanakan proses penerapan algoritma visi komputer dan secara efisien membawa konsep aplikasi ke implementasi praktis.
Tingkatkan pemahaman Anda tentang konsep yang dibahas dalam artikel ini dengan menyelami lebih jauh pemrosesan gambar di Python melalui kursus terkurasi dengan baik. Kursus ini memperluas perangkat Anda untuk pemrosesan gambar dan visi komputer dengan pustaka tambahan seperti Sci-kit Image dan Numpy.
Mulai Perjalanan Python Anda Hari Ini!
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt




