
Curso
Python intermediário
4 h
1.4M
OpenCV, a Open Source Computer Vision Library, é uma robusta biblioteca aberta amplamente adotada em projetos de visão computacional. O OpenCV foi criado para oferecer um framework integrado para visão computacional em tempo real e serve como uma plataforma que viabiliza inúmeras aplicações de análise de imagens e vídeos.
A biblioteca OpenCV tem um papel fundamental ao permitir que desenvolvedores e pesquisadores aproveitem as vantagens do processamento de dados visuais. Seus recursos abrangem diversas aplicações, desde o processamento básico de imagens até tarefas mais complexas, como identificação de objetos e reconhecimento facial. Ao oferecer uma ampla coleção de algoritmos, métodos e operações de processamento de imagens, o OpenCV facilita o desenvolvimento de sistemas inteligentes capazes de reconhecer e classificar conteúdo visual.
Uma aplicação notável do OpenCV é o reconhecimento de objetos, em que seus algoritmos ajudam a identificar e localizar objetos em imagens ou fluxos de vídeo. Essa capacidade também se estende a outras tarefas de visão computacional, como reconhecimento facial, rastreamento de movimento e suporte a tecnologias de realidade aumentada.
Neste artigo, você vai ver:
Para acompanhar este tutorial de OpenCV, você precisa ter conhecimento intermediário de Python e noções básicas de visão computacional. Familiaridade com princípios de processamento de imagens também melhora a experiência ao longo do tutorial, embora os conceitos-chave sejam definidos quando mencionados.
!pip install opencv-pythonSe estiver usando Anaconda, você pode usar o comando abaixo:
!conda install -c conda-forge opencvPara confirmar se a instalação foi bem-sucedida, execute o código a seguir em um interpretador Python ou no Jupyter Notebook:
import cv2
print(cv2.__version__)
Se tudo deu certo, será exibido o número da versão do OpenCV instalado. Se a versão não aparecer no terminal ou console, significa que a instalação não foi concluída com sucesso.
Observação importante ao usar Google Colab: Para exibir imagens em notebooks do Google Colab, é necessário substituir a função tradicional cv2.imshow por cv2_imshow, fornecida pelas bibliotecas específicas do Colab. Essa adaptação garante compatibilidade com o ambiente Colab, que não suporta cv2.imshow. Para isso, importe a função cv2_imshow dos patches do Google Colab assim:
from google.colab.patches import cv2_imshow

# Exibindo uma imagem em uma janela
cv2_imshow(image)
O trecho de código abaixo apresenta um ponto de partida fundamental para usar a biblioteca OpenCV no processamento de imagens. Carregar uma imagem no ambiente de desenvolvimento é algo feito em várias frentes, desde projetos simples de visão computacional até aplicações complexas de detecção de objetos em tempo real em produção. Exibir uma imagem também é essencial para observar o conteúdo ou o resultado de um processamento. No código abaixo, lemos um JPG de um arquivo e o exibimos usando a biblioteca OpenCV.
Use o trecho de código a seguir para carregar e exibir imagens com o OpenCV:
import cv2

# Carregando a imagem de um arquivo
image = cv2.imread('your/image/path.jpg')

# Exibindo a imagem em uma janela
cv2.imshow('Image', image)
cv2.waitKey(0)
cv2.destroyAllWindows()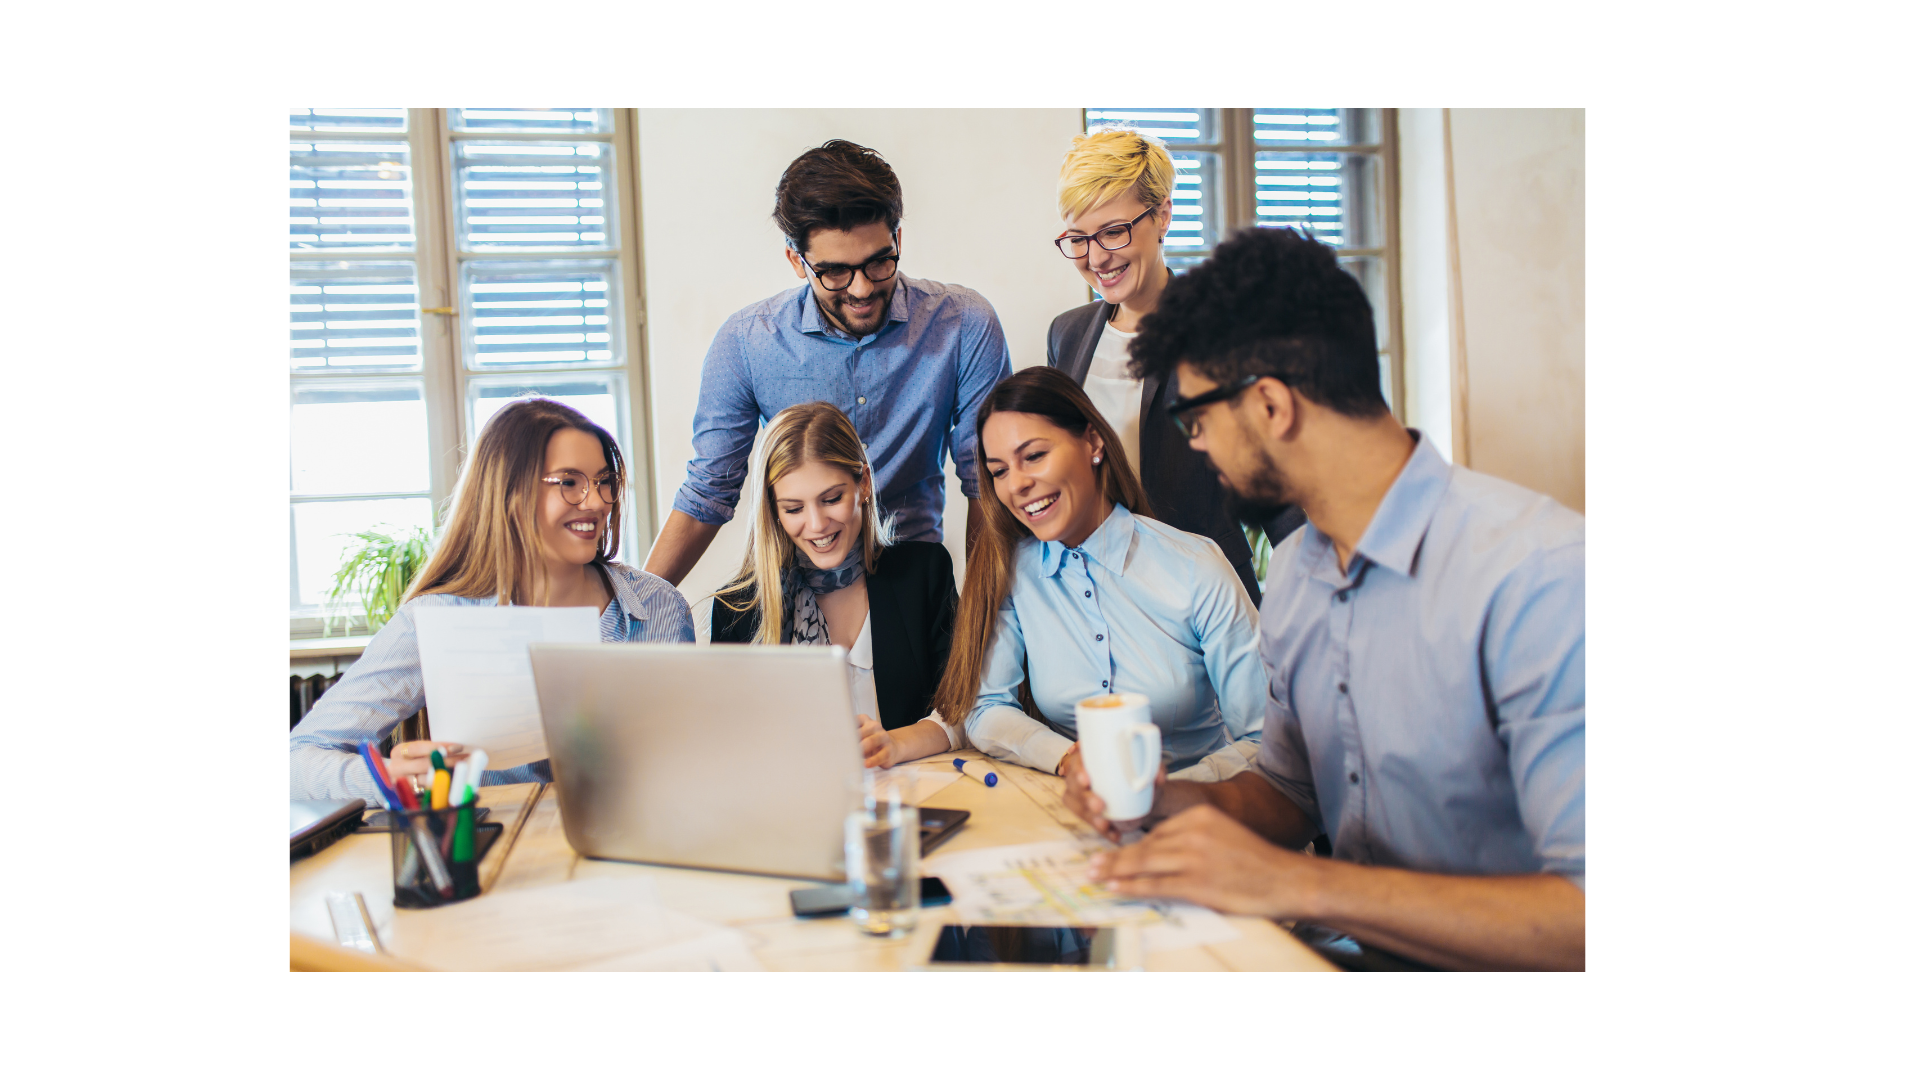
Profissionais de escritório em volta de um laptop. Fonte: Canva
Nesse código, a imagem é lida de um arquivo usando cv2.imread e exibida em uma janela com a função imshow. A função cv2.waitKey(0) garante que a janela permaneça aberta até o usuário fechá-la pressionando uma tecla.
Processamento de imagem é a manipulação dos pixels de uma imagem de forma a modificar a aparência visual da imagem original, seja para extração de atributos, análise de imagens ou outras tarefas de visão computacional. Exemplos de técnicas incluem processamento de cores, filtragem, segmentação, detecção de bordas etc.
O trecho de código abaixo demonstra uma técnica simples de processamento aplicada à imagem carregada anteriormente: uma conversão de cor para tons de cinza. A conversão para escala de cinza é uma técnica básica no processamento de imagens, reduzindo a imagem a um único canal de intensidades.
# Convertendo uma imagem para tons de cinza
gray_image = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)

# Exibindo a imagem em tons de cinza
cv2.imshow('Gray Image', gray_image)
cv2.waitKey(0)
cv2.destroyAllWindows()
Aqui, cv2.cvtColor() converte a imagem carregada para escala de cinza.
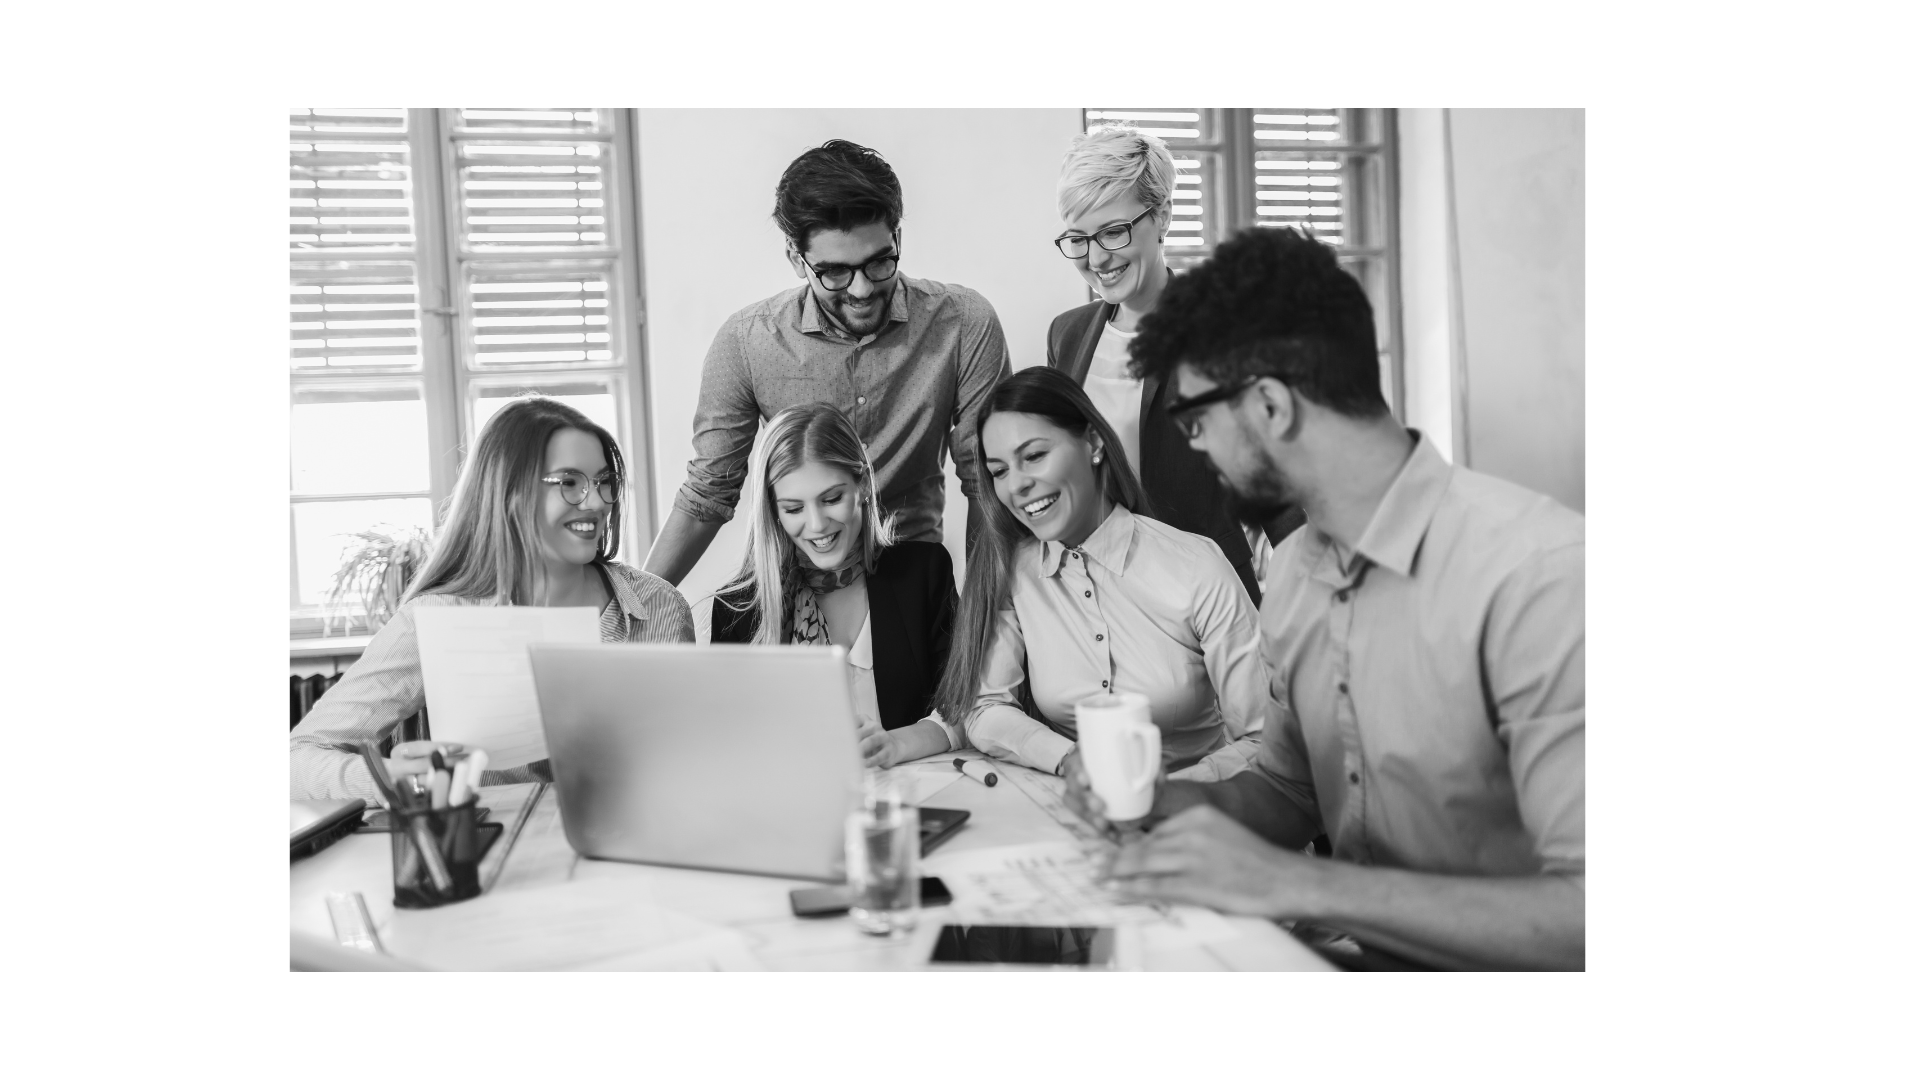
Profissionais de escritório em volta de um laptop (tons de cinza). Fonte: Canva
Detecção de bordas é uma técnica fundamental em processamento de imagens e visão computacional. Ela identifica pontos de uma imagem onde o brilho muda abruptamente ou onde há descontinuidades. Detectar bordas é essencial, especialmente quando buscamos identificar elementos dentro dos dados de imagem. Em geral, a detecção de bordas funciona encontrando mudanças bruscas nas intensidades dos pixels. Ao conectar esses pontos de variação acentuada no brilho, formam-se linhas e contornos que delineiam os objetos na imagem.
Com algoritmos de detecção de bordas, é possível identificar detalhes texturais e estruturais minuciosos de um objeto na imagem.
Vários algoritmos de detecção de bordas, como o Canny Edge Detector, o método de Sobel e o método de lógica fuzzy, são utilizados em reconhecimento de objetos, segmentação de imagens e extração de atributos. O código a seguir demonstra a detecção básica de bordas usando OpenCV:
# Aplicando a detecção de bordas de Canny (um método simples de detecção)
edges = cv2.Canny(gray_image, 50, 150)

# Exibindo a imagem com bordas detectadas
cv2.imshow('Edges', edges)
cv2.waitKey(0)
cv2.destroyAllWindows()
O algoritmo de detecção de bordas de Canny está disponível no OpenCV por meio da função cv2.Canny(), que detecta as bordas do objeto em uma imagem em tons de cinza.
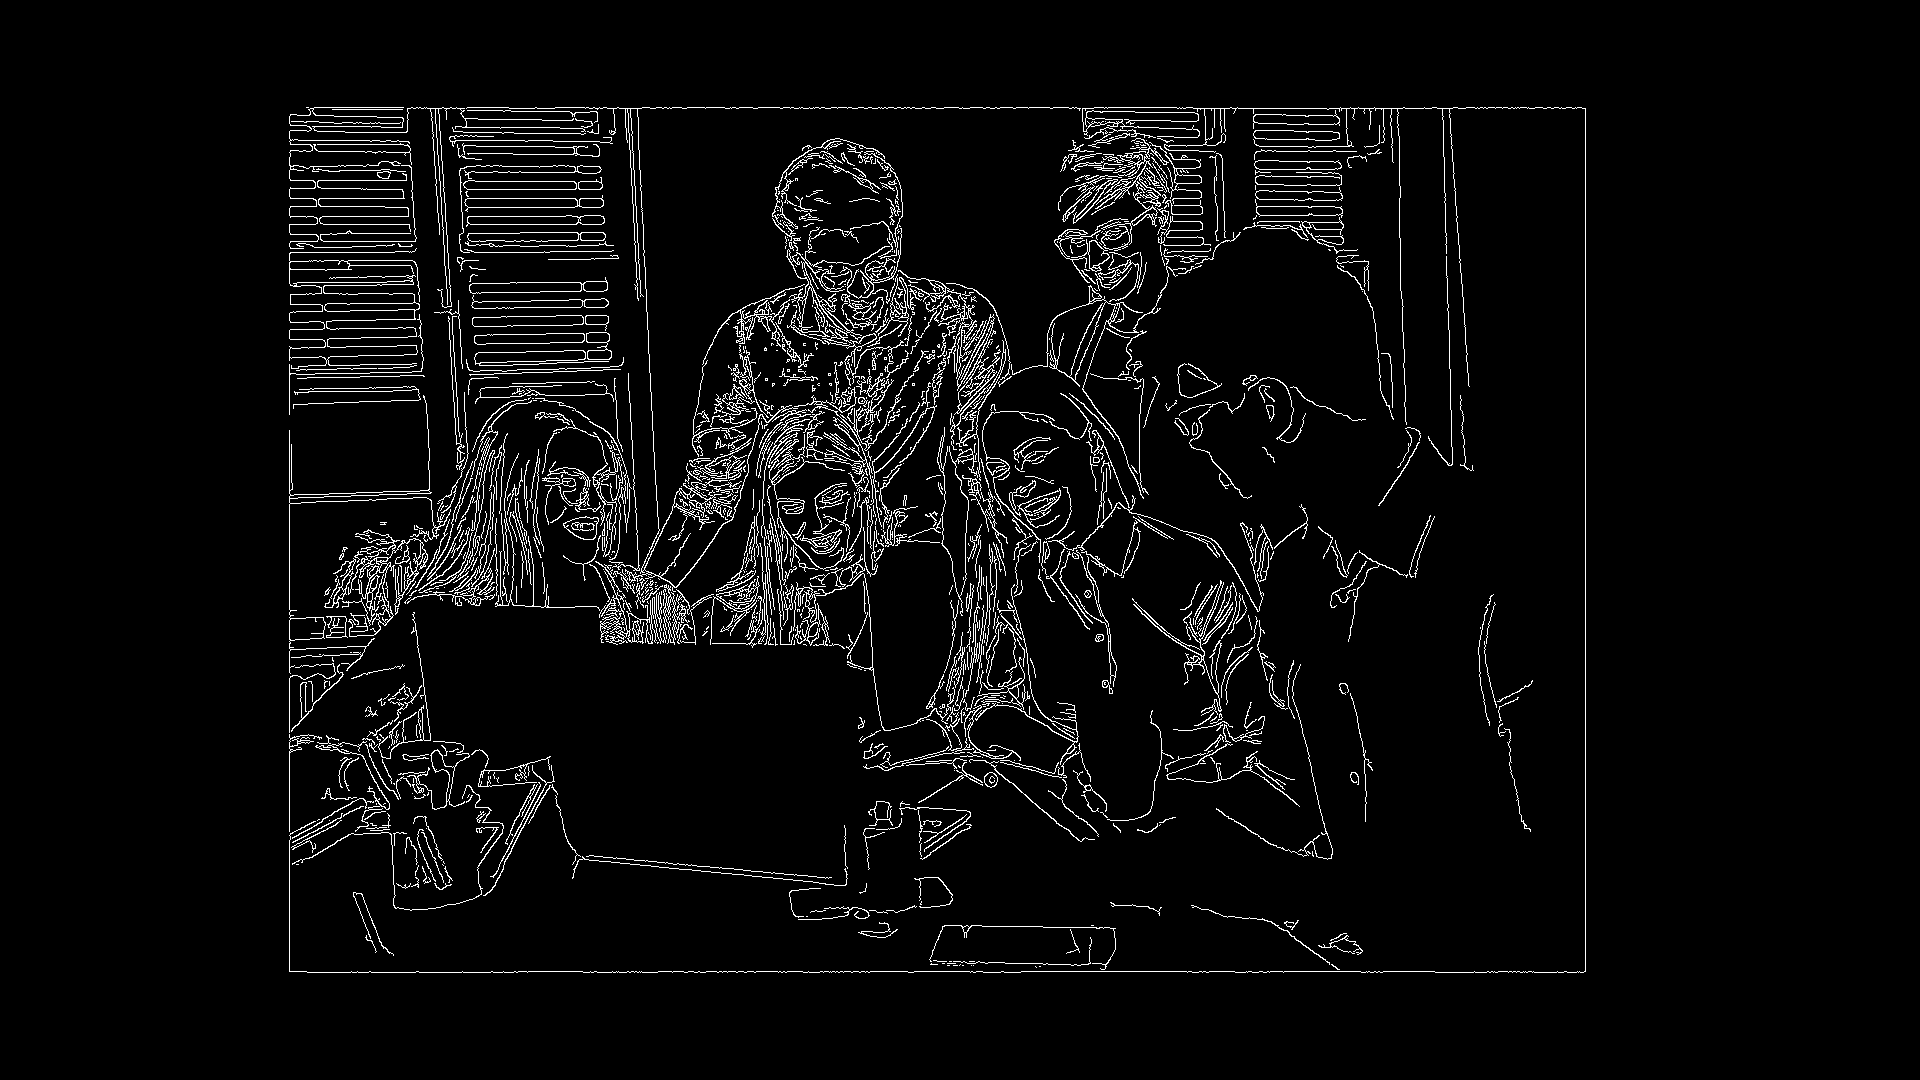
Profissionais de escritório em volta de um laptop (tons de cinza). Fonte: Canva
Redimensionar e rotacionar imagens são requisitos fundamentais no processamento, pois facilitam a adaptação e a transformação do conteúdo visual. Redimensionar envolve alterar as dimensões de uma imagem, seja ampliando ou reduzindo, e é essencial para ajustar e posicionar imagens em contextos específicos.
Rotacionar é um ajuste que altera o ângulo pelo qual uma imagem é visualizada. Ambas as operações são comuns como etapas de pré-processamento de imagens para vários fins, incluindo visão computacional, aprendizado de máquina e computação gráfica. Por exemplo, no treinamento de redes neurais profundas, rotacionar e redimensionar imagens são técnicas de aumento de dados usadas para ampliar a variabilidade do conjunto de treinamento. O objetivo é treinar a rede com um conjunto com variância suficiente para que o modelo generalize bem em dados não vistos.
Para redimensionar e rotacionar imagens com OpenCV, você pode usar o código abaixo:
# Redimensionando a imagem
resized_image = cv2.resize(image, (width, height))

# Rotacionando a imagem em 45 graus
rotation_matrix = cv2.getRotationMatrix2D((width / 2, height / 2), 45, 1)
rotated_image = cv2.warpAffine(resized_image, rotation_matrix, (width, height))

# Exibindo as imagens redimensionada e rotacionada
cv2.imshow('Resized Image', resized_image)
cv2.imshow('Rotated Image', rotated_image)
cv2.waitKey(0)
cv2.destroyAllWindows()
Enquanto cv2.resize é usado para redimensionar a imagem, cv2.getRotationMatrix2D em conjunto com cv2.warpAffine são usados para rotacioná-la.
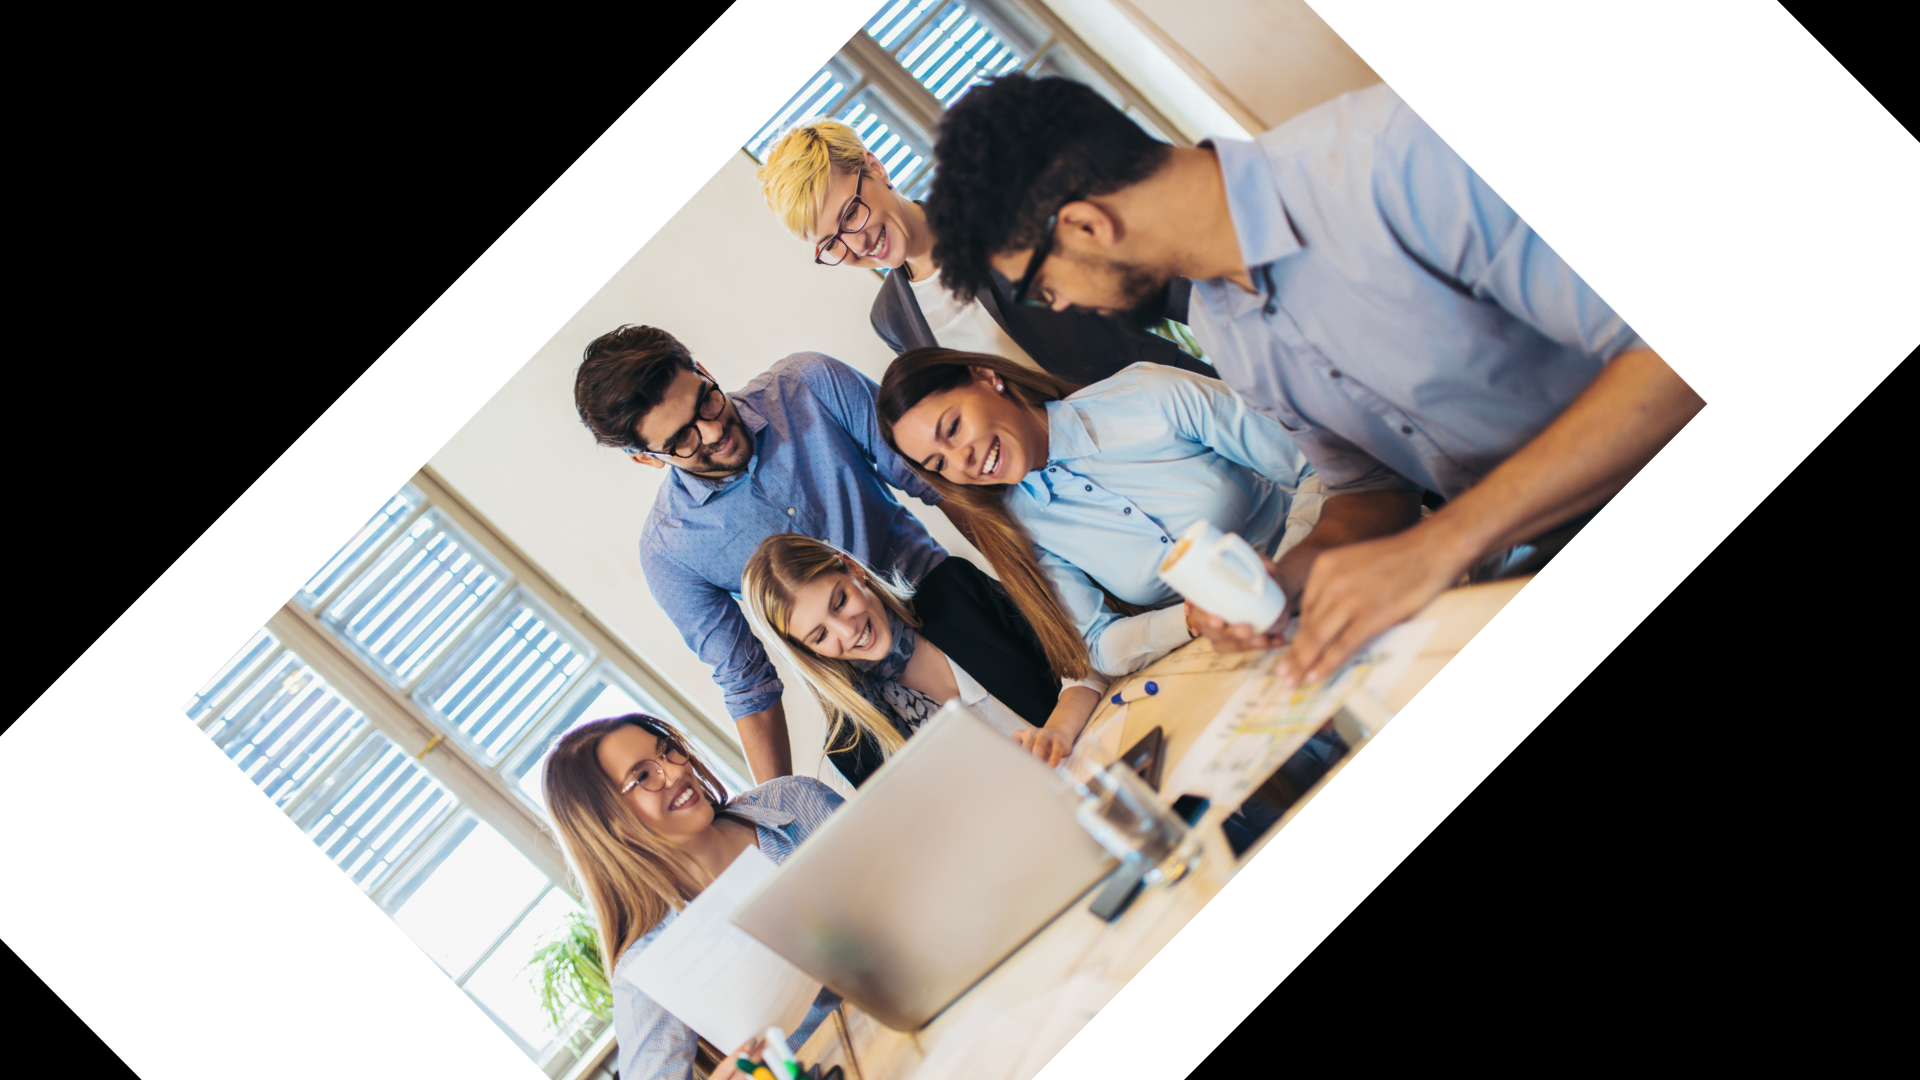
Profissionais de escritório em volta de um laptop (rotacionada). Fonte: Canva
Vídeos são uma sequência de imagens apresentadas em ordem. Em visão computacional, recursos de processamento de vídeo são essenciais para desenvolver aplicações que tratam dados em tempo real e gravados. Diferente das imagens estáticas, o processamento de vídeo lida com sequências temporais, permitindo analisar movimento, mudanças ao longo do tempo e extrair padrões temporais.
A natureza dinâmica do conteúdo em dados de vídeo exige técnicas eficientes, especialmente em sistemas críticos, como vigilância, direção autônoma, reconhecimento de atividades e muito mais, onde entender movimento e mudança é essencial.
Uma grande vantagem de usar o OpenCV em tarefas de vídeo é o conjunto abrangente de recursos projetados para lidar com fluxos de vídeo com eficiência. Assim como com imagens, o OpenCV oferece ferramentas para captura, processamento e análise de vídeo.
O trecho de código abaixo pode ser usado para carregar e processar um vídeo localizado localmente:
import cv2

# Abrindo um objeto de captura de vídeo
cap = cv2.VideoCapture("Your video's path.mp4")

# Verificando se o vídeo foi aberto com sucesso
if not cap.isOpened():
    print("Error: Couldnot open the video.")
    exit()

# Loop pelos frames do vídeo
while True:
    # Lendo um frame do vídeo
    ret, frame = cap.read()

    # Encerra o loop se o vídeo terminar
    if not ret:
        break

    # Exibe o frame original
    cv2.imshow('Original Video', frame)

    gray_frame = cv2.cvtColor(frame, cv2.COLOR_BGR2GRAY)
    cv2.imshow('Black and White Video', gray_frame)

    # Realiza detecção de bordas no vídeo
    edges_frame = cv2.Canny(gray_frame, 50, 150)
    cv2.imshow('Edges Video', edges_frame)

    # Encerra o loop se a tecla 'q' for pressionada
    if cv2.waitKey(25) & 0xFF == ord('q'):
        break

# Libera o objeto de captura e fecha todas as janelas
cap.release()
cv2.destroyAllWindows()
Nesse código, a classe cv2.VideoCapture acessa um arquivo de vídeo e lê frames por meio do método cap.read. Em seguida, ele exibe primeiro o vídeo original, depois converte para preto e branco e, por fim, aplica detecção de bordas a cada frame. O loop roda até o vídeo acabar ou até receber o comando do teclado para sair. O cv2.waitKey(25) adiciona um pequeno atraso entre os frames para exibi-los, garantindo uma reprodução fluida.
Detecção de objetos é uma tarefa fundamental da visão computacional que visa detectar e localizar objetos em uma imagem ou vídeo, fornecendo resultados de reconhecimento – uma lista de classes detectadas e as respectivas bounding boxes. A detecção de pessoas, uma variação do reconhecimento de objetos, foca em identificar e localizar pessoas nas informações visuais.
Aplicações incluem vigilância, gestão de multidões, contagem de pessoas, rastreamento, interação humano-computador e ambientes inteligentes. Em vigilância, essa tecnologia ajuda a detectar atividades suspeitas; na gestão de multidões, dá suporte ao reconhecimento de gestos e ao rastreamento. A detecção de pessoas é crucial na interação humano-computador e também é usada em ambientes inteligentes para otimização de recursos e maior segurança.
YOLO, sigla para "You Only Look Once", tornou-se um sistema amplamente utilizado que alcança reconhecimento de objetos em tempo real com eficiência. Ao contrário dos métodos clássicos, o YOLO divide a imagem em uma grade de células, prevendo simultaneamente as bounding boxes e as probabilidades de classe para cada célula.
Você pode saber mais sobre o YOLO Object Detection no nosso guia completo.
Abaixo está um trecho de código usando OpenCV e YOLO para detecção de pessoas em uma imagem:
import cv2

net = cv2.dnn.readNet('yolov3.weights', 'yolov3.cfg')
layer_names = net.getUnconnectedOutLayersNames()

image = cv2.imread('image path.jpg')
height, width = image.shape[:2]

blob = cv2.dnn.blobFromImage(image, 1/255.0, (416, 416), swapRB=True, crop=False)
net.setInput(blob)
outs = net.forward(layer_names)

for out in outs:
    for detection in out:
        scores = detection[5:]
        class_id = np.argmax(scores)
        confidence = scores[class_id]

        if confidence > 0.5 and class_id == 0:  # Class ID for person
            box = detection[:4] * np.array([width, height, width, height])
            (x, y, w, h) = box.astype(int)
            cv2.rectangle(image, (x, y), (x + w, y + h), (0, 255, 0), 2)

cv2.imshow('Person Detection', image)
cv2.waitKey(0)
cv2.destroyAllWindows()Da mesma forma, a estrutura do código segue princípios semelhantes para detecção de pessoas em vídeo. Em vez de processar uma imagem estática, o script ou aplicação processa continuamente os frames do vídeo.
O mesmo princípio fundamenta a identificação de pessoas em imagens e em clipes de vídeo, com a principal diferença sendo o fator tempo. Em imagens, a tarefa envolve reconhecer e posicionar pessoas em frames estáticos individuais.
Essa aplicação é mais adequada para registros de vigilância e outras fotografias não sobrepostas. Já em vídeos, o objetivo é identificar e rastrear indivíduos conforme avançam para os frames seguintes, o que às vezes é chamado de rastreamento de objetos em vídeo. O aspecto temporal é crucial ao considerar movimentos e interações humanas ao longo do tempo, tornando a detecção de pessoas baseada em vídeo uma ferramenta vital para aplicações em tempo real, incluindo segurança, monitoramento de multidões e análise de comportamento.
Outros casos de uso incluem cidades inteligentes, analytics para varejo e segurança pública. Ainda assim, há considerações éticas ligadas à privacidade, consentimento e possíveis usos indevidos da tecnologia. A implantação responsável em diferentes domínios exige equilibrar benefícios e preocupações éticas.
Este tutorial apresentou os fundamentos para trabalhar com a biblioteca OpenCV em diversas tarefas de visão computacional. Começando pelo básico, mostramos como instalar o OpenCV em um ambiente Python. Demonstramos operações do OpenCV para carregar e exibir imagens, além de técnicas de processamento como conversão para tons de cinza e aplicação de detecção de bordas. No geral, fica claro que o OpenCV executa transformações e análises sofisticadas de imagens, incluindo a aplicação de técnicas de processamento a frames de vídeo.
Notavelmente, o OpenCV tem um papel crucial na visão computacional aplicada, pois oferece versatilidade e recursos robustos, permitindo que engenheiros de visão computacional e profissionais de machine learning enfrentem muitos desafios relacionados ao processamento de dados visuais. A principal vantagem de usar a biblioteca OpenCV é agilizar a aplicação de algoritmos de visão computacional e transformar conceitos de aplicação em implementações práticas com eficiência.
Aprofunde seu entendimento dos conceitos discutidos neste artigo explorando image processing in Python em um curso bem estruturado. Esse curso amplia seu repertório para processamento de imagens e visão computacional com bibliotecas adicionais como Sci-kit Image e Numpy.
Comece sua jornada em Python hoje mesmo!
Curso
Curso
Curso
Tutorial
Natassha Selvaraj
8 min
Tutorial
Moez Ali
14 min
Tutorial
Kurtis Pykes
11 min
Tutorial
Karlijn Willems
14 min
Tutorial
Amberle McKee
15 min
Tutorial
Joleen Bothma
9 min


