
Cours
Python intermédiaire
4 h
1.4M
OpenCV, pour Open Source Computer Vision Library, est une bibliothèque open source puissante, largement adoptée dans les projets de vision par ordinateur. OpenCV est conçue pour offrir un cadre intégré de vision en temps réel et sert de plateforme pour de nombreuses applications d’analyse d’images et de vidéos.
La bibliothèque OpenCV joue un rôle clé en permettant aux développeurs et aux chercheurs de tirer parti du traitement des données visuelles. Ses fonctionnalités couvrent un large éventail d’applications, du traitement d’image de base à des tâches plus complexes comme l’identification d’objets et la reconnaissance faciale. En proposant une vaste collection d’algorithmes, de méthodes et d’opérations de traitement d’images, OpenCV facilite le développement de systèmes intelligents capables de reconnaître et de classer des contenus visuels.
Une application notable d’OpenCV est la reconnaissance d’objets, où ses algorithmes permettent d’identifier et de localiser des objets dans des images ou des flux vidéo. Cette capacité s’étend également à d’autres tâches de vision par ordinateur, telles que la reconnaissance faciale, le suivi de mouvement et la prise en charge des technologies de réalité augmentée.
Dans cet article, nous abordons les points suivants :
Pour suivre ce tutoriel OpenCV, vous devez avoir un niveau intermédiaire en Python et des bases en vision par ordinateur. La familiarité avec les principes du traitement d’images améliorera également votre parcours d’apprentissage, même si les notions clés sont définies au fil du texte.
!pip install opencv-pythonSi vous utilisez Anaconda, vous pouvez exécuter la commande suivante :
!conda install -c conda-forge opencvPour confirmer que l’installation a réussi, exécutez le code suivant dans un interpréteur Python ou un Jupyter Notebook :
import cv2
print(cv2.__version__)
En cas de succès, la version de la bibliothèque OpenCV installée s’affiche. Si aucun numéro de version n’apparaît dans le terminal ou la console, cela signifie que l’installation n’a pas abouti.
Remarque importante si vous utilisez Google Colab : Pour afficher des images dans les notebooks Google Colab, il faut remplacer la fonction classique cv2.imshow par cv2_imshow, fournie par des bibliothèques spécifiques à Colab. Cet ajustement garantit la compatibilité avec l’environnement Colab, qui ne prend pas en charge cv2.imshow. Pour l’appliquer, importez la fonction cv2_imshow depuis les patches de Google Colab comme suit :
from google.colab.patches import cv2_imshow

# Afficher une image dans une fenêtre
cv2_imshow(image)
L’extrait de code ci-dessous constitue un point d’entrée fondamental pour utiliser OpenCV dans le traitement d’images. Le chargement d’une image dans un environnement de développement intervient partout, des projets simples de vision par ordinateur aux applications de détection d’objets en temps réel en production. L’affichage d’une image est tout aussi essentiel pour observer le contenu ou le résultat d’un traitement. Dans le code ci-dessous, nous lisons un fichier JPG et l’affichons avec OpenCV.
Vous pouvez utiliser l’extrait de code suivant pour charger et afficher des images avec OpenCV :
import cv2

# Charger une image depuis un fichier
image = cv2.imread('your/image/path.jpg')

# Afficher l'image dans une fenêtre
cv2.imshow('Image', image)
cv2.waitKey(0)
cv2.destroyAllWindows()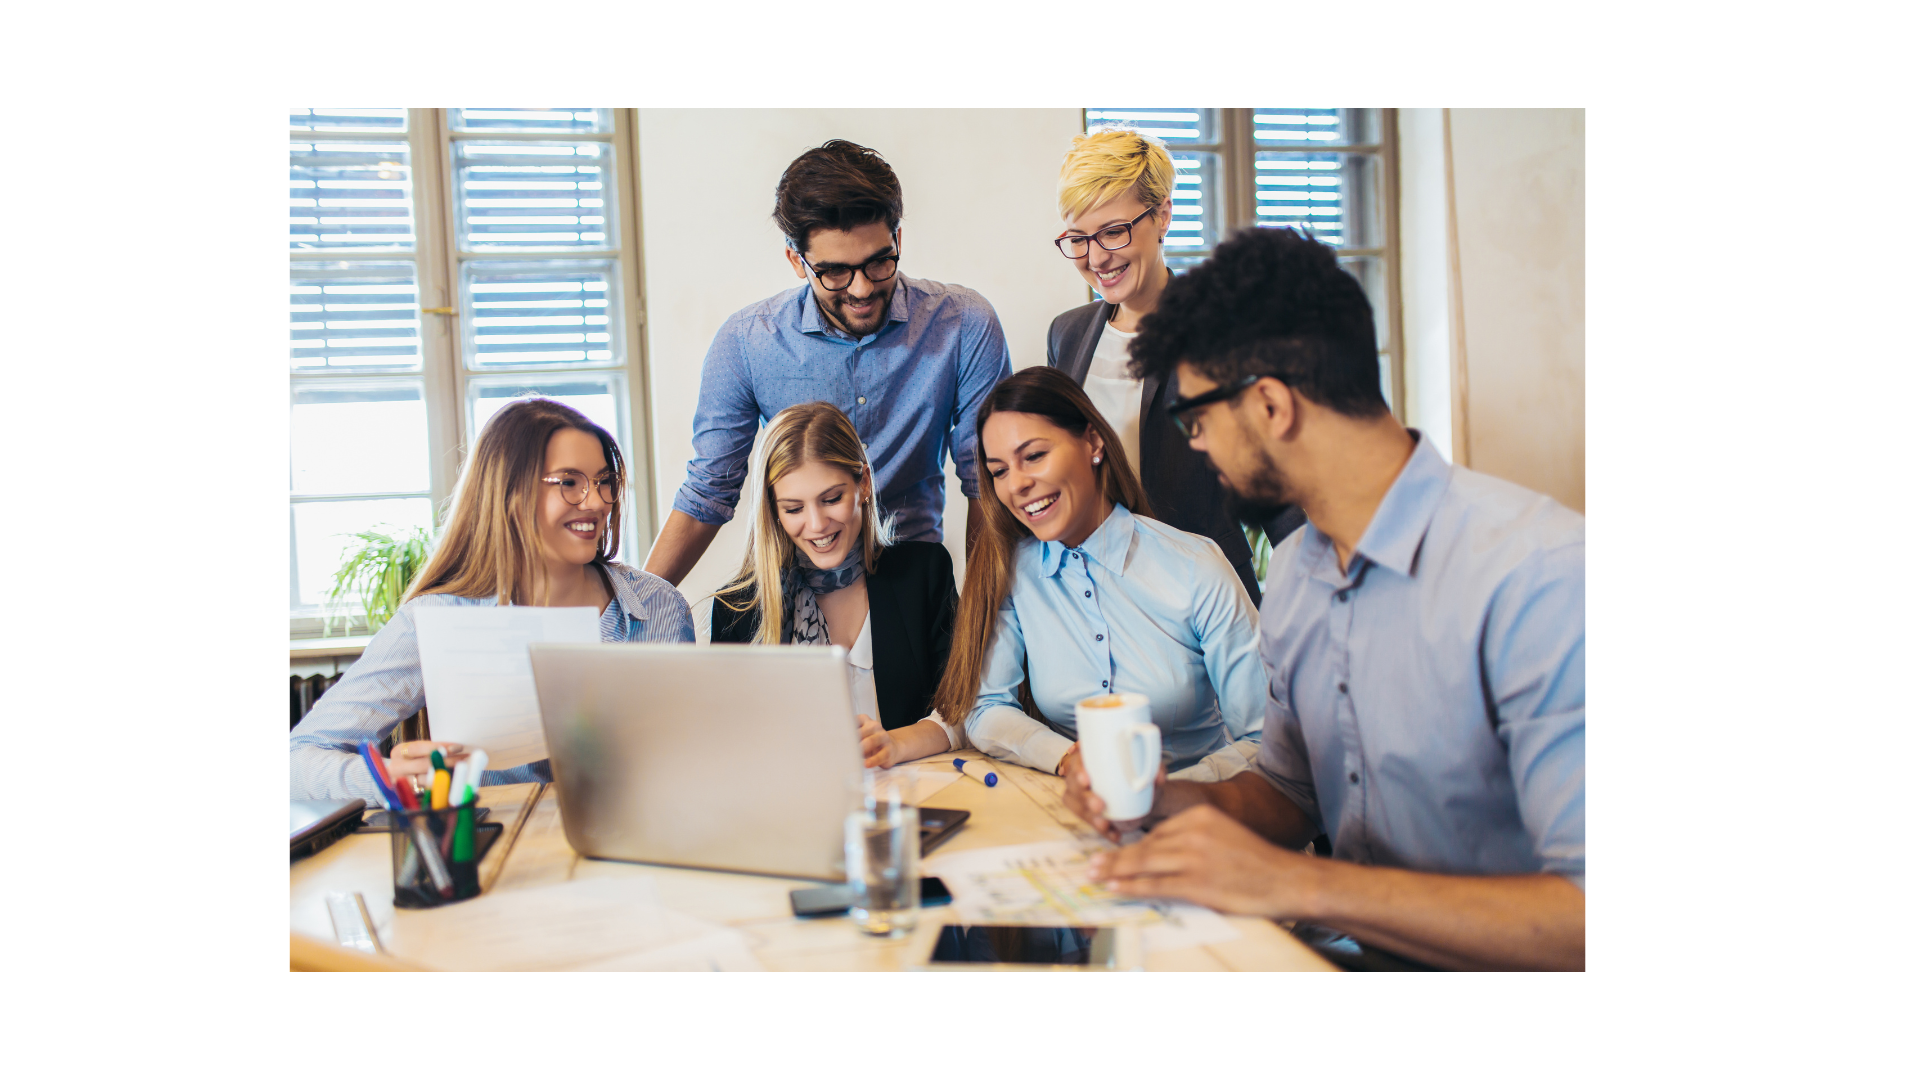
Employés de bureau autour d’un ordinateur portable. Source : Canva
Dans ce code, l’image est lue depuis un fichier grâce à « cv2.imread », puis affichée dans une fenêtre avec « imshow ». La fonction « cv2.waitKey(0) » garantit que la fenêtre reste ouverte jusqu’à ce que vous appuyiez sur une touche.
Le traitement d’images consiste à manipuler les pixels d’une image de façon à modifier l’apparence visuelle de l’image initiale, pour l’extraction de caractéristiques, l’analyse d’image ou d’autres tâches liées à la vision par ordinateur. Parmi les techniques courantes : traitement des couleurs, filtrage, segmentation, détection de contours, etc.
L’extrait de code ci-dessous illustre une technique simple de traitement sur l’image chargée précédemment : une conversion de couleurs en niveaux de gris. La conversion en niveaux de gris est une technique fondamentale qui ramène l’image à un seul canal d’intensité.
# Convertir une image en niveaux de gris
gray_image = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)

# Afficher l'image en niveaux de gris
cv2.imshow('Gray Image', gray_image)
cv2.waitKey(0)
cv2.destroyAllWindows()
Ici, cv2.cvtColor() convertit l’image chargée en niveaux de gris.
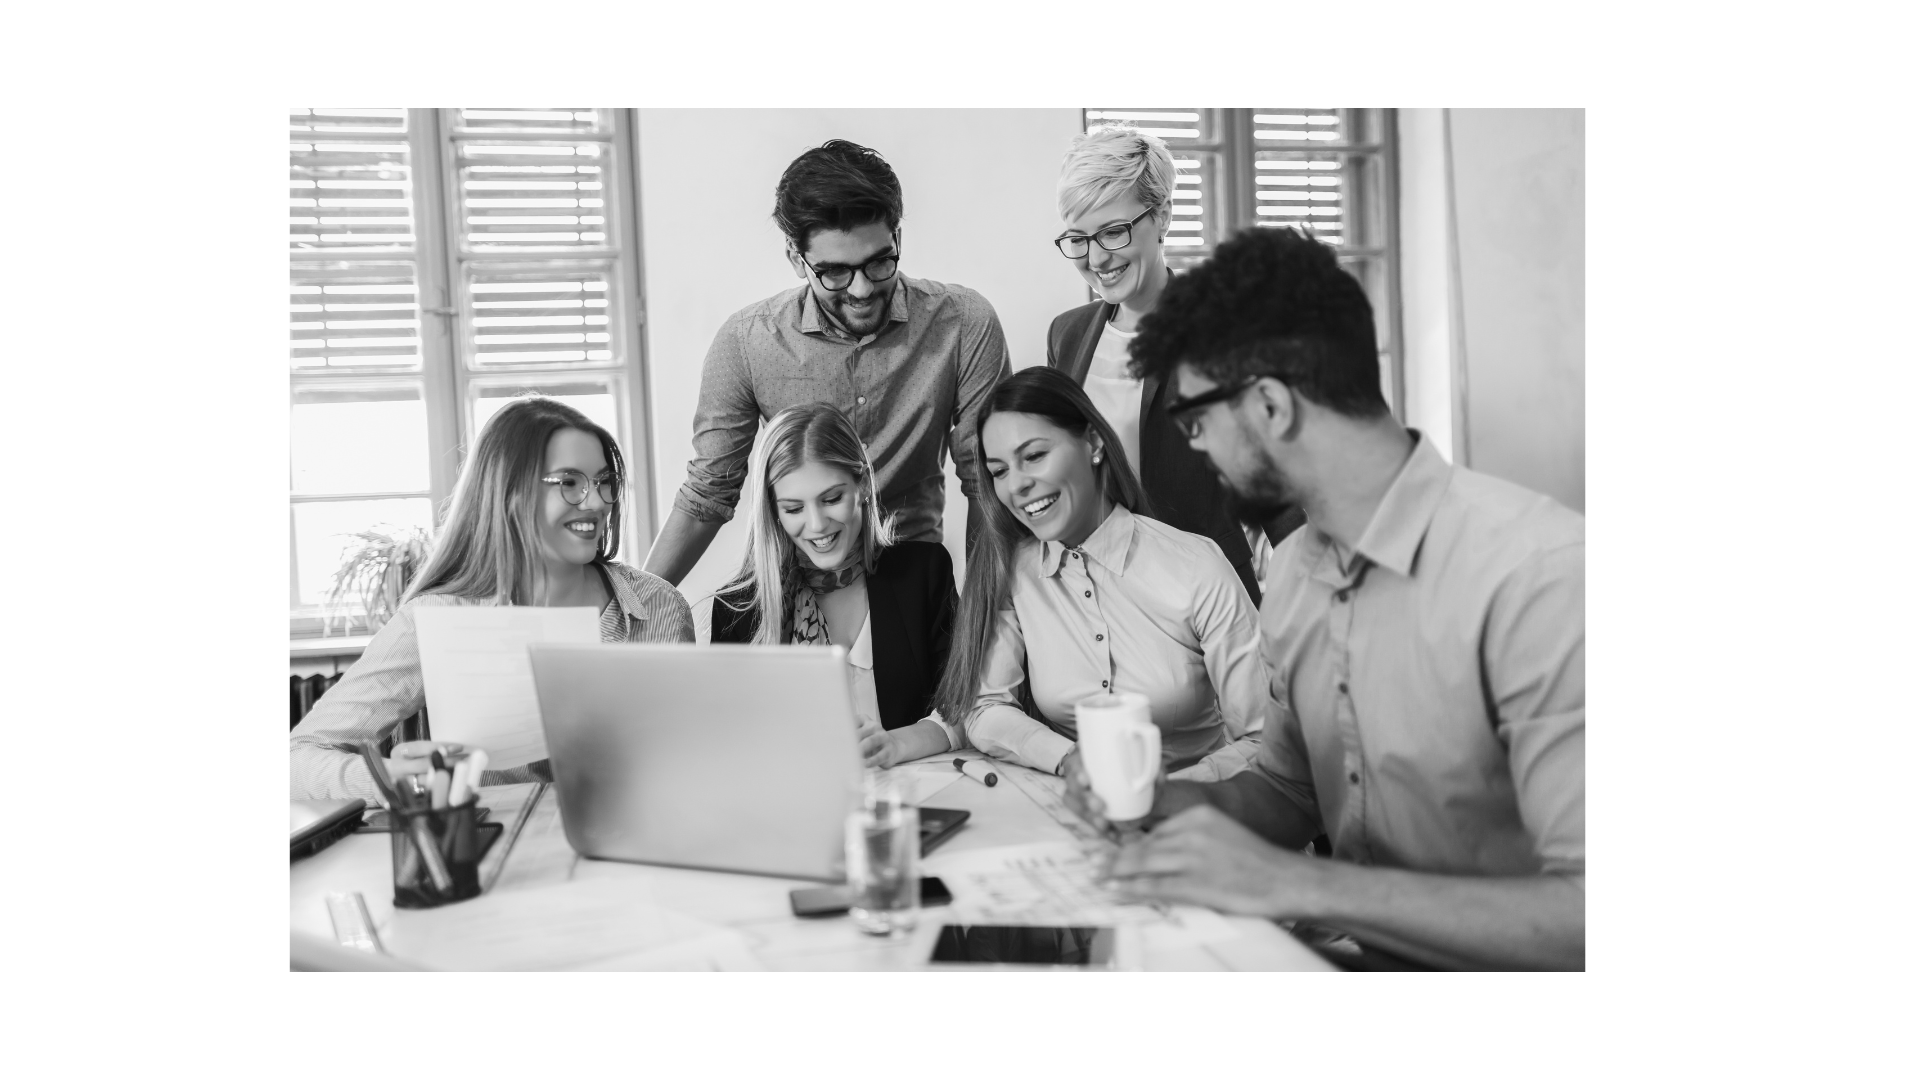
Employés de bureau autour d’un ordinateur portable (niveaux de gris). Source : Canva
La détection de contours est une technique fondamentale en traitement d’images et en vision par ordinateur. Elle identifie les points d’une image où la luminosité varie fortement ou présente des discontinuités. La détection des contours est essentielle pour repérer des caractéristiques dans les données d’image. Elle fonctionne généralement en détectant les changements brusques d’intensité des pixels. En reliant ces points de variation, on forme des lignes et des arêtes qui délimitent les objets de l’image.
Grâce aux algorithmes de détection de contours, il est possible de repérer des caractéristiques texturales et structurelles très fines des objets dans une image.
Plusieurs algorithmes existent, tels que le détecteur de Canny, la méthode de Sobel ou la méthode par logique floue, utilisés pour la reconnaissance d’objets, la segmentation d’images et l’extraction de caractéristiques. L’extrait de code suivant présente une détection de contours basique avec OpenCV :
# Appliquer la détection de contours de Canny (méthode simple)
edges = cv2.Canny(gray_image, 50, 150)

# Afficher l'image avec les contours détectés
cv2.imshow('Edges', edges)
cv2.waitKey(0)
cv2.destroyAllWindows()
L’algorithme de Canny est directement disponible dans OpenCV via la fonction « cv2.Canny() », qui détecte les contours d’objets sur l’image en niveaux de gris.
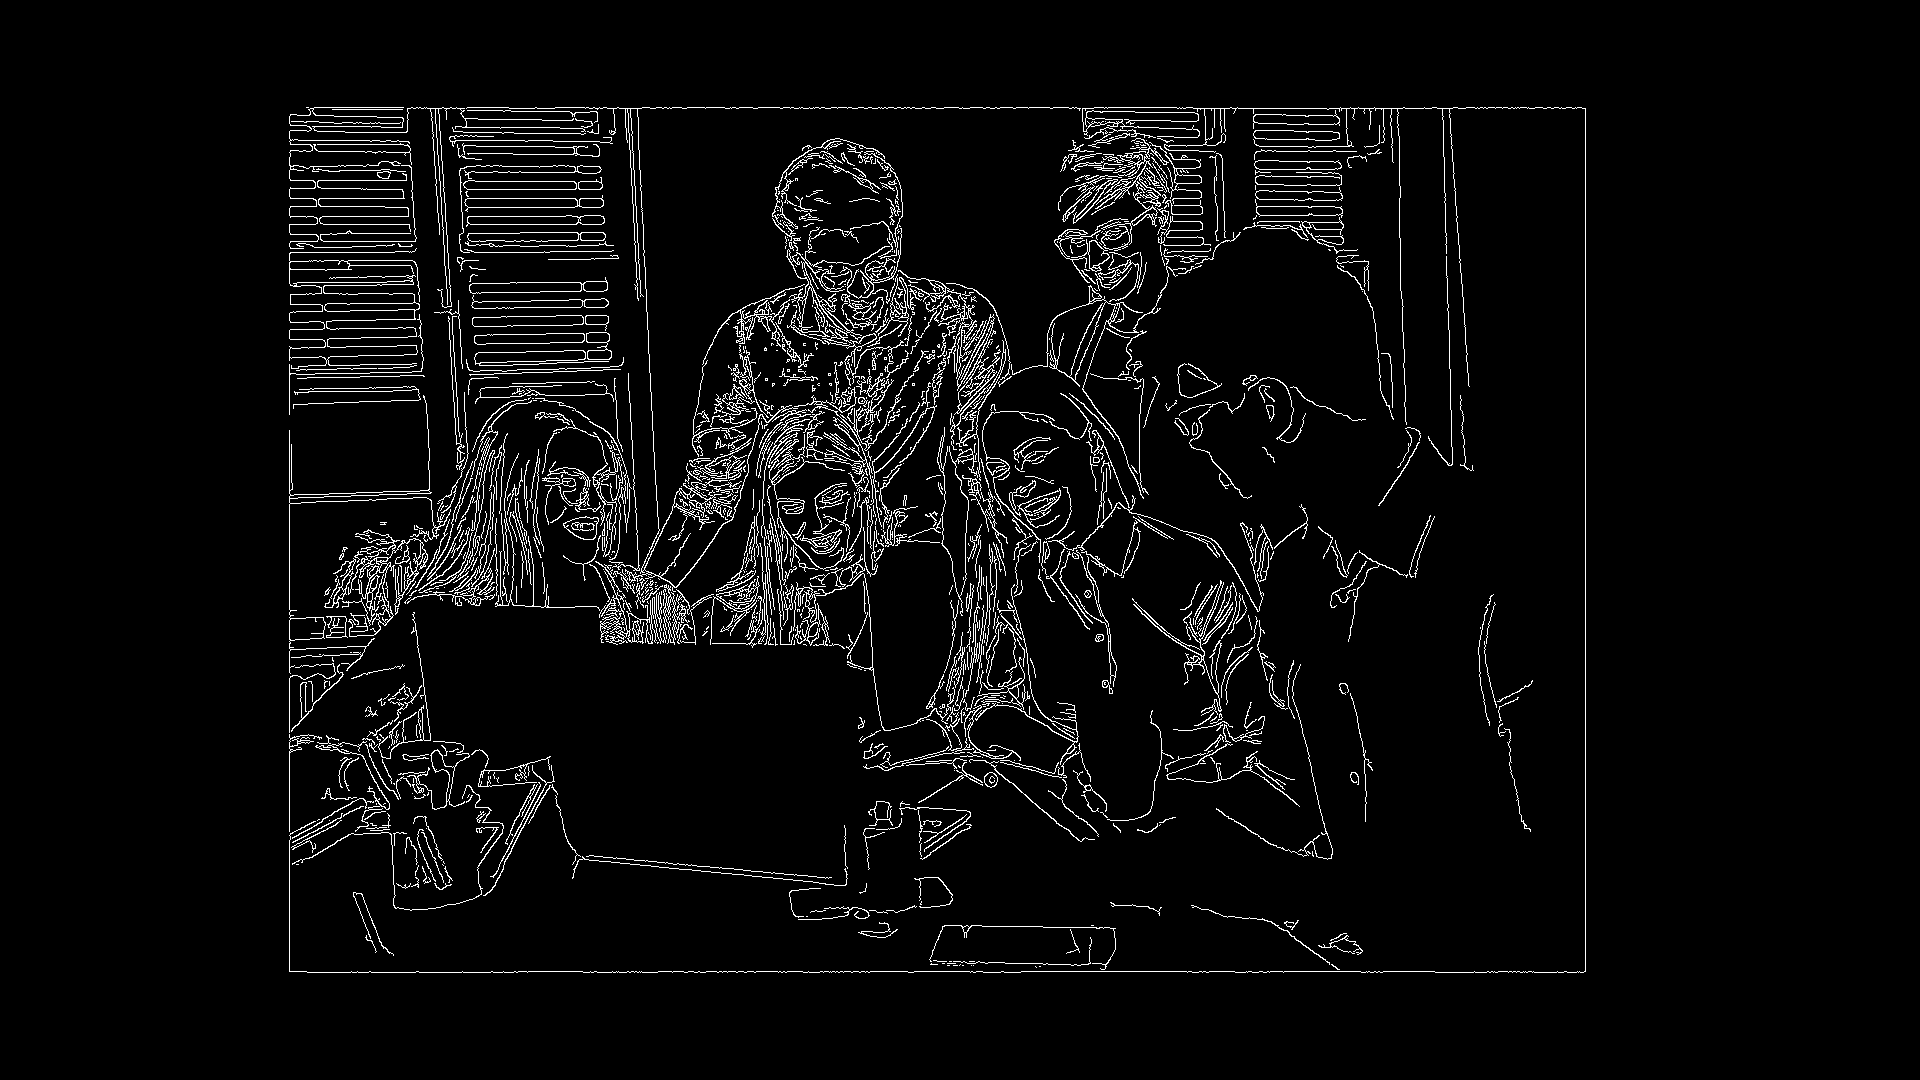
Employés de bureau autour d’un ordinateur portable (niveaux de gris). Source : Canva
Le redimensionnement et la rotation d’images sont des opérations de base en traitement d’images, car elles permettent d’adapter et de transformer des contenus visuels. Redimensionner consiste à modifier les dimensions d’une image, en l’agrandissant ou la réduisant, ce qui est indispensable pour l’intégration dans des contextes spécifiques.
La rotation ajuste l’angle d’affichage selon un angle donné. Ces deux opérations sont souvent utilisées en prétraitement d’images pour la vision par ordinateur, l’apprentissage automatique et les graphismes. Par exemple, lors de l’entraînement de réseaux de neurones profonds, la rotation et le redimensionnement font partie des techniques d’augmentation de données, afin d’accroître la variabilité du jeu d’entraînement et d’améliorer la capacité de généralisation sur des données inédites.
Pour redimensionner et faire pivoter des images avec OpenCV, utilisez le code suivant :
# Redimensionner l'image
resized_image = cv2.resize(image, (width, height))

# Faire pivoter l'image de 45 degrés
rotation_matrix = cv2.getRotationMatrix2D((width / 2, height / 2), 45, 1)
rotated_image = cv2.warpAffine(resized_image, rotation_matrix, (width, height))

# Afficher les images redimensionnée et pivotée
cv2.imshow('Resized Image', resized_image)
cv2.imshow('Rotated Image', rotated_image)
cv2.waitKey(0)
cv2.destroyAllWindows()
« cv2.resize » sert à redimensionner l’image, tandis que « cv2.getRotationMatrix2D » associé à « cv2.warpAffine » permet de la faire pivoter.
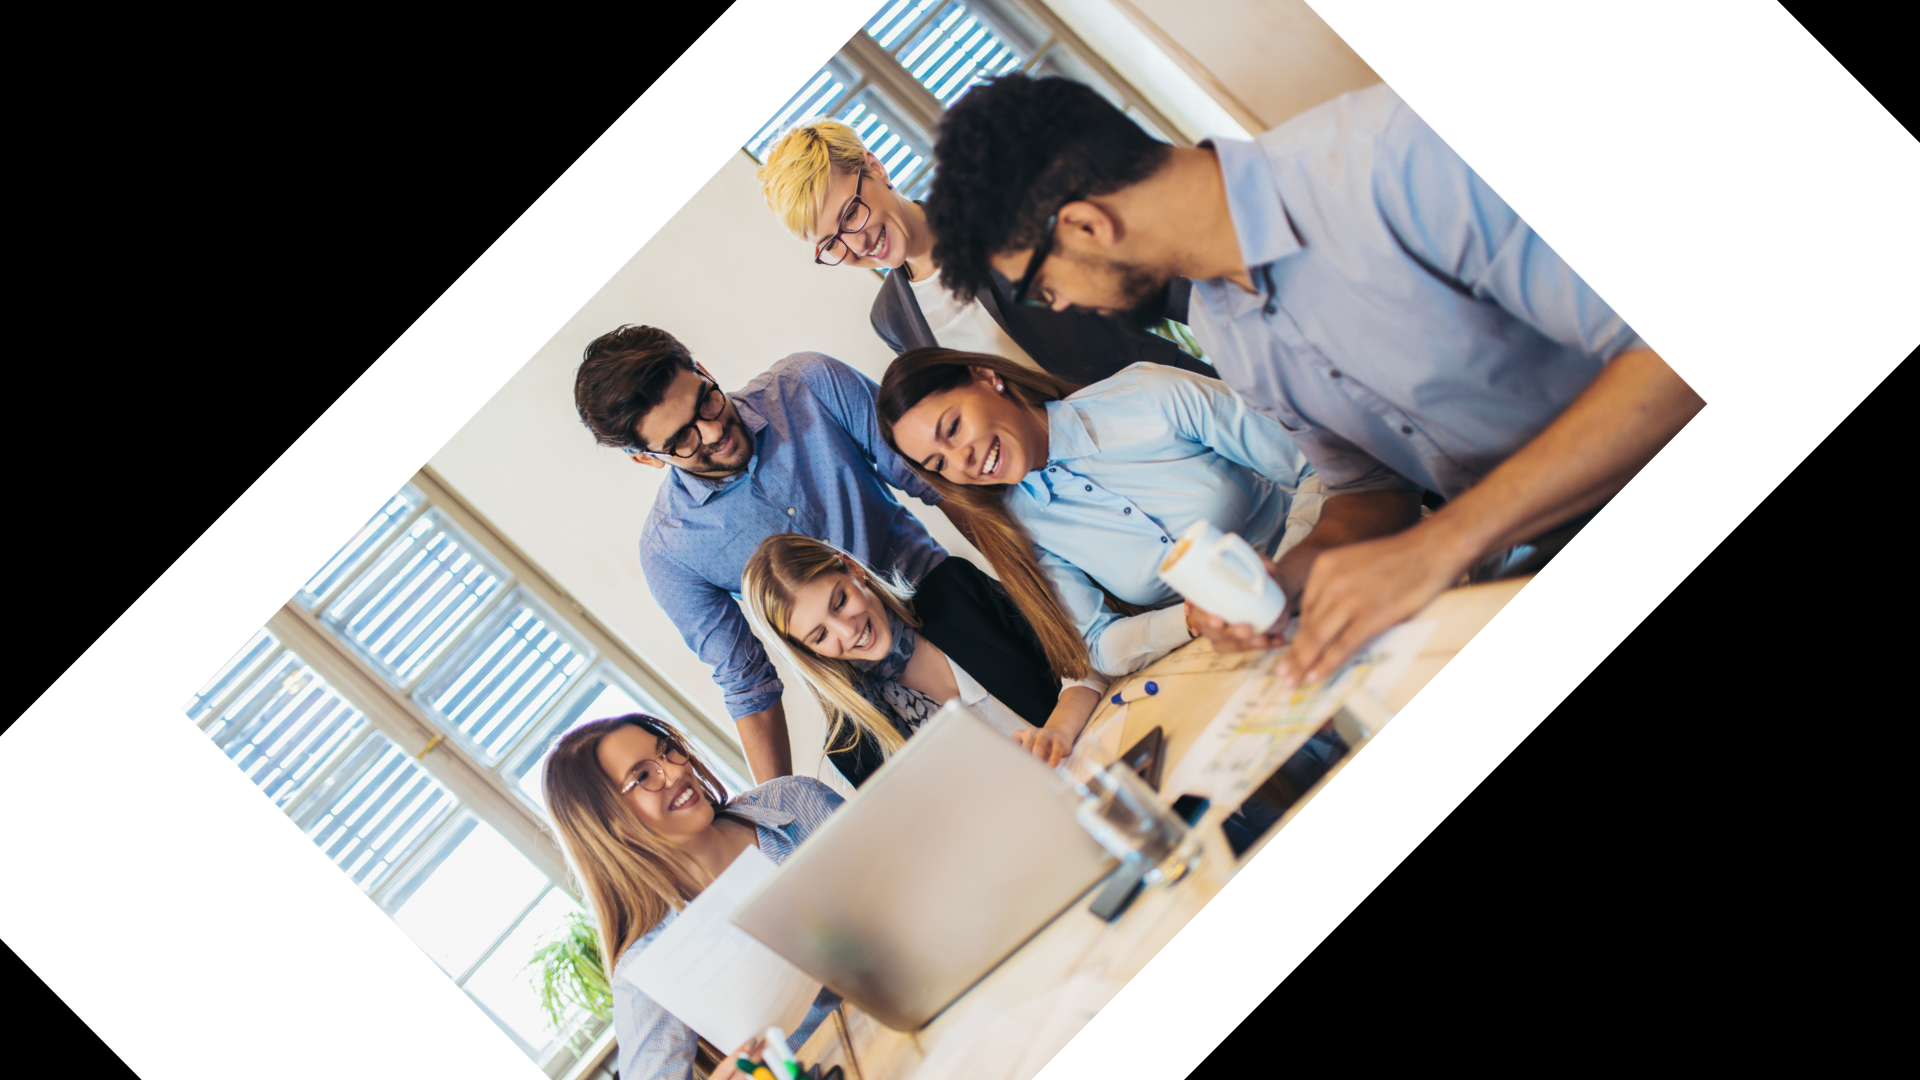
Employés de bureau autour d’un ordinateur portable (pivotée). Source : Canva
Une vidéo est une suite d’images présentées séquentiellement. En vision par ordinateur, les capacités de traitement vidéo sont essentielles pour développer des applications capables de traiter des données en temps réel comme des enregistrements. Contrairement aux images statiques, le traitement vidéo gère des séquences temporelles, ce qui permet d’analyser le mouvement, les changements au fil du temps et d’extraire des motifs temporels.
La nature dynamique du contenu vidéo exige des techniques efficaces, notamment pour des systèmes critiques comme la surveillance, la conduite autonome, la reconnaissance d’activités, et bien d’autres, où la compréhension des déplacements et des évolutions est primordiale.
Un avantage majeur d’OpenCV pour le traitement vidéo est la richesse de ses fonctionnalités dédiées à la gestion efficace des flux. OpenCV propose des outils de capture, de traitement et d’analyse vidéo, comme il le fait pour les images.
L’extrait de code suivant permet de charger et traiter une vidéo stockée localement :
import cv2

# Ouvrir un objet de capture vidéo
cap = cv2.VideoCapture("Your video's path.mp4")

# Vérifier si l'ouverture de la vidéo a réussi
if not cap.isOpened():
    print("Error: Couldnot open the video.")
    exit()

# Parcourir les frames de la vidéo
while True:
    # Lire une frame depuis la vidéo
    ret, frame = cap.read()

    # Sortir de la boucle si la vidéo est terminée
    if not ret:
        break

    # Afficher la frame originale
    cv2.imshow('Original Video', frame)

    gray_frame = cv2.cvtColor(frame, cv2.COLOR_BGR2GRAY)
    cv2.imshow('Black and White Video', gray_frame)

    # Effectuer la détection de contours sur la vidéo
    edges_frame = cv2.Canny(gray_frame, 50, 150)
    cv2.imshow('Edges Video', edges_frame)

    # Quitter la boucle si la touche 'q' est pressée
    if cv2.waitKey(25) & 0xFF == ord('q'):
        break

# Libérer l'objet de capture et fermer les fenêtres
cap.release()
cv2.destroyAllWindows()
Ici, la classe « cv2.VideoCapture » est utilisée pour accéder à un fichier vidéo et lire des images via sa méthode « cap.read ». Le script affiche d’abord la vidéo originale, puis la convertit en noir et blanc, et enfin applique une détection de contours à chaque image. La boucle s’exécute jusqu’à la fin de la vidéo ou jusqu’à ce qu’une entrée clavier demande l’arrêt. La fonction « cv2.waitKey(25) » introduit un court délai entre les images pour assurer une lecture fluide.
La détection d’objets est une tâche fondamentale de vision par ordinateur qui vise à détecter et localiser des objets dans une image ou une vidéo, puis à fournir des résultats de reconnaissance : une liste d’étiquettes détectées et leurs boîtes englobantes. La détection de personnes, variante de la reconnaissance d’objets, se concentre sur l’identification et la localisation des individus dans des contenus visuels.
Ses applications incluent la surveillance, la gestion de foules, le comptage, le suivi, l’interaction homme-machine et les environnements intelligents. En surveillance, cette technologie aide à repérer des activités suspectes ; en gestion de foule, elle soutient la reconnaissance de gestes et le suivi. La détection de personnes joue un rôle crucial dans l’interaction homme-machine et s’emploie aussi dans les environnements intelligents pour optimiser les ressources et renforcer la sécurité.
YOLO, acronyme de « You Only Look Once », s’est imposé comme un système couramment utilisé pour la reconnaissance d’objets en temps réel. Contrairement aux méthodes classiques, YOLO divise l’image en une grille de cellules et prédit simultanément les boîtes englobantes et les probabilités de classe pour chaque cellule.
Pour en savoir plus sur la détection d’objets avec YOLO, consultez notre guide détaillé.
Ci-dessous, un extrait de code utilisant OpenCV et Yolo pour détecter des personnes dans une image :
import cv2

net = cv2.dnn.readNet('yolov3.weights', 'yolov3.cfg')
layer_names = net.getUnconnectedOutLayersNames()

image = cv2.imread('image path.jpg')
height, width = image.shape[:2]

blob = cv2.dnn.blobFromImage(image, 1/255.0, (416, 416), swapRB=True, crop=False)
net.setInput(blob)
outs = net.forward(layer_names)

for out in outs:
    for detection in out:
        scores = detection[5:]
        class_id = np.argmax(scores)
        confidence = scores[class_id]

        if confidence > 0.5 and class_id == 0:  # Class ID for person
            box = detection[:4] * np.array([width, height, width, height])
            (x, y, w, h) = box.astype(int)
            cv2.rectangle(image, (x, y), (x + w, y + h), (0, 255, 0), 2)

cv2.imshow('Person Detection', image)
cv2.waitKey(0)
cv2.destroyAllWindows()La structure du code suit des principes similaires pour la détection de personnes dans une vidéo. Au lieu de traiter une image statique, le script ou l’application traite en continu les images de la vidéo.
Le principe d’identification des personnes est le même pour les images et les vidéos, la différence majeure tenant à la dimension temporelle. Sur image, il s’agit de reconnaître et de positionner des personnes sur un unique instantané.
Cette approche convient surtout aux captures de surveillance et autres photos non superposées. À l’inverse, sur vidéo, l’objectif est d’identifier et de suivre les individus au fil des images successives, ce que l’on appelle parfois le suivi d’objets en vidéo. L’aspect temporel est crucial pour analyser les mouvements et interactions humaines, faisant de la détection de personnes sur vidéo un outil central pour des applications en temps réel, notamment la sécurité, le suivi de foules et l’analyse de comportements.
Parmi les autres cas d’usage concrets : les villes intelligentes, l’analytique retail et la sécurité publique. Il existe néanmoins des considérations éthiques liées à la vie privée, au consentement et aux risques d’abus. Un déploiement responsable consiste à trouver le juste équilibre entre bénéfices et enjeux éthiques selon les domaines.
Ce tutoriel a présenté les bases de l’utilisation d’OpenCV pour diverses tâches de vision par ordinateur. Après l’installation d’OpenCV dans un environnement Python, nous avons vu comment charger et afficher des images, puis appliquer des techniques de traitement comme la conversion en niveaux de gris et la détection de contours. Globalement, il apparaît clairement qu’OpenCV peut réaliser des transformations et analyses d’images avancées, y compris l’application de traitements aux images d’une vidéo.
OpenCV joue un rôle déterminant en vision par ordinateur appliquée grâce à sa polyvalence et à la robustesse de ses fonctionnalités, permettant aux ingénieurs en vision et aux praticiens du machine learning de relever de nombreux défis liés au traitement des données visuelles. L’avantage majeur d’OpenCV est de simplifier l’application des algorithmes de vision et d’accélérer le passage de l’idée à l’implémentation opérationnelle.
Approfondissez les notions abordées dans cet article en explorant le traitement d’images en Python via un cours soigneusement conçu. Ce cours enrichit votre boîte à outils en traitement d’images et vision par ordinateur avec des bibliothèques supplémentaires comme Sci-kit Image et Numpy.
Commencez votre parcours Python dès aujourd’hui !
Cours
Cours
Cours