
Corso
Python - Livello Intermedio
4 ore
1.4M
OpenCV, acronimo di Open Source Computer Vision Library, è una solida libreria open source ampiamente adottata nei progetti di visione artificiale. OpenCV è progettata per offrire un framework integrato per la computer vision in tempo reale e funge da piattaforma che facilita numerose applicazioni di analisi di immagini e video.
La libreria OpenCV svolge un ruolo fondamentale nel permettere a sviluppatori e ricercatori di sfruttare i vantaggi dell'elaborazione dei dati visivi. Le sue funzionalità coprono varie applicazioni, dall'elaborazione di immagini di base a compiti più complessi come l'identificazione di oggetti e il riconoscimento facciale. Offrendo un'ampia raccolta di algoritmi, metodi e operazioni per l'elaborazione dei dati visivi, OpenCV facilita lo sviluppo di sistemi intelligenti in grado di riconoscere e classificare contenuti visivi.
Una delle applicazioni più rilevanti di OpenCV è il riconoscimento di oggetti, in cui i suoi algoritmi permettono di identificare e localizzare oggetti all'interno di immagini o flussi video. Questa capacità si estende anche ad altri compiti di visione artificiale, come il riconoscimento facciale, il tracciamento del movimento e il supporto a tecnologie di realtà aumentata.
In questo articolo esploriamo:
Per seguire questo tutorial su OpenCV ti serviranno una conoscenza intermedia di Python e una comprensione di base della visione artificiale. La familiarità con i principi dell'elaborazione delle immagini migliorerà inoltre l'esperienza di apprendimento lungo il tutorial, anche se i concetti chiave vengono definiti quando citati.
!pip install opencv-pythonSe stai usando Anaconda, puoi usare il seguente comando:
!conda install -c conda-forge opencvPer confermare che l'installazione sia andata a buon fine, esegui il seguente codice in un interprete Python o in un Jupyter Notebook:
import cv2
print(cv2.__version__)
Se l'installazione è riuscita, verrà stampato il numero di versione della libreria OpenCV installata. Se il numero di versione non viene stampato nel terminale o nella console, significa che il processo di installazione non è andato a buon fine.
Nota importante se usi Google Colab: Per adattare il codice alla visualizzazione delle immagini nei notebook di Google Colab, è necessario sostituire la tradizionale funzione cv2.imshow con cv2_imshow fornita dalle librerie specifiche di Google Colab. Questa modifica garantisce la compatibilità con l'ambiente Colab, che non supporta cv2.imshow. Per implementare il cambiamento, importa la funzione cv2_imshow dalle patch di Google Colab come segue:
from google.colab.patches import cv2_imshow

# Displaying an image in a window
cv2_imshow(image)
Lo snippet di codice seguente introduce un punto di partenza fondamentale per utilizzare la libreria OpenCV nell'elaborazione delle immagini. Caricare un'immagine in un ambiente di sviluppo è un'operazione condotta in contesti diversi, da semplici progetti di visione artificiale ad applicazioni di rilevamento di oggetti in tempo reale in produzione. Visualizzare un'immagine è altrettanto cruciale per osservare il contenuto di un'immagine o il risultato di un'elaborazione. Nel codice seguente, leggiamo un JPG da un file e lo visualizziamo con la libreria OpenCV.
Il seguente snippet di codice può essere usato per caricare e visualizzare immagini in OpenCV:
import cv2

# Loading image from a file
image = cv2.imread('your/image/path.jpg')

# Displaying an image in a window
cv2.imshow('Image', image)
cv2.waitKey(0)
cv2.destroyAllWindows()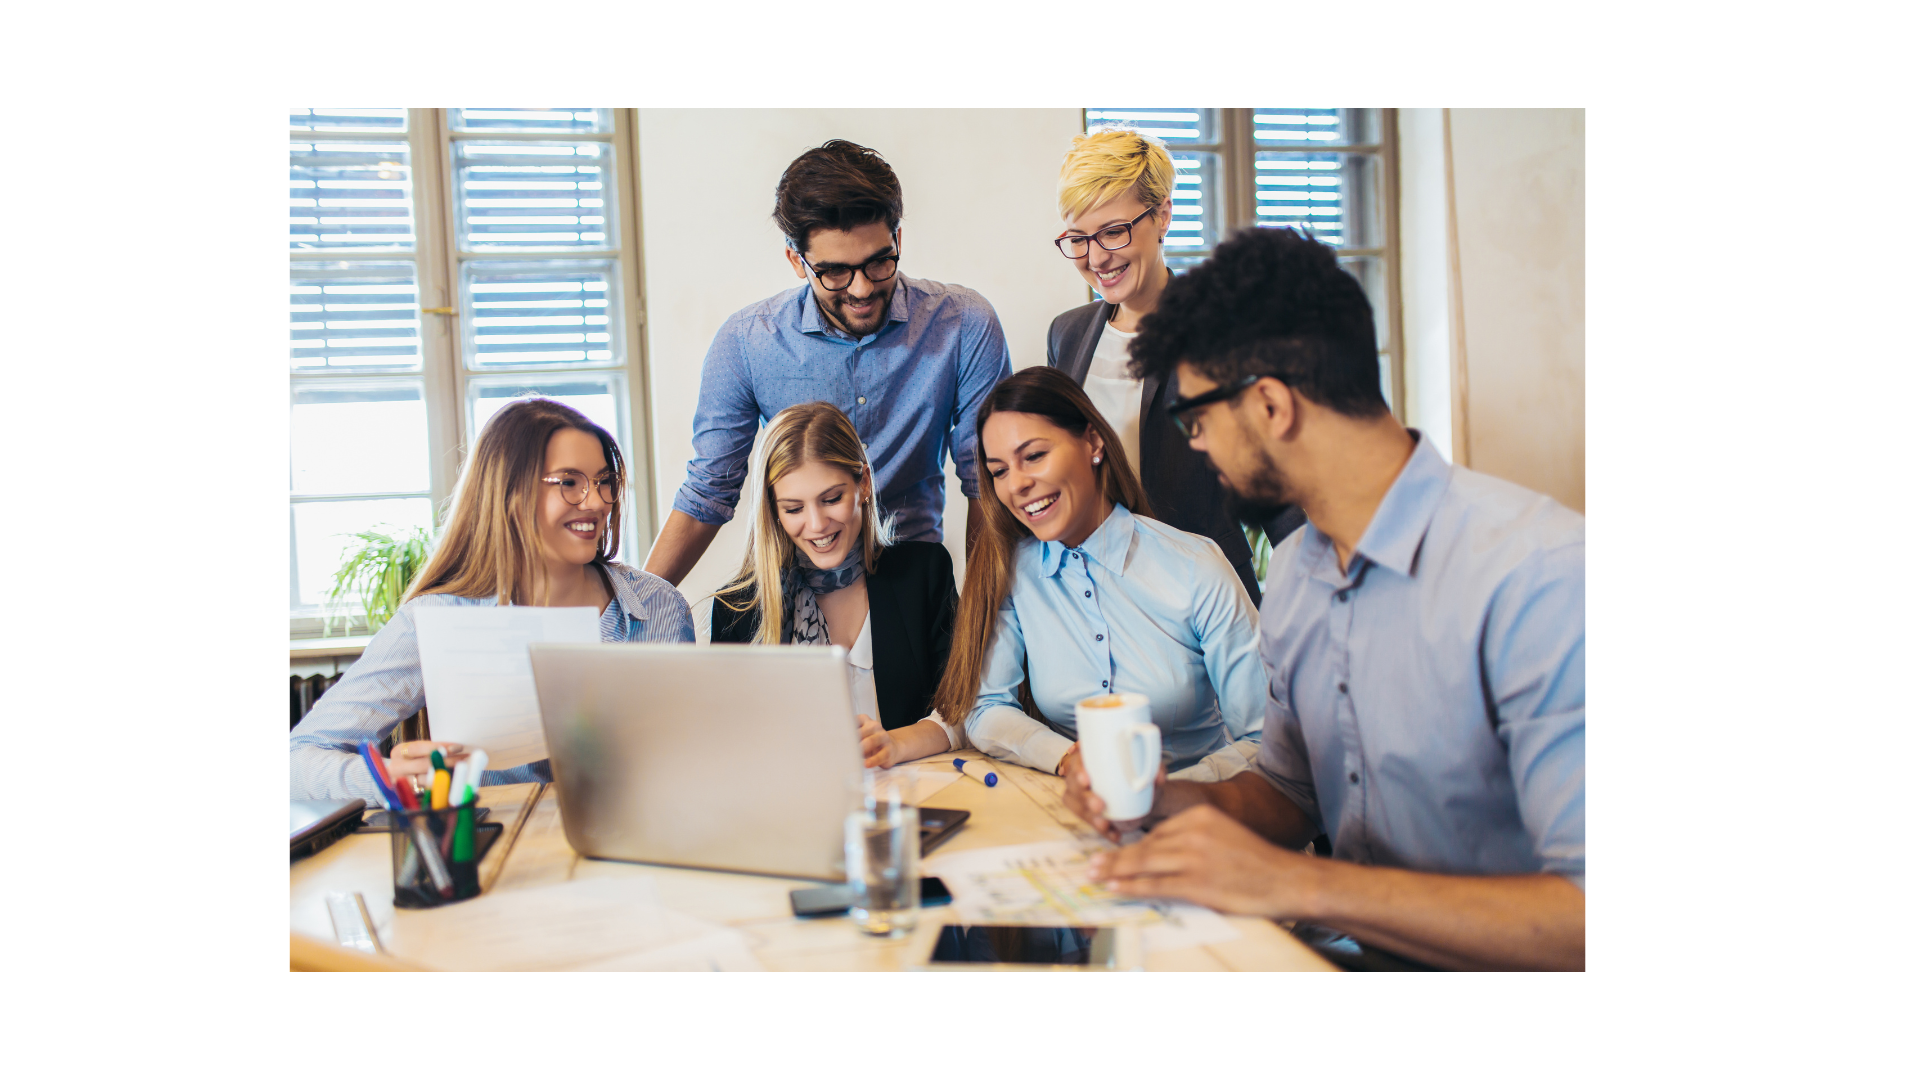
Impiegati d'ufficio attorno a un laptop. Fonte: Canva
In questo codice, l'immagine viene letta da un file usando «cv2.imread» e poi visualizzata in una finestra con l'aiuto di «imshow». La funzione «cv2.waitKey(0)» fa sì che la finestra rimanga aperta finché l'utente non la chiude premendo un tasto.
L'elaborazione delle immagini consiste nel manipolare i dati dei pixel in un'immagine in modo da modificarne l'aspetto visivo, per l'estrazione di caratteristiche, l'analisi delle immagini o altri compiti legati alla visione artificiale. Esempi di tecniche di elaborazione delle immagini sono l'elaborazione del colore, il filtraggio, la segmentazione, il rilevamento dei bordi, ecc.
Lo snippet di codice seguente mostra una semplice tecnica di elaborazione dell'immagine caricata nello snippet precedente. La tecnica mostrata qui è una semplice conversione dei colori, nello specifico una conversione in scala di grigi. La conversione in scala di grigi è una tecnica fondamentale nell'elaborazione delle immagini, che riduce l'immagine a un'unica banda di valori di intensità.
# Converting an image to grayscale form
gray_image = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)

# Displaying the grayscale image
cv2.imshow('Gray Image', gray_image)
cv2.waitKey(0)
cv2.destroyAllWindows()
Qui, cv2.cvtColor() converte l'immagine caricata in scala di grigi.
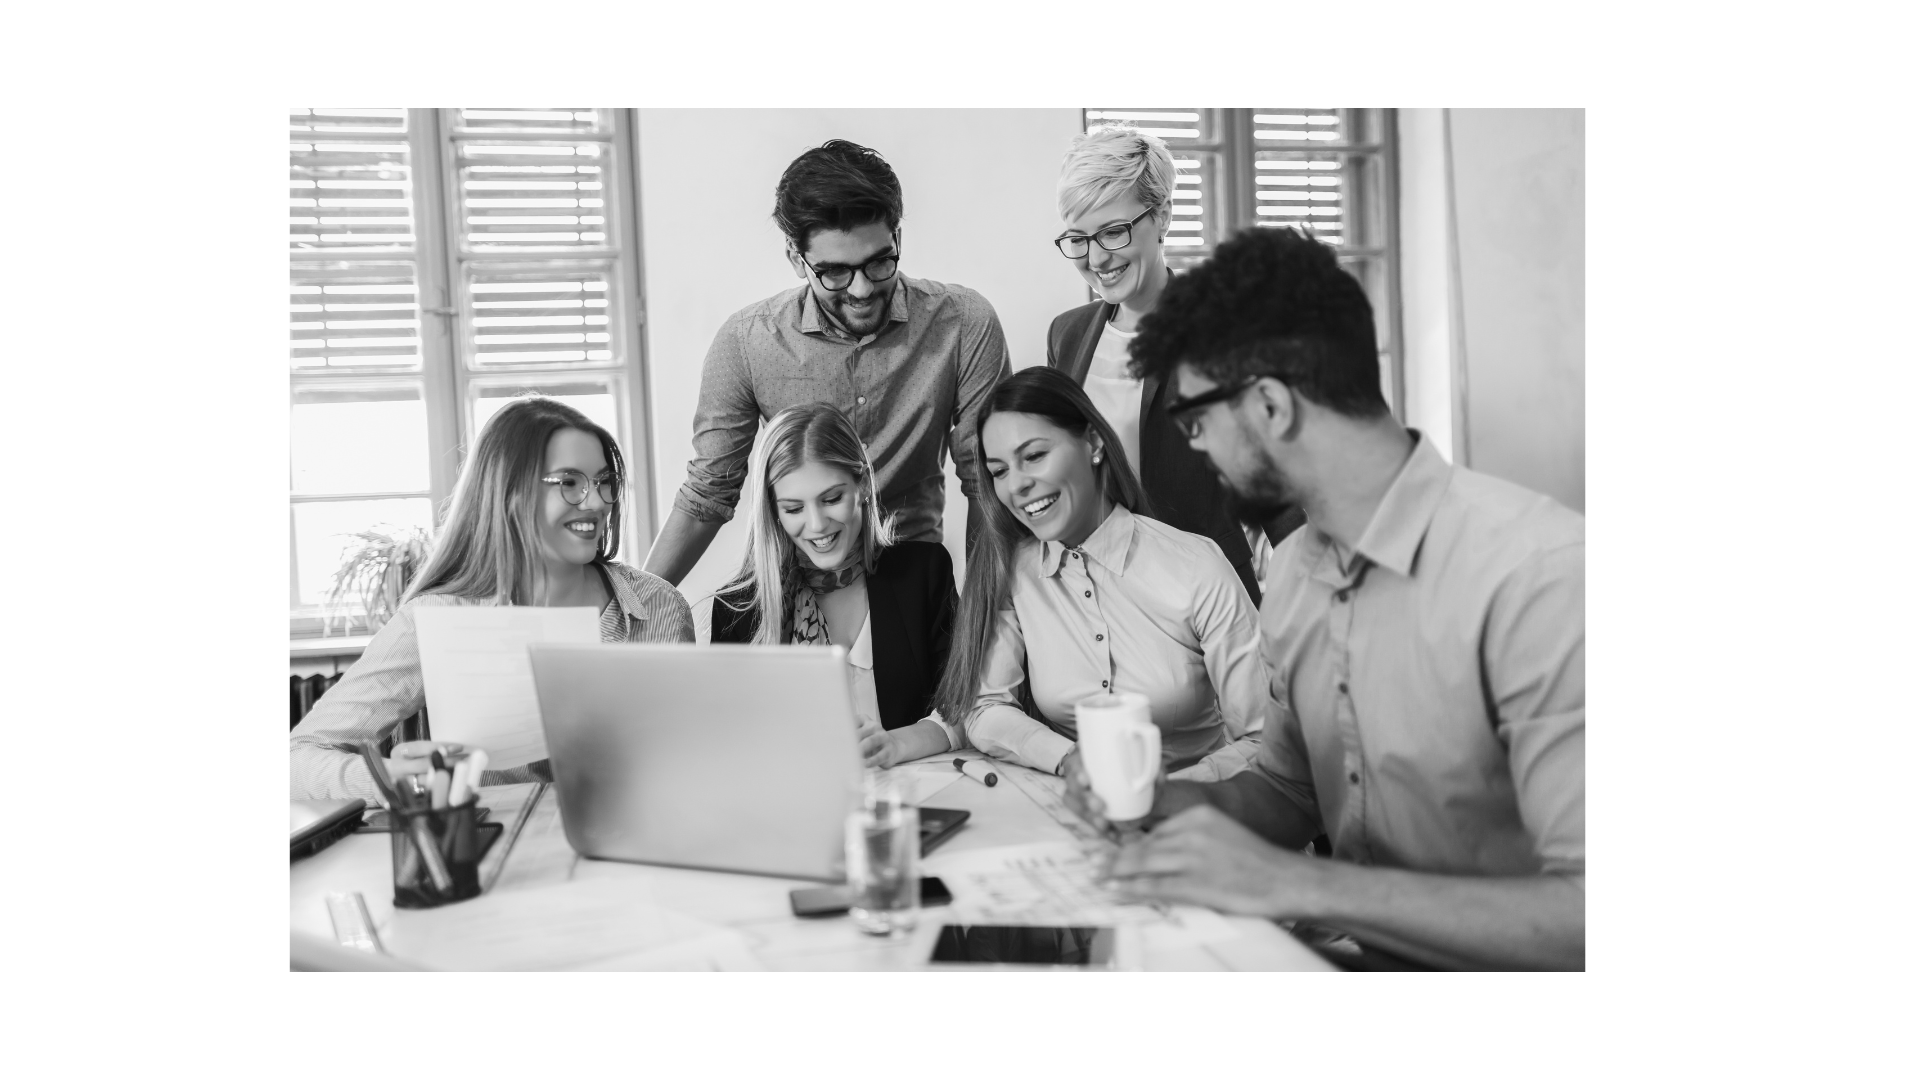
Impiegati d'ufficio attorno a un laptop (scala di grigi). Fonte: Canva
Il rilevamento dei bordi è una tecnica fondamentale nell'elaborazione delle immagini e nella visione artificiale. Identifica i punti in un'immagine in cui la luminosità cambia bruscamente o presenta discontinuità. Rilevare i bordi è essenziale nella visione artificiale, soprattutto quando si individuano caratteristiche all'interno dei dati di immagine. In generale, il rilevamento dei bordi funziona individuando bruschi cambiamenti nelle intensità dei pixel. Unendo questi punti di forte variazione di luminosità si formano linee e bordi che delineano gli oggetti in un'immagine.
Con gli algoritmi di rilevamento dei bordi, è possibile rilevare minuscole caratteristiche testurali e strutturali di un oggetto in un'immagine.
Diversi algoritmi di rilevamento dei bordi, come il Canny Edge Detector, il metodo di Sobel e il metodo della logica fuzzy, sono utilizzati nel riconoscimento di oggetti, nella segmentazione delle immagini e nell'estrazione di caratteristiche. Il seguente snippet di codice mostra un rilevamento dei bordi di base usando OpenCV:
# Applying Canny edge detection (a simple edge detection method)
edges = cv2.Canny(gray_image, 50, 150)

# Displaying the edge-detected image
cv2.imshow('Edges', edges)
cv2.waitKey(0)
cv2.destroyAllWindows()
L'algoritmo di rilevamento dei bordi Canny è reso facilmente disponibile nella libreria OpenCV tramite la funzione sottostante «cv2.Canny()» che si applica al rilevamento dei bordi di un oggetto per l'immagine in scala di grigi.
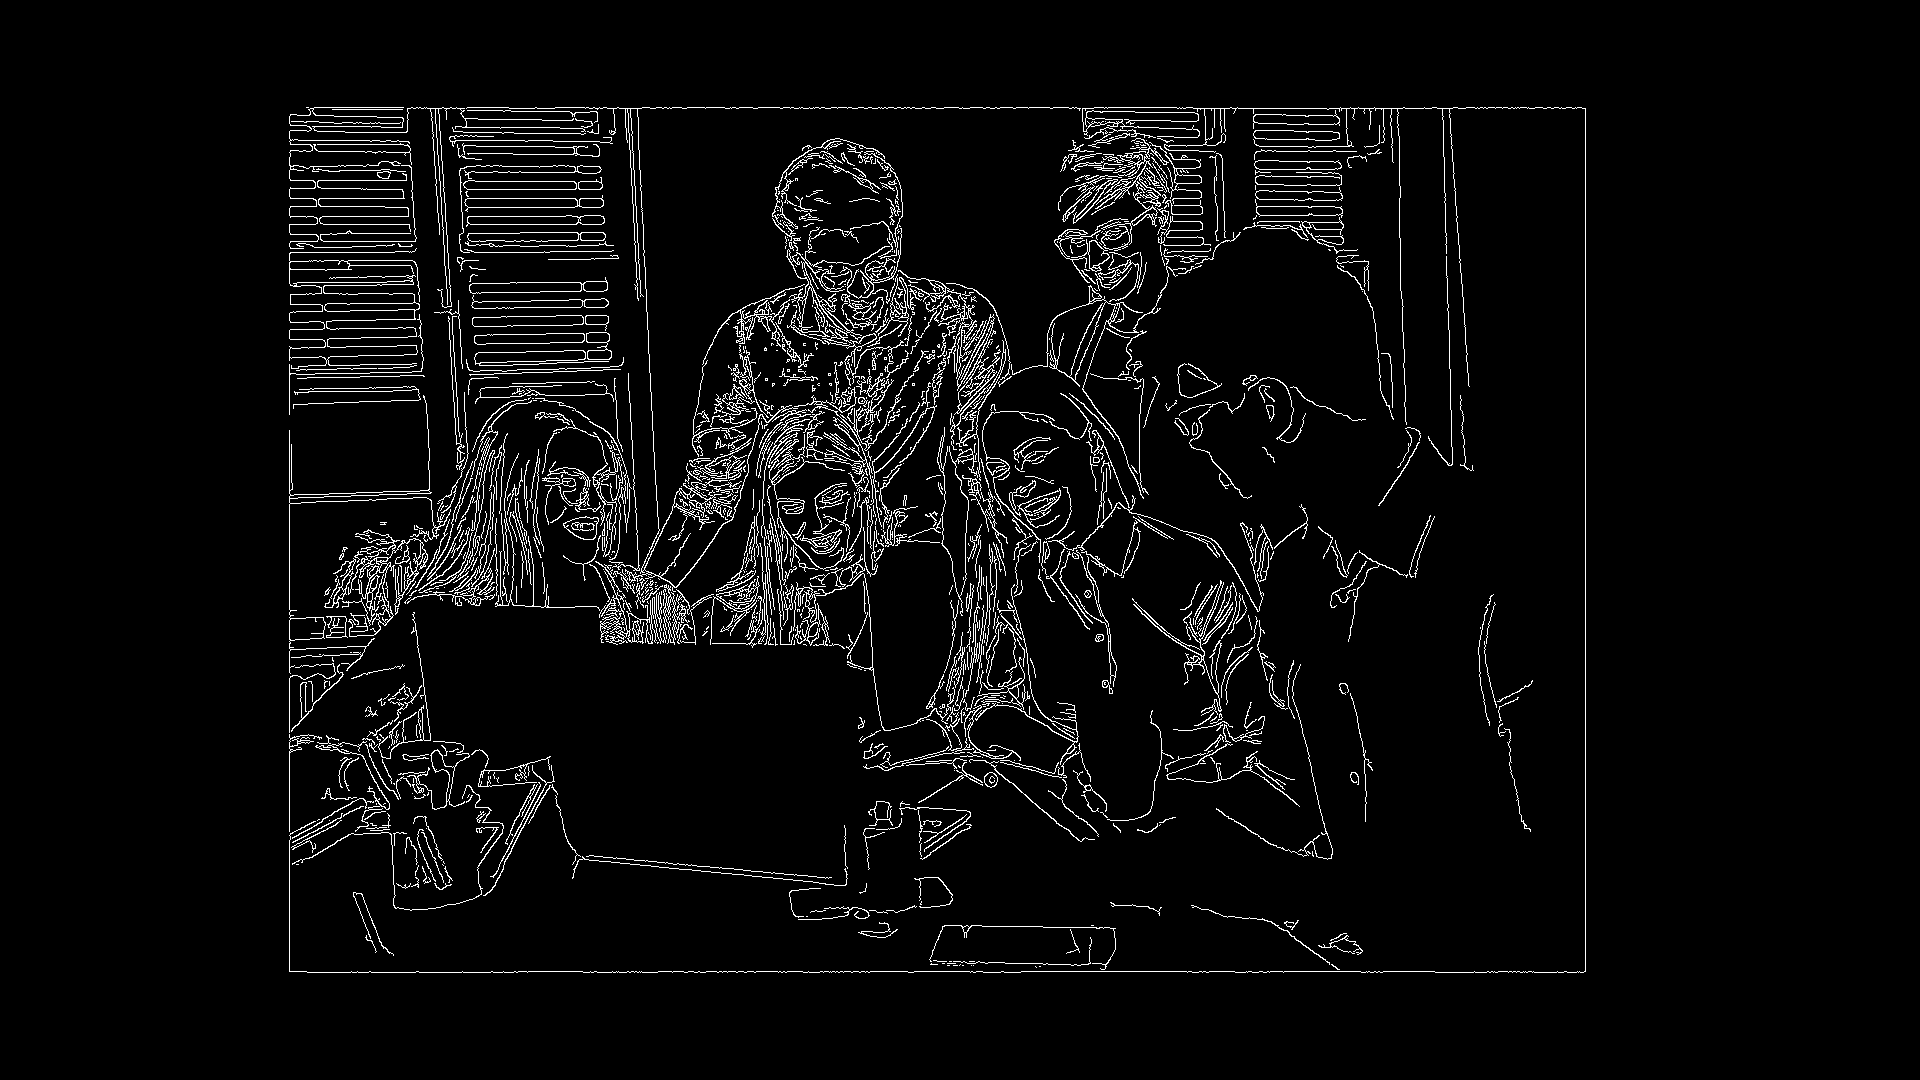
Impiegati d'ufficio attorno a un laptop (scala di grigi). Fonte: Canva
Ridimensionare e ruotare le immagini sono esigenze fondamentali nell'elaborazione delle immagini perché facilitano l'adattamento e la trasformazione dei contenuti visivi. Ridimensionare un'immagine significa cambiarne le dimensioni, ingrandendola o riducendola, ed è essenziale per scalare e posizionare le immagini in ambienti specifici.
La rotazione è un aggiustamento che modifica l'angolo con cui un'immagine viene vista rispetto a un angolo di rotazione specificato. Entrambe le operazioni sono comunemente applicate come passaggi di pre-elaborazione delle immagini per vari scopi, tra cui visione artificiale, machine learning e grafica. Ad esempio, nell'addestramento di reti neurali profonde, la rotazione e il ridimensionamento delle immagini sono tecniche di data augmentation utilizzate per aumentare la variabilità del dataset di addestramento fornito alle reti durante l'addestramento. L'obiettivo della data augmentation è addestrare la rete con un dataset sufficientemente vario da consentire una buona generalizzazione su dati mai visti.
Per ridimensionare e ruotare le immagini con OpenCV, puoi usare il seguente codice:
# Resizing the image
resized_image = cv2.resize(image, (width, height))

# Rotating the image by 45 degrees
rotation_matrix = cv2.getRotationMatrix2D((width / 2, height / 2), 45, 1)
rotated_image = cv2.warpAffine(resized_image, rotation_matrix, (width, height))

# Displaying the resized and rotated images
cv2.imshow('Resized Image', resized_image)
cv2.imshow('Rotated Image', rotated_image)
cv2.waitKey(0)
cv2.destroyAllWindows()
Mentre «cv2.resize» viene usato per ridimensionare l'immagine, «cv2.getRotationMatrix2D» insieme a «cv2.warpAffine» vengono entrambi usati per ruotare l'immagine.
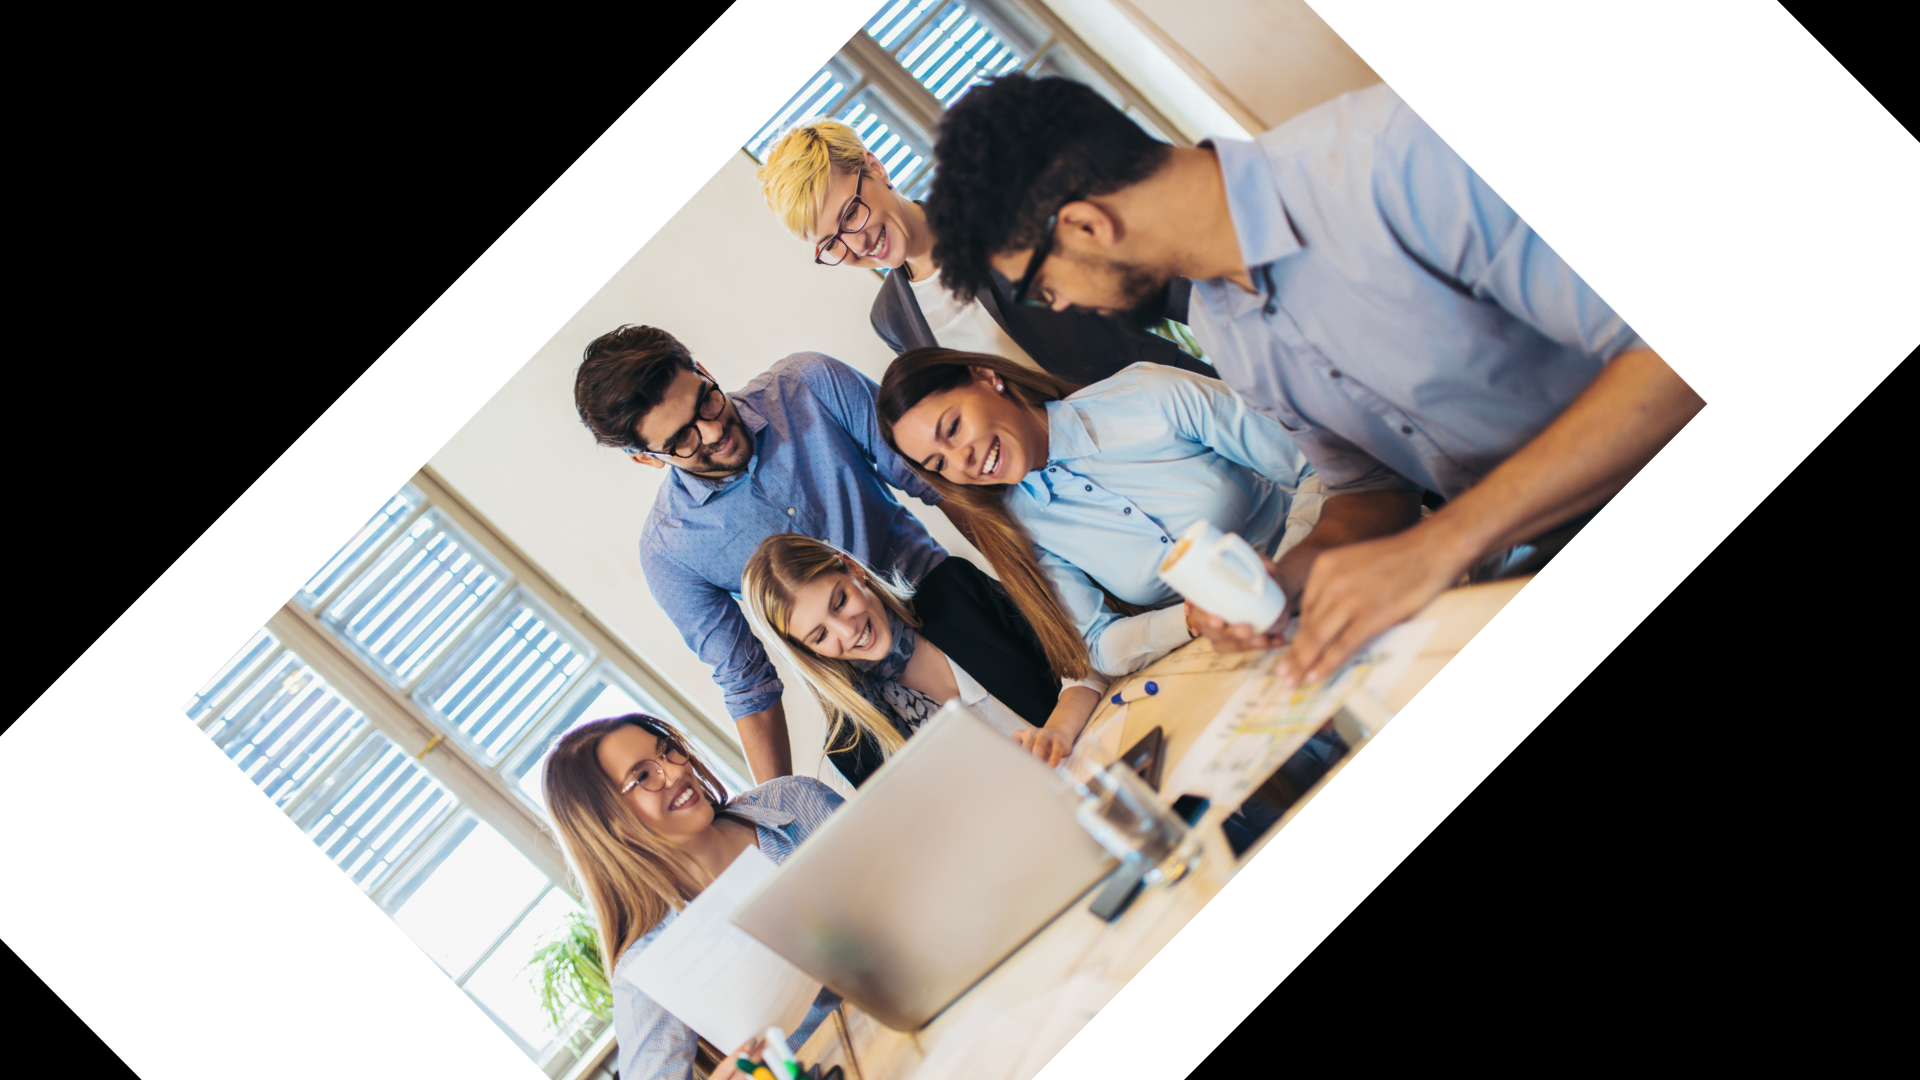
Impiegati d'ufficio attorno a un laptop (ruotata). Fonte: Canva
I video sono una sequenza di immagini presentate in successione. Nella visione artificiale, le capacità di elaborazione video sono cruciali per sviluppare e costruire applicazioni che elaborano dati in tempo reale e registrati. A differenza della natura statica delle immagini, l'elaborazione video gestisce sequenze temporali di immagini, consentendo l'analisi del movimento, dei cambiamenti nel tempo e l'estrazione di pattern temporali.
La natura dinamica dei contenuti nei dati video richiede che le tecniche di elaborazione video siano efficienti, specialmente in sistemi critici, ad esempio in applicazioni come sorveglianza, guida autonoma, riconoscimento di attività e molto altro, dove comprendere movimento e cambiamento è essenziale.
Un vantaggio significativo dell'uso di OpenCV per i compiti di elaborazione video è la disponibilità di una suite di funzionalità complete progettate per gestire i flussi video in modo efficiente. OpenCV fornisce strumenti di acquisizione, elaborazione e analisi video come fa con le immagini.
Il seguente snippet di codice può essere usato per caricare ed elaborare un video presente in locale:
import cv2

# Open a video capture object
cap = cv2.VideoCapture("Your video's path.mp4")

# To check if the video has opened successfully of not
if not cap.isOpened():
    print("Error: Couldnot open the video.")
    exit()

# Loop through the video frames
while True:
    # Reading a frame from the video
    ret, frame = cap.read()

    # Break the loop if the video has ended
    if not ret:
        break

    # Display the original frame
    cv2.imshow('Original Video', frame)

    gray_frame = cv2.cvtColor(frame, cv2.COLOR_BGR2GRAY)
    cv2.imshow('Black and White Video', gray_frame)

    # Perform edge detection on the video
    edges_frame = cv2.Canny(gray_frame, 50, 150)
    cv2.imshow('Edges Video', edges_frame)

    # Break the loop if 'q' key is pressed
    if cv2.waitKey(25) & 0xFF == ord('q'):
        break

# Release the video capture object and close all windows
cap.release()
cv2.destroyAllWindows()
In questo codice, la classe «cv2.VideoCapture» viene usata per accedere a un file video e leggere i frame tramite il metodo «cap.read». Mostra prima il video originale, poi lo converte in bianco e nero e infine esegue il rilevamento dei bordi per ogni frame. Il ciclo continua finché il video non termina o finché non arriva l'input da tastiera per uscire. «cv2.waitKey(25)» consente un breve ritardo tra i frame per visualizzarli, garantendo una riproduzione fluida.
Il rilevamento di oggetti è un compito fondamentale della visione artificiale che mira a individuare e localizzare oggetti in un'immagine o in un video e a fornire risultati di riconoscimento – un elenco di etichette di classe rilevate e relative bounding box. Il rilevamento di persone, una variante del riconoscimento di oggetti, si concentra sull'identificazione e la localizzazione delle persone all'interno di informazioni visive.
Le applicazioni del rilevamento di persone includono sorveglianza, gestione delle folle, conteggio delle persone, tracciamento, interazione uomo-computer e ambienti smart. Nella sorveglianza, questa tecnologia aiuta a rilevare attività sospette, mentre nella gestione delle folle supporta il riconoscimento dei gesti e il tracciamento. Il rilevamento di persone svolge un ruolo cruciale nell'interazione uomo-computer ed è impiegato anche in ambienti smart per l'ottimizzazione delle risorse e una maggiore sicurezza.
YOLO, acronimo di "You Only Look Once", è emerso come un sistema comunemente utilizzato che raggiunge in modo efficiente il riconoscimento di oggetti in tempo reale. A differenza dei metodi classici di rilevamento degli oggetti, YOLO divide l'immagine in una griglia di celle, prevedendo simultaneamente bounding box e probabilità di classe per ciascuna cella.
Puoi approfondire il rilevamento oggetti con YOLO nella nostra guida completa.
Di seguito trovi uno snippet di codice che usa OpenCV e Yolo per il rilevamento di persone in un'immagine:
import cv2

net = cv2.dnn.readNet('yolov3.weights', 'yolov3.cfg')
layer_names = net.getUnconnectedOutLayersNames()

image = cv2.imread('image path.jpg')
height, width = image.shape[:2]

blob = cv2.dnn.blobFromImage(image, 1/255.0, (416, 416), swapRB=True, crop=False)
net.setInput(blob)
outs = net.forward(layer_names)

for out in outs:
    for detection in out:
        scores = detection[5:]
        class_id = np.argmax(scores)
        confidence = scores[class_id]

        if confidence > 0.5 and class_id == 0:  # Class ID for person
            box = detection[:4] * np.array([width, height, width, height])
            (x, y, w, h) = box.astype(int)
            cv2.rectangle(image, (x, y), (x + w, y + h), (0, 255, 0), 2)

cv2.imshow('Person Detection', image)
cv2.waitKey(0)
cv2.destroyAllWindows()In modo analogo, la struttura del codice segue principi simili per il rilevamento di persone in un video. Invece di elaborare una singola immagine statica, lo script o l'applicazione elabora continuamente i frame del video.
Lo stesso principio è alla base dell'identificazione delle persone sia nelle immagini sia nelle clip video, con la principale differenza rappresentata dal fattore tempo. Con le immagini, il compito consiste nel riconoscere e posizionare le persone in singoli frame statici.
Questa applicazione è più adatta a istantanee di sorveglianza e ad altre fotografie non sovrapposte. Al contrario, con i video l'obiettivo è identificare e tracciare gli individui mentre si spostano nei frame successivi. Questo viene talvolta chiamato tracciamento di oggetti nei video. L'aspetto temporale è cruciale quando si considerano i movimenti e le interazioni umane nel tempo, rendendo il rilevamento di persone basato su video uno strumento fondamentale per applicazioni in tempo reale, tra cui sorveglianza di sicurezza, monitoraggio delle folle e analisi dei comportamenti.
Altri casi d'uso reali del rilevamento di persone includono smart city, analisi retail e sicurezza pubblica. Tuttavia, ci sono considerazioni etiche legate a privacy, consenso e uso improprio della tecnologia. Un'implementazione responsabile nei vari domini si ottiene bilanciando vantaggi e preoccupazioni etiche.
Questo tutorial ha mostrato gli aspetti fondamentali del lavoro con la libreria OpenCV per vari compiti di visione artificiale. Partendo dalle basi, ha illustrato come installare OpenCV in un ambiente Python. Sono state presentate le operazioni di OpenCV per il caricamento e la visualizzazione di immagini insieme a tecniche di elaborazione come la conversione in scala di grigi e l'applicazione del rilevamento dei bordi. Nel complesso, è chiaro che OpenCV può eseguire sofisticate trasformazioni e analisi delle immagini, incluse l'applicazione di tecniche di elaborazione ai frame video.
In particolare, OpenCV svolge un ruolo cruciale nella visione artificiale applicata poiché offre versatilità e robuste capacità, permettendo a ingegneri della visione artificiale e professionisti del machine learning di affrontare molte sfide legate all'elaborazione dei dati visivi. Il vantaggio chiave dell'utilizzo della libreria OpenCV è che semplifica l'applicazione degli algoritmi di visione artificiale e trasforma in modo efficiente i concetti applicativi in implementazioni pratiche.
Migliora la tua comprensione dei concetti trattati in questo articolo approfondendo l'elaborazione delle immagini in Python con un corso ben curato. Questo corso amplia la tua cassetta degli attrezzi per l'elaborazione delle immagini e la visione artificiale con librerie aggiuntive come Sci-kit Image e Numpy.
Inizia oggi il tuo percorso con Python!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



