
Kurs
Python für Fortgeschrittene
4 Std.
1.4M
OpenCV, die Open Source Computer Vision Library, ist eine leistungsstarke Open-Source-Bibliothek, die in Computer-Vision-Projekten weit verbreitet ist. OpenCV bietet ein integriertes Framework für Echtzeit-Computervision und dient als Plattform für zahlreiche Anwendungen der Bild- und Videoanalyse.
Die OpenCV-Bibliothek spielt eine zentrale Rolle dabei, Entwicklerinnen und Entwicklern sowie Forschenden die Vorteile der visuellen Datenverarbeitung zugänglich zu machen. Ihre Funktionen decken ein breites Spektrum ab – von grundlegender Bildverarbeitung bis hin zu komplexen Aufgaben wie Objekterkennung und Gesichtserkennung. Dank einer umfangreichen Sammlung an Algorithmen, Methoden und Bildverarbeitungsoperationen erleichtert OpenCV die Entwicklung intelligenter Systeme, die visuelle Inhalte erkennen und klassifizieren können.
Eine besonders wichtige Anwendung von OpenCV ist die Objekterkennung, bei der Algorithmen Objekte in Bildern oder Videostreams identifizieren und lokalisieren. Diese Fähigkeit erstreckt sich auch auf andere Computer-Vision-Aufgaben wie Gesichtserkennung, Bewegungserkennung und die Unterstützung von Augmented-Reality-Technologien.
In diesem Artikel behandeln wir:
Für dieses OpenCV-Tutorial solltest du über mittlere Python-Kenntnisse und ein grundlegendes Verständnis von Computer Vision verfügen. Vertrautheit mit Prinzipien der Bildverarbeitung verbessert das Lernerlebnis zusätzlich – zentrale Konzepte werden im Verlauf dennoch erläutert.
!pip install opencv-pythonWenn du Anaconda verwendest, kannst du stattdessen diesen Befehl nutzen:
!conda install -c conda-forge opencvUm die erfolgreiche Installation zu prüfen, führe den folgenden Code in einem Python-Interpreter oder Jupyter Notebook aus:
import cv2
print(cv2.__version__)
Bei erfolgreicher Installation wird die Versionsnummer der installierten OpenCV-Bibliothek ausgegeben. Erscheint keine Versionsnummer im Terminal oder in der Konsole, war die Installation nicht erfolgreich.
Wichtiger Hinweis für Google Colab: Damit Bilder in Google-Colab-Notebooks angezeigt werden, musst du die klassische Funktion cv2.imshow durch cv2_imshow aus den spezifischen Colab-Bibliotheken ersetzen. Das stellt die Kompatibilität mit Colab sicher, da cv2.imshow dort nicht unterstützt wird. Importiere dazu die Funktion cv2_imshow wie folgt aus den Colab-Patches:
from google.colab.patches import cv2_imshow

# Anzeige eines Bildes in einem Fenster
cv2_imshow(image)
Der folgende Codeschnipsel zeigt den grundlegenden Einstieg in die Nutzung von OpenCV für die Bildverarbeitung. Das Laden eines Bildes in die Entwicklungsumgebung ist in vielen Szenarien gefragt – von einfachen Computer-Vision-Projekten bis zu komplexen Echtzeit-Objekterkennungen in der Produktion. Auch das Anzeigen eines Bildes ist wichtig, um Inhalte oder Verarbeitungsergebnisse zu prüfen. Im folgenden Beispiel lesen wir eine JPG-Datei ein und zeigen sie mit OpenCV an.
Mit diesem Code kannst du in OpenCV Bilder laden und anzeigen:
import cv2

# Bild aus einer Datei laden
image = cv2.imread('your/image/path.jpg')

# Bild in einem Fenster anzeigen
cv2.imshow('Image', image)
cv2.waitKey(0)
cv2.destroyAllWindows()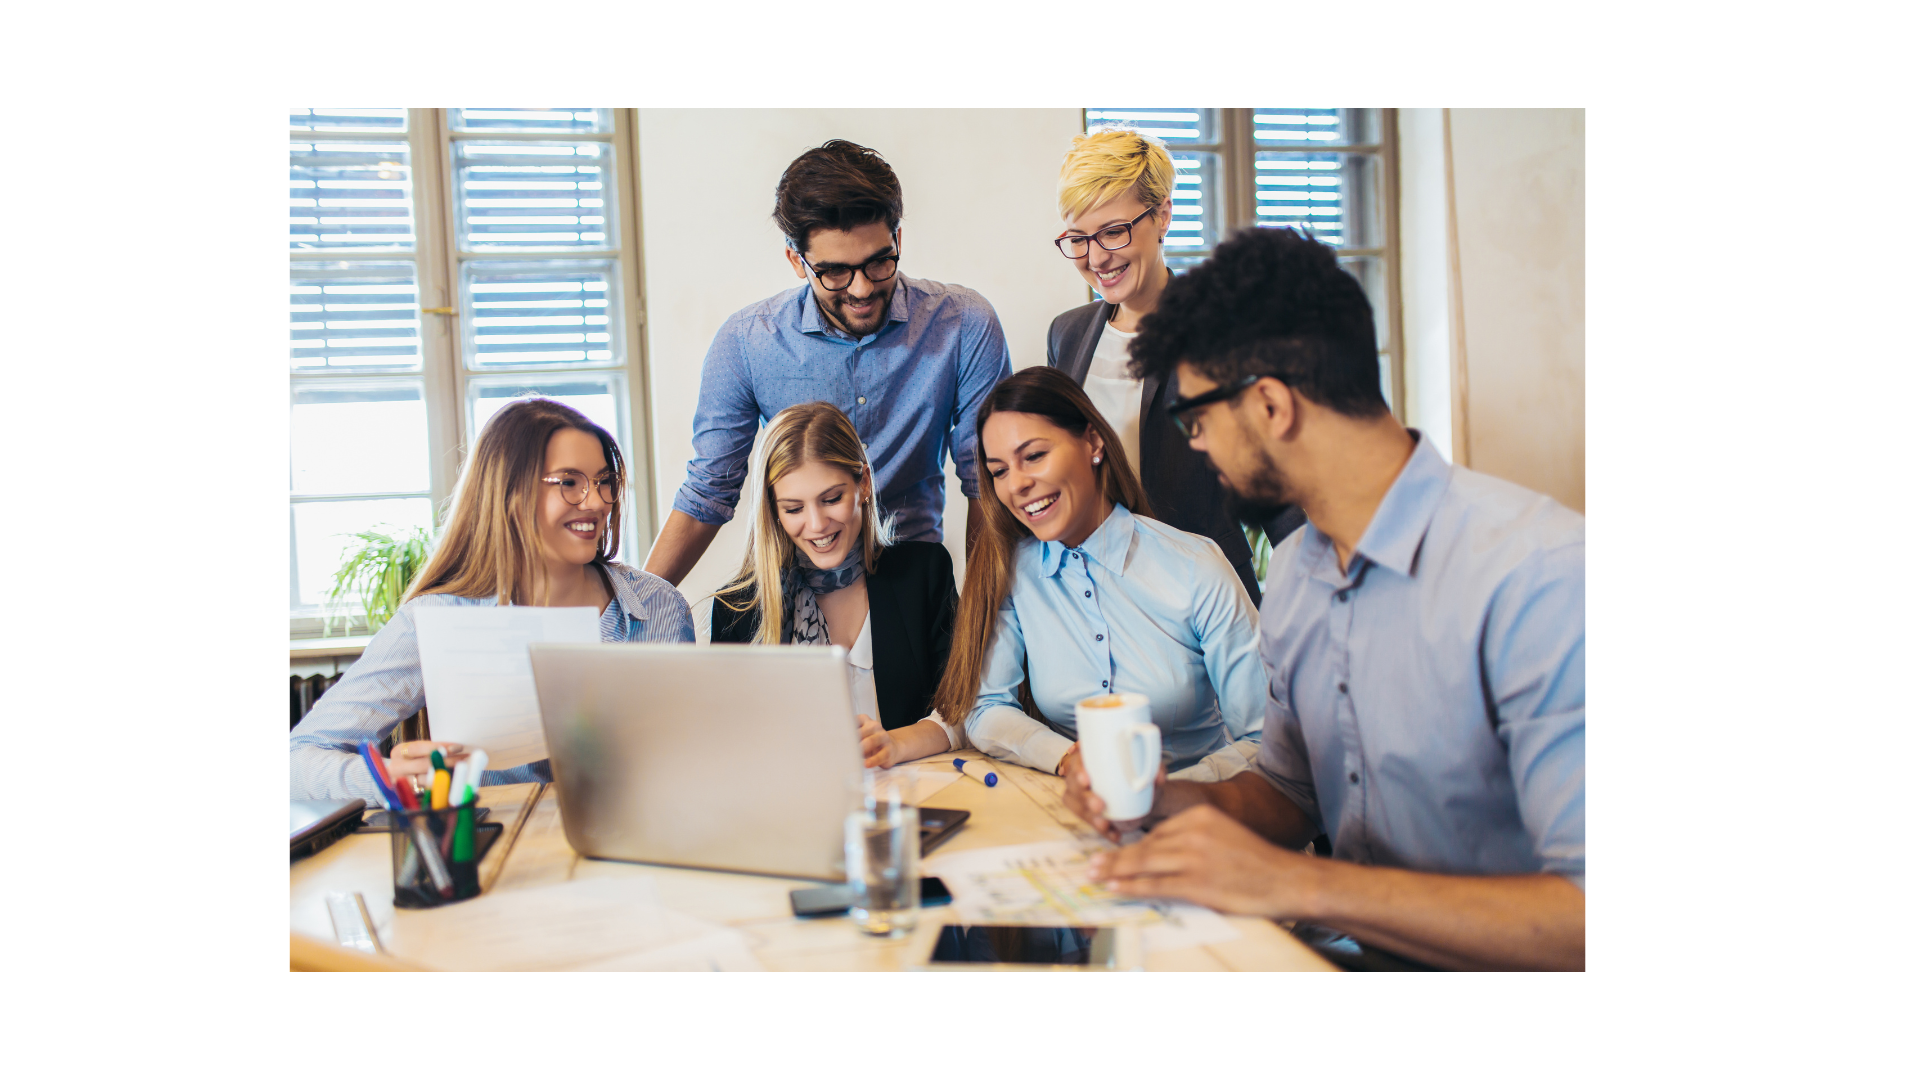
Angestellte rund um einen Laptop. Quelle: Canva
In diesem Code wird das Bild mit „cv2.imread“ aus einer Datei gelesen und anschließend mit „imshow“ in einem Fenster dargestellt. Die Funktion „cv2.waitKey(0)“ sorgt dafür, dass das Fenster geöffnet bleibt, bis du eine Taste drückst.
Bildverarbeitung bedeutet, Pixeldaten so zu verändern, dass sich das visuelle Erscheinungsbild des Ausgangsbildes gezielt anpasst – etwa zur Merkmalsextraktion, Bildanalyse oder für andere Computer-Vision-Aufgaben. Beispiele sind Farbverarbeitung, Filterung, Segmentierung, Kantenerkennung u. a.
Der nächste Codeschnipsel zeigt eine einfache Bildverarbeitungstechnik auf dem zuvor geladenen Bild: eine Farbkonvertierung in Graustufen. Die Umwandlung in Graustufen ist eine grundlegende Technik, bei der das Bild auf einen einzelnen Intensitätskanal reduziert wird.
# Bild in Graustufen umwandeln
gray_image = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)

# Graustufenbild anzeigen
cv2.imshow('Gray Image', gray_image)
cv2.waitKey(0)
cv2.destroyAllWindows()
Hier wandelt cv2.cvtColor() das geladene Bild in ein Graustufenbild um.
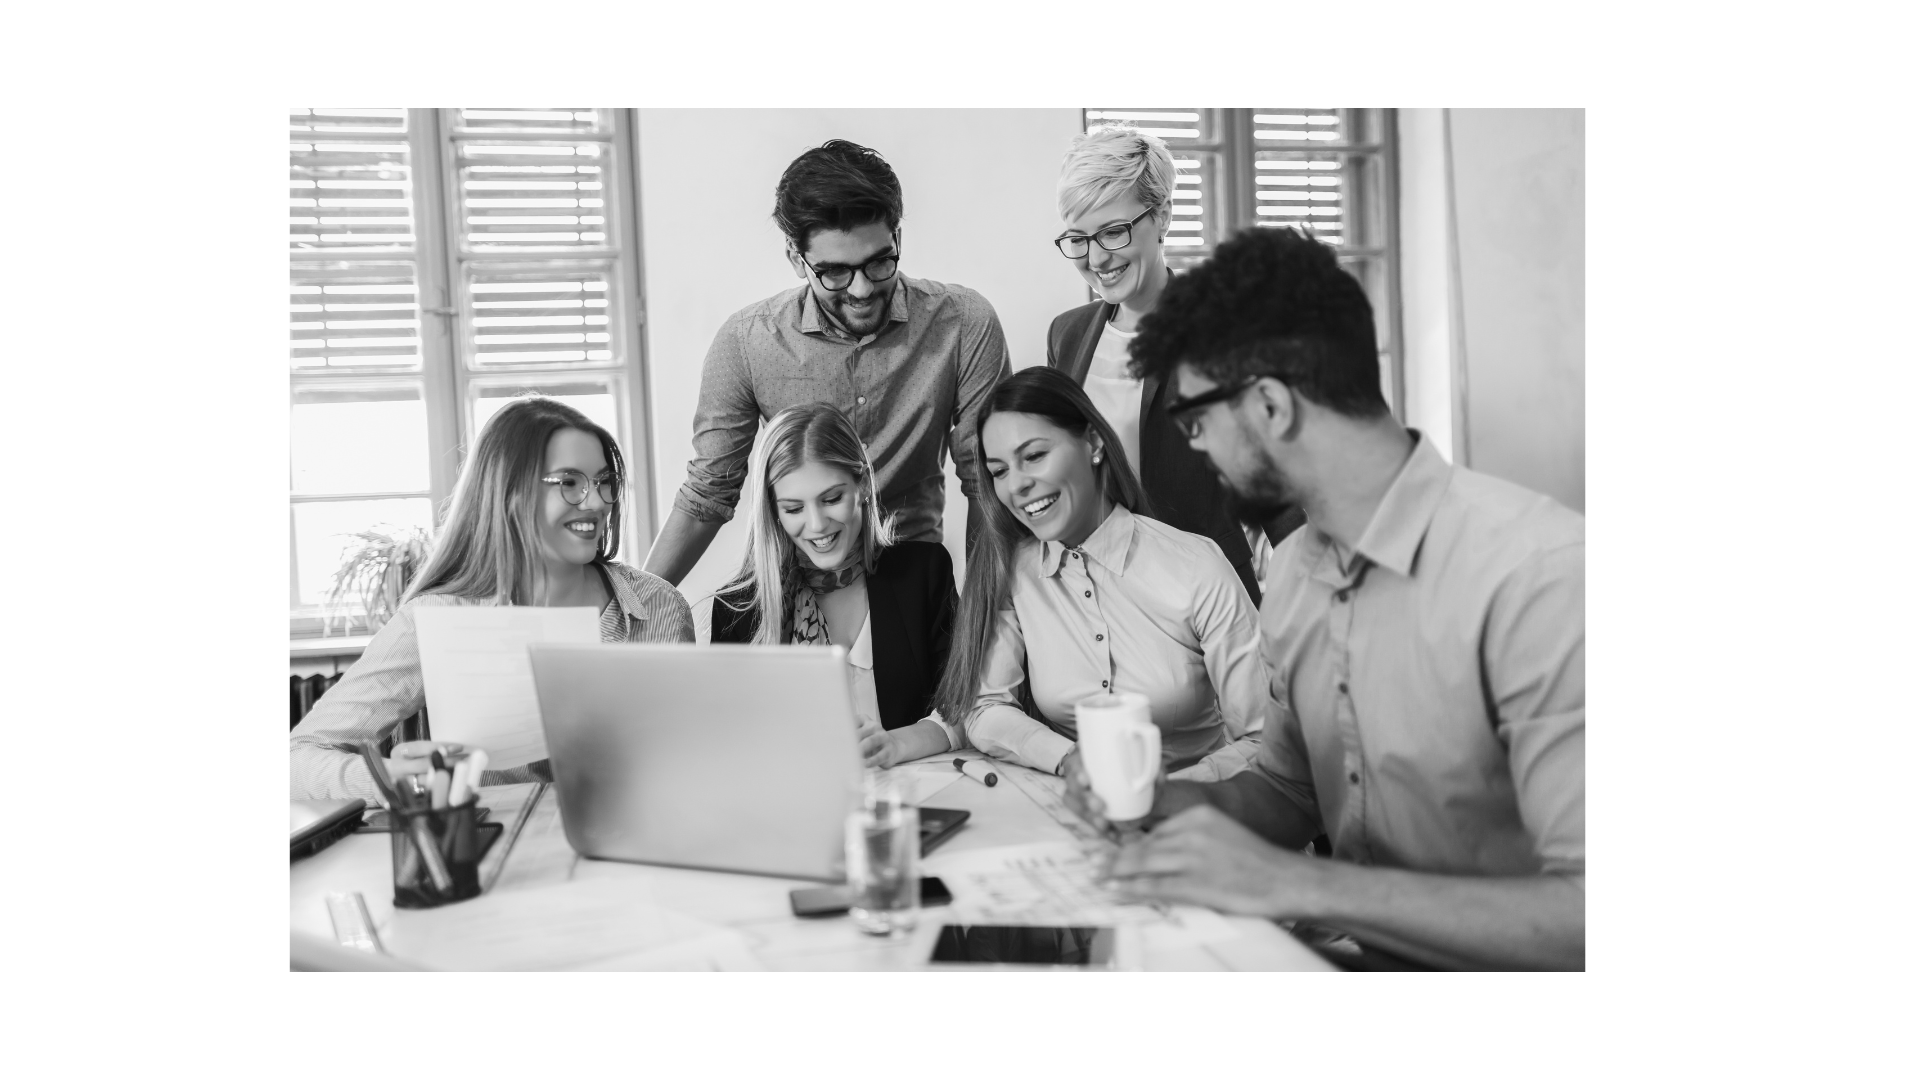
Angestellte rund um einen Laptop (Graustufen). Quelle: Canva
Kantenerkennung ist eine grundlegende Technik in der Bildverarbeitung und Computer Vision. Sie identifiziert Punkte im Bild, an denen die Helligkeit stark wechselt oder Diskontinuitäten vorliegen. Die Erkennung von Kanten ist zentral, um Merkmale in Bilddaten aufzuspüren. Typischerweise werden dabei starke Änderungen der Pixelintensitäten detektiert. Durch das Verbinden dieser Punkte entstehen Linien und Kanten, die Objekte im Bild umreißen.
Mit Kantenerkennungsalgorithmen lassen sich feinste Textur- und Strukturmerkmale von Objekten im Bild aufspüren.
Mehrere Algorithmen wie der Canny-Detektor, die Sobel-Methode und Verfahren der Fuzzy-Logik werden in Objekterkennung, Bildsegmentierung und Merkmalsextraktion eingesetzt. Der folgende Code demonstriert eine einfache Kantenerkennung mit OpenCV:
# Canny-Kantenerkennung anwenden (ein einfaches Verfahren)
edges = cv2.Canny(gray_image, 50, 150)

# Bild mit erkannten Kanten anzeigen
cv2.imshow('Edges', edges)
cv2.waitKey(0)
cv2.destroyAllWindows()
Der Canny-Algorithmus ist in OpenCV über die Funktion „cv2.Canny()“ direkt verfügbar und erkennt Kanten im Graustufenbild.
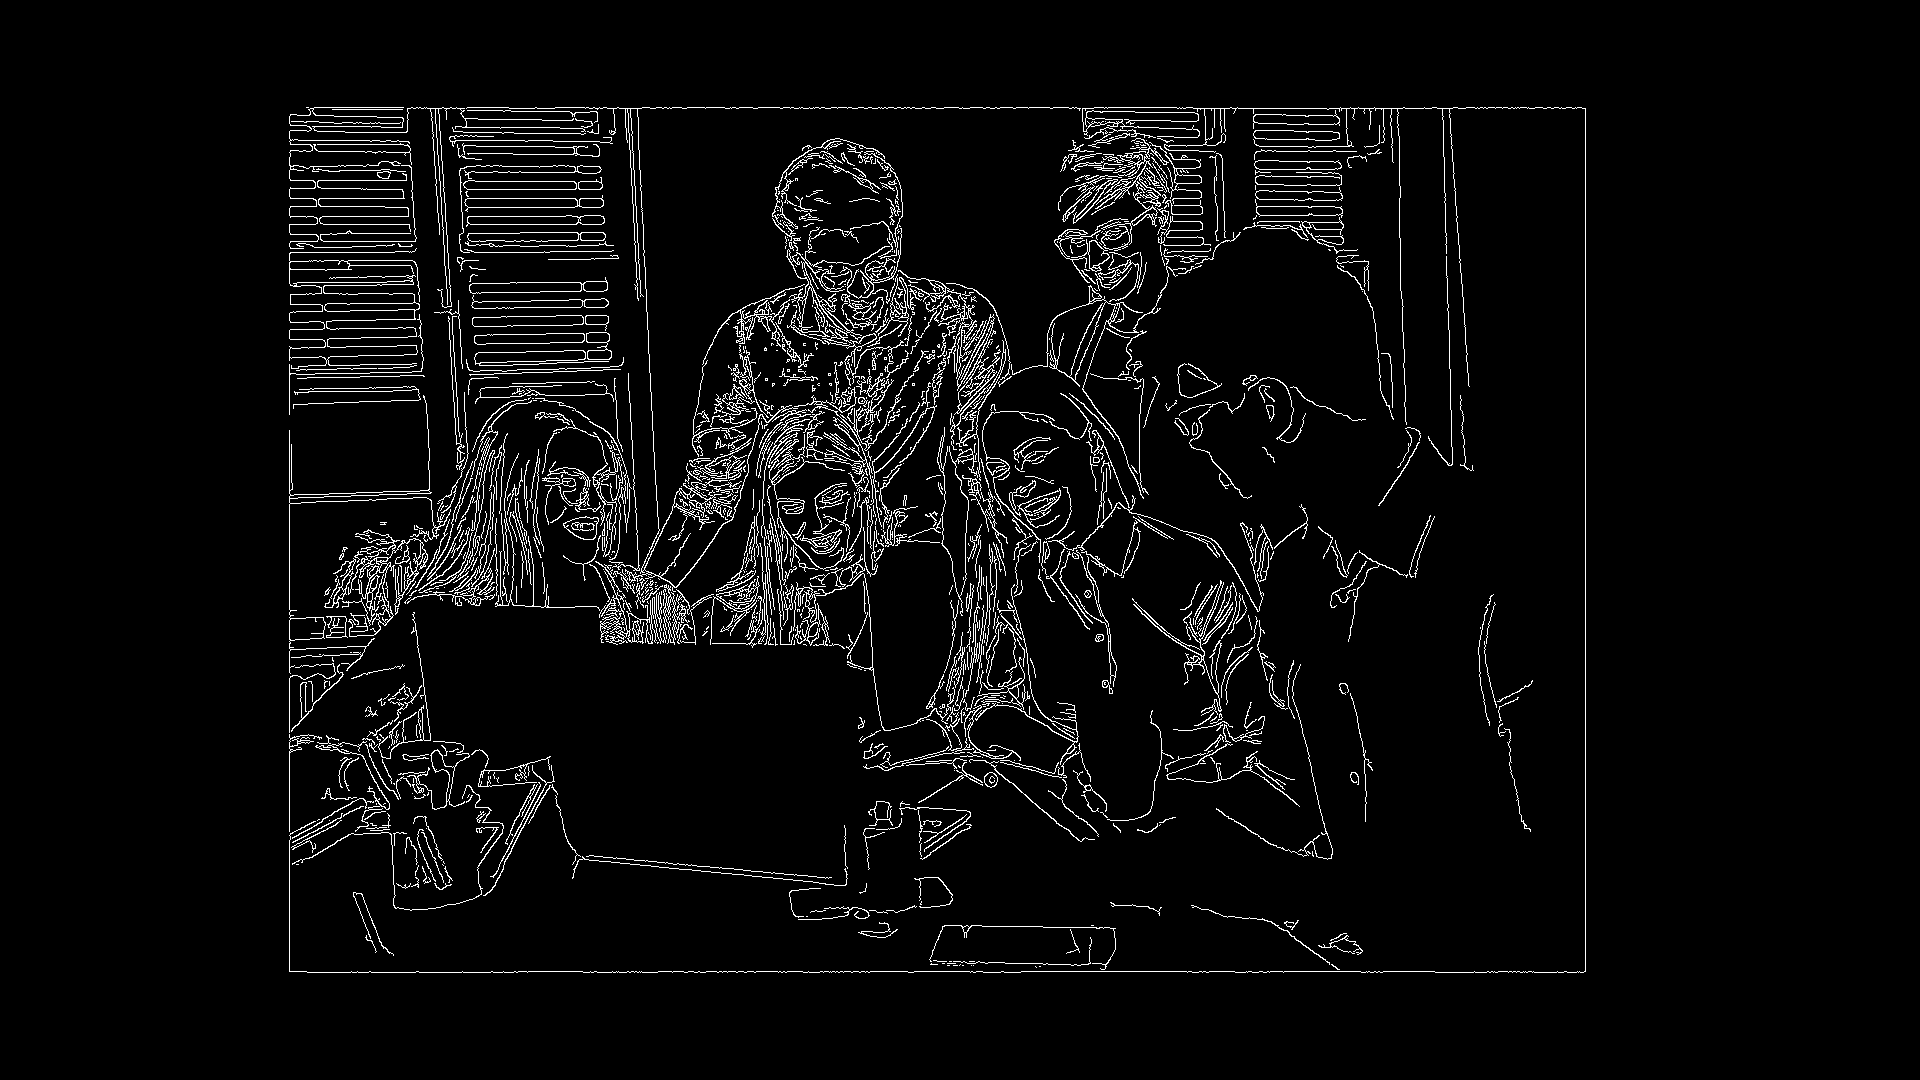
Angestellte rund um einen Laptop (Graustufen). Quelle: Canva
Das Skalieren und Drehen von Bildern gehört zu den Grundanforderungen der Bildverarbeitung, um visuelle Inhalte anzupassen und zu transformieren. Beim Skalieren werden die Abmessungen verändert – vergrößert oder verkleinert –, was wichtig ist, um Bilder für bestimmte Umgebungen passend zu machen.
Drehen verändert den Blickwinkel auf das Bild um einen definierten Rotationswinkel. Beide Schritte werden häufig als Vorverarbeitung für Computer Vision, Machine Learning und Grafik eingesetzt. In der Trainingsphase tiefer neuronaler Netze sind Drehen und Skalieren gängige Methoden der Datenaugmentation, um die Varianz im Datensatz zu erhöhen. Ziel ist es, Modelle so zu trainieren, dass sie auf unbekannte Daten gut generalisieren.
Mit OpenCV kannst du Bilder wie folgt skalieren und drehen:
# Bild skalieren
resized_image = cv2.resize(image, (width, height))

# Bild um 45 Grad drehen
rotation_matrix = cv2.getRotationMatrix2D((width / 2, height / 2), 45, 1)
rotated_image = cv2.warpAffine(resized_image, rotation_matrix, (width, height))

# Skaliertes und gedrehtes Bild anzeigen
cv2.imshow('Resized Image', resized_image)
cv2.imshow('Rotated Image', rotated_image)
cv2.waitKey(0)
cv2.destroyAllWindows()
Während „cv2.resize“ zum Skalieren dient, werden „cv2.getRotationMatrix2D“ und „cv2.warpAffine“ gemeinsam zum Drehen des Bildes verwendet.
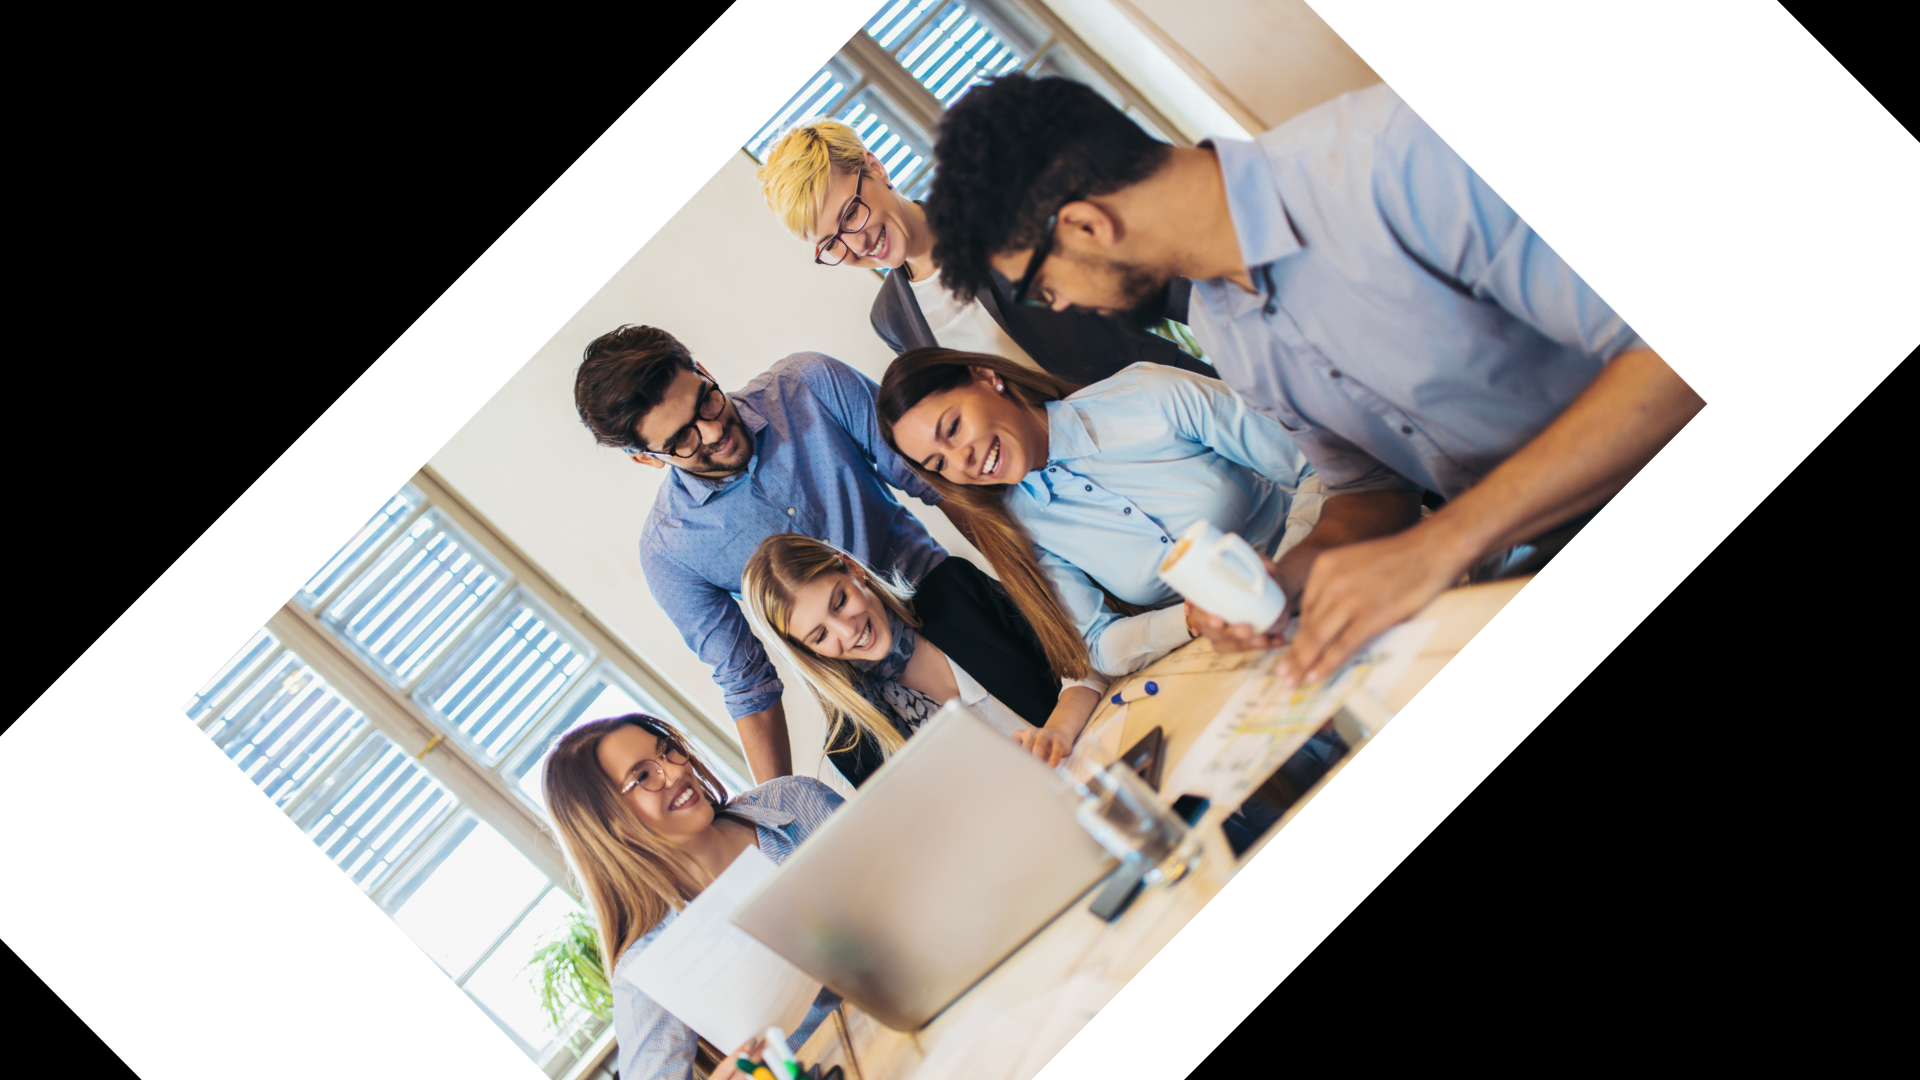
Angestellte rund um einen Laptop (gedreht). Quelle: Canva
Videos sind eine Abfolge von Bildern, die nacheinander gezeigt werden. In der Computer Vision sind Videofunktionen entscheidend, um Anwendungen für Echtzeit- und aufgezeichnete Daten zu entwickeln. Im Gegensatz zu statischen Bildern arbeitet die Videobearbeitung mit zeitlichen Bildfolgen und ermöglicht so die Analyse von Bewegung, Veränderungen über die Zeit und die Erkennung zeitlicher Muster.
Die dynamische Natur von Videoinhalten erfordert effiziente Verarbeitung – besonders in kritischen Systemen wie Überwachung, autonomem Fahren, Aktivitätserkennung und vielen weiteren Anwendungen, in denen das Verständnis von Bewegung und Veränderung zentral ist.
Ein großer Vorteil von OpenCV für Videobearbeitungsaufgaben ist der umfassende Funktionsumfang zur effizienten Verarbeitung von Videostreams. Wie bei Bildern stellt OpenCV auch für Videos Werkzeuge zum Erfassen, Verarbeiten und Analysieren bereit.
Der folgende Code lädt und verarbeitet ein lokal gespeichertes Video:
import cv2

# Video-Capture-Objekt öffnen
cap = cv2.VideoCapture("Your video's path.mp4")

# Prüfen, ob das Video erfolgreich geöffnet wurde
if not cap.isOpened():
    print("Error: Couldnot open the video.")
    exit()

# Über die Videoframes iterieren
while True:
    # Ein Frame aus dem Video lesen
    ret, frame = cap.read()

    # Schleife beenden, wenn das Video zu Ende ist
    if not ret:
        break

    # Originalframe anzeigen
    cv2.imshow('Original Video', frame)

    gray_frame = cv2.cvtColor(frame, cv2.COLOR_BGR2GRAY)
    cv2.imshow('Black and White Video', gray_frame)

    # Kantenerkennung auf dem Video durchführen
    edges_frame = cv2.Canny(gray_frame, 50, 150)
    cv2.imshow('Edges Video', edges_frame)

    # Schleife beenden, wenn die Taste 'q' gedrückt wird
    if cv2.waitKey(25) & 0xFF == ord('q'):
        break

# Capture-Objekt freigeben und alle Fenster schließen
cap.release()
cv2.destroyAllWindows()
In diesem Code greift die Klasse „cv2.VideoCapture“ auf eine Videodatei zu und liest die Frames mit „cap.read“. Zunächst wird das Originalvideo angezeigt, anschließend in Schwarz-Weiß konvertiert und schließlich für jedes Frame eine Kantenerkennung durchgeführt. Die Schleife läuft, bis das Video endet oder per Tastatureingabe beendet wird. „cv2.waitKey(25)“ sorgt für eine kurze Verzögerung zwischen den Frames, damit die Wiedergabe flüssig bleibt.
Objekterkennung ist eine grundlegende Aufgabe der Computer Vision. Sie zielt darauf ab, Objekte in Bildern oder Videos zu erkennen und zu lokalisieren und liefert als Ergebnis Klassenlabels und zugehörige Begrenzungsrahmen. Die Personenerkennung als spezielle Form der Objekterkennung konzentriert sich darauf, Menschen in visuellen Daten zu identifizieren und zu lokalisieren.
Einsatzfelder sind unter anderem Überwachung, Crowd-Management, Personenzählung, Tracking, Mensch-Computer-Interaktion und smarte Umgebungen. In der Überwachung hilft die Technik beim Erkennen verdächtiger Aktivitäten, im Crowd-Management unterstützt sie Gestenerkennung und Verfolgung. Personenerkennung ist ein Schlüsselfaktor in der Mensch-Computer-Interaktion und wird in smarten Umgebungen zur Ressourcenoptimierung und für mehr Sicherheit eingesetzt.
YOLO, kurz für „You Only Look Once“, hat sich als verbreitetes System für effiziente Objekterkennung in Echtzeit etabliert. Anders als klassische Verfahren teilt YOLO das Bild in ein Raster auf und sagt für jede Zelle simultan Begrenzungsrahmen und Klassenwahrscheinlichkeiten voraus.
In unserem Leitfaden findest du mehr über die YOLO-Objekterkennung.
Unten findest du einen Codeschnipsel, der OpenCV und YOLO für die Personenerkennung in einem Bild nutzt:
import cv2

net = cv2.dnn.readNet('yolov3.weights', 'yolov3.cfg')
layer_names = net.getUnconnectedOutLayersNames()

image = cv2.imread('image path.jpg')
height, width = image.shape[:2]

blob = cv2.dnn.blobFromImage(image, 1/255.0, (416, 416), swapRB=True, crop=False)
net.setInput(blob)
outs = net.forward(layer_names)

for out in outs:
    for detection in out:
        scores = detection[5:]
        class_id = np.argmax(scores)
        confidence = scores[class_id]

        if confidence > 0.5 and class_id == 0:  # Class ID for person
            box = detection[:4] * np.array([width, height, width, height])
            (x, y, w, h) = box.astype(int)
            cv2.rectangle(image, (x, y), (x + w, y + h), (0, 255, 0), 2)

cv2.imshow('Person Detection', image)
cv2.waitKey(0)
cv2.destroyAllWindows()Die Code-Struktur folgt für Videos denselben Prinzipien. Statt eines statischen Bildes werden fortlaufend Videoframes verarbeitet.
Das Grundprinzip der Personenerkennung ist in Bildern und Videos identisch, der wesentliche Unterschied ist die Zeitkomponente. Bei Bildern geht es um das Erkennen und Lokalisieren in einzelnen, statischen Frames.
Das eignet sich besonders für Überwachungsstandbilder und andere nicht überlappende Aufnahmen. In Videos hingegen sollen Personen über aufeinanderfolgende Frames hinweg erkannt und verfolgt werden – häufig als Objektverfolgung bezeichnet. Die zeitliche Dimension ist entscheidend, um Bewegungen und Interaktionen zu verstehen. Deshalb ist videobasierte Personenerkennung ein zentrales Werkzeug für Echtzeitanwendungen wie Sicherheit, Crowd-Monitoring und Verhaltensanalyse.
Weitere Praxisbeispiele sind Smart Cities, Retail-Analytics und öffentliche Sicherheit. Gleichzeitig stellen sich ethische Fragen rund um Privatsphäre, Einwilligung und möglichen Missbrauch der Technik. Eine verantwortungsvolle Einführung gelingt nur, wenn Nutzen und ethische Bedenken sorgfältig abgewogen werden.
Dieses Tutorial hat die Grundlagen der Arbeit mit der OpenCV-Bibliothek für verschiedene Computer-Vision-Aufgaben gezeigt. Vom Setup in einer Python-Umgebung über das Laden und Anzeigen von Bildern bis hin zu Bildverarbeitungstechniken wie Graustufenumwandlung und Kantenerkennung. Insgesamt zeigt sich: OpenCV beherrscht anspruchsvolle Transformationen und Analysen und kann Bildverarbeitungsmethoden auch auf Videoframes anwenden.
Gerade in der angewandten Computer Vision ist OpenCV unverzichtbar: Die Bibliothek ist vielseitig und robust und hilft Computer-Vision-Ingenieurinnen und -Ingenieuren sowie Machine-Learning-Praktikerinnen und -Praktikern, vielfältige Herausforderungen der visuellen Datenverarbeitung zu meistern. Der große Vorteil liegt darin, dass OpenCV die Umsetzung von Computer-Vision-Algorithmen vereinfacht und Ideen effizient in lauffähige Anwendungen überführt.
Vertiefe die in diesem Artikel behandelten Konzepte mit dem Kurs Image Processing in Python. Der Kurs erweitert dein Toolkit für Bildverarbeitung und Computer Vision um zusätzliche Bibliotheken wie scikit-image und NumPy.
Starte noch heute mit Python!
Kurs
Kurs
Kurs