
Kursus
Analisis Deret Waktu dengan Python
4 jam
70.9K
Berlatih dan lacak kemajuan Anda.
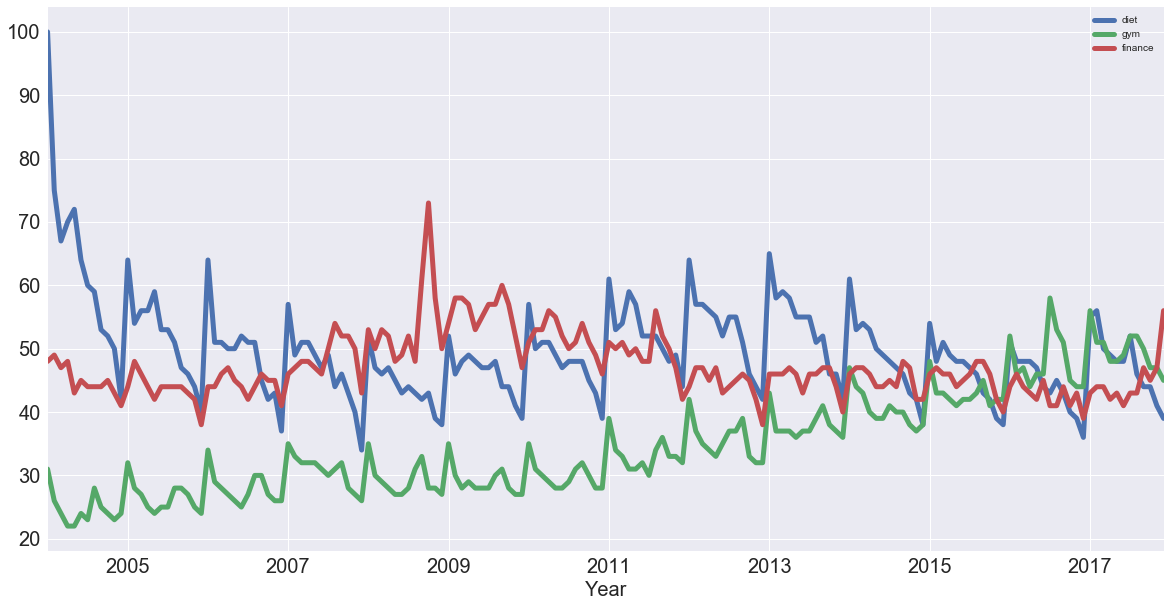
Lanjutkan Dengan GoogleDalam sesi code along Facebook Live pada 4 Januari, kami meninjau data Google Trends untuk kata kunci 'diet', 'gym', dan 'finance' guna melihat bagaimana perubahannya dari waktu ke waktu. Kami bertanya-tanya apakah mungkin ada lebih banyak penelusuran untuk istilah-istilah ini pada bulan Januari saat kita semua mencoba memulai lembaran baru?
Dalam tutorial ini, Anda akan menelusuri kode yang kami susun selama sesi tersebut langkah demi langkah. Anda tidak akan banyak melakukan matematika. Penekanan tutorial ini sepenuhnya pada eksplorasi visual dari dataset yang dibahas.
Untuk materi lebih lanjut tentang pandas, lihat Data Manipulation with Python track di DataCamp. Untuk topik deret waktu dengan pandas, pelajari juga Manipulating Time Series Data in Python course.
Jadi pertanyaannya tetap: mungkinkah ada lebih banyak penelusuran untuk istilah-istilah ini pada bulan Januari saat kita semua mencoba memulai lembaran baru?
Mari cari tahu dengan pergi ke sini dan meninjau datanya. Catatan bahwa tutorial ini terinspirasi oleh tulisan FiveThirtyEight ini.
Anda juga dapat mengunduh data sebagai .csv, simpan ke file dan impor ke lingkungan Python Anda sendiri untuk melakukan analisis. Anda akan melakukannya sekarang. Ayo mulai!
Untuk memulai, Anda akan mengimpor beberapa package: dalam hal ini, Anda akan menggunakan numpy, pandas, matplotlib, dan seaborn.
Selain itu, jika Anda ingin gambar ditampilkan di Jupyter Notebook, Anda dapat menggunakan magic IPython dengan menambahkan %matplotlib inline ke kode Anda. Alternatifnya, Anda juga dapat beralih ke default Seaborn dengan sns.set():
# Import packages
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
%matplotlib inline
sns.set()
Impor data yang Anda unduh dengan .read_csv() dan lihat beberapa baris pertama dengan .head().
Catatan bahwa Anda menambahkan argumen skiprows untuk melewati baris pertama di awal file.
 df = pd.read_csv('data/multiTimeline.csv', skiprows=1)
df.head()| Month | diet: (Worldwide) | gym: (Worldwide) | finance: (Worldwide) | |
|---|---|---|---|---|
| 0 | 2004-01 | 100 | 31 | 48 |
| 1 | 2004-02 | 75 | 26 | 49 |
| 2 | 2004-03 | 67 | 24 | 47 |
| 3 | 2004-04 | 70 | 22 | 48 |
| 4 | 2004-05 | 72 | 22 | 43 |
Anda juga dapat menggunakan metode .info() untuk melihat tipe data, jumlah baris, dan lainnya:
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 168 entries, 0 to 167
Data columns (total 4 columns):
Month                   168 non-null object
diet: (Worldwide)       168 non-null int64
gym: (Worldwide)        168 non-null int64
finance: (Worldwide)    168 non-null int64
dtypes: int64(3), object(1)
memory usage: 5.3+ KB
Sekarang setelah Anda mengimpor data dari Google Trends dan meninjaunya secara singkat, saatnya menata data agar siap untuk analisis.
Hal pertama yang ingin Anda lakukan adalah mengganti nama kolom DataFrame df agar tidak memiliki spasi. Ada beberapa cara untuk melakukan ini, tetapi untuk saat ini, Anda akan menetapkan ulang ke df.columns sebuah list berisi nama kolom yang diinginkan.
Periksa kembali hasil penetapan ulang dengan memanggil df.head():
df.columns = ['month', 'diet', 'gym', 'finance']
df.head()
| month | diet | gym | finance | |
|---|---|---|---|---|
| 0 | 2004-01 | 100 | 31 | 48 |
| 1 | 2004-02 | 75 | 26 | 49 |
| 2 | 2004-03 | 67 | 24 | 47 |
| 3 | 2004-04 | 70 | 22 | 48 |
| 4 | 2004-05 | 72 | 22 | 43 |
Berikutnya, Anda akan mengubah kolom 'month' menjadi tipe data DateTime dan menjadikannya indeks DataFrame.
Catatan bahwa Anda melakukan ini karena dari hasil metode .info() terlihat kolom 'Month' sebenarnya bertipe data object. Tipe data generik tersebut mencakup segala sesuatu mulai dari string hingga integer, dll. Itu bukan yang Anda inginkan saat menganalisis data deret waktu. Itulah mengapa Anda akan menggunakan .to_datetime() untuk mengonversi kolom 'month' di DataFrame Anda menjadi DateTime.
Hati-hati! Pastikan menyertakan argumen inplace saat Anda mengatur indeks DataFrame df agar benar-benar mengubah indeks asli dan menetapkannya ke kolom 'month'.
df.month = pd.to_datetime(df.month)
df.set_index('month', inplace=True)
df.head()
| diet | gym | finance | |
|---|---|---|---|
| month | |||
| 2004-01-01 | 100 | 31 | 48 |
| 2004-02-01 | 75 | 26 | 49 |
| 2004-03-01 | 67 | 24 | 47 |
| 2004-04-01 | 70 | 22 | 48 |
| 2004-05-01 | 72 | 22 | 43 |
Sekarang saatnya mengeksplorasi DataFrame Anda secara visual.
Anda dapat menggunakan metode visualisasi bawaan pandas .plot() untuk memvisualisasikan data sebagai 3 plot garis dalam satu figur (masing-masing untuk kolom 'diet', 'gym', dan 'finance').
Catatan bahwa Anda juga dapat menentukan beberapa argumen untuk metode ini, seperti figsize, linewidth, dan fontsize untuk mengatur ukuran figur, lebar garis, dan ukuran font plot.
Selain itu, Anda akan melihat bahwa yang tampil pada sumbu x bukan bulan seperti label defaultnya, melainkan tahun. Untuk membuat plot lebih akurat, Anda akan atur label pada sumbu x menjadi 'Year' dan ukuran font 20.
Tip: jika Anda ingin menekan output Matplotlib, tambahkan titik koma ; pada baris kode terakhir!
df.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
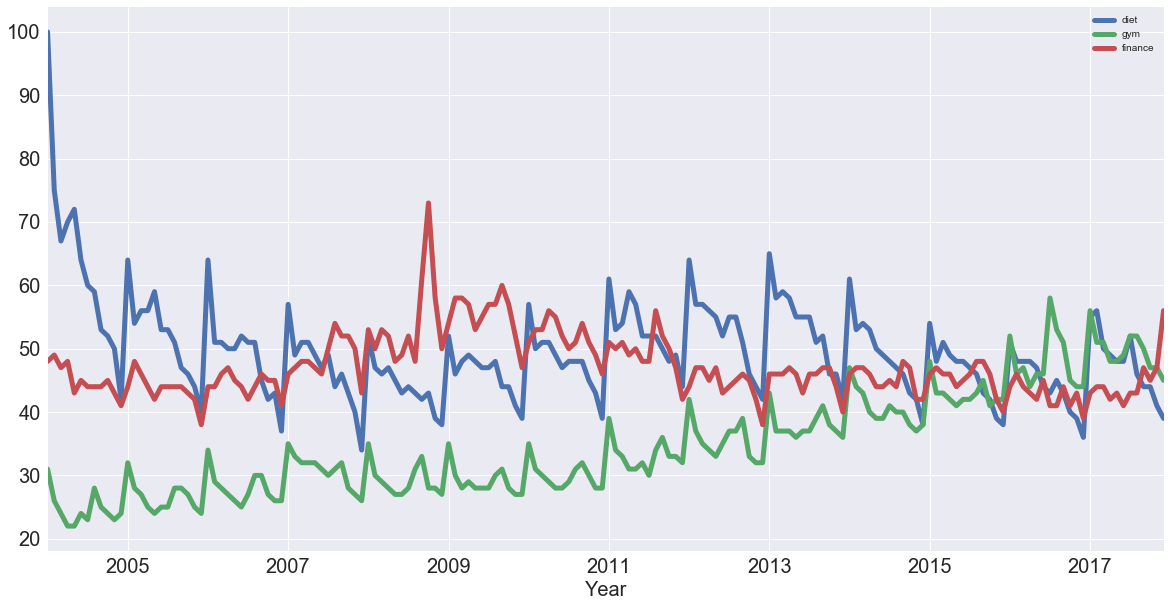
Catatan bahwa data ini bersifat relatif. Seperti yang Anda baca di Google Trends:
Angka mewakili ketertarikan penelusuran relatif terhadap titik tertinggi pada grafik untuk wilayah dan waktu tertentu. Nilai 100 adalah puncak popularitas untuk istilah tersebut. Nilai 50 berarti istilah tersebut setengah sepopuler. Demikian pula skor 0 berarti istilah tersebut kurang dari 1% sepopuler puncaknya.
Jika ingin, Anda juga dapat memplot kolom 'diet' saja sebagai deret waktu:
df[['diet']].plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
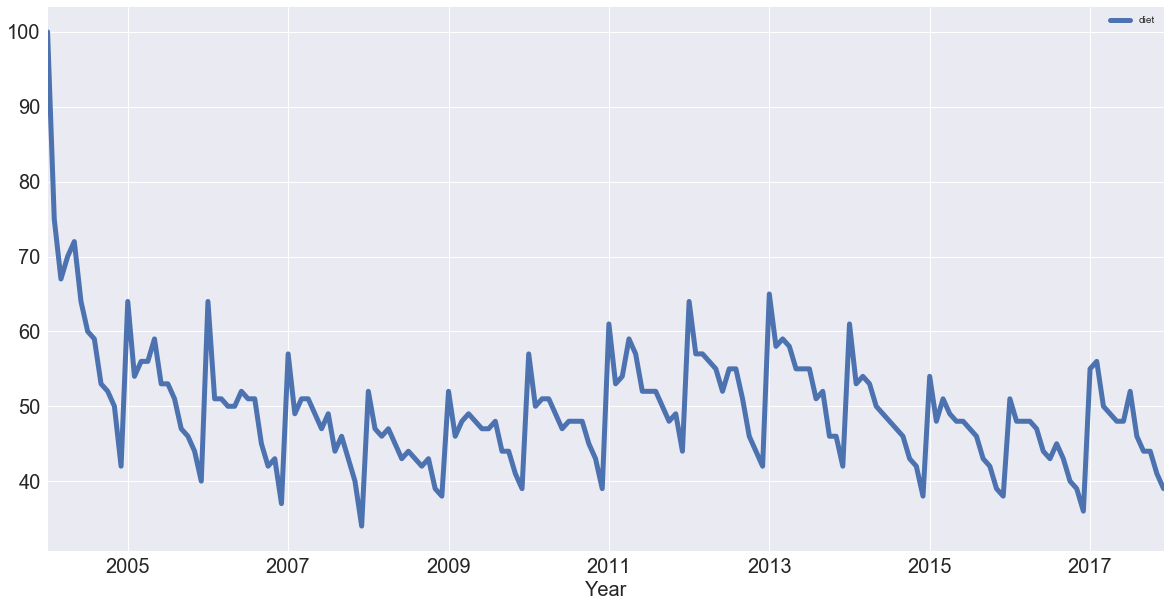
Catatan: hal pertama yang terlihat adalah adanya musiman: setiap Januari, ada lonjakan besar. Juga tampak ada tren: terlihat sedikit naik, lalu turun, naik lagi, lalu turun lagi. Dengan kata lain, tampaknya ada komponen tren dan musiman pada deret waktu ini.
Dengan ini, Anda akan belajar cara mengidentifikasi tren pada deret waktu!
Ada beberapa cara untuk memikirkan identifikasi tren dalam deret waktu. Salah satu cara populer adalah dengan mengambil rata-rata bergulir, yang berarti untuk setiap titik waktu, Anda mengambil rata-rata dari titik-titik di sekitarnya. Perhatikan bahwa jumlah titik ditentukan oleh ukuran jendela yang perlu Anda pilih.
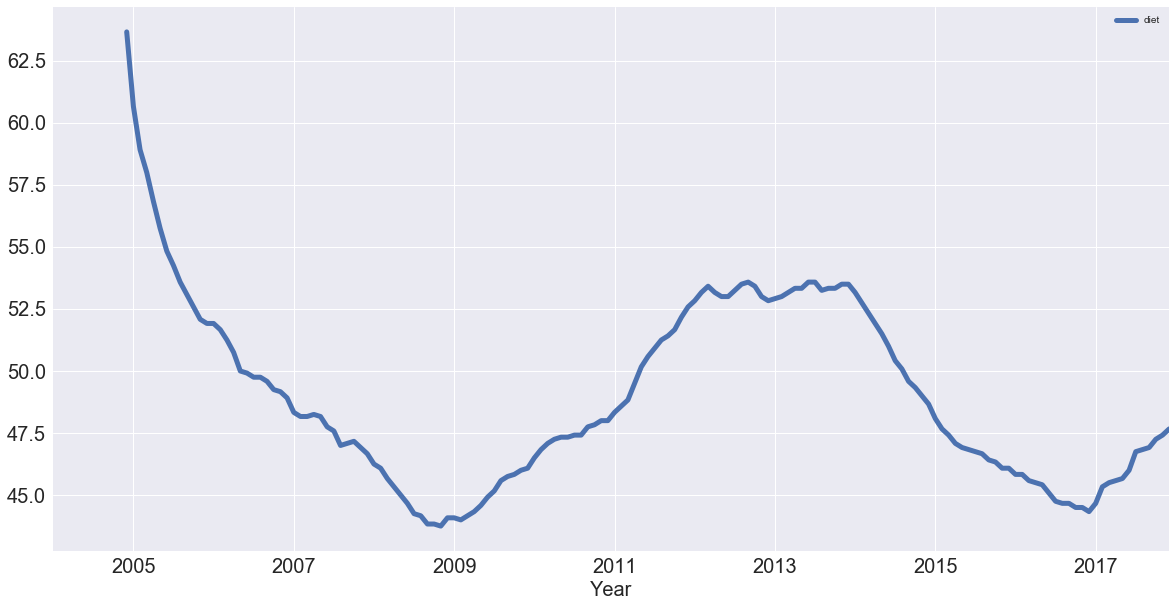
Karena Anda mengambil rata-rata, ini cenderung menghaluskan noise dan musiman. Anda akan melihat contohnya sekarang. Lihat rata-rata bergulir dari 'diet' menggunakan metode bawaan pandas.
Untuk menentukan ukuran jendela, masuk akal untuk mencoba jendela dua belas bulan terlebih dahulu, karena kita membahas musiman tahunan.
diet = df[['diet']]
diet.rolling(12).mean().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
Catatan bahwa pada potongan kode di atas Anda menggunakan dua set tanda kurung siku untuk mengekstrak kolom 'diet' sebagai DataFrame; Jika Anda menggunakan satu set seperti df['diet'], Anda akan membuat Series pandas.
Pada potongan kode di atas, Anda juga melakukan method chaining: memanggil metode pada sebuah objek satu demi satu. Method chaining cukup populer dan pandas adalah salah satu package yang sangat mendukung gaya pemrograman ini!
Sekarang Anda mendapatkan tren yang dicari! Anda telah menghapus sebagian besar musiman dibandingkan plot sebelumnya.
Anda juga dapat memplot rata-rata bergulir 'gym' menggunakan metode bawaan pandas dengan ukuran jendela yang sama seperti pada data 'diet':
gym = df[['gym']]
gym.rolling(12).mean().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
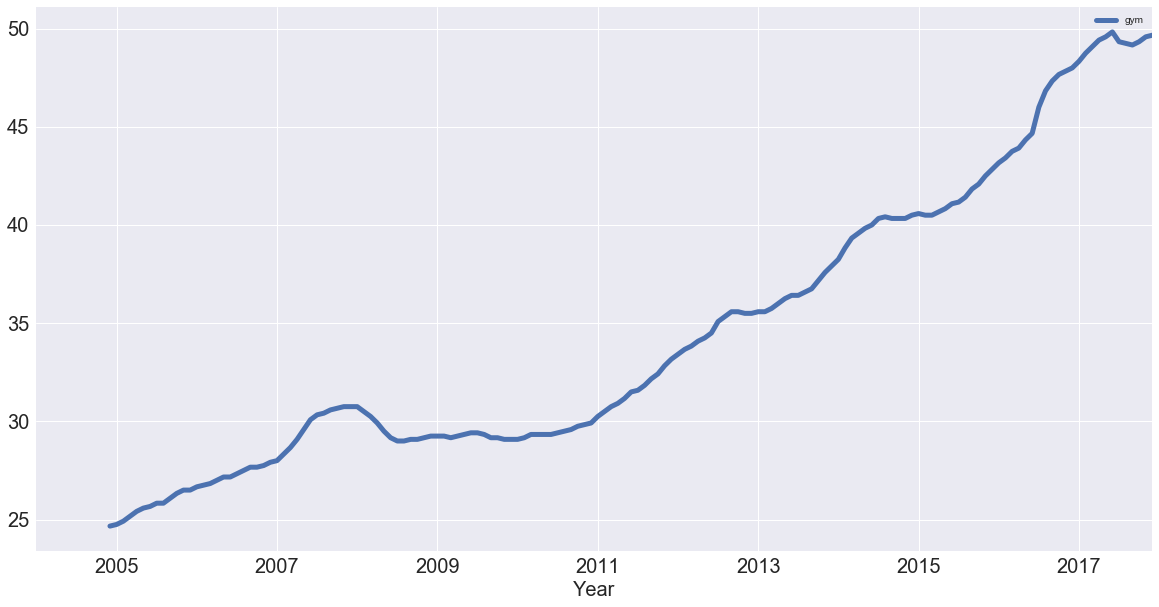
Anda berhasil menghapus musiman dan Anda melihat tren naik untuk "gym"! Tetapi bagaimana perbandingan kedua istilah penelusuran ini?
Anda dapat mengetahuinya dengan memplot tren 'gym' dan 'diet' dalam satu figur:
df_rm = pd.concat([diet.rolling(12).mean(), gym.rolling(12).mean()], axis=1)
df_rm.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
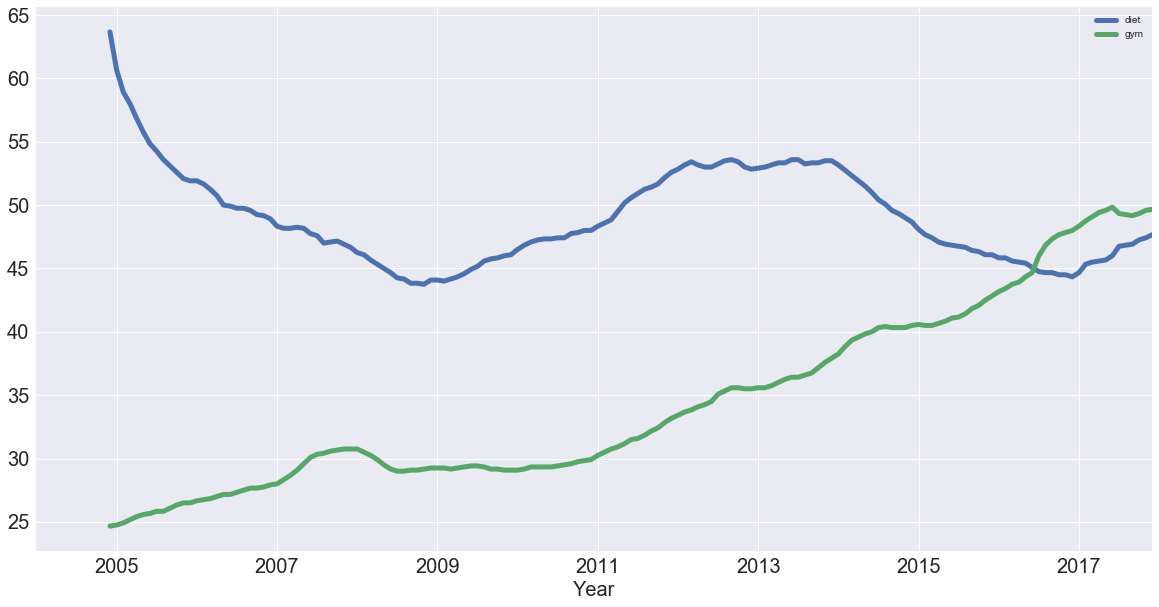
Anda membuat DataFrame baru df_rm yang memiliki dua kolom berisi rata-rata bergulir dari 'diet' dan 'gym'. Anda menggunakan fungsi pd.concat(), yang menerima list kolom sebagai argumen pertama dan, karena ingin menggabungkannya sebagai kolom, Anda menambahkan argumen axis yang disetel ke 1.
Berikutnya, Anda memplot DataFrame dengan metode plot(), seperti sebelumnya! Jadi kini, setelah menghilangkan musiman, terlihat bahwa diet berpotensi memiliki semacam pola musiman, sedangkan gym sebenarnya meningkat!
Setelah mengidentifikasi tren dalam data, saatnya memikirkan musiman, yaitu sifat berulang dari deret waktu Anda. Seperti yang terlihat di awal tutorial, tampaknya ada komponen tren dan musiman pada deret waktu data.
Salah satu cara memikirkan komponen musiman pada deret waktu data Anda adalah dengan menghapus tren dari deret waktu, sehingga Anda dapat menyelidiki musiman dengan lebih mudah. Untuk menghapus tren, Anda dapat mengurangkan tren yang dihitung di atas (rata-rata bergulir) dari sinyal asli. Namun, ini akan bergantung pada berapa banyak titik data yang Anda rata-ratakan.
Cara lain untuk menghapus tren disebut "differencing", yaitu melihat selisih antara titik data yang berurutan (disebut "first-order differencing", karena Anda hanya melihat selisih antara satu titik data dan titik sebelumnya).
Anda dapat menggunakan pandas serta metode diff() dan plot() untuk menghitung dan memplot selisih orde pertama dari Series 'diet':
diet.diff().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
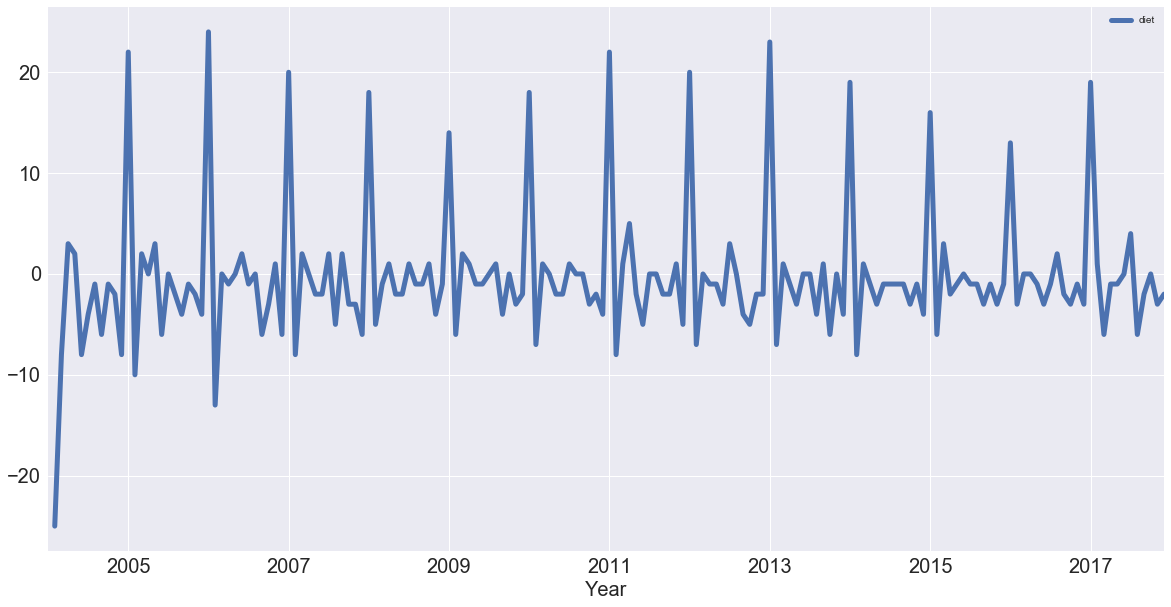
Lihat bahwa Anda telah menghapus banyak komponen tren dan benar-benar dapat melihat puncak setiap Januari. Setiap Januari, ada lonjakan besar sebesar 20 persen atau lebih pada item penelusuran tertinggi yang Anda lihat!
Catatan: Anda juga dapat melakukan differencing orde ke-2, yang berarti Anda melihat selisih antara satu titik data dan dua titik sebelumnya, jika tren belum sepenuhnya terhapus. Lihat di sini untuk informasi lebih lanjut tentang differencing.
Differencing sangat membantu untuk mengubah deret waktu menjadi deret waktu stasioner. Kita tidak akan terlalu jauh ke sini, tetapi deret waktu stasioner adalah deret yang sifat statistiknya (seperti mean dan varians) tidak berubah dari waktu ke waktu. Deret-deret ini berguna karena banyak metode peramalan deret waktu berasumsi deret waktunya kira-kira stasioner.
Dengan semua ini, sekarang Anda akan menganalisis periodisitas pada deret waktu dengan melihat fungsi autokorelasinya. Namun sebelum itu, mari singgah sejenak ke korelasi.
Sebuah deret waktu bersifat periodik jika mengulang dirinya pada selang yang sama, misalnya setiap 12 bulan.
Cara lain memikirkannya adalah jika deret waktu memiliki puncak di suatu tempat, maka akan ada puncak lagi 12 bulan setelahnya dan, jika memiliki lembah, juga akan ada lembah 12 bulan setelahnya.
Cara lain yang sama adalah deret waktu berkorelasi dengan dirinya sendiri yang digeser 12 bulan. Artinya, jika Anda menggeser deret waktu 12 bulan ke belakang atau ke depan, deret itu akan memetakan dirinya sendiri dalam beberapa cara.
Pertimbangan korelasi deret waktu dengan versi dirinya yang digeser demikian ditangkap oleh konsep autokorelasi.
Anda akan sampai ke sana sebentar lagi.
Pertama, mari mengingat kembali tentang korelasi dan mengambil pendekatan intuitif terhadap konsep ini!
Koefisien korelasi dari dua variabel menangkap seberapa linear keterkaitannya. Untuk memahaminya, Anda akan melihat contoh praktis dengan bantuan dataset iris, yang berisi pengukuran bunga.
Untuk mempelajarinya lebih lanjut, Anda akan mengimpor dataset iris dari scikit-learn, mengubahnya menjadi DataFrame dan melihat baris-baris pertama dengan bantuan .head():
from sklearn import datasets
iris = datasets.load_iris()
df_iris = pd.DataFrame(data= np.c_[iris['data'], iris['target']],
                     columns= iris['feature_names'] + ['target'])
df_iris.head()
| sepal length (cm) | sepal width (cm) | petal length (cm) | petal width (cm) | target | |
|---|---|---|---|---|---|
| 0 | 5.1 | 3.5 | 1.4 | 0.2 | 0.0 |
| 1 | 4.9 | 3.0 | 1.4 | 0.2 | 0.0 |
| 2 | 4.7 | 3.2 | 1.3 | 0.2 | 0.0 |
| 3 | 4.6 | 3.1 | 1.5 | 0.2 | 0.0 |
| 4 | 5.0 | 3.6 | 1.4 | 0.2 | 0.0 |
Sebagai pengingat agar Anda memahami dataset ini, semua bunga memiliki sepal dan petal. Sepal melindungi petal dan biasanya berwarna hijau serta mirip daun, sementara petal biasanya merupakan daun yang berwarna. Kolom 'target', yang merupakan variabel target, adalah spesies bunga iris, yang dapat berupa Versicolor, Virginica, atau Setosa. Pada tabel di atas, mereka dikodekan sebagai 0, 1, dan 2.
Sekarang, untuk memikirkan korelasi, Anda akan melihat bagaimana panjang sepal bunga iris berkorelasi dengan lebar sepal. Untuk melakukannya, Anda akan menggunakan pandas atau seaborn untuk membuat scatter plot 'sepal length' terhadap 'sepal width':
sns.lmplot(x='sepal length (cm)', y='sepal width (cm)', fit_reg=False, data=df_iris);
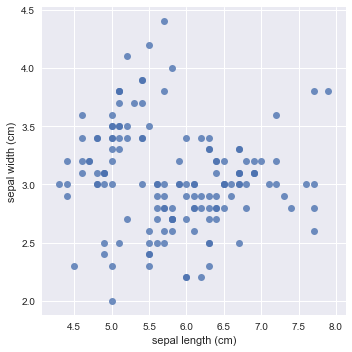
Catatan bahwa Anda mematikan regresi linear dengan menyetel argumen fit_reg ke False.
Apakah panjang dan lebar sepal berkorelasi positif atau negatif di seluruh bunga? Apakah mereka berkorelasi positif atau negatif dalam tiap spesies? Ini adalah pembedaan penting.
Ingat bahwa yang pertama berarti ketika panjang sepal meningkat, lebar sepal juga meningkat secara linear. Yang kedua berarti jika panjang sepal meningkat, lebar sepal akan menurun secara linear.
Sekilas, tampaknya ada korelasi negatif pada plot di atas: ketika panjang sepal meningkat, Anda melihat lebar sepal sedikit menurun.
Sekarang mari buat scatter plot 'sepal length' terhadap 'sepal width', diwarnai berdasarkan target (species):
sns.lmplot(x='sepal length (cm)', y='sepal width (cm)', fit_reg=False, data=df_iris, hue='target');
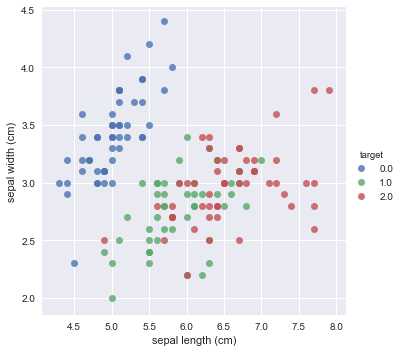
Sekilas, tampak bahwa plot di atas menunjukkan korelasi positif: untuk setiap spesies bunga iris, terlihat ketika panjang sepal meningkat, lebar sepal juga meningkat.
Visualisasi adalah cara yang bagus untuk mendapatkan intuisi tentang korelasi, tetapi cara lain untuk memikirkannya lebih jauh adalah benar-benar menghitung koefisien korelasi.
Anda dapat menghitung koefisien korelasi untuk setiap pasangan pengukuran dengan bantuan metode .corr():
df_iris.corr()
| sepal length (cm) | sepal width (cm) | petal length (cm) | petal width (cm) | target | |
|---|---|---|---|---|---|
| sepal length (cm) | 1.000000 | -0.109369 | 0.871754 | 0.817954 | 0.782561 |
| sepal width (cm) | -0.109369 | 1.000000 | -0.420516 | -0.356544 | -0.419446 |
| petal length (cm) | 0.871754 | -0.420516 | 1.000000 | 0.962757 | 0.949043 |
| petal width (cm) | 0.817954 | -0.356544 | 0.962757 | 1.000000 | 0.956464 |
| target | 0.782561 | -0.419446 | 0.949043 | 0.956464 | 1.000000 |
Catatan bahwa 'sepal length (cm)' dan 'sepal width (cm)' tampaknya berkorelasi negatif! Dan memang demikian, di seluruh populasi bunga yang diukur. Anda melihat koefisien korelasinya -0,1. Namun, mereka tidak berkorelasi negatif dalam tiap spesies, karena koefisiennya 0,78.
Bagi yang tertarik, ini dikenal sebagai paradoks Simpson dan sangat penting saat memikirkan inferensi kausal. Anda dapat membaca lebih lanjut di sini.
Mari telusuri lebih jauh. Mari hitung koefisien korelasi setiap pasangan pengukuran dalam tiap spesies. Caranya dengan merangkai metode .groupby() dan .corr(), untuk mengelompokkan berdasarkan target dan menampilkan koefisien korelasi:
df_iris.groupby(['target']).corr()
| petal length (cm) | petal width (cm) | sepal length (cm) | sepal width (cm) | ||
|---|---|---|---|---|---|
| target | |||||
| 0.0 | petal length (cm) | 1.000000 | 0.306308 | 0.263874 | 0.176695 |
| petal width (cm) | 0.306308 | 1.000000 | 0.279092 | 0.279973 | |
| sepal length (cm) | 0.263874 | 0.279092 | 1.000000 | 0.746780 | |
| sepal width (cm) | 0.176695 | 0.279973 | 0.746780 | 1.000000 | |
| 1.0 | petal length (cm) | 1.000000 | 0.786668 | 0.754049 | 0.560522 |
| petal width (cm) | 0.786668 | 1.000000 | 0.546461 | 0.663999 | |
| sepal length (cm) | 0.754049 | 0.546461 | 1.000000 | 0.525911 | |
| sepal width (cm) | 0.560522 | 0.663999 | 0.525911 | 1.000000 | |
| 2.0 | petal length (cm) | 1.000000 | 0.322108 | 0.864225 | 0.401045 |
| petal width (cm) | 0.322108 | 1.000000 | 0.281108 | 0.537728 | |
| sepal length (cm) | 0.864225 | 0.281108 | 1.000000 | 0.457228 | |
| sepal width (cm) | 0.401045 | 0.537728 | 0.457228 | 1.000000 |
Dalam matriks korelasi ini, Anda dapat melihat bahwa:
Semua ini adalah tingkat korelasi positif yang menurun, tetapi semuanya jauh lebih positif dibanding korelasi negatif awal Anda.
Ini sangat informatif dan menjadi pengingat jelas akan pentingnya menganalisis data secara menyeluruh.
Sekarang setelah Anda meninjau korelasi lebih dekat, Anda siap menganalisis periodisitas pada deret waktu dengan melihat fungsi autokorelasinya!
Untuk mulai, plot kembali semua deret waktu Anda untuk mengingat tampilannya:
df.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
Kemudian, hitung koefisien korelasi dari semua deret waktu ini dengan bantuan .corr():
df.corr()
| diet | gym | finance | |
|---|---|---|---|
| diet | 1.000000 | -0.100764 | -0.034639 |
| gym | -0.100764 | 1.000000 | -0.284279 |
| finance | -0.034639 | -0.284279 | 1.000000 |
Sekarang, apa arti tabel di atas?
Fokus pada 'diet' dan 'gym'; Keduanya berkorelasi negatif. Menarik! Ingat bahwa Anda memiliki komponen musiman dan tren. Dari koefisien korelasi, 'diet' dan 'gym' berkorelasi negatif. Namun, dari melihat deret waktunya, tampaknya komponen musiman mereka berkorelasi positif dan trennya berkorelasi negatif.
Koefisien korelasi aktual sebenarnya menangkap keduanya.
Sekarang Anda ingin memplot selisih orde pertama dari deret waktu tersebut lalu menghitung korelasinya karena itu akan menjadi korelasi komponen musiman, secara aproksimasi. Ingat bahwa menghapus tren dapat mengungkap korelasi pada musiman.
Mulailah dengan memplot selisih orde pertama dengan bantuan .diff() dan .plot():
df.diff().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
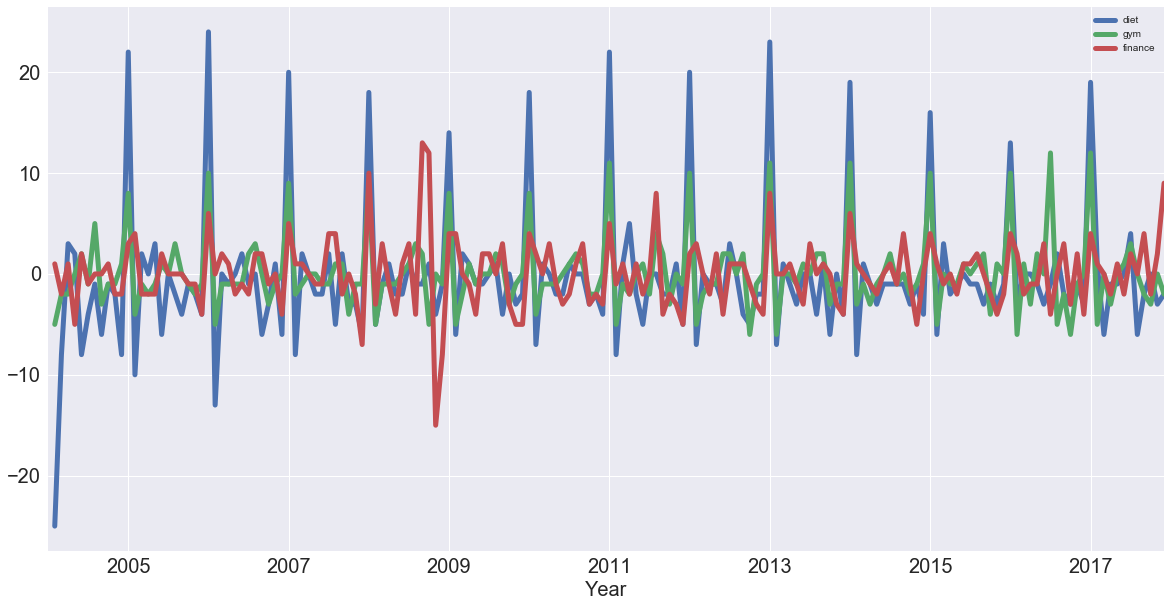
Anda melihat bahwa 'diet' dan 'gym' sangat berkorelasi setelah Anda menghapus tren. Sekarang, Anda akan menghitung koefisien korelasi dari selisih orde pertama deret waktu tersebut:
df.diff().corr()
| diet | gym | finance | |
|---|---|---|---|
| diet | 1.000000 | 0.758707 | 0.373828 |
| gym | 0.758707 | 1.000000 | 0.301111 |
| finance | 0.373828 | 0.301111 | 1.000000 |
Catatan bahwa sekali lagi, sebelumnya ada korelasi negatif ringan saat Anda memikirkan komponen tren dan musiman. Kini, pada komponen musiman, 'diet' dan 'gym' sangat berkorelasi, dengan koefisien 0,76.
Sekarang setelah Anda menelusuri korelasi antar variabel dan korelasi deret waktu, saatnya memplot autokorelasi dari series 'diet': pada sumbu x, Anda memiliki lag dan pada sumbu y, seberapa besar deret waktu berkorelasi dengan dirinya sendiri pada lag tersebut.
Jadi, ini berarti jika deret waktu asli berulang setiap dua hari, Anda akan melihat puncak pada fungsi autokorelasi di 2 hari.
Di sini, Anda akan melihat plot dan yang diharapkan adalah puncak pada fungsi autokorelasi di 12 bulan: deret waktu berkorelasi dengan dirinya sendiri yang digeser dua belas bulan.
Gunakan antarmuka plotting dari pandas, yang memiliki fungsi autocorrelation_plot(). Anda dapat menggunakan fungsi ini untuk memplot deret waktu 'diet':
pd.plotting.autocorrelation_plot(diet);
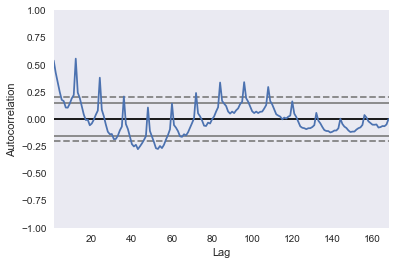
Jika Anda menyertakan lebih banyak lag pada sumbu, Anda akan melihat bahwa pada 12 bulan terdapat puncak korelasi yang besar. Ada puncak lain pada interval 24 bulan, di mana deret juga berkorelasi dengan dirinya sendiri. Ada puncak lain di 36, tetapi semakin jauh Anda bergeser, korelasi akan semakin berkurang.
Tentu saja, ada korelasi deret dengan dirinya sendiri pada lag 0.
Garis putus-putus pada plot di atas memberi tahu Anda tentang signifikansi statistik dari korelasi. Dalam kasus ini, Anda dapat mengatakan bahwa series 'diet' benar-benar memiliki autokorelasi dengan lag dua belas bulan.
Anda telah mengidentifikasi musiman dengan pengulangan 12 bulan ini!
Dalam tutorial ini, Anda membahas banyak hal! Anda meninjau data Google Trends untuk kata kunci 'diet', 'gym' dan sekilas 'finance' untuk melihat bagaimana perubahannya dari waktu ke waktu. Anda membahas konsep seperti musiman, tren, korelasi, autokorelasi, ...
Bagi data scientist yang antusias, ada dua hal yang bisa langsung Anda lakukan:
Pelajari lebih lanjut tentang Python
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



