Khóa học
Phân tích chuỗi thời gian với Python
4 giờ
70.9K
Trong buổi code along Facebook Live ngày 4 tháng 1, chúng ta đã xem dữ liệu Google Trends của các từ khóa 'diet', 'gym' và 'finance' để xem chúng biến động theo thời gian như thế nào. Chúng ta tự hỏi liệu có thể có nhiều lượt tìm kiếm cho các thuật ngữ này vào tháng 1 khi tất cả đều cố gắng bắt đầu một thói quen mới?
Trong hướng dẫn này, bạn sẽ đi qua từng bước đoạn mã mà chúng ta đã cùng xây dựng trong phiên. Bạn sẽ không phải làm nhiều toán học. Trọng tâm của hướng dẫn này sẽ là khám phá trực quan bộ dữ liệu đang xét.
Để tìm hiểu thêm về pandas, hãy xem lộ trình Data Manipulation with Python của DataCamp. Để tìm hiểu thêm về chuỗi thời gian với pandas, hãy xem khóa học Manipulating Time Series Data in Python.
Vậy câu hỏi vẫn còn đó: liệu có nhiều lượt tìm kiếm cho các thuật ngữ này vào tháng 1 khi tất cả đều cố gắng thay đổi bản thân?
Hãy cùng tìm hiểu bằng cách truy cập tại đây và xem dữ liệu. Lưu ý rằng hướng dẫn này lấy cảm hứng từ bài viết của FiveThirtyEight này.
Bạn cũng có thể tải dữ liệu dưới dạng .csv, lưu vào tệp và nhập vào môi trường Python của riêng bạn để tự thực hiện phân tích. Bạn sẽ làm điều này ngay bây giờ. Bắt đầu thôi!
Trước tiên, bạn sẽ nhập một số gói: trong trường hợp này, bạn sẽ sử dụng numpy, pandas, matplotlib và seaborn.
Ngoài ra, nếu bạn muốn hiển thị hình vẽ ngay trong Jupyter Notebook, bạn có thể dùng IPython magic bằng cách thêm %matplotlib inline vào mã. Hoặc, bạn cũng có thể chuyển sang dùng mặc định của Seaborn với sns.set():
# Import packages
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
%matplotlib inline
sns.set()
Nhập dữ liệu bạn đã tải bằng .read_csv() và xem vài hàng đầu tiên với .head().
Lưu ý rằng bạn thêm đối số skiprows để bỏ qua hàng đầu tiên ở đầu tệp.
 df = pd.read_csv('data/multiTimeline.csv', skiprows=1)
df.head()| Month | diet: (Worldwide) | gym: (Worldwide) | finance: (Worldwide) | |
|---|---|---|---|---|
| 0 | 2004-01 | 100 | 31 | 48 |
| 1 | 2004-02 | 75 | 26 | 49 |
| 2 | 2004-03 | 67 | 24 | 47 |
| 3 | 2004-04 | 70 | 22 | 48 |
| 4 | 2004-05 | 72 | 22 | 43 |
Bạn cũng có thể dùng phương thức .info() để xem kiểu dữ liệu, số hàng và nhiều thông tin khác:
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 168 entries, 0 to 167
Data columns (total 4 columns):
Month                   168 non-null object
diet: (Worldwide)       168 non-null int64
gym: (Worldwide)        168 non-null int64
finance: (Worldwide)    168 non-null int64
dtypes: int64(3), object(1)
memory usage: 5.3+ KB
Bây giờ bạn đã nhập dữ liệu từ Google Trends và xem qua nhanh, đã đến lúc xử lý dữ liệu và đưa nó về dạng mong muốn để chuẩn bị cho phân tích.
Việc đầu tiên bạn muốn làm là đổi tên các cột của DataFrame df để chúng không có khoảng trắng. Có nhiều cách để làm điều này, nhưng trước mắt, bạn sẽ gán lại cho df.columns một danh sách tên cột mong muốn.
Kiểm tra lại kết quả gán bằng cách gọi df.head():
df.columns = ['month', 'diet', 'gym', 'finance']
df.head()
| month | diet | gym | finance | |
|---|---|---|---|---|
| 0 | 2004-01 | 100 | 31 | 48 |
| 1 | 2004-02 | 75 | 26 | 49 |
| 2 | 2004-03 | 67 | 24 | 47 |
| 3 | 2004-04 | 70 | 22 | 48 |
| 4 | 2004-05 | 72 | 22 | 43 |
Tiếp theo, bạn sẽ chuyển cột 'month' sang kiểu dữ liệu DateTime và đặt nó làm chỉ mục của DataFrame.
Lưu ý rằng bạn làm vậy vì bạn thấy trong kết quả phương thức .info() cột 'Month' thực ra có kiểu dữ liệu object. Kiểu dữ liệu chung này bao gồm mọi thứ từ chuỗi đến số nguyên, v.v. Đó không phải điều bạn muốn khi làm việc với dữ liệu chuỗi thời gian. Vì vậy, bạn sẽ dùng .to_datetime() để chuyển cột 'month' trong DataFrame sang DateTime.
Cẩn thận! Hãy đảm bảo thêm đối số inplace khi bạn đặt chỉ mục cho DataFrame df để thực sự thay đổi chỉ mục gốc và đặt nó thành cột 'month'.
df.month = pd.to_datetime(df.month)
df.set_index('month', inplace=True)
df.head()
| diet | gym | finance | |
|---|---|---|---|
| month | |||
| 2004-01-01 | 100 | 31 | 48 |
| 2004-02-01 | 75 | 26 | 49 |
| 2004-03-01 | 67 | 24 | 47 |
| 2004-04-01 | 70 | 22 | 48 |
| 2004-05-01 | 72 | 22 | 43 |
Bây giờ là lúc khám phá DataFrame của bạn một cách trực quan.
Bạn có thể dùng phương thức trực quan hóa tích hợp của pandas là .plot() để vẽ dữ liệu dưới dạng 3 biểu đồ đường trên một hình (mỗi cột một biểu đồ, cụ thể là 'diet', 'gym' và 'finance').
Lưu ý rằng bạn cũng có thể chỉ định một số đối số cho phương thức này, như figsize, linewidth và fontsize để lần lượt đặt kích thước hình, độ dày đường và cỡ chữ của biểu đồ.
Ngoài ra, bạn sẽ thấy trên trục x không phải là các tháng như nhãn mặc định gợi ý, mà là các năm. Để biểu đồ chính xác hơn, bạn sẽ đặt lại nhãn trục x thành 'Year' và đặt cỡ chữ là 20.
Mẹo: nếu bạn muốn ẩn đầu ra của Matplotlib, chỉ cần thêm dấu chấm phẩy ; ở dòng mã cuối!
df.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
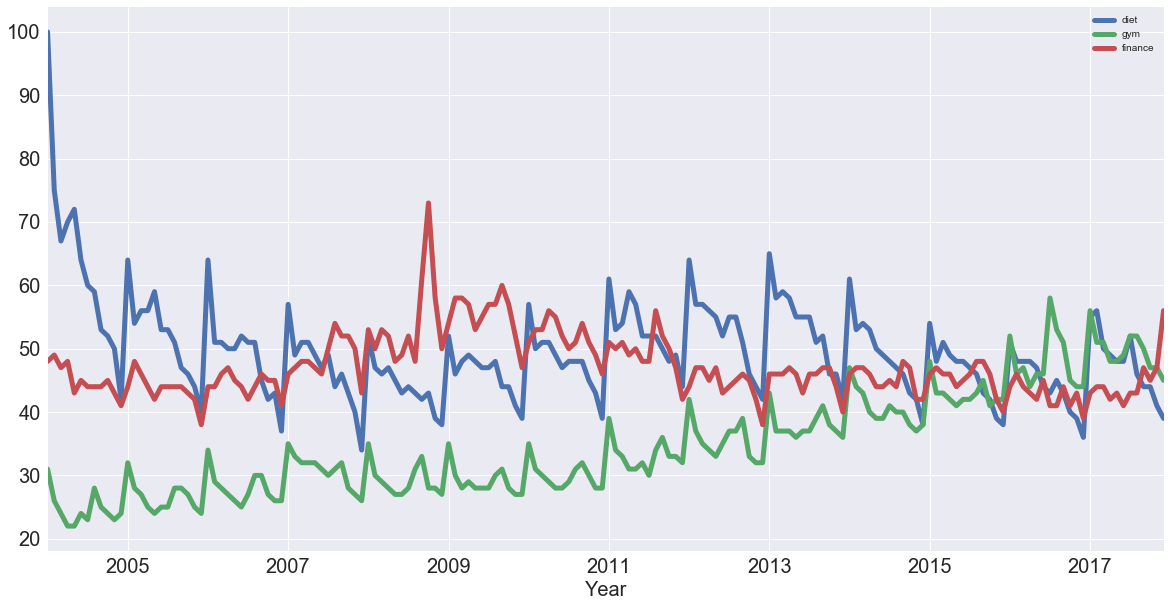
Lưu ý rằng dữ liệu này là tương đối. Như bạn có thể đọc trên Google Trends:
Các con số thể hiện mức độ quan tâm tìm kiếm tương đối so với điểm cao nhất trên biểu đồ cho khu vực và khoảng thời gian đã cho. Giá trị 100 là mức phổ biến cao nhất của thuật ngữ. Giá trị 50 có nghĩa là thuật ngữ đó phổ biến bằng một nửa. Tương tự, điểm số 0 nghĩa là thuật ngữ đó ít phổ biến hơn 1% so với mức đỉnh.
Nếu muốn, bạn cũng có thể vẽ riêng cột 'diet' như một chuỗi thời gian:
df[['diet']].plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
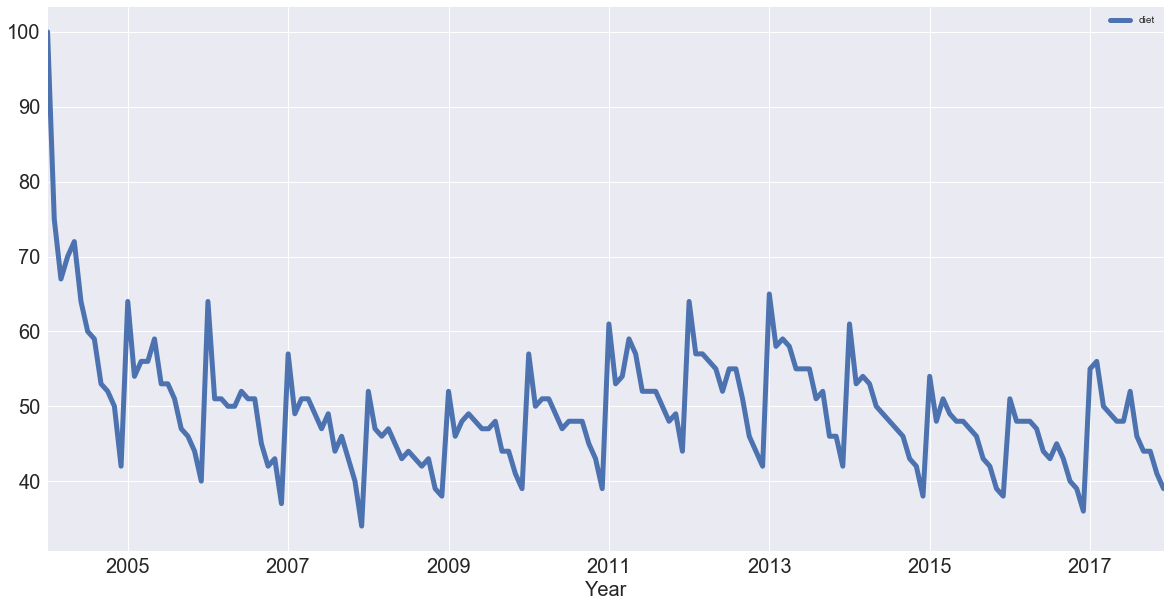
Lưu ý: điều đầu tiên cần nhận thấy là có tính mùa vụ: mỗi tháng 1, có một cú nhảy lớn. Cũng có vẻ có xu hướng: dường như tăng nhẹ, rồi giảm, rồi tăng lại và lại giảm. Nói cách khác, có vẻ như các chuỗi thời gian này có cả thành phần xu hướng và mùa vụ.
Với điều này trong đầu, bạn sẽ học cách nhận diện xu hướng trong chuỗi thời gian!
Có vài cách để nghĩ về việc nhận diện xu hướng trong chuỗi thời gian. Một cách phổ biến là lấy trung bình trượt, tức là với mỗi thời điểm, bạn lấy trung bình của các điểm ở hai bên nó. Lưu ý rằng số lượng điểm được xác định bởi kích thước cửa sổ, và bạn cần lựa chọn giá trị này.
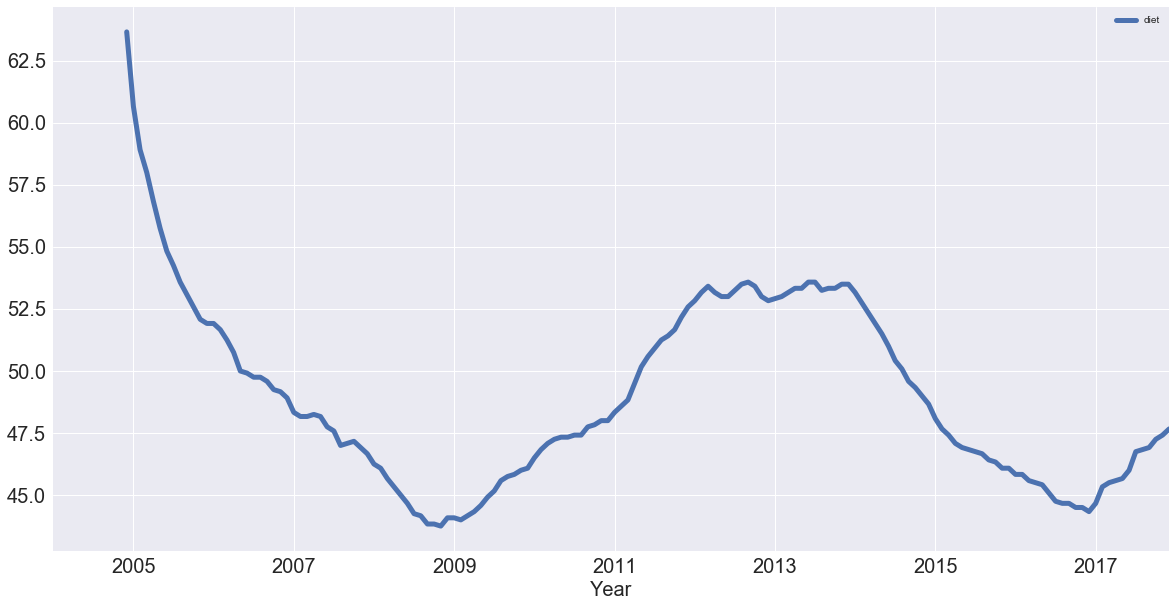
Do bạn lấy trung bình, điều xảy ra là nó có xu hướng làm mượt nhiễu và tính mùa vụ. Bạn sẽ thấy ví dụ ngay bây giờ. Xem trung bình trượt của 'diet' bằng các phương thức tích hợp của pandas.
Khi xác định kích thước cửa sổ, ở đây hợp lý là thử trước cửa sổ 12 tháng, vì bạn đang nói về mùa vụ hàng năm.
diet = df[['diet']]
diet.rolling(12).mean().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
Lưu ý rằng trong khối mã trên, bạn dùng hai cặp ngoặc vuông để trích xuất cột 'diet' dưới dạng một DataFrame; Nếu dùng một cặp như df['diet'], bạn sẽ tạo ra một pandas Series.
Trong khối mã trên, bạn cũng xâu chuỗi phương thức: bạn gọi các phương thức trên một đối tượng lần lượt. Xâu chuỗi phương thức khá phổ biến và pandas là một trong những gói cho phép bạn dùng phong cách lập trình này rất hiệu quả!
Bây giờ bạn đã có xu hướng mình cần! Bạn đã loại bỏ phần lớn tính mùa vụ so với biểu đồ trước.
Bạn cũng có thể vẽ trung bình trượt của 'gym' bằng các phương thức tích hợp của pandas với cùng kích thước cửa sổ như dữ liệu 'diet':
gym = df[['gym']]
gym.rolling(12).mean().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
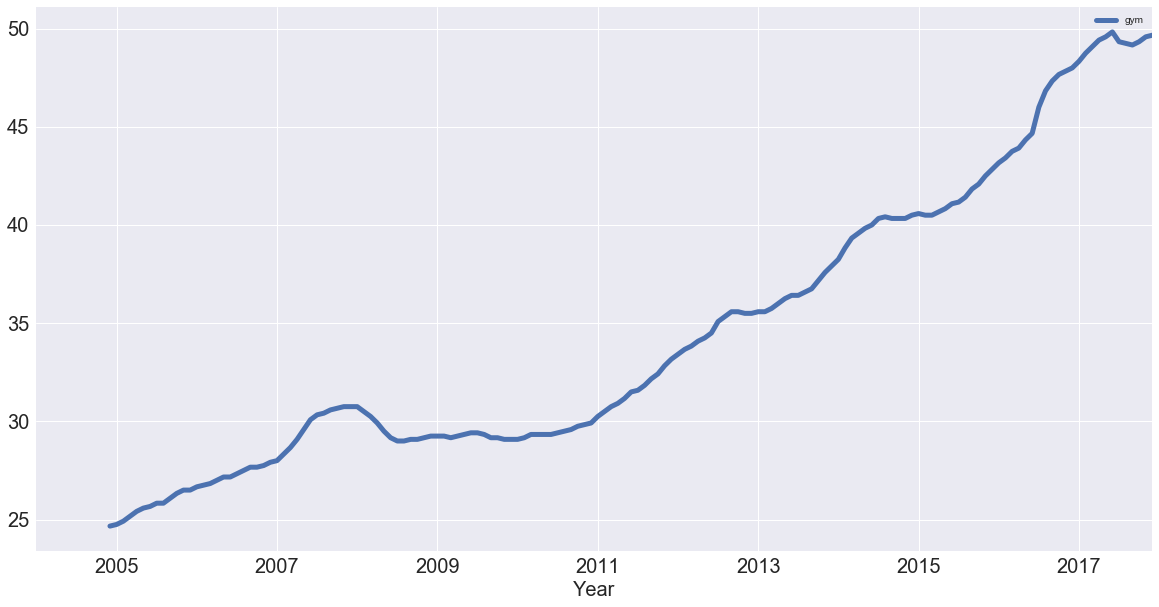
Bạn đã loại bỏ thành công tính mùa vụ và thấy một xu hướng tăng cho "gym"! Nhưng hai thuật ngữ tìm kiếm này so sánh với nhau như thế nào?
Bạn có thể tìm ra bằng cách vẽ các xu hướng của 'gym' và 'diet' trên cùng một hình:
df_rm = pd.concat([diet.rolling(12).mean(), gym.rolling(12).mean()], axis=1)
df_rm.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
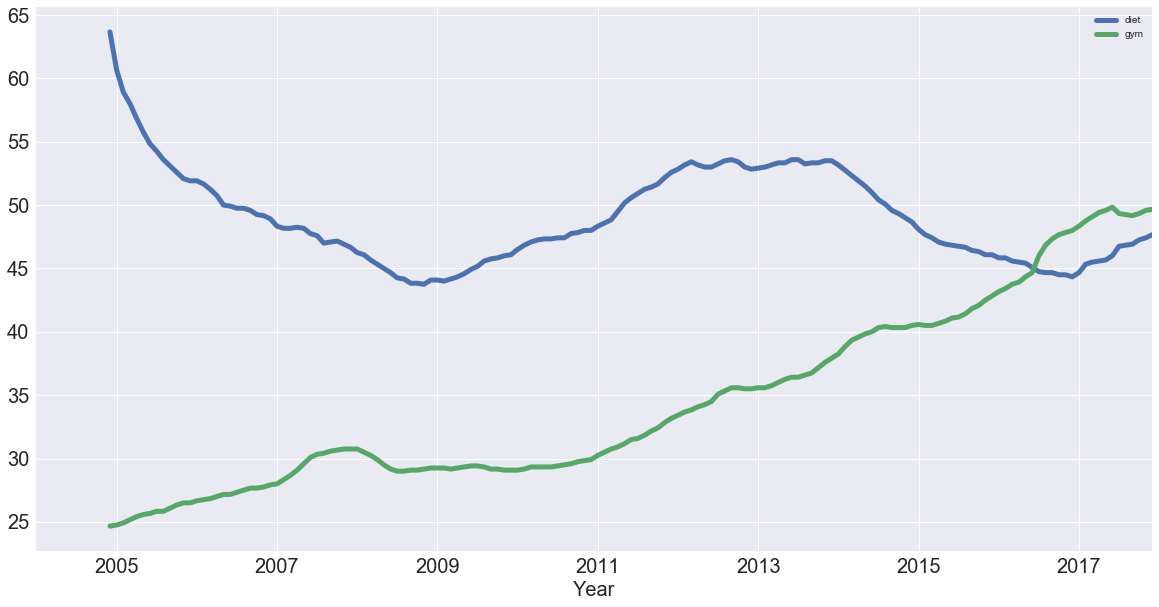
Bạn đã tạo một DataFrame mới df_rm có hai cột là trung bình trượt của 'diet' và 'gym'. Bạn dùng hàm pd.concat(), nhận danh sách các cột làm đối số đầu tiên và, vì bạn muốn nối theo cột, bạn thêm đối số axis và đặt là 1.
Tiếp theo, bạn vẽ DataFrame với phương thức plot(), giống như trước! Vậy là, sau khi loại bỏ tính mùa vụ, bạn thấy diet có thể vẫn còn một số dạng mùa vụ, trong khi gym thực sự đang tăng!
Sau khi đã nhận diện xu hướng trong dữ liệu, đã đến lúc nghĩ về tính mùa vụ, tức tính lặp lại của chuỗi thời gian. Như bạn thấy ở đầu hướng dẫn, có vẻ như chuỗi thời gian của dữ liệu có cả thành phần xu hướng và mùa vụ.
Một cách nghĩ về thành phần mùa vụ của chuỗi thời gian là loại bỏ xu hướng khỏi chuỗi, để bạn có thể dễ dàng khảo sát tính mùa vụ hơn. Để loại bỏ xu hướng, bạn có thể trừ đi xu hướng đã tính ở trên (trung bình trượt) khỏi tín hiệu gốc. Tuy nhiên, điều này sẽ phụ thuộc vào số điểm dữ liệu bạn đã lấy trung bình.
Một cách khác để loại bỏ xu hướng gọi là "sai phân", trong đó bạn xét hiệu giữa các điểm dữ liệu liên tiếp (gọi là "sai phân bậc nhất", vì bạn chỉ xét hiệu giữa một điểm dữ liệu và điểm ngay trước nó).
Bạn có thể dùng pandas và các phương thức diff() và plot() để tính và vẽ sai phân bậc nhất của Series 'diet':
diet.diff().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
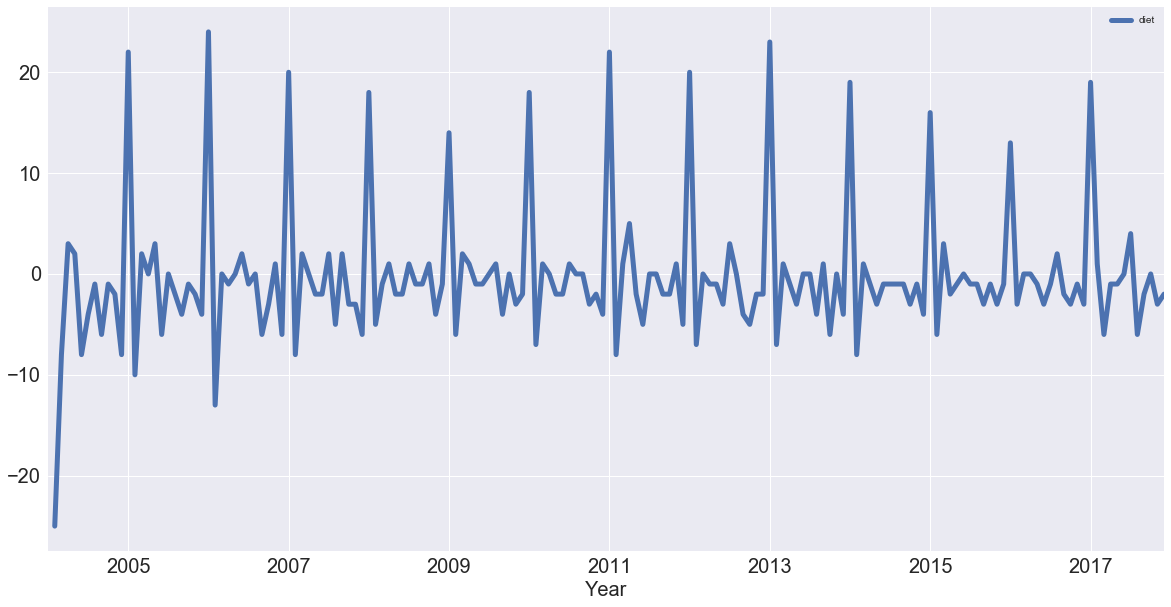
Thấy rằng bạn đã loại bỏ phần lớn xu hướng và có thể thật sự nhìn rõ các đỉnh vào tháng 1 mỗi năm. Mỗi tháng 1, có một cú tăng vọt 20% hoặc hơn ở mục tìm kiếm cao nhất mà bạn thấy!
Lưu ý: bạn cũng có thể thực hiện sai phân bậc 2, tức bạn sẽ xét hiệu giữa một điểm dữ liệu và hai điểm đứng trước nó, nếu xu hướng vẫn chưa bị loại bỏ hoàn toàn. Xem thêm tại đây về sai phân.
Sai phân rất hữu ích để biến chuỗi thời gian của bạn thành chuỗi thời gian dừng (stationary). Bạn sẽ không đi quá sâu ở đây, nhưng chuỗi thời gian dừng là chuỗi có các đặc tính thống kê (như trung bình và phương sai) không đổi theo thời gian. Những chuỗi này hữu ích vì nhiều phương pháp dự báo chuỗi thời gian dựa trên giả định chuỗi thời gian xấp xỉ dừng.
Với tất cả những điều này, bây giờ bạn sẽ phân tích tính chu kỳ trong chuỗi thời gian bằng cách xem hàm tự tương quan của nó. Nhưng trước đó, bạn sẽ vòng qua một chút về tương quan.
Một chuỗi thời gian là có chu kỳ nếu nó lặp lại theo những khoảng đều nhau, ví dụ, mỗi 12 tháng.
Một cách nghĩ khác là nếu chuỗi thời gian có một đỉnh ở đâu đó, thì nó sẽ có một đỉnh sau đó 12 tháng, và nếu có một đáy ở đâu đó, thì cũng sẽ có một đáy sau đó 12 tháng.
Một cách nghĩ khác nữa là chuỗi thời gian tương quan với chính nó khi được tịnh tiến 12 tháng. Điều đó nghĩa là, nếu bạn lấy chuỗi thời gian và dịch nó lùi hoặc tiến 12 tháng, nó sẽ phần nào trùng khớp với chính nó.
Xét tương quan của chuỗi thời gian với phiên bản dịch của chính nó được thể hiện bởi khái niệm tự tương quan.
Bạn sẽ đi đến điều này ngay.
Trước tiên, hãy nhắc lại về tương quan và tiếp cận khái niệm này một cách trực quan!
Hệ số tương quan của hai biến thể hiện mức độ quan hệ tuyến tính của chúng. Để hiểu điều này, bạn sẽ xem một ví dụ thực tế với bộ dữ liệu iris, chứa các phép đo hoa.
Để nghiên cứu kỹ hơn, bạn sẽ nhập bộ dữ liệu iris từ scikit-learn, chuyển nó thành DataFrame và xem các hàng đầu tiên với .head():
from sklearn import datasets
iris = datasets.load_iris()
df_iris = pd.DataFrame(data= np.c_[iris['data'], iris['target']],
                     columns= iris['feature_names'] + ['target'])
df_iris.head()
| sepal length (cm) | sepal width (cm) | petal length (cm) | petal width (cm) | target | |
|---|---|---|---|---|---|
| 0 | 5.1 | 3.5 | 1.4 | 0.2 | 0.0 |
| 1 | 4.9 | 3.0 | 1.4 | 0.2 | 0.0 |
| 2 | 4.7 | 3.2 | 1.3 | 0.2 | 0.0 |
| 3 | 4.6 | 3.1 | 1.5 | 0.2 | 0.0 |
| 4 | 5.0 | 3.6 | 1.4 | 0.2 | 0.0 |
Nhắc lại để bạn hiểu bộ dữ liệu này, mọi bông hoa đều có lá đài (sepal) và cánh hoa (petal). Lá đài bao bọc cánh hoa và thường có màu xanh, giống lá; còn cánh hoa thường có màu sắc. Cột 'target', là biến mục tiêu, là loài của hoa iris, có thể là Versicolor, Virginica hoặc Setosa. Trong bảng trên, chúng được mã hóa là 0, 1 và 2.
Bây giờ, để nghĩ về tương quan, bạn sẽ xem độ tương quan giữa chiều dài lá đài và chiều rộng lá đài của hoa iris. Để làm điều này, bạn sẽ dùng pandas hoặc seaborn để dựng biểu đồ phân tán của 'sepal length' theo 'sepal width':
sns.lmplot(x='sepal length (cm)', y='sepal width (cm)', fit_reg=False, data=df_iris);
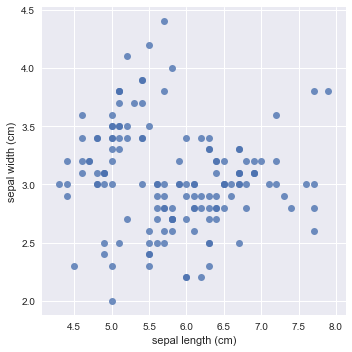
Lưu ý rằng bạn đã tắt hồi quy tuyến tính bằng cách đặt đối số fit_reg thành False.
Chiều dài và chiều rộng lá đài có tương quan dương hay âm trên toàn bộ tập hoa? Chúng có tương quan dương hay âm trong từng loài? Đây là một phân biệt thiết yếu.
Nhớ rằng trường hợp thứ nhất nghĩa là khi chiều dài lá đài tăng, chiều rộng lá đài cũng tăng theo cách tuyến tính. Trường hợp thứ hai nghĩa là nếu chiều dài lá đài tăng, chiều rộng lá đài sẽ giảm theo cách tuyến tính.
Thoạt nhìn, có vẻ có tương quan âm trong biểu đồ trên: khi chiều dài lá đài tăng, bạn thấy chiều rộng lá đài giảm nhẹ.
Bây giờ hãy dựng biểu đồ phân tán của 'sepal length' theo 'sepal width', tô màu theo biến mục tiêu (species):
sns.lmplot(x='sepal length (cm)', y='sepal width (cm)', fit_reg=False, data=df_iris, hue='target');
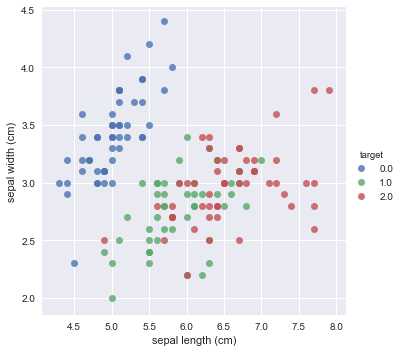
Thoạt nhìn, biểu đồ trên thể hiện tương quan dương: với mỗi loài hoa iris, bạn thấy khi chiều dài lá đài tăng, chiều rộng lá đài cũng tăng.
Trực quan hóa là cách tuyệt vời để có trực giác về tương quan, nhưng cách bạn có thể đi sâu hơn là thực sự tính hệ số tương quan.
Bạn có thể tính các hệ số tương quan của từng cặp phép đo với phương thức .corr():
df_iris.corr()
| sepal length (cm) | sepal width (cm) | petal length (cm) | petal width (cm) | target | |
|---|---|---|---|---|---|
| sepal length (cm) | 1.000000 | -0.109369 | 0.871754 | 0.817954 | 0.782561 |
| sepal width (cm) | -0.109369 | 1.000000 | -0.420516 | -0.356544 | -0.419446 |
| petal length (cm) | 0.871754 | -0.420516 | 1.000000 | 0.962757 | 0.949043 |
| petal width (cm) | 0.817954 | -0.356544 | 0.962757 | 1.000000 | 0.956464 |
| target | 0.782561 | -0.419446 | 0.949043 | 0.956464 | 1.000000 |
Lưu ý rằng 'sepal length (cm)' và 'sepal width (cm)' dường như tương quan âm! Và đúng là như vậy, trên toàn bộ quần thể hoa được đo. Bạn thấy hệ số tương quan là -0.1. Tuy nhiên, chúng không tương quan âm trong từng loài, vì hệ số là 0.78.
Với những ai quan tâm, đây được gọi là nghịch lý Simpson và rất quan trọng khi nghĩ về suy luận nhân quả. Bạn có thể đọc thêm tại đây.
Hãy khám phá sâu hơn. Hãy tính các hệ số tương quan của từng cặp phép đo trong từng loài. Cách làm là xâu chuỗi các phương thức .groupby() và .corr(), để nhóm theo biến mục tiêu và in hệ số tương quan:
df_iris.groupby(['target']).corr()
| petal length (cm) | petal width (cm) | sepal length (cm) | sepal width (cm) | ||
|---|---|---|---|---|---|
| target | |||||
| 0.0 | petal length (cm) | 1.000000 | 0.306308 | 0.263874 | 0.176695 |
| petal width (cm) | 0.306308 | 1.000000 | 0.279092 | 0.279973 | |
| sepal length (cm) | 0.263874 | 0.279092 | 1.000000 | 0.746780 | |
| sepal width (cm) | 0.176695 | 0.279973 | 0.746780 | 1.000000 | |
| 1.0 | petal length (cm) | 1.000000 | 0.786668 | 0.754049 | 0.560522 |
| petal width (cm) | 0.786668 | 1.000000 | 0.546461 | 0.663999 | |
| sepal length (cm) | 0.754049 | 0.546461 | 1.000000 | 0.525911 | |
| sepal width (cm) | 0.560522 | 0.663999 | 0.525911 | 1.000000 | |
| 2.0 | petal length (cm) | 1.000000 | 0.322108 | 0.864225 | 0.401045 |
| petal width (cm) | 0.322108 | 1.000000 | 0.281108 | 0.537728 | |
| sepal length (cm) | 0.864225 | 0.281108 | 1.000000 | 0.457228 | |
| sepal width (cm) | 0.401045 | 0.537728 | 0.457228 | 1.000000 |
Trong ma trận tương quan này, bạn có thể thấy rằng:
Đó đều là các mức tương quan dương giảm dần, nhưng tất cả đều dương hơn rất nhiều so với tương quan âm ban đầu của bạn.
Điều này cực kỳ đáng chú ý và là lời nhắc rõ ràng về tầm quan trọng của việc phân tích kỹ lưỡng dữ liệu.
Bây giờ bạn đã xem xét kỹ hơn về tương quan, bạn sẵn sàng phân tích tính chu kỳ trong chuỗi thời gian bằng cách xem hàm tự tương quan!
Để bắt đầu, hãy vẽ lại tất cả các chuỗi thời gian để nhắc lại chúng trông như thế nào:
df.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
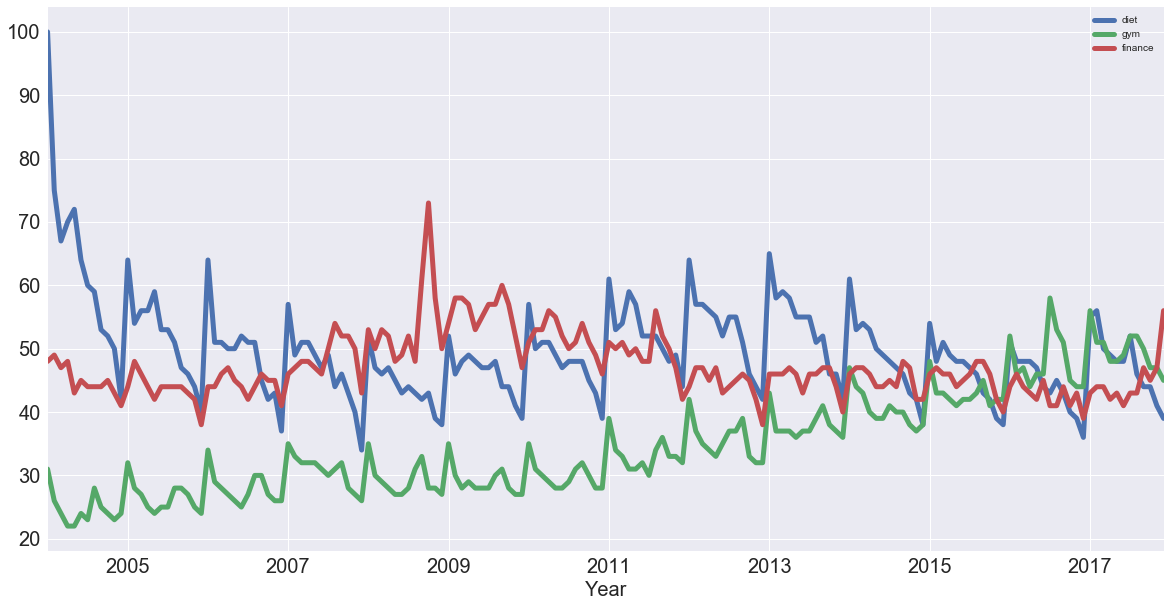
Sau đó, tính các hệ số tương quan của tất cả các chuỗi thời gian này với .corr():
df.corr()
| diet | gym | finance | |
|---|---|---|---|
| diet | 1.000000 | -0.100764 | -0.034639 |
| gym | -0.100764 | 1.000000 | -0.284279 |
| finance | -0.034639 | -0.284279 | 1.000000 |
Bây giờ, điều trên nói gì với bạn?
Hãy tập trung vào 'diet' và 'gym'; Chúng tương quan âm. Điều đó rất thú vị! Hãy nhớ rằng bạn có cả thành phần mùa vụ và xu hướng. Từ hệ số tương quan, 'diet' và 'gym' là tương quan âm. Tuy nhiên, khi nhìn vào các chuỗi thời gian, có vẻ như các thành phần mùa vụ của chúng sẽ tương quan dương và các xu hướng tương quan âm.
Hệ số tương quan thực tế đang gộp cả hai yếu tố đó.
Điều bạn muốn làm bây giờ là vẽ sai phân bậc nhất của các chuỗi thời gian này rồi tính tương quan của chúng, vì đó sẽ xấp xỉ tương quan của các thành phần mùa vụ. Hãy nhớ rằng loại bỏ xu hướng có thể làm lộ ra tương quan trong mùa vụ.
Bắt đầu bằng cách vẽ sai phân bậc nhất với .diff() và .plot():
df.diff().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
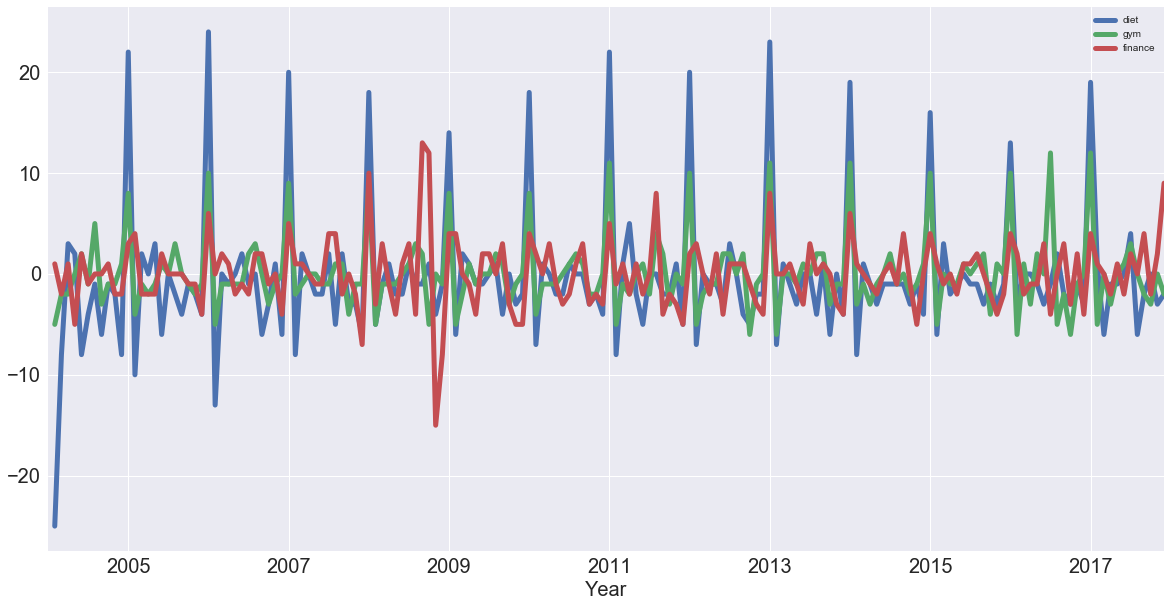
Bạn thấy rằng 'diet' và 'gym' cực kỳ tương quan khi bạn loại bỏ xu hướng. Bây giờ, bạn sẽ tính các hệ số tương quan của sai phân bậc nhất của các chuỗi thời gian này:
df.diff().corr()
| diet | gym | finance | |
|---|---|---|---|
| diet | 1.000000 | 0.758707 | 0.373828 |
| gym | 0.758707 | 1.000000 | 0.301111 |
| finance | 0.373828 | 0.301111 | 1.000000 |
Lưu ý rằng một lần nữa, đã có một tương quan âm nhẹ khi bạn xét cả xu hướng và mùa vụ. Bây giờ, bạn có thể thấy với thành phần mùa vụ, 'diet' và 'gym' tương quan rất cao, với hệ số 0.76.
Bây giờ bạn đã đi sâu vào tương quan của các biến và tương quan của các chuỗi thời gian, đã đến lúc vẽ tự tương quan của chuỗi 'diet': trên trục x là độ trễ (lag) và trên trục y là mức độ tương quan của chuỗi với chính nó tại độ trễ đó.
Điều này nghĩa là nếu chuỗi gốc lặp lại mỗi hai ngày, bạn kỳ vọng thấy một đỉnh trong hàm tự tương quan tại mốc 2 ngày.
Ở đây, bạn sẽ xem biểu đồ và kỳ vọng thấy một đỉnh trong hàm tự tương quan tại 12 tháng: chuỗi thời gian tương quan với chính nó khi dịch 12 tháng.
Dùng giao diện plotting của pandas, có hàm autocorrelation_plot(). Bạn có thể dùng hàm này để vẽ chuỗi thời gian 'diet':
pd.plotting.autocorrelation_plot(diet);
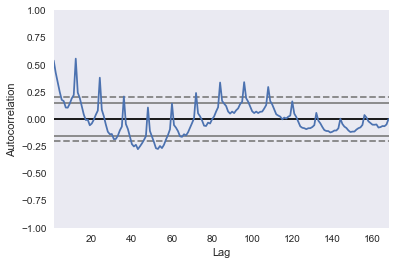
Nếu bạn hiển thị nhiều độ trễ hơn trên trục, bạn sẽ thấy tại 12 tháng có một đỉnh rất lớn về tương quan. Bạn có một đỉnh khác tại khoảng 24 tháng, nơi nó cũng tương quan với chính nó. Lại có một đỉnh tại 36 tháng, nhưng khi đi xa hơn, mức độ tương quan giảm dần.
Tất nhiên, bạn có tương quan của chính nó với chính nó tại độ trễ 0.
Các đường chấm trong biểu đồ trên thực ra cho bạn biết về ý nghĩa thống kê của tương quan. Trong trường hợp này, bạn có thể nói rằng chuỗi 'diet' thật sự tự tương quan với độ trễ mười hai tháng.
Bạn đã xác định được tính mùa vụ lặp lại 12 tháng này!
Trong hướng dẫn này, bạn đã đi qua rất nhiều nội dung! Bạn đã xem dữ liệu Google Trends của các từ khóa 'diet', 'gym' và lướt qua 'finance' để xem chúng biến động theo thời gian như thế nào. Bạn đã đề cập đến các khái niệm như mùa vụ, xu hướng, tương quan, tự tương quan, ...
Với những nhà khoa học dữ liệu háo hức, có hai việc bạn có thể làm ngay:
Tìm hiểu thêm về Python
Khóa học
Khóa học
Khóa học