Curso
Análise de séries temporais em Python
4 h
70.6K
Na sessão de code along no Facebook Live do dia 4 de janeiro, analisamos os dados do Google Trends para as palavras-chave "diet", "gym" e "finance" para ver como elas variam ao longo do tempo. Perguntamos: será que há mais buscas por esses termos em janeiro, quando todo mundo quer começar o ano com o pé direito?
Neste tutorial, você vai percorrer, passo a passo, o código que montamos durante a sessão. Não vamos focar em matemática pesada. A ênfase aqui é uma exploração visual do conjunto de dados em questão.
Para saber mais sobre pandas, confira a trilha de aprendizado Data Manipulation with Python da DataCamp. Para mais conteúdo sobre séries temporais com pandas, veja o curso Manipulating Time Series Data in Python.
Então a pergunta permanece: será que há mais buscas por esses termos em janeiro, quando estamos tentando começar uma nova fase?
Vamos descobrir acessando este link e conferindo os dados. Observação: este tutorial foi inspirado nesta matéria do FiveThirtyEight.
Você também pode baixar os dados em .csv, salvar em um arquivo e importar no seu próprio ambiente Python para fazer sua análise. Vamos fazer isso agora. Mãos à obra!
Para começar, importe alguns pacotes: neste caso, vamos usar numpy, pandas, matplotlib e seaborn.
Além disso, se quiser que as imagens sejam exibidas no Jupyter Notebook, use o magic do IPython adicionando %matplotlib inline ao seu código. Como alternativa, você também pode ativar os padrões do Seaborn com sns.set():
# Import packages
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
%matplotlib inline
sns.set()
Importe os dados que você baixou com .read_csv() e visualize as primeiras linhas com .head().
Observação: adicione o argumento skiprows para pular a primeira linha do arquivo.
 df = pd.read_csv('data/multiTimeline.csv', skiprows=1)
df.head()| Month | diet: (Worldwide) | gym: (Worldwide) | finance: (Worldwide) | |
|---|---|---|---|---|
| 0 | 2004-01 | 100 | 31 | 48 |
| 1 | 2004-02 | 75 | 26 | 49 |
| 2 | 2004-03 | 67 | 24 | 47 |
| 3 | 2004-04 | 70 | 22 | 48 |
| 4 | 2004-05 | 72 | 22 | 43 |
Você também pode usar o método .info() para conferir os tipos de dados, número de linhas e mais:
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 168 entries, 0 to 167
Data columns (total 4 columns):
Month                   168 non-null object
diet: (Worldwide)       168 non-null int64
gym: (Worldwide)        168 non-null int64
finance: (Worldwide)    168 non-null int64
dtypes: int64(3), object(1)
memory usage: 5.3+ KB
Agora que você importou os dados do Google Trends e deu uma olhada inicial, é hora de tratar os dados e deixá-los no formato ideal para a análise.
A primeira coisa é renomear as colunas do seu DataFrame df para remover espaços em branco. Há várias maneiras de fazer isso; por enquanto, vamos atribuir a df.columns uma lista com os novos nomes das colunas.
Confira o resultado chamando df.head():
df.columns = ['month', 'diet', 'gym', 'finance']
df.head()
| month | diet | gym | finance | |
|---|---|---|---|---|
| 0 | 2004-01 | 100 | 31 | 48 |
| 1 | 2004-02 | 75 | 26 | 49 |
| 2 | 2004-03 | 67 | 24 | 47 |
| 3 | 2004-04 | 70 | 22 | 48 |
| 4 | 2004-05 | 72 | 22 | 43 |
Em seguida, transforme a coluna 'month' em DateTime e use-a como índice do DataFrame.
Observação: fazemos isso porque, no resultado de .info(), vimos que a coluna 'Month' era do tipo object, que é genérico (pode ser string, inteiro etc.). Para séries temporais, isso não é o ideal. Por isso, usamos .to_datetime() para converter a coluna 'month' em DateTime.
Atenção! Inclua o argumento inplace ao definir o índice do DataFrame df para realmente alterar o índice original e defini-lo como a coluna 'month'.
df.month = pd.to_datetime(df.month)
df.set_index('month', inplace=True)
df.head()
| diet | gym | finance | |
|---|---|---|---|
| month | |||
| 2004-01-01 | 100 | 31 | 48 |
| 2004-02-01 | 75 | 26 | 49 |
| 2004-03-01 | 67 | 24 | 47 |
| 2004-04-01 | 70 | 22 | 48 |
| 2004-05-01 | 72 | 22 | 43 |
Agora é hora de explorar seu DataFrame visualmente.
Você pode usar o método de visualização do pandas, .plot(), para criar 3 gráficos de linha em uma única figura (um para cada coluna: 'diet', 'gym' e 'finance').
Dica: é possível especificar argumentos como figsize, linewidth e fontsize para ajustar o tamanho da figura, a espessura da linha e o tamanho da fonte, respectivamente.
Além disso, repare que o eixo x exibe anos (e não meses, como o rótulo padrão pode sugerir). Para deixar o gráfico mais fiel, altere o rótulo do eixo x para 'Year' e defina o tamanho da fonte como 20.
Truque: se quiser suprimir a saída do Matplotlib, basta adicionar um ponto e vírgula ; na última linha!
df.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
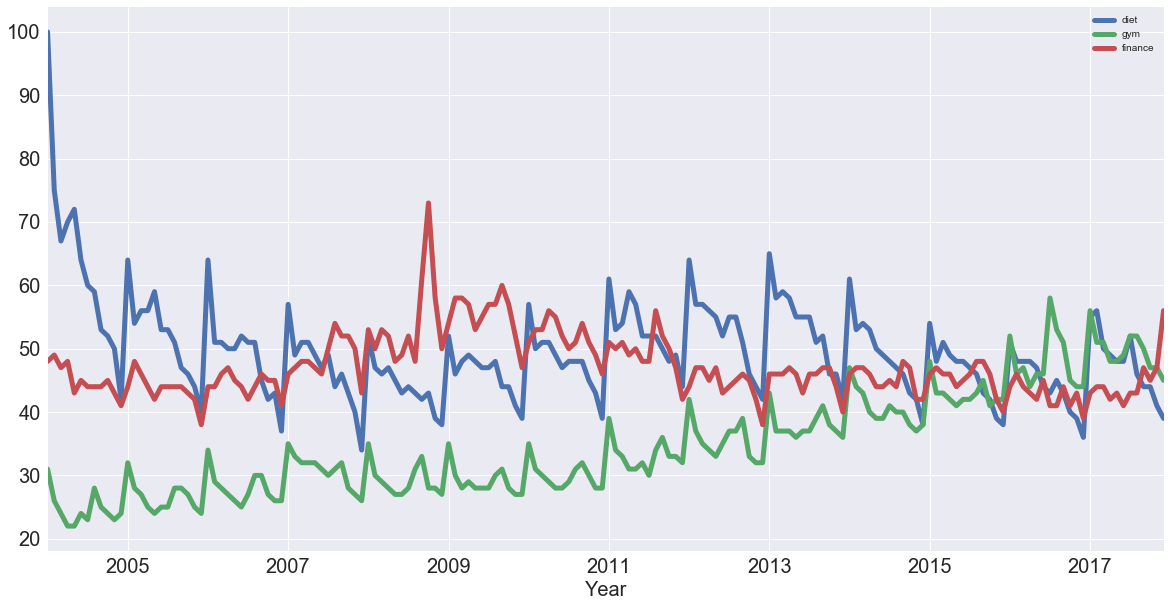
Observação: esses dados são relativos. Como explicado no Google Trends:
Os números representam o interesse de pesquisa em relação ao ponto mais alto do gráfico para a região e o período selecionados. Um valor de 100 indica pico de popularidade do termo. Um valor de 50 significa metade da popularidade. Um valor 0 significa que o termo teve menos de 1% da popularidade do pico.
Se quiser, você também pode plotar apenas a coluna 'diet' como uma série temporal:
df[['diet']].plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
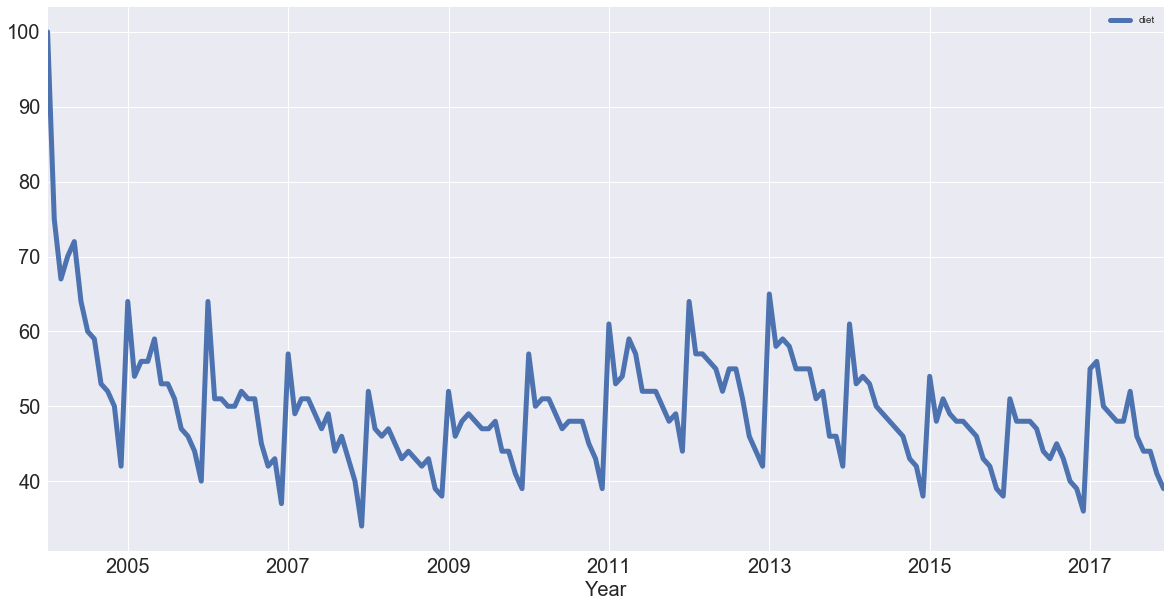
Observação: a primeira coisa a notar é a sazonalidade: todo mês de janeiro há um grande salto. Também parece haver uma tendência: sobe um pouco, depois cai, volta a subir e então cai de novo. Em outras palavras, há componentes de tendência e sazonais nessas séries temporais.
Com isso em mente, vamos aprender a identificar tendências na sua série temporal!
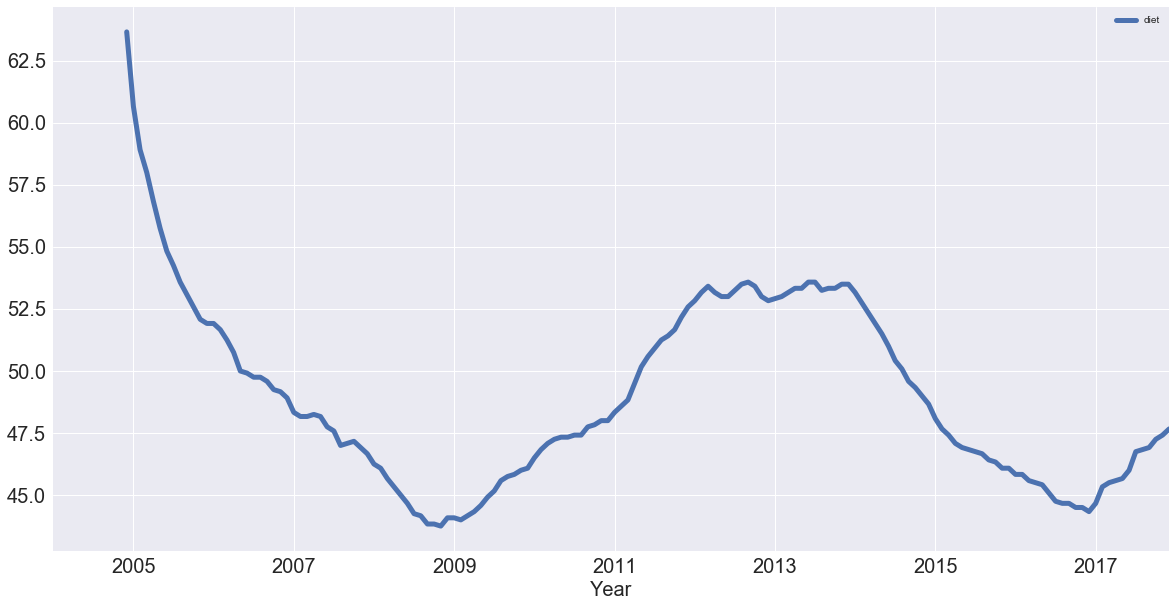
Há várias maneiras de identificar tendências em séries temporais. Uma bastante usada é a média móvel (rolling average), em que, para cada ponto no tempo, você calcula a média dos pontos ao seu redor. O número de pontos é definido por uma janela (window size) que você precisa escolher.
Ao tirar a média, você tende a suavizar ruídos e a sazonalidade. Veja um exemplo agora com a média móvel de 'diet' usando métodos nativos do pandas.
Como estamos falando de sazonalidade anual, faz sentido começar testando uma janela de doze meses.
diet = df[['diet']]
diet.rolling(12).mean().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
Observação: no trecho de código acima, usamos dois colchetes para extrair a coluna 'diet' como um DataFrame; se usássemos um só, como em df['diet'], teríamos criado uma Series do pandas.
Nesse código, também encadeamos métodos (method chaining): chamamos métodos em sequência sobre um objeto. Esse estilo é bem popular e o pandas dá ótimo suporte a ele!
Agora você tem a tendência que buscava! Grande parte da sazonalidade foi removida em comparação ao gráfico anterior.
Você também pode plotar a média móvel de 'gym' com a mesma janela usada para 'diet':
gym = df[['gym']]
gym.rolling(12).mean().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
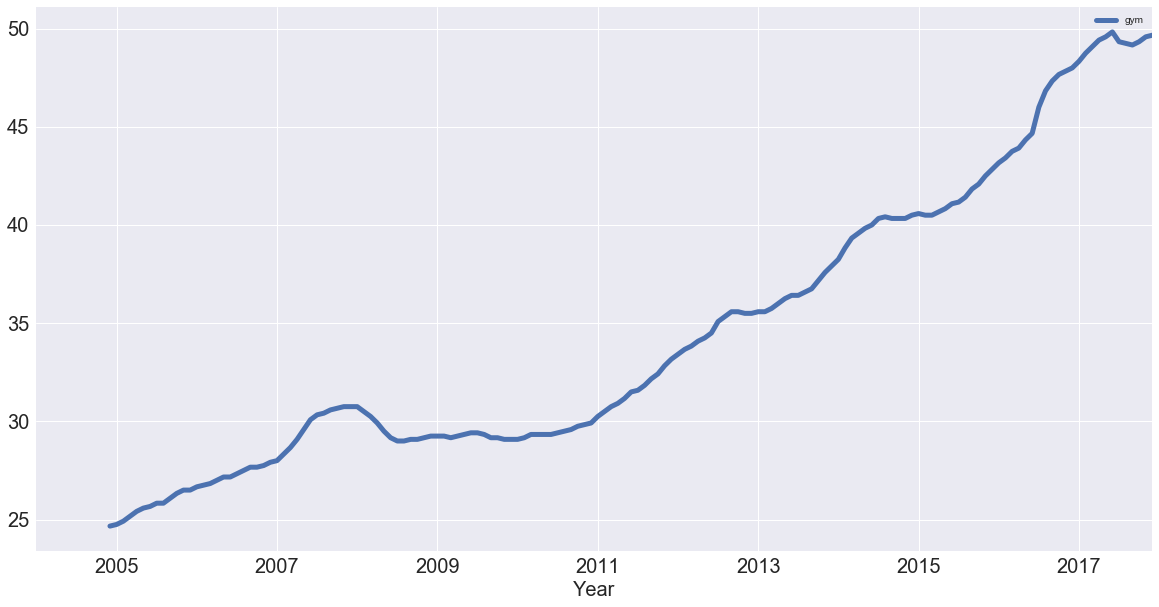
Conseguimos remover a sazonalidade e vemos uma tendência de alta para "gym"! Mas como esses dois termos se comparam?
Você pode descobrir isso plotando as tendências de 'gym' e 'diet' na mesma figura:
df_rm = pd.concat([diet.rolling(12).mean(), gym.rolling(12).mean()], axis=1)
df_rm.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
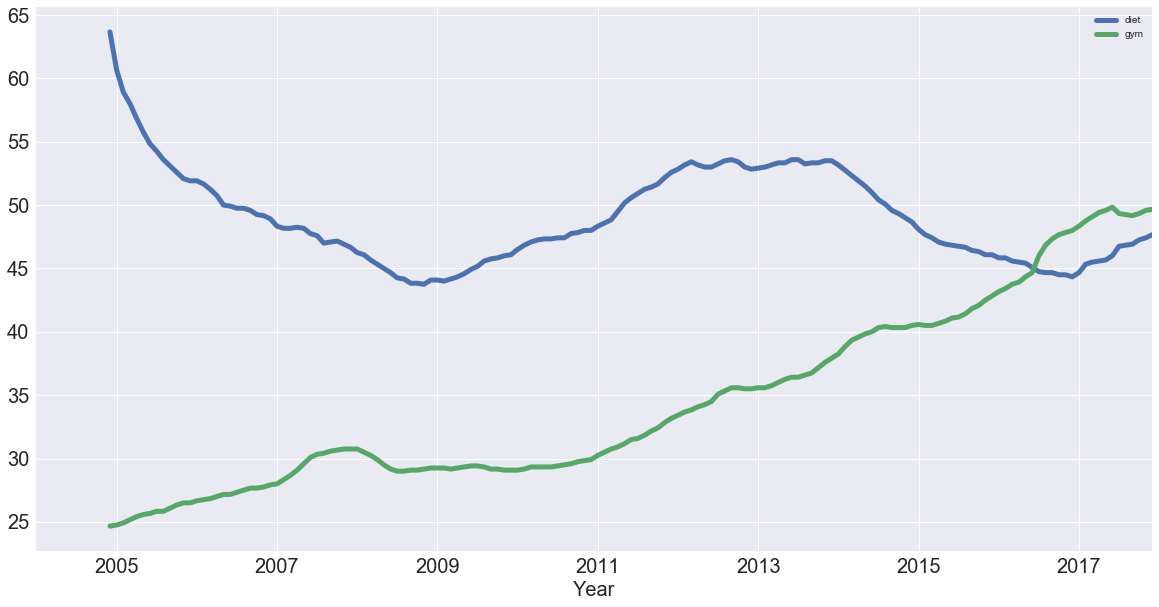
Criamos um novo DataFrame, df_rm, com duas colunas contendo as médias móveis de 'diet' e 'gym'. Usamos pd.concat(), que recebe uma lista de colunas como primeiro argumento e, como queremos concatenar por colunas, definimos axis=1.
Depois, plotamos o DataFrame com plot(), como antes! Removendo a sazonalidade, vemos que diet pode ter algum comportamento cíclico, enquanto gym está de fato em alta!
Com as tendências identificadas, é hora de analisar a sazonalidade, ou seja, a natureza repetitiva da sua série temporal. Como vimos no começo, parecia haver componentes de tendência e sazonais nos dados.
Uma forma de analisar os componentes sazonais é remover a tendência da série, facilitando a investigação da sazonalidade. Para isso, você pode subtrair a tendência (média móvel) do sinal original. Porém, o resultado depende do tamanho da janela usada.
Outra forma é o "differencing" (diferenças), em que você observa a diferença entre pontos sucessivos ("diferença de primeira ordem", pois olha a diferença entre um ponto e seu antecessor).
Use pandas com os métodos diff() e plot() para calcular e plotar a diferença de primeira ordem da Series 'diet':
diet.diff().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
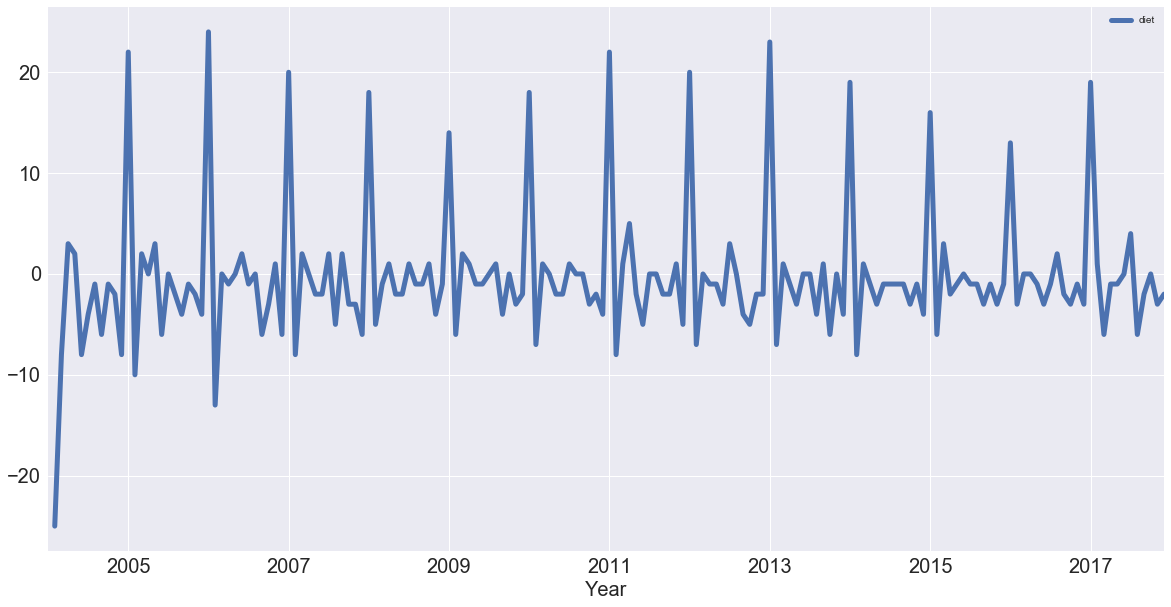
Perceba que boa parte da tendência foi removida e os picos de janeiro de cada ano ficam bem evidentes. Todo janeiro há um salto enorme de 20% ou mais no termo com maior volume de buscas!
Observação: você também pode aplicar diferenças de 2ª ordem (diferença entre um ponto e os dois anteriores) se a tendência ainda não tiver sido totalmente removida. Veja mais detalhes aqui.
O differencing é muito útil para transformar sua série em estacionária. Sem entrar a fundo, uma série estacionária é aquela cujas propriedades estatísticas (como média e variância) não mudam no tempo. Elas são úteis porque muitos métodos de previsão assumem estacionariedade.
Com isso em mãos, vamos analisar a periodicidade da sua série olhando a função de autocorrelação. Antes, porém, um breve desvio sobre correlação.
Uma série temporal é periódica quando se repete em intervalos regulares, por exemplo, a cada 12 meses.
Outra forma de pensar: se a série tem um pico em algum ponto, haverá um pico 12 meses depois; se há um vale, outro vale aparecerá 12 meses depois.
Mais uma visão: a série é correlacionada com ela mesma deslocada em 12 meses. Ou seja, se você mover a série 12 meses para trás ou para frente, ela se "alinha" consigo mesma de alguma forma.
Considerar a correlação de uma série com uma versão deslocada dela é justamente o conceito de autocorrelação.
Já vamos chegar lá.
Antes, vamos relembrar rapidamente o que é correlação de forma intuitiva!
O coeficiente de correlação entre duas variáveis captura o quanto elas se relacionam linearmente. Para entender melhor, vamos a um exemplo prático com o conjunto de dados iris, que contém medidas de flores.
Para isso, importe o conjunto iris do scikit-learn, transforme-o em um DataFrame e visualize as primeiras linhas com .head():
from sklearn import datasets
iris = datasets.load_iris()
df_iris = pd.DataFrame(data= np.c_[iris['data'], iris['target']],
                     columns= iris['feature_names'] + ['target'])
df_iris.head()
| sepal length (cm) | sepal width (cm) | petal length (cm) | petal width (cm) | target | |
|---|---|---|---|---|---|
| 0 | 5.1 | 3.5 | 1.4 | 0.2 | 0.0 |
| 1 | 4.9 | 3.0 | 1.4 | 0.2 | 0.0 |
| 2 | 4.7 | 3.2 | 1.3 | 0.2 | 0.0 |
| 3 | 4.6 | 3.1 | 1.5 | 0.2 | 0.0 |
| 4 | 5.0 | 3.6 | 1.4 | 0.2 | 0.0 |
Relembrando: toda flor tem sépala e pétala. A sépala envolve as pétalas e costuma ser verde e semelhante a uma folha; as pétalas são as "folhas" coloridas. A coluna 'target', variável-alvo, representa a espécie das íris (Versicolor, Virginica ou Setosa), codificadas como 0, 1 e 2 na tabela.
Agora, para pensar em correlação, vamos ver como o comprimento da sépala se correlaciona com a largura da sépala. Para isso, use pandas ou seaborn para criar um scatter plot de 'sepal length' versus 'sepal width':
sns.lmplot(x='sepal length (cm)', y='sepal width (cm)', fit_reg=False, data=df_iris);
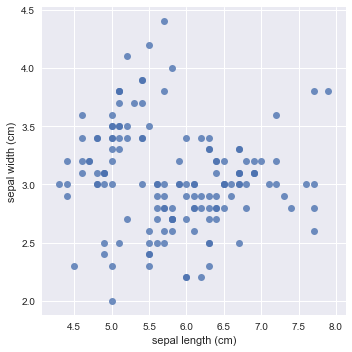
Observação: desativamos a regressão linear definindo fit_reg=False.
O comprimento e a largura da sépala são positiva ou negativamente correlacionados no conjunto todo? E dentro de cada espécie? Essa distinção é essencial.
No primeiro caso, conforme o comprimento aumenta, a largura também aumenta de forma linear. No segundo, conforme o comprimento aumenta, a largura diminui linearmente.
À primeira vista, o gráfico sugere uma correlação negativa: conforme o comprimento aumenta, a largura diminui levemente.
Agora, vamos criar um scatter plot de 'sepal length' versus 'sepal width', colorindo pelos valores de species (target):
sns.lmplot(x='sepal length (cm)', y='sepal width (cm)', fit_reg=False, data=df_iris, hue='target');
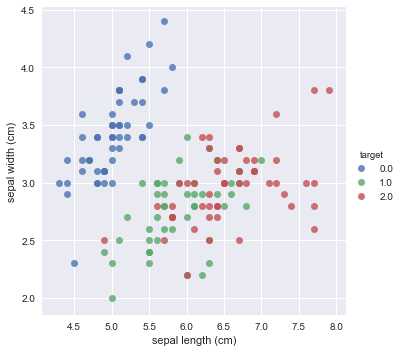
À primeira vista, o gráfico acima sugere correlação positiva: dentro de cada espécie, quando o comprimento aumenta, a largura também aumenta.
Visualizações ajudam a construir intuição sobre correlação, mas também é útil calcular o coeficiente de correlação.
Você pode calcular os coeficientes de correlação de cada par de medidas com .corr():
df_iris.corr()
| sepal length (cm) | sepal width (cm) | petal length (cm) | petal width (cm) | target | |
|---|---|---|---|---|---|
| sepal length (cm) | 1.000000 | -0.109369 | 0.871754 | 0.817954 | 0.782561 |
| sepal width (cm) | -0.109369 | 1.000000 | -0.420516 | -0.356544 | -0.419446 |
| petal length (cm) | 0.871754 | -0.420516 | 1.000000 | 0.962757 | 0.949043 |
| petal width (cm) | 0.817954 | -0.356544 | 0.962757 | 1.000000 | 0.956464 |
| target | 0.782561 | -0.419446 | 0.949043 | 0.956464 | 1.000000 |
Observação: "sepal length (cm)" e "sepal width (cm)" parecem negativamente correlacionados no conjunto total (coeficiente -0,1). No entanto, dentro de cada espécie, a correlação não é negativa — chega a 0,78.
Para quem se interessar, isso é conhecido como paradoxo de Simpson e é crucial ao pensar em inferência causal. Leia mais aqui.
Vamos explorar mais: vamos calcular os coeficientes de correlação de cada par de medidas dentro de cada espécie. Para isso, encadeie .groupby() e .corr() para agrupar por target e calcular a correlação:
df_iris.groupby(['target']).corr()
| petal length (cm) | petal width (cm) | sepal length (cm) | sepal width (cm) | ||
|---|---|---|---|---|---|
| target | |||||
| 0.0 | petal length (cm) | 1.000000 | 0.306308 | 0.263874 | 0.176695 |
| petal width (cm) | 0.306308 | 1.000000 | 0.279092 | 0.279973 | |
| sepal length (cm) | 0.263874 | 0.279092 | 1.000000 | 0.746780 | |
| sepal width (cm) | 0.176695 | 0.279973 | 0.746780 | 1.000000 | |
| 1.0 | petal length (cm) | 1.000000 | 0.786668 | 0.754049 | 0.560522 |
| petal width (cm) | 0.786668 | 1.000000 | 0.546461 | 0.663999 | |
| sepal length (cm) | 0.754049 | 0.546461 | 1.000000 | 0.525911 | |
| sepal width (cm) | 0.560522 | 0.663999 | 0.525911 | 1.000000 | |
| 2.0 | petal length (cm) | 1.000000 | 0.322108 | 0.864225 | 0.401045 |
| petal width (cm) | 0.322108 | 1.000000 | 0.281108 | 0.537728 | |
| sepal length (cm) | 0.864225 | 0.281108 | 1.000000 | 0.457228 | |
| sepal width (cm) | 0.401045 | 0.537728 | 0.457228 | 1.000000 |
Nesta matriz de correlação, vemos que:
Todas são correlações positivas (em ordem decrescente) e bem mais altas que a correlação negativa observada no conjunto inteiro.
Isso é muito revelador e reforça a importância de analisar os dados a fundo.
Agora que revisamos correlação, estamos prontos para analisar a periodicidade da sua série olhando a função de autocorrelação!
Para começar, plote todas as séries novamente para relembrar o comportamento:
df.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
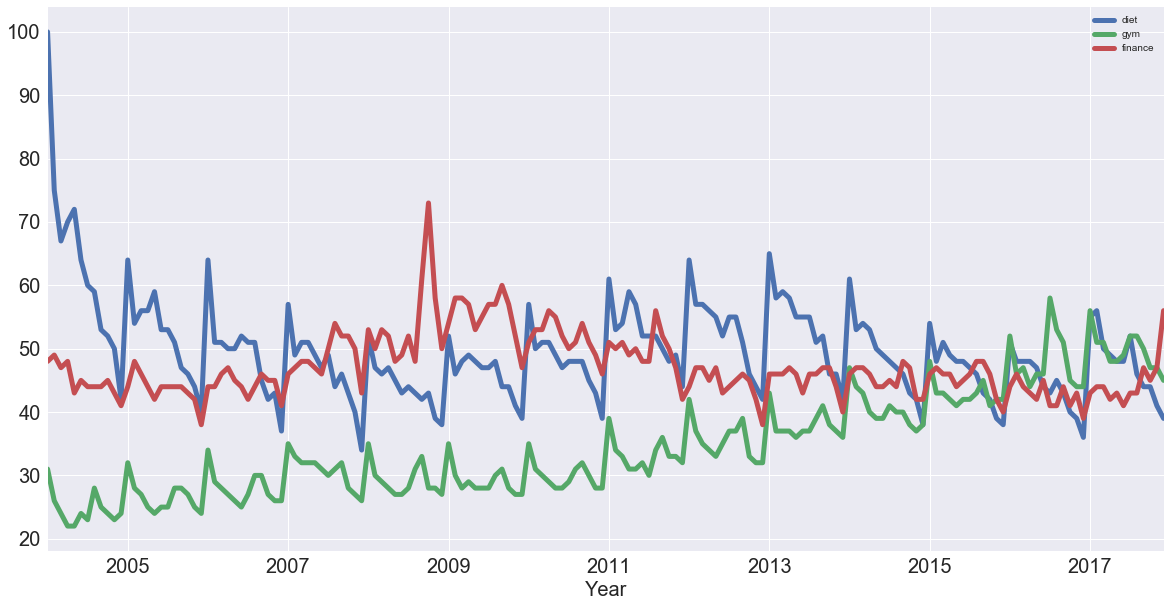
Depois, calcule os coeficientes de correlação entre todas as séries com .corr():
df.corr()
| diet | gym | finance | |
|---|---|---|---|
| diet | 1.000000 | -0.100764 | -0.034639 |
| gym | -0.100764 | 1.000000 | -0.284279 |
| finance | -0.034639 | -0.284279 | 1.000000 |
O que isso nos diz?
Focando em 'diet' e 'gym': elas são negativamente correlacionadas. Interessante! Lembre que temos componentes de tendência e sazonais. Pelo coeficiente, "diet" e "gym" são negativamente correlacionadas. Mas, olhando as séries, parece que os componentes sazonais seriam positivamente correlacionados e as tendências, negativamente.
O coeficiente de correlação está capturando ambos.
Agora queremos plotar as diferenças de primeira ordem dessas séries e então calcular a correlação entre elas, o que aproxima a correlação dos componentes sazonais. Remover a tendência pode revelar correlação na sazonalidade.
Comece plotando as diferenças de primeira ordem com .diff() e .plot():
df.diff().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
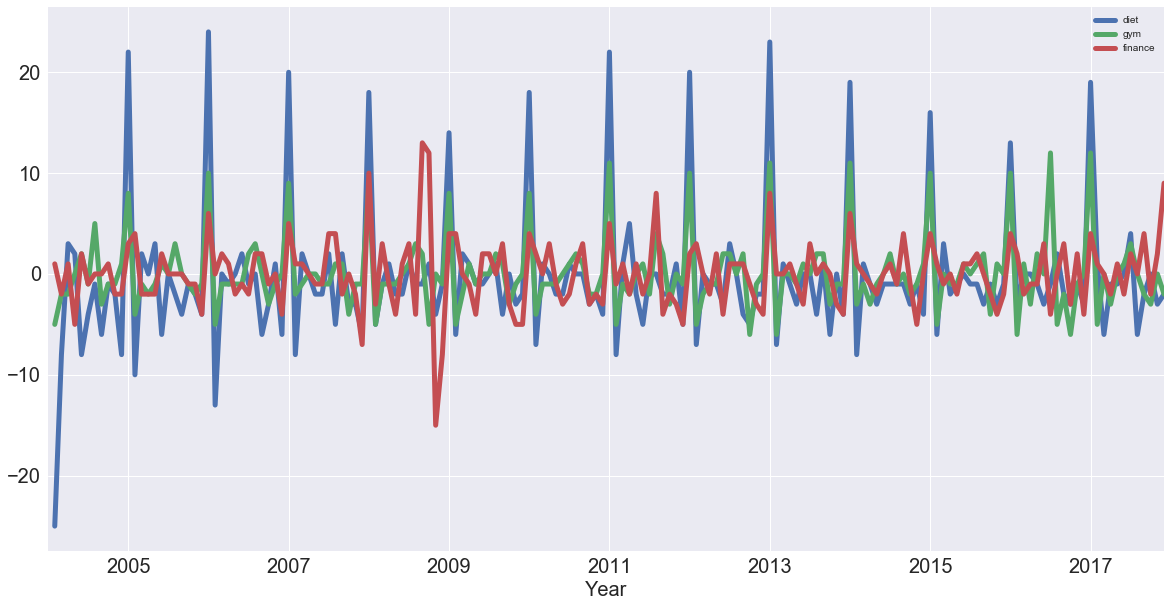
Você vê que 'diet' e 'gym' ficam altamente correlacionadas após remover a tendência. Agora, calcule os coeficientes de correlação das diferenças de primeira ordem dessas séries:
df.diff().corr()
| diet | gym | finance | |
|---|---|---|---|
| diet | 1.000000 | 0.758707 | 0.373828 |
| gym | 0.758707 | 1.000000 | 0.301111 |
| finance | 0.373828 | 0.301111 | 1.000000 |
Observação: antes, ao considerar tendência e sazonalidade juntas, vimos leve correlação negativa. Agora, considerando o componente sazonal, 'diet' e 'gym' estão altamente correlacionadas (coeficiente 0,76).
Depois de explorar correlação entre variáveis e séries, vamos plotar a autocorrelação da série 'diet': no eixo x, o lag; no eixo y, o quanto a série se correlaciona consigo mesma nesse lag.
Se a série se repete a cada dois dias, esperamos um pico na função de autocorrelação em 2 dias.
Aqui, esperamos um pico em 12 meses: a série é correlacionada consigo mesma deslocada em doze meses.
Use a interface plotting do pandas, com a função autocorrelation_plot(), para plotar a série 'diet':
pd.plotting.autocorrelation_plot(diet);
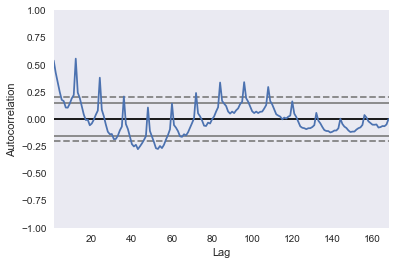
Se ampliarmos os lags no eixo, veremos um pico enorme em 12 meses. Há outro pico em 24 meses (e também em 36). Conforme o lag aumenta, a correlação tende a diminuir.
Claro, no lag 0 a correlação é 1 (a série com ela mesma).
As linhas pontilhadas indicam a significância estatística da correlação. Neste caso, podemos dizer que a série 'diet' é genuinamente autocorrelacionada com lag de doze meses.
Identificamos a sazonalidade dessa repetição anual!
Neste tutorial, cobrimos bastante coisa! Analisamos os dados do Google Trends para as palavras "diet", "gym" e demos uma olhada rápida em "finance" para ver como variam no tempo. Abordamos conceitos como sazonalidade, tendências, correlação, autocorrelação...
Para quem quer ir além, aqui vão duas ideias imediatas:
Saiba mais sobre Python
Curso
Curso
Curso
Tutorial
Elena Kosourova
8 min
Tutorial
Karlijn Willems
14 min
Tutorial
Elena Kosourova
15 min
Tutorial
Moez Ali
14 min
Tutorial
Elena Kosourova
12 min
Tutorial
Joleen Bothma
9 min