在 1 月 4 日的 Facebook Live 实操课程中,我们查看了关键词“diet”“gym”和“finance”的 Google 趋势数据,看看它们随时间如何变化。我们也问自己:当大家在一月立下新年目标时,这些词的搜索量会不会更多?
在本教程中,您将逐步走过我们在课程中写下的代码。您不会做太多数学推导,重点将放在对该数据集的可视化探索上。
想进一步学习 pandas,请查看 DataCamp 的Python 数据操作学习路径。想了解使用 pandas 的时间序列,请查看在 Python 中处理时间序列数据课程。
导入包与数据
所以问题仍在:当大家在一月下定决心重新开始时,这些词的搜索会不会更多?
让我们通过访问此处查看数据找出答案。注意,本教程灵感来源于FiveThirtyEight 的这篇文章。
您也可以将数据下载为 .csv,保存到文件并导入您自己的 Python 环境,进行自主分析。我们现在就来这么做。开始吧!
首先,导入一些包:这里将使用 numpy、pandas、matplotlib 和 seaborn。
此外,如果您希望在 Jupyter Notebook 中绘图显示,可以在代码中加入 IPython 魔法命令 %matplotlib inline。或者,您也可以通过 sns.set() 切换到 Seaborn 的默认样式:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
%matplotlib inline
sns.set()技术支持
使用 .read_csv() 导入您下载的数据,并用 .head() 查看前几行。
注意,这里添加了 skiprows 参数以跳过文件开头的第一行。
 df = pd.read_csv('data/multiTimeline.csv', skiprows=1)
df.head()技术支持
| | Month | diet: (Worldwide) | gym: (Worldwide) | finance: (Worldwide) |
|---|
| 0 | 2004-01 | 100 | 31 | 48 |
|---|
| 1 | 2004-02 | 75 | 26 | 49 |
|---|
| 2 | 2004-03 | 67 | 24 | 47 |
|---|
| 3 | 2004-04 | 70 | 22 | 48 |
|---|
| 4 | 2004-05 | 72 | 22 | 43 |
|---|
您也可以使用 .info() 方法查看数据类型、行数等信息:
df.info()
技术支持
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 168 entries, 0 to 167
Data columns (total 4 columns):
Month                   168 non-null object
diet: (Worldwide)       168 non-null int64
gym: (Worldwide)        168 non-null int64
finance: (Worldwide)    168 non-null int64
dtypes: int64(3), object(1)
memory usage: 5.3+ KB
技术支持
现在您已经从 Google 趋势导入了数据并做了初步查看,接下来要整理数据,让它更适合分析。
整理数据
首先,您需要重命名 DataFrame df 的列,使其不包含空格。这有多种做法,此处我们直接给 df.columns 重新赋值为期望的列名列表。
通过调用 df.head() 再次核对重命名结果:
df.columns = ['month', 'diet', 'gym', 'finance']
df.head()
技术支持
| | month | diet | gym | finance |
|---|
| 0 | 2004-01 | 100 | 31 | 48 |
|---|
| 1 | 2004-02 | 75 | 26 | 49 |
|---|
| 2 | 2004-03 | 67 | 24 | 47 |
|---|
| 3 | 2004-04 | 70 | 22 | 48 |
|---|
| 4 | 2004-05 | 72 | 22 | 43 |
|---|
接着,您将把 'month' 列转换为 DateTime 类型,并将其设为 DataFrame 的索引。
注意,之所以这样做,是因为 .info() 的结果显示 'Month' 列的数据类型是 object。该泛型类型可以表示字符串、整数等多种类型,但在处理时间序列时并不理想。因此使用 .to_datetime() 将 DataFrame 中的 'month' 列转换为 DateTime。
请小心!在为 DataFrame df 设定索引时,确保包含 inplace 参数,以实际修改原有索引并设为 'month' 列。
df.month = pd.to_datetime(df.month)
df.set_index('month', inplace=True)
技术支持
df.head()
技术支持
| | diet | gym | finance |
|---|
| month | | | |
|---|
| 2004-01-01 | 100 | 31 | 48 |
|---|
| 2004-02-01 | 75 | 26 | 49 |
|---|
| 2004-03-01 | 67 | 24 | 47 |
|---|
| 2004-04-01 | 70 | 22 | 48 |
|---|
| 2004-05-01 | 72 | 22 | 43 |
|---|
现在是时候对 DataFrame 进行可视化探索了。
一点探索性数据分析(EDA)
您可以使用 pandas 的内置可视化方法 .plot(),将数据绘制为同一图中的 3 条折线图(每个列各一条,即 'diet'、'gym' 和 'finance')。
注意,您也可以为该方法指定一些参数,如 figsize、linewidth 和 fontsize,分别控制图像尺寸、线宽和字体大小。
另外,您会发现 x 轴上显示的并非月份(尽管默认标签如此暗示),而是年份。为使图形更准确,我们将 x 轴标签指定为 'Year',并将字体大小设为 20。
提示:如果想抑制 Matplotlib 的输出,只需在最后一行代码后加分号 ;!
df.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
技术支持
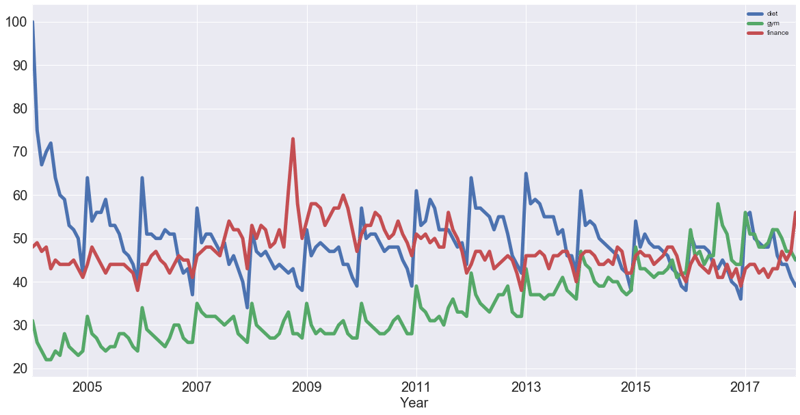
注意,这些数据是相对值。正如 Google 趋势所述:
数值表示相对于所选地区与时段中该图表最高点的搜索热度。数值 100 表示该术语的峰值人气。数值 50 表示该术语的人气为峰值的一半。同样地,得分 0 表示该术语的人气低于峰值的 1%。
如果您愿意,也可以将 'diet' 列单独绘制为时间序列:
df[['diet']].plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
技术支持
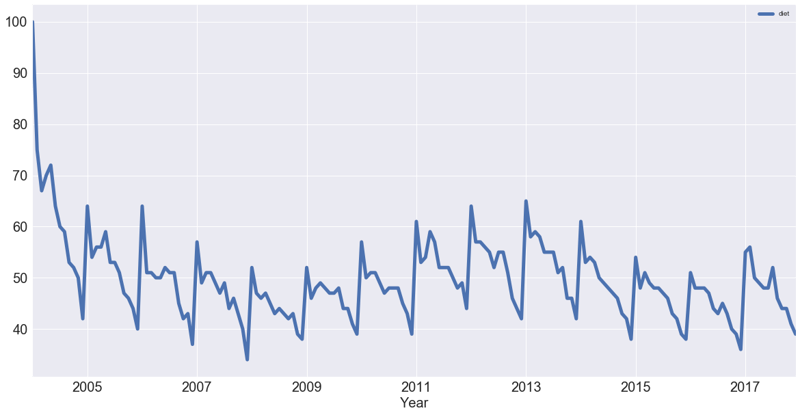
注意:首先可以看到季节性:每年一月都有明显的跳升。同时似乎也存在趋势:先略有上升,再下降,又上升,然后再下降。换言之,该时间序列既包含趋势,也包含季节性成分。
考虑到这些,接下来您将学习如何识别时间序列中的趋势!
时间序列数据中的趋势与季节性
识别时间序列中的趋势
识别时间序列趋势有多种思路。其中一个常见方法是计算滚动平均:即对每个时间点,取其两侧若干点的平均值。注意,这里的点数由您选择的窗口大小决定。
由于取了平均,往往能平滑噪声与季节性。下面马上来看一个示例。使用 pandas 内置方法查看 'diet' 的滚动平均。
关于窗口大小的确定,这里先试 12 个月,因为我们讨论的是年度季节性。
diet = df[['diet']]
diet.rolling(12).mean().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
技术支持
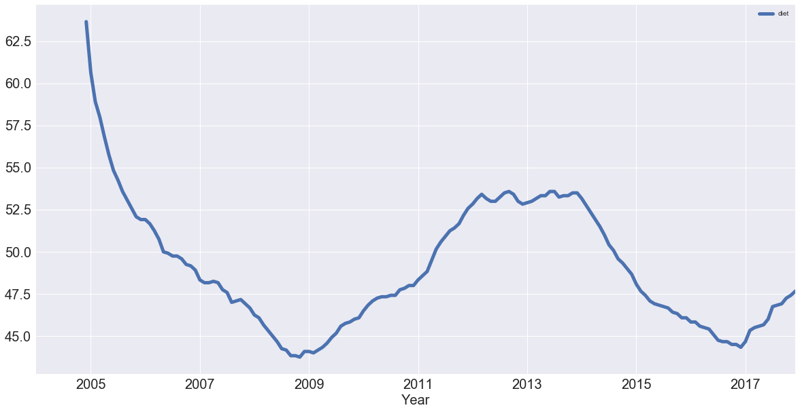
注意,上面的代码使用了两层方括号来将 'diet' 列提取为 DataFrame;如果只用一层方括号,如 df['diet'],则会得到 pandas 的 Series。
上面的代码还演示了方法链式调用:在一个对象上连续调用方法。方法链很流行,而 pandas 尤其支持这种风格!
现在您得到了想要的趋势!与之前的图相比,大部分季节性已经被去除。
您也可以用相同的窗口大小,使用 pandas 内置方法绘制 'gym' 的滚动平均:
gym = df[['gym']]
gym.rolling(12).mean().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
技术支持
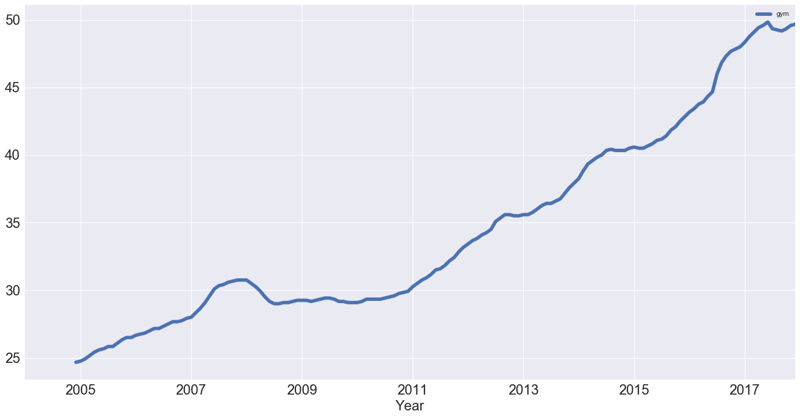
季节性被成功去除,您能看到“gym”呈上升趋势!但这两个搜索词如何对比?
可以把 'gym' 与 'diet' 的趋势绘制在同一图中进行比较:
df_rm = pd.concat([diet.rolling(12).mean(), gym.rolling(12).mean()], axis=1)
df_rm.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
技术支持
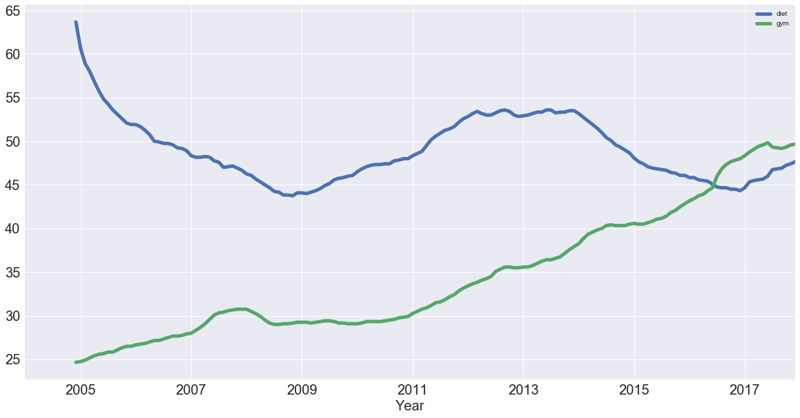
您创建了新的 DataFrame df_rm,其中包含 'diet' 与 'gym' 的滚动平均两列。这里使用了 pd.concat() 函数,第一参数传入列的列表,并因按列合并而将 axis 设为 1。
随后像之前一样用 plot() 绘图!因此,在去除季节性后,可以看到 diet 可能仍有某种季节性,而 gym 实际在上升!
在识别出数据中的趋势之后,接下来思考季节性,即时间序列的重复性。正如本教程开头所见,这些数据的时间序列似乎同时具有趋势与季节性成分。
时间序列数据中的季节性模式
研究数据的季节性成分的一种方式是移除时间序列中的趋势,从而更容易考察季节性。移除趋势的一种做法是将您上面计算的趋势(滚动平均)从原始信号中减去。但这会依赖于您平均的点数。
另一个移除趋势的方法叫“差分”,即考察相邻数据点之间的差(称为“一阶差分”,因为只看当前点与其前一个点的差)。
一阶差分
您可以使用 pandas 的 diff() 与 plot() 方法,计算并绘制 'diet' 序列的一阶差分:
diet.diff().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
技术支持
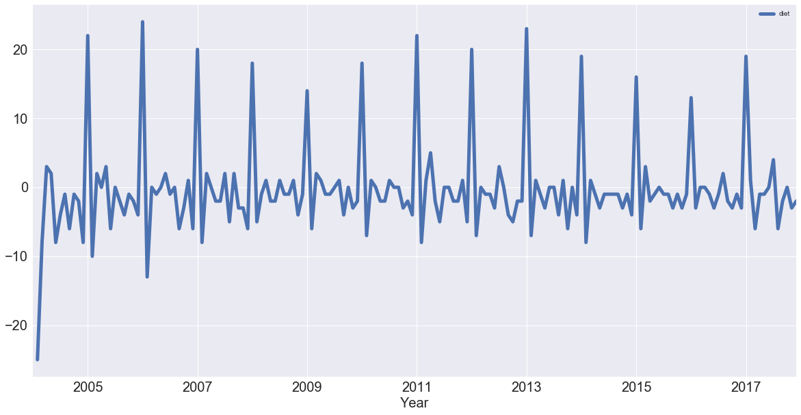
您会发现大部分趋势被移除,并且可以清晰看到每年一月的峰值。每逢一月,最高搜索项会出现 20% 或更多的巨大跃升!
注意:如果趋势尚未完全移除,也可以进行二阶差分,即考察一个点与其前两个点之间的差。关于差分的更多信息见此处。
差分对于将时间序列转为平稳序列非常有用。尽管这里不会展开,平稳时间序列指统计特性(如均值与方差)不随时间变化的序列。许多时间序列预测方法都基于时间序列近似平稳的假设,因此这类序列很有用。
掌握上述内容后,接下来您将通过查看自相关函数来分析时间序列的周期性。不过在此之前,先简单回顾一下相关性。
周期性与自相关
如果一个时间序列以等间隔重复自身(例如每 12 个月),则称其为周期性。
换个思路,如果时间序列在某处有峰值,那么在 12 个月后也会出现峰值;如果在某处有谷值,12 个月后也会出现谷值。
再换一种说法:该时间序列与其自身平移 12 个月后的序列具有相关性。也就是说,如果把时间序列向前或向后移动 12 个月,在某种意义上它能映射回自身。
考虑时间序列与其自身平移版本之间的相关性,这正是自相关的概念所刻画的。
很快就会用到这一点。
首先,让我们用一种更直观的方式回忆一下相关性的概念!
两个变量的相关系数反映它们线性相关的程度。为理解这一点,我们借助包含花朵测量值的 iris 数据集,来看一个实际示例。
为深入研究,导入 scikit-learn 的 iris 数据集,将其转换为 DataFrame,并用 .head() 查看前几行:
from sklearn import datasets
iris = datasets.load_iris()
df_iris = pd.DataFrame(data= np.c_[iris['data'], iris['target']],
                     columns= iris['feature_names'] + ['target'])
df_iris.head()
技术支持
| | sepal length (cm) | sepal width (cm) | petal length (cm) | petal width (cm) | target |
|---|
| 0 | 5.1 | 3.5 | 1.4 | 0.2 | 0.0 |
|---|
| 1 | 4.9 | 3.0 | 1.4 | 0.2 | 0.0 |
|---|
| 2 | 4.7 | 3.2 | 1.3 | 0.2 | 0.0 |
|---|
| 3 | 4.6 | 3.1 | 1.5 | 0.2 | 0.0 |
|---|
| 4 | 5.0 | 3.6 | 1.4 | 0.2 | 0.0 |
|---|
提醒一下,为便于理解该数据集:所有花都有萼片(sepal)和花瓣(petal)。萼片包裹花瓣,通常为绿色且叶状;花瓣通常色彩鲜艳。目标变量 'target' 是鸢尾花的品种,可能是 Versicolor、Virginica 或 Setosa。上表中分别编码为 0、1、2。
接下来,为思考相关性,我们来查看萼片长度与萼片宽度的相关情况。为此,使用 pandas 或 seaborn 绘制 'sepal length' 与 'sepal width' 的散点图:
sns.lmplot(x='sepal length (cm)', y='sepal width (cm)', fit_reg=False, data=df_iris);
技术支持
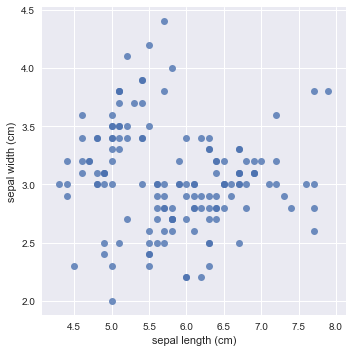
注意,我们通过将 fit_reg 设为 False 关闭了线性回归拟合。
萼片长度与宽度在所有花中是正相关还是负相关?在每个品种内又是正相关还是负相关?这是一个关键区别。
前者意味着当萼片长度增加时,萼片宽度也以线性方式增加;后者则意味着当萼片长度增加时,萼片宽度会以线性方式减少。
乍看之下,上图似乎呈负相关:随着萼片长度增加,萼片宽度略有下降。
现在我们绘制按目标(species)着色的 'sepal length' 与 'sepal width' 散点图:
sns.lmplot(x='sepal length (cm)', y='sepal width (cm)', fit_reg=False, data=df_iris, hue='target');
技术支持
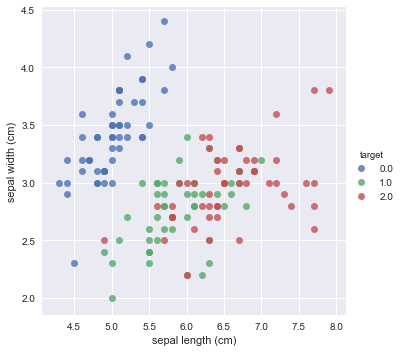
乍看之下,上图呈现正相关:在每个鸢尾花品种中,随着萼片长度增加,萼片宽度也增加。
可视化有助于建立对相关性的直觉,而进一步的方式是实际计算相关系数。
您可以使用 .corr() 方法计算每对测量值的相关系数:
df_iris.corr()
技术支持
| | sepal length (cm) | sepal width (cm) | petal length (cm) | petal width (cm) | target |
|---|
| sepal length (cm) | 1.000000 | -0.109369 | 0.871754 | 0.817954 | 0.782561 |
|---|
| sepal width (cm) | -0.109369 | 1.000000 | -0.420516 | -0.356544 | -0.419446 |
|---|
| petal length (cm) | 0.871754 | -0.420516 | 1.000000 | 0.962757 | 0.949043 |
|---|
| petal width (cm) | 0.817954 | -0.356544 | 0.962757 | 1.000000 | 0.956464 |
|---|
| target | 0.782561 | -0.419446 | 0.949043 | 0.956464 | 1.000000 |
|---|
注意,“sepal length (cm)”与“sepal width (cm)”在整体上似乎为负相关!确实如此:全体花样本上的相关系数为 -0.1。但在各个品种内部却不是负相关,其中与 target 的系数为 0.78。
对于感兴趣的读者,这被称为辛普森悖论,在因果推断中非常关键。详情可阅读这里。
我们进一步探索:计算各品种内部每对测量值的相关系数。做法是链式调用 .groupby() 与 .corr(),按目标分组并计算相关系数:
df_iris.groupby(['target']).corr()
技术支持
| | | petal length (cm) | petal width (cm) | sepal length (cm) | sepal width (cm) |
|---|
| target | | | | | |
|---|
| 0.0 | petal length (cm) | 1.000000 | 0.306308 | 0.263874 | 0.176695 |
|---|
| petal width (cm) | 0.306308 | 1.000000 | 0.279092 | 0.279973 |
|---|
| sepal length (cm) | 0.263874 | 0.279092 | 1.000000 | 0.746780 |
|---|
| sepal width (cm) | 0.176695 | 0.279973 | 0.746780 | 1.000000 |
|---|
| 1.0 | petal length (cm) | 1.000000 | 0.786668 | 0.754049 | 0.560522 |
|---|
| petal width (cm) | 0.786668 | 1.000000 | 0.546461 | 0.663999 |
|---|
| sepal length (cm) | 0.754049 | 0.546461 | 1.000000 | 0.525911 |
|---|
| sepal width (cm) | 0.560522 | 0.663999 | 0.525911 | 1.000000 |
|---|
| 2.0 | petal length (cm) | 1.000000 | 0.322108 | 0.864225 | 0.401045 |
|---|
| petal width (cm) | 0.322108 | 1.000000 | 0.281108 | 0.537728 |
|---|
| sepal length (cm) | 0.864225 | 0.281108 | 1.000000 | 0.457228 |
|---|
| sepal width (cm) | 0.401045 | 0.537728 | 0.457228 | 1.000000 |
|---|
从该相关矩阵可见:
- 对于 target 0,萼片长度与宽度的相关为 0.75;
- 对于 target 1,系数为 0.5;以及
- 对于 target 2,相关为 0.46。
这些都是逐渐减小的正相关,但都远高于最初整体上的负相关。
这非常有启发性,再次提醒我们要彻底分析数据的重要性。
既然已更深入地了解相关性,您就可以通过查看自相关函数来分析时间序列的周期性了!
首先,再次绘制所有时间序列,回顾它们的形态:
df.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
技术支持
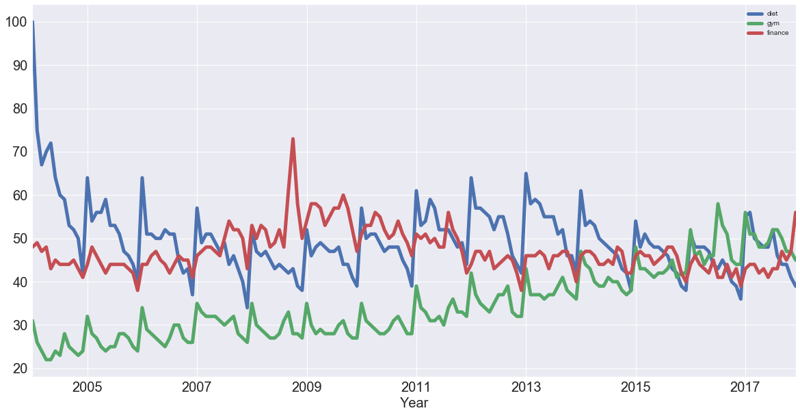
然后,使用 .corr() 计算这些时间序列之间的相关系数:
df.corr()
技术支持
| | diet | gym | finance |
|---|
| diet | 1.000000 | -0.100764 | -0.034639 |
|---|
| gym | -0.100764 | 1.000000 | -0.284279 |
|---|
| finance | -0.034639 | -0.284279 | 1.000000 |
|---|
以上结果说明了什么?
聚焦 'diet' 与 'gym':它们是负相关的。这很有意思!回想我们有季节性与趋势两部分。从相关系数看,“diet”与“gym”为负相关。但从时间序列图看,它们的季节性成分似乎是正相关,而趋势成分似乎是负相关。
总体相关系数实际同时捕捉了这两部分。
接下来要做的是:先绘制这些时间序列的一阶差分,再计算它们的一阶差分的相关性,因为这将近似反映季节性成分的相关性。请记住,去除趋势后可能会揭示季节性之间的相关。
首先使用 .diff() 与 .plot() 绘制一阶差分:
df.diff().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
技术支持
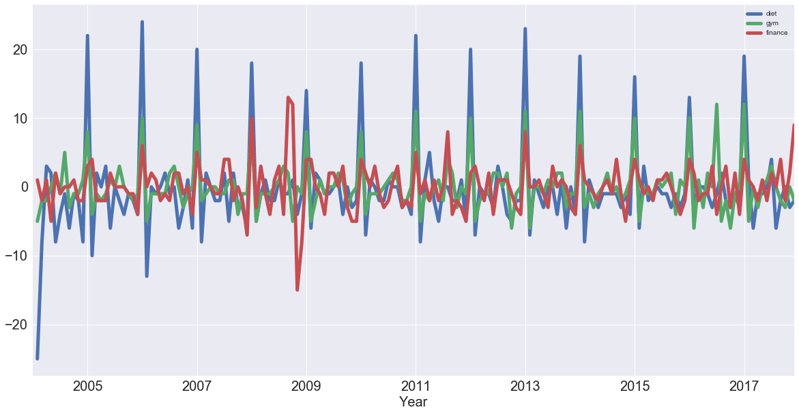
您会看到,在去除趋势后,'diet' 与 'gym' 的相关性非常强。现在计算这些时间序列一阶差分的相关系数:
df.diff().corr()
技术支持
| | diet | gym | finance |
|---|
| diet | 1.000000 | 0.758707 | 0.373828 |
|---|
| gym | 0.758707 | 1.000000 | 0.301111 |
|---|
| finance | 0.373828 | 0.301111 | 1.000000 |
|---|
注意,再次验证:在考虑趋势与季节成分时存在轻微负相关;而就季节性成分而言,'diet' 与 'gym' 高度相关,系数为 0.76。
自相关
现在您已了解变量间相关与时间序列相关,接下来绘制 'diet' 序列的自相关图:x 轴为滞后(lag),y 轴为该时间序列在该滞后下与自身的相关程度。
这意味着,如果原始时间序列每两天重复一次,您会期望在自相关函数的 2 天处看到一个峰值。
这里我们查看图形,预期在 12 个月处出现自相关峰值:时间序列与自身平移 12 个月后相关。
使用 pandas 的 plotting 接口中的 autocorrelation_plot() 函数来绘制 'diet' 的自相关:
pd.plotting.autocorrelation_plot(diet);
技术支持
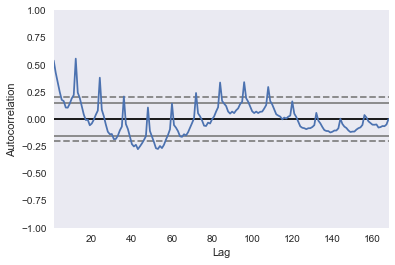
如果在坐标轴上包含更多滞后值,您会看到在 12 个月处出现巨大相关峰值;在 24 个月也有一个峰;在 36 个月也有,但随着滞后变大,相关性会逐渐减弱。
当然,在滞后为 0 时,序列与自身的相关为 1。
图中的虚线表示相关性的统计显著性。在本例中,可以认为 'diet' 序列在 12 个月滞后处确实具有自相关。
至此,您已经识别出 12 个月重复的季节性!
总结
在本教程中,您走过了不少内容!我们查看了关键词“diet”“gym”,并粗略查看了“finance”的 Google 趋势数据,考察它们随时间的变化。您学习了季节性、趋势、相关性、自相关等概念……
对于跃跃欲试的数据科学家,有两件事可以立即开展:


在 1 月 4 日的 Facebook Live 实操课程中,我们查看了关键词“diet”“gym”和“finance”的 Google 趋势数据,看看它们随时间如何变化。我们也问自己:当大家在一月立下新年目标时,这些词的搜索量会不会更多?
在本教程中,您将逐步走过我们在课程中写下的代码。您不会做太多数学推导,重点将放在对该数据集的可视化探索上。
想进一步学习 pandas,请查看 DataCamp 的Python 数据操作学习路径。想了解使用 pandas 的时间序列,请查看在 Python 中处理时间序列数据课程。
导入包与数据
所以问题仍在:当大家在一月下定决心重新开始时,这些词的搜索会不会更多?
让我们通过访问此处查看数据找出答案。注意,本教程灵感来源于FiveThirtyEight 的这篇文章。
您也可以将数据下载为 .csv,保存到文件并导入您自己的 Python 环境,进行自主分析。我们现在就来这么做。开始吧!
首先,导入一些包:这里将使用
numpy、pandas、matplotlib和seaborn。此外,如果您希望在 Jupyter Notebook 中绘图显示,可以在代码中加入 IPython 魔法命令
%matplotlib inline。或者,您也可以通过sns.set()切换到 Seaborn 的默认样式:使用
.read_csv()导入您下载的数据,并用.head()查看前几行。注意,这里添加了
skiprows参数以跳过文件开头的第一行。您也可以使用
.info()方法查看数据类型、行数等信息:现在您已经从 Google 趋势导入了数据并做了初步查看,接下来要整理数据,让它更适合分析。
整理数据
首先,您需要重命名 DataFrame
df的列,使其不包含空格。这有多种做法,此处我们直接给df.columns重新赋值为期望的列名列表。通过调用
df.head()再次核对重命名结果:接着,您将把
'month'列转换为 DateTime 类型,并将其设为 DataFrame 的索引。注意,之所以这样做,是因为
.info()的结果显示'Month'列的数据类型是object。该泛型类型可以表示字符串、整数等多种类型,但在处理时间序列时并不理想。因此使用.to_datetime()将 DataFrame 中的'month'列转换为 DateTime。请小心!在为 DataFrame
df设定索引时,确保包含inplace参数,以实际修改原有索引并设为'month'列。现在是时候对 DataFrame 进行可视化探索了。
一点探索性数据分析(EDA)
您可以使用
pandas的内置可视化方法.plot(),将数据绘制为同一图中的 3 条折线图(每个列各一条,即'diet'、'gym'和'finance')。注意,您也可以为该方法指定一些参数,如
figsize、linewidth和fontsize,分别控制图像尺寸、线宽和字体大小。另外,您会发现 x 轴上显示的并非月份(尽管默认标签如此暗示),而是年份。为使图形更准确,我们将 x 轴标签指定为
'Year',并将字体大小设为 20。提示:如果想抑制 Matplotlib 的输出,只需在最后一行代码后加分号
;!注意,这些数据是相对值。正如 Google 趋势所述:
如果您愿意,也可以将
'diet'列单独绘制为时间序列:注意:首先可以看到季节性:每年一月都有明显的跳升。同时似乎也存在趋势:先略有上升,再下降,又上升,然后再下降。换言之,该时间序列既包含趋势,也包含季节性成分。
考虑到这些,接下来您将学习如何识别时间序列中的趋势!
时间序列数据中的趋势与季节性
识别时间序列中的趋势
识别时间序列趋势有多种思路。其中一个常见方法是计算滚动平均:即对每个时间点,取其两侧若干点的平均值。注意,这里的点数由您选择的窗口大小决定。
由于取了平均,往往能平滑噪声与季节性。下面马上来看一个示例。使用
pandas内置方法查看'diet'的滚动平均。关于窗口大小的确定,这里先试 12 个月,因为我们讨论的是年度季节性。
注意,上面的代码使用了两层方括号来将
'diet'列提取为 DataFrame;如果只用一层方括号,如df['diet'],则会得到 pandas 的 Series。上面的代码还演示了方法链式调用:在一个对象上连续调用方法。方法链很流行,而 pandas 尤其支持这种风格!
现在您得到了想要的趋势!与之前的图相比,大部分季节性已经被去除。
您也可以用相同的窗口大小,使用
pandas内置方法绘制'gym'的滚动平均:季节性被成功去除,您能看到“gym”呈上升趋势!但这两个搜索词如何对比?
可以把
'gym'与'diet'的趋势绘制在同一图中进行比较:您创建了新的 DataFrame
df_rm,其中包含'diet'与'gym'的滚动平均两列。这里使用了pd.concat()函数,第一参数传入列的列表,并因按列合并而将axis设为1。随后像之前一样用
plot()绘图!因此,在去除季节性后,可以看到diet可能仍有某种季节性,而gym实际在上升!在识别出数据中的趋势之后,接下来思考季节性,即时间序列的重复性。正如本教程开头所见,这些数据的时间序列似乎同时具有趋势与季节性成分。
时间序列数据中的季节性模式
研究数据的季节性成分的一种方式是移除时间序列中的趋势,从而更容易考察季节性。移除趋势的一种做法是将您上面计算的趋势(滚动平均)从原始信号中减去。但这会依赖于您平均的点数。
另一个移除趋势的方法叫“差分”,即考察相邻数据点之间的差(称为“一阶差分”,因为只看当前点与其前一个点的差)。
一阶差分
您可以使用
pandas的diff()与plot()方法,计算并绘制'diet'序列的一阶差分:您会发现大部分趋势被移除,并且可以清晰看到每年一月的峰值。每逢一月,最高搜索项会出现 20% 或更多的巨大跃升!
注意:如果趋势尚未完全移除,也可以进行二阶差分,即考察一个点与其前两个点之间的差。关于差分的更多信息见此处。
差分对于将时间序列转为平稳序列非常有用。尽管这里不会展开,平稳时间序列指统计特性(如均值与方差)不随时间变化的序列。许多时间序列预测方法都基于时间序列近似平稳的假设,因此这类序列很有用。
掌握上述内容后,接下来您将通过查看自相关函数来分析时间序列的周期性。不过在此之前,先简单回顾一下相关性。
周期性与自相关
如果一个时间序列以等间隔重复自身(例如每 12 个月),则称其为周期性。
换个思路,如果时间序列在某处有峰值,那么在 12 个月后也会出现峰值;如果在某处有谷值,12 个月后也会出现谷值。
再换一种说法:该时间序列与其自身平移 12 个月后的序列具有相关性。也就是说,如果把时间序列向前或向后移动 12 个月,在某种意义上它能映射回自身。
考虑时间序列与其自身平移版本之间的相关性,这正是自相关的概念所刻画的。
很快就会用到这一点。
首先,让我们用一种更直观的方式回忆一下相关性的概念!
两个变量的相关系数反映它们线性相关的程度。为理解这一点,我们借助包含花朵测量值的
iris数据集,来看一个实际示例。为深入研究,导入 scikit-learn 的
iris数据集,将其转换为 DataFrame,并用.head()查看前几行:提醒一下,为便于理解该数据集:所有花都有萼片(sepal)和花瓣(petal)。萼片包裹花瓣,通常为绿色且叶状;花瓣通常色彩鲜艳。目标变量
'target'是鸢尾花的品种,可能是 Versicolor、Virginica 或 Setosa。上表中分别编码为 0、1、2。接下来,为思考相关性,我们来查看萼片长度与萼片宽度的相关情况。为此,使用
pandas或seaborn绘制'sepal length'与'sepal width'的散点图:注意,我们通过将
fit_reg设为False关闭了线性回归拟合。萼片长度与宽度在所有花中是正相关还是负相关?在每个品种内又是正相关还是负相关?这是一个关键区别。
前者意味着当萼片长度增加时,萼片宽度也以线性方式增加;后者则意味着当萼片长度增加时,萼片宽度会以线性方式减少。
乍看之下,上图似乎呈负相关:随着萼片长度增加,萼片宽度略有下降。
现在我们绘制按目标(
species)着色的'sepal length'与'sepal width'散点图:乍看之下,上图呈现正相关:在每个鸢尾花品种中,随着萼片长度增加,萼片宽度也增加。
可视化有助于建立对相关性的直觉,而进一步的方式是实际计算相关系数。
您可以使用
.corr()方法计算每对测量值的相关系数:注意,“sepal length (cm)”与“sepal width (cm)”在整体上似乎为负相关!确实如此:全体花样本上的相关系数为 -0.1。但在各个品种内部却不是负相关,其中与
target的系数为 0.78。对于感兴趣的读者,这被称为辛普森悖论,在因果推断中非常关键。详情可阅读这里。
我们进一步探索:计算各品种内部每对测量值的相关系数。做法是链式调用
.groupby()与.corr(),按目标分组并计算相关系数:从该相关矩阵可见:
这些都是逐渐减小的正相关,但都远高于最初整体上的负相关。
这非常有启发性,再次提醒我们要彻底分析数据的重要性。
既然已更深入地了解相关性,您就可以通过查看自相关函数来分析时间序列的周期性了!
首先,再次绘制所有时间序列,回顾它们的形态:
然后,使用
.corr()计算这些时间序列之间的相关系数:以上结果说明了什么?
聚焦
'diet'与'gym':它们是负相关的。这很有意思!回想我们有季节性与趋势两部分。从相关系数看,“diet”与“gym”为负相关。但从时间序列图看,它们的季节性成分似乎是正相关,而趋势成分似乎是负相关。总体相关系数实际同时捕捉了这两部分。
接下来要做的是:先绘制这些时间序列的一阶差分,再计算它们的一阶差分的相关性,因为这将近似反映季节性成分的相关性。请记住,去除趋势后可能会揭示季节性之间的相关。
首先使用
.diff()与.plot()绘制一阶差分:您会看到,在去除趋势后,
'diet'与'gym'的相关性非常强。现在计算这些时间序列一阶差分的相关系数:注意,再次验证:在考虑趋势与季节成分时存在轻微负相关;而就季节性成分而言,
'diet'与'gym'高度相关,系数为 0.76。自相关
现在您已了解变量间相关与时间序列相关,接下来绘制
'diet'序列的自相关图:x 轴为滞后(lag),y 轴为该时间序列在该滞后下与自身的相关程度。这意味着,如果原始时间序列每两天重复一次,您会期望在自相关函数的 2 天处看到一个峰值。
这里我们查看图形,预期在 12 个月处出现自相关峰值:时间序列与自身平移 12 个月后相关。
使用
pandas的plotting接口中的autocorrelation_plot()函数来绘制'diet'的自相关:如果在坐标轴上包含更多滞后值,您会看到在 12 个月处出现巨大相关峰值;在 24 个月也有一个峰;在 36 个月也有,但随着滞后变大,相关性会逐渐减弱。
当然,在滞后为 0 时,序列与自身的相关为 1。
图中的虚线表示相关性的统计显著性。在本例中,可以认为
'diet'序列在 12 个月滞后处确实具有自相关。至此,您已经识别出 12 个月重复的季节性!
总结
在本教程中,您走过了不少内容!我们查看了关键词“diet”“gym”,并粗略查看了“finance”的 Google 趋势数据,考察它们随时间的变化。您学习了季节性、趋势、相关性、自相关等概念……
对于跃跃欲试的数据科学家,有两件事可以立即开展: