
Keluaran audio native belum saya lihat di Runway atau Sora. Pada titik ini, saya akan bilang Veo 3 selangkah lebih maju.
Walau demo terlihat bagus, saya belajar bahwa video demo jarang mencerminkan perilaku model dalam praktik. Begitu prompt keluar dari pola data latih—adegan yang asing, karakter yang aneh, atau ide yang terlalu subtil—model cenderung kolaps. Saya menantikan untuk mencoba Veo 3 dan melihat seberapa baik performanya.
Akses ke Veo 3 memerlukan langganan AI Ultra, dengan biaya $250/bulan. Bahkan jika Anda bersedia membayar, ketersediaannya terbatas. Saat ini, hanya dapat diakses di AS, dan hanya melalui editor video bertenaga AI baru dari Google bernama Flow (yang akan kita bahas berikutnya).
Jika Anda penasaran dengan detail teknis atau ingin menjelajahi lebih banyak contoh, lihat halaman resmi Veo di sini.
Flow
Flow adalah alat pembuatan film berbasis AI yang memungkinkan Anda menghasilkan bidikan individual dengan kombinasi Veo, Imagen, dan Gemini.
Satu hal yang saya anggap berguna adalah Anda dapat membuat elemen terpisah (disebut “ingredients”) lalu mengelompokkannya menjadi satu adegan. Ini memberi kontrol modular dan sangat membantu ketika Anda ingin menggunakan ulang elemen yang sama di berbagai prompt atau bidikan.
Mari lihat contohnya:
Ada juga alat untuk kontrol kamera dan transisi di dalam Flow, yang membantu memberi nuansa lebih sinematik pada klip. Ini berguna, tetapi bukan hal baru—Sora dan Runway sudah menawarkan fitur serupa, jadi saya tidak akan bilang ada terobosan di sini.
Meski begitu, layak untuk memperhatikan bagaimana alat seperti ini berkembang. Flow terasa seperti versi awal editor video yang berorientasi AI, dan mudah membayangkan masa depan di mana alur kerja semacam ini menjadi standar. Seperti kita kini menganggap Premiere Pro atau DaVinci Resolve sebagai hal yang lumrah, sesuatu seperti Flow bisa menjadi norma dalam beberapa tahun.
Flow saat ini hanya tersedia di AS, dan Anda dapat mengaksesnya melalui langganan AI Pro dan AI Ultra dari Google.
Imagen 4
Pengumuman penting lainnya adalah Imagen 4, model generasi gambar terbaru dari Google. Anda dapat menggunakannya langsung di Gemini atau di dalam Whisk, alat desain Google.
Google mengklaim peningkatan di berbagai aspek—fotorealisme yang lebih baik, detail close-up yang lebih bersih, variasi gaya seni yang lebih kaya. Itu semua bagus, tetapi yang menarik perhatian saya adalah janji ejaan dan tipografi yang lebih canggih. Jika Anda pernah menggunakan generator gambar akhir-akhir ini, kemungkinan besar Anda melihat sebagian besar masih salah mengeja kata atau bahkan merusak bentuk huruf.
Mari lihat gambar yang dihasilkan Imagen 4:
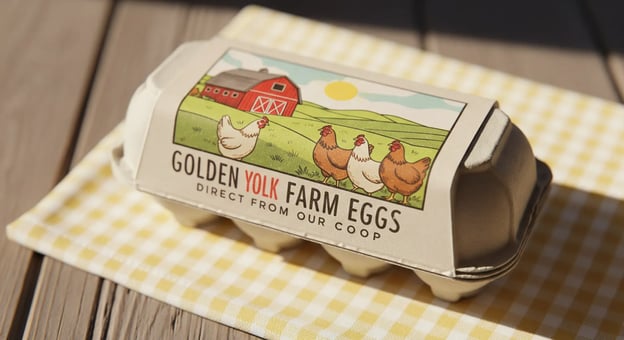
Sumber: Google
Saat ini, saya akan bilang generasi gambar GPT-4o adalah yang terkuat di pasar. Namun, sesekali masih kesulitan dengan teks dan ketaatan pada prompt. Jika Imagen 4 benar-benar mampu mengeja dengan tepat dan mempertahankan maksud prompt, menurut saya ia berpeluang memimpin di ranah generasi gambar.
Gemma 3n
Gemma 3n adalah model on-device terbaru dan paling mumpuni dari Google. Jika Anda belum familier dengan istilah tersebut, model on-device adalah model yang berjalan langsung di ponsel, tablet, atau laptop Anda—tanpa perlu mengirim data ke cloud. Ini penting karena beberapa alasan: latensi lebih rendah, privasi yang lebih baik, dan ketersediaan offline.
Namun agar berhasil, model harus cukup kecil untuk muat di memori terbatas, tetapi cukup kuat untuk menangani tugas nyata. Itulah tantangan yang coba dijawab Gemma 3n.
Model ini dibangun di atas arsitektur baru yang sama dengan Gemini Nano—dan faktanya, huruf “n” pada “3n” merujuk pada “nano.” Arsitektur ini dioptimalkan untuk penggunaan memori rendah, waktu respons cepat, dan dukungan untuk beragam input seperti teks, audio, dan gambar.
Gemma 3n hadir dalam dua varian, dengan ukuran parameter 5B dan 8B. Keduanya dirancang agar efisien, dengan kebutuhan memori yang mendekati model 2B dan 4B berkat beberapa optimalisasi di balik layar.
Yang sangat mencolok bagi saya adalah performanya hampir setara di Chatbot Arena dengan Claude 3.7 Sonnet, yang jauh lebih besar.
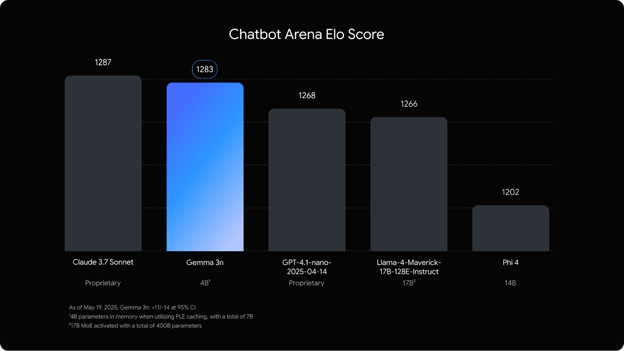
Sumber: Google
Rilis ini terutama ditujukan bagi pengembang, khususnya yang membangun aplikasi seluler atau embedded yang dapat memanfaatkan AI lokal. Sementara tim kami di DataCamp sedang menyiapkan tutorial Gemma 3n terbaru, saya sarankan mulai dari blog Gemma 3 berikut:
- Cara Menyiapkan dan Menjalankan Gemma 3 Secara Lokal dengan Ollama
- Fine-Tune Gemma 3: Panduan Langkah demi Langkah
Gemini Diffusion
Teknologi yang paling membuat saya penasaran adalah Gemini Diffusion.
Gemini Diffusion adalah arsitektur model eksperimental baru yang dirancang untuk meningkatkan kecepatan dan koherensi dalam generasi teks. Berbeda dengan model bahasa tradisional yang menghasilkan token satu per satu dalam urutan tetap, model difusi bekerja dengan memurnikan noise melalui beberapa langkah—metode yang diadopsi dari generasi gambar.
Alih-alih langsung memprediksi kata berikutnya, Gemini Diffusion memulai dengan pendekatan kasar lalu menyempurnakannya secara iteratif, yang membuatnya lebih baik pada tugas yang diuntungkan dari perbaikan bertahap dan koreksi kesalahan—seperti matematika, kode, dan pengeditan.
Dalam tolok ukur awal, dilaporkan mampu menghasilkan token hingga lima kali lebih cepat dibanding model autoregresif standar seperti Gemini 2.0 Flash-Lite, sambil memberikan kinerja serupa atau lebih baik pada tugas penalaran terstruktur.
Saat ini, akses dibatasi untuk penguji terpilih. Belum ada tanggal rilis publik yang diumumkan. Bergabunglah ke daftar tunggu pada halaman ini.
Project Mariner
Project Mariner adalah versi Google dari agen AI yang dapat beroperasi langsung di browser. Ini dirancang untuk membantu tugas kompleks dan multi-langkah—seperti merencanakan perjalanan, riset produk, atau meringkas konten padat di banyak tab.
Dalam pengertian itu, ini mirip dengan Manus AI atau Operator dari OpenAI, yang sudah tersedia melalui ChatGPT. Mari lihat contoh Mariner saat beraksi:
Untuk saat ini, Mariner belum tersedia untuk publik, tetapi Google mengatakan akses yang lebih luas akan hadir. Akses bagi pengembang diperkirakan segera melalui Gemini API.
Lihat lebih banyak contoh di sini:
Project Astra
Project Astra adalah prototipe dari Google DeepMind untuk asisten AI yang lebih serbaguna—sesuatu yang tidak hanya merespons prompt, tetapi juga melihat, mendengar, mengingat, dan bereaksi. Pertama kali diperkenalkan tahun lalu sebagai proyek riset, dan di I/O 2025 kita mendapat gambaran lebih jelas tentang kemampuannya.
Mari lihat saat beraksi:
Ini belum tersedia untuk publik, tetapi sebagian dari Astra sudah mulai dihadirkan ke Gemini Live, dan peluncuran yang lebih luas akan menyusul. Apakah ia akan menjadi produk nyata atau tetap di fase riset masih perlu dilihat, tetapi arahnya jelas: inilah yang dilihat Google sebagai fondasi untuk asisten AI universal.
Mode AI di Penelusuran
Mode AI adalah pengalaman penelusuran baru Google yang terasa lebih seperti chatbot daripada mesin telusur. Ini berbeda dari AI Overviews, yaitu ringkasan AI singkat yang ditempatkan di bagian atas halaman hasil Google tradisional yang kita kenal. Sebaliknya, Mode AI mengambil alih seluruh antarmuka—ini adalah tab baru di mana Anda dapat mengajukan pertanyaan kompleks dan menindaklanjutinya secara percakapan.
Mari lihat contohnya:
Antarmukanya sangat mirip dengan ChatGPT atau Perplexity. Anda memasukkan prompt, dan Mode AI merespons dengan jawaban yang lebih panjang dan terstruktur, termasuk tautan, sitasi, bagan, dan terkadang bahkan pemecahan riset lengkap. Ini menggunakan pendekatan “query fan-out” untuk memecah pertanyaan Anda menjadi subtopik dan menarik sumber dari seluruh web, semuanya dalam satu proses.
Salah satu fitur yang patut dicatat adalah integrasi kapabilitas agensi dari Project Mariner. Ini dapat menghemat waktu Anda untuk tugas seperti membeli tiket acara, membuat reservasi, atau mencari ketersediaan di banyak situs web.
Jelas bahwa penelusuran sedang mengalami pergeseran fundamental. Kita bergerak dari model yang berpusat pada daftar tautan ke model yang berpusat pada jawaban langsung, ringkasan, dan penyelesaian tugas. Ini berdampak besar pada cara informasi ditampilkan dan dikonsumsi. Industri SEO dan pemasaran konten sudah merasakan dampaknya.
Mode AI mulai diluncurkan di AS sekarang, dengan lebih banyak fitur yang akan hadir di Labs dalam beberapa minggu ke depan. Anda dapat mengaktifkan eksperimen ini di Google Labs jika ingin mencobanya lebih awal.
Kesimpulan
Itulah rangkuman pengumuman AI terpenting dari Hari 1 I/O 2025. Seperti biasa, banyak ambisi yang ditampilkan—tetapi ujian sebenarnya adalah bagaimana alat-alat ini bekerja di tangan pengguna dan pengembang sehari-hari.
Sebagian teknologi ini masih dini atau dibatasi oleh langganan mahal, tetapi beberapa fitur sudah mulai diluncurkan untuk semua pengguna.

Saya adalah editor dan penulis yang mengulas blog, tutorial, dan berita AI, memastikan semuanya selaras dengan strategi konten yang kuat dan praktik terbaik SEO. Saya telah menulis kursus data science tentang Python, statistik, probabilitas, dan visualisasi data. Saya juga telah menerbitkan novel pemenang penghargaan dan menghabiskan waktu luang untuk menulis skenario serta menyutradarai film.



Hari pertama Google I/O 2025 telah usai. Dalam artikel ini, saya akan membahas pengumuman yang paling penting bagi industri AI.
Saya akan berfokus pada pembaruan yang sudah siap digunakan atau diperkirakan akan segera dirilis. Sepanjang jalan, saya akan berbagi kesan singkat dan, jika relevan, memberi konteks dengan membandingkannya dengan para pesaing.
Kami terus memberi kabar terbaru tentang AI kepada pembaca melalui The Median, buletin gratis setiap Jumat yang mengulas kisah-kisah kunci pekan ini. Berlangganan dan tetap tajam hanya dalam beberapa menit per minggu:
Veo 3
Yang menonjol bagi saya tentang Veo 3 adalah kemampuannya menghasilkan audio secara native. Kini Anda dapat membuat video yang langsung menyertakan suara, tanpa perlu langkah pengeditan tambahan. Mari lihat contohnya: