

Corso
Introduzione ad Apache Kafka
2 ore
12.3K
Pratica and corso your progress.
Continua Con GoogleUn message broker è un software server che consente la comunicazione tra vari servizi, applicazioni e componenti, soprattutto nei sistemi distribuiti. Svolge un ruolo importante nell’abilitare la messaggistica asincrona, permettendo ai sistemi di disaccoppiarsi e scalare in modo indipendente.
Due scelte popolari in questo ambito sono ActiveMQ e Apache Kafka.
In questo articolo confronteremo in profondità ActiveMQ e Kafka, evidenziandone funzionalità, architetture, prestazioni e casi d’uso. Alla fine avrai un’idea più chiara di quale piattaforma si adatti meglio alle tue esigenze specifiche.
ActiveMQ è stato originariamente sviluppato da LogicBlaze, un'azienda specializzata in soluzioni open-source per l’integrazione e la messaggistica. LogicBlaze ha contribuito ActiveMQ alla Apache Software Foundation (ASF) nel 2007, dove è diventato un progetto di primo livello di Apache.
Da allora, la community open-source sotto la governance della Apache Software Foundation ha mantenuto e sviluppato ulteriormente ActiveMQ, con contributi di vari sviluppatori e organizzazioni in tutto il mondo.
In particolare, ActiveMQ è un message broker open-source scritto in Java che implementa l’API Java Message Service (JMS), uno standard per il middleware orientato ai messaggi (MOM) definito da Oracle. Il servizio è noto per la sua facilità d’uso, l’ampia documentazione e la flessibilità di deployment, che include supporto per clustering, failover e molteplici protocolli di trasporto.
Queste sono le principali funzionalità e caratteristiche di ActiveMQ:
Questi sono i casi d’uso più comuni di ActiveMQ:
Apache Kafka è stato originariamente sviluppato da LinkedIn per gestire i flussi di dati in tempo reale dell'azienda ed è stato reso open-source all’inizio del 2011.
Nel 2012, Kafka è stato conferito alla Apache Software Foundation (ASF), dove è diventato un progetto di primo livello. Da allora è mantenuto e sviluppato dalla community open-source sotto la governance della Apache Software Foundation, con contributi significativi da organizzazioni come LinkedIn, Confluent e altre.
Kafka è una piattaforma distribuita di event streaming progettata per una messaggistica ad alto throughput, tollerante ai guasti e scalabile. È scritto in Scala e Java, e la sua architettura è ottimizzata per gestire flussi di dati in tempo reale, rendendolo adatto alla creazione di data pipeline e applicazioni event-driven.
Kafka è apprezzato per la capacità di elaborare grandi volumi di dati con bassa latenza, una solida conservazione dei dati e la possibilità di rigiocare gli eventi. Il suo ampio ecosistema include Kafka Connect e Kafka Streams per integrare altri sistemi dati ed elaborare i flussi in tempo reale.
Ecco le funzionalità più rilevanti di Kafka:
Questi sono i casi d’uso più pertinenti e diffusi per Apache Kafka:
Se stai pensando di usare Kafka per i tuoi dati in tempo reale o sei semplicemente curioso di questa tecnologia, segui il corso Introduction to Apache Kafka per rimetterti in pari!
Scegliere la piattaforma di messaggistica giusta per la tua applicazione è importante per garantire un flusso dati efficiente, scalabilità e affidabilità del sistema.
Come abbiamo visto, sebbene ActiveMQ e Apache Kafka fungano da message broker, rispondono a esigenze e casi d’uso diversi. Ognuno offre un’architettura, caratteristiche prestazionali e funzionalità operative specifiche.
Esaminiamo le principali differenze tra questi broker in diverse categorie:
ActiveMQ utilizza un’architettura incentrata sul broker, memorizzando i messaggi in un broker centrale che gestisce code e topic. Questa configurazione si basa su acknowledgment dei messaggi e archiviazione persistente per garantire la consegna affidabile e la durabilità dei messaggi.
Al contrario, Kafka utilizza un’architettura a log distribuito, in cui i dati sono partizionati e replicati su più broker in un cluster. Il design di Kafka disaccoppia producer e consumer, consentendo un’alta scalabilità e prestazioni elevate, ideale per gestire grandi volumi di dati in sistemi distribuiti.
ActiveMQ supporta sia i modelli point-to-point (code) e publish-subscribe (topic) , offrendo flessibilità per diversi scenari di messaggistica con una forte enfasi sulle garanzie di consegna.
Kafka, invece, opera principalmente con un modello publish-subscribe basato su log distribuiti. Questo approccio consente a più consumer di leggere i dati in modo indipendente e al proprio ritmo dalla stessa partizione, vantaggioso per applicazioni che richiedono alto throughput ed elaborazione concorrente.
Per quanto riguarda prestazioni e throughput, ActiveMQ è adatto a casi d’uso che richiedono throughput moderato e bassa latenza, ma le sue prestazioni possono risentire della necessità di messaggistica persistente e di instradamenti complessi attraverso un broker centrale. Questo può limitarne l’efficienza nella gestione di volumi di dati estremamente elevati.
Kafka, invece, è progettato per alto throughput e bassa latenza, ed è in grado di elaborare milioni di messaggi al secondo. La sua architettura è ottimizzata per lo streaming dati in tempo reale, rendendolo una scelta preferenziale per applicazioni che richiedono elaborazione continua e ad alta velocità, come aggregazione di log e analytics in tempo reale.
ActiveMQ può scalare tramite clustering e una rete di broker, ma questo processo può essere complesso e richiede spesso una configurazione e una gestione attente.
Kafka, invece, nasce con la scalabilità in mente, consentendo una scalabilità orizzontale semplice aggiungendo altri broker al cluster. Le strategie di partizionamento e replica di Kafka facilitano una gestione efficiente dei dati su un gran numero di nodi, permettendo di gestire carichi crescenti con un minimo sforzo di configurazione.
ActiveMQ utilizza opzioni di archiviazione persistente e clustering dei broker con meccanismi di failover per garantire la durabilità dei messaggi e assicurare che il sistema possa riprendersi dai guasti senza perdita di dati.
Kafka, invece, offre una solida tolleranza ai guasti tramite replica dei dati su più broker nel cluster, garantendo alta durabilità anche durante i guasti dei broker. La capacità di Kafka di rigiocare i messaggi dal proprio log di archiviazione aggiunge un ulteriore livello di affidabilità, consentendo ai consumer di rielaborare i dati quando necessario.
ActiveMQ è particolarmente adatto alle applicazioni enterprise, soprattutto quando è richiesta la conformità JMS. Supporta una varietà di protocolli di messaggistica, tra cui AMQP, STOMP e MQTT, rendendolo una scelta versatile per collegare sistemi e applicazioni eterogenei.
Kafka, invece, ha un ecosistema in rapida crescita che include strumenti come Kafka Connect per l’integrazione con varie sorgenti e destinazioni dati e Kafka Streams per l’elaborazione in tempo reale. Le sue capacità di integrazione si estendono a piattaforme big data, servizi cloud e altre tecnologie moderne, rendendolo un'opzione potente per costruire pipeline dati scalabili in tempo reale e architetture event-driven.
La seguente tabella riassume le differenze tra ActiveMQ e Kafka nelle categorie discusse in precedenza:
|
Caratteristica |
ActiveMQ |
Apache Kafka |
|
Architettura |
Centrata sul broker |
Log distribuito |
|
Modello di messaggistica |
Point-to-point, publish-subscribe |
Publish-subscribe, log distribuiti |
|
Prestazioni |
Throughput moderato, bassa latenza |
Alto throughput, bassa latenza |
|
Scalabilità |
Clustering complesso tramite rete di broker |
Scalabilità orizzontale (facile da espandere) |
|
Tolleranza ai guasti |
Clustering, archiviazione persistente |
Replica, archiviazione a log durevole |
|
Durabilità |
Persistenza dei messaggi |
Replica dei dati, rigiocabilità |
|
Ecosistema |
Supporto JMS, protocolli multipli |
Kafka Connect, Streams, integrazione big data |
Ora vediamo i casi d’uso ideali per ciascuno di questi broker.
ActiveMQ è un'opzione solida per vari scenari di messaggistica, soprattutto quando si lavora con sistemi legacy, esigenze di messaggistica enterprise o requisiti specifici di conformità.
Ecco uno sguardo più dettagliato sulla sua idoneità ai diversi casi d’uso:
ActiveMQ è particolarmente adatto all’integrazione con sistemi legacy che dipendono dall’API Java Message Service (JMS). Implementa le specifiche JMS, risultando una scelta ideale per applicazioni che devono comunicare con sistemi più datati progettati secondo gli standard JMS.
Inoltre, ActiveMQ supporta la messaggistica point-to-point (code) e publish-subscribe (topic), essenziale per garantire la compatibilità con le infrastrutture esistenti che si basano su questi paradigmi.
ActiveMQ offre vantaggi significativi negli ambienti enterprise, dove sono importanti funzionalità di sicurezza avanzate, conformità e opzioni di deployment flessibili.
Fornisce meccanismi di sicurezza robusti, essenziali per mantenere la riservatezza e l’integrità dei messaggi. La conformità agli standard JMS assicura un'integrazione fluida con altri sistemi enterprise che aderiscono agli stessi standard.
Inoltre, ActiveMQ supporta vari modelli di deployment, come broker standalone, configurazioni in cluster e broker in rete, permettendo alle aziende di scegliere l’approccio più adatto alla propria infrastruttura e alle esigenze operative.
ActiveMQ è un candidato valido per applicazioni che non richiedono un throughput estremamente elevato ma necessitano di messaggistica affidabile e a bassa latenza. Il suo design si adatta a scenari con volumi di messaggi moderati e, grazie all’attenzione alle garanzie di consegna, assicura una trasmissione affidabile dei messaggi anche in ambienti complessi.
I meccanismi di persistenza e acknowledgment di ActiveMQ forniscono l’affidabilità necessaria per applicazioni in cui l’integrità dei messaggi è critica ma il volume è gestibile entro le sue capacità di throughput.
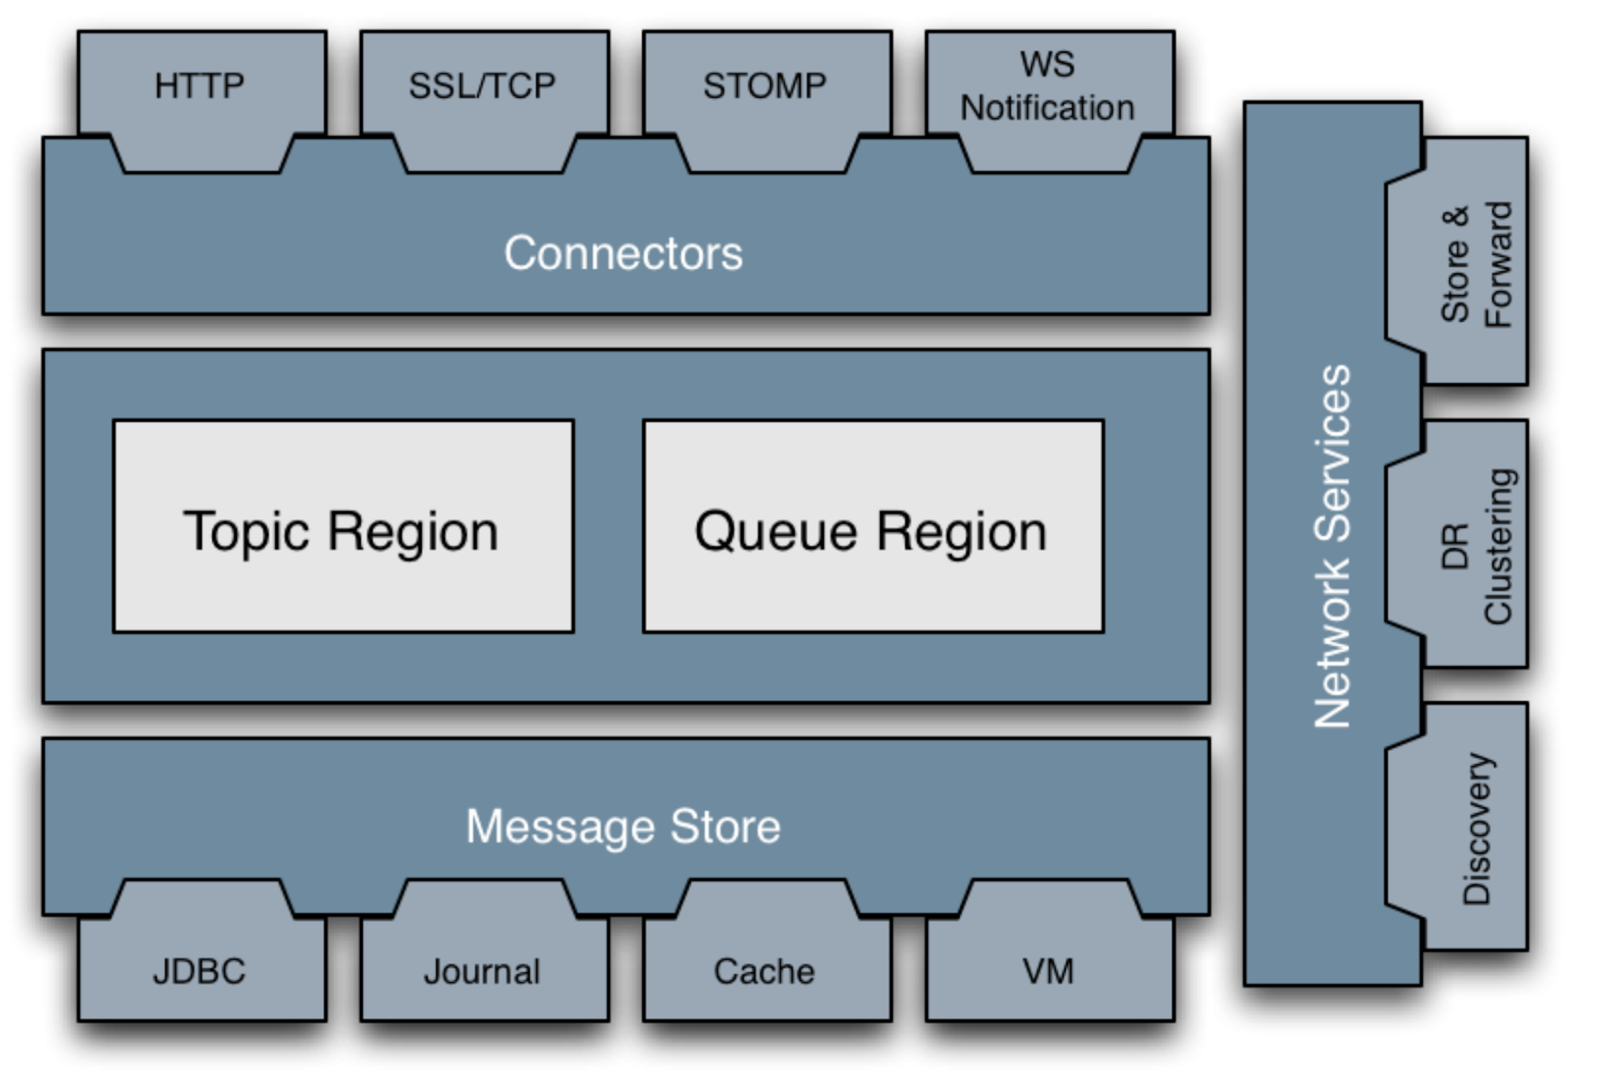
Componenti principali di ActiveMQ Classic. Fonte immagine: documentazione di ActiveMQ.
Kafka è particolarmente adatto a scenari che richiedono alto throughput, scalabilità eccezionale e funzionalità avanzate di gestione dei dati.
Ecco in dettaglio quando usare Kafka:
Kafka è una scelta di punta per applicazioni che richiedono elaborazione dati in tempo reale e alto throughput. Eccelle in scenari di aggregazione di log ed event sourcing, in cui enormi quantità di dati devono essere raccolte, elaborate e analizzate in tempo reale.
L’architettura di Kafka è ottimizzata per gestire milioni di messaggi al secondo con bassa latenza, rendendolo ideale per applicazioni di streaming che richiedono flussi continui di dati e ritardi minimi.
Kafka è molto efficace nel supportare architetture a microservizi scalabili. Fornisce un sistema di messaggistica distribuito e tollerante ai guasti in grado di gestire la natura dinamica e distribuita dei microservizi.
La capacità di Kafka di disaccoppiare producer e consumer consente ai microservizi di comunicare in modo efficiente anche al crescere del numero di servizi e del volume dei dati. La sua solida tolleranza ai guasti assicura che i messaggi vengano consegnati ed elaborati in modo affidabile anche in ambienti complessi e distribuiti.
Kafka si distingue nella costruzione di pipeline dati in tempo reale e piattaforme di analytics grazie alle sue solide funzionalità di durabilità e rigiocabilità dei dati. La sua architettura a log distribuito consente un’archiviazione e un recupero affidabili, permettendo di creare pipeline sofisticate in grado di gestire ingestion ed elaborazione ad alto volume.
La capacità di conservare e rigiocare i messaggi dai propri log è fondamentale per le piattaforme di analytics che elaborano dati storici e supportano query analitiche complesse.
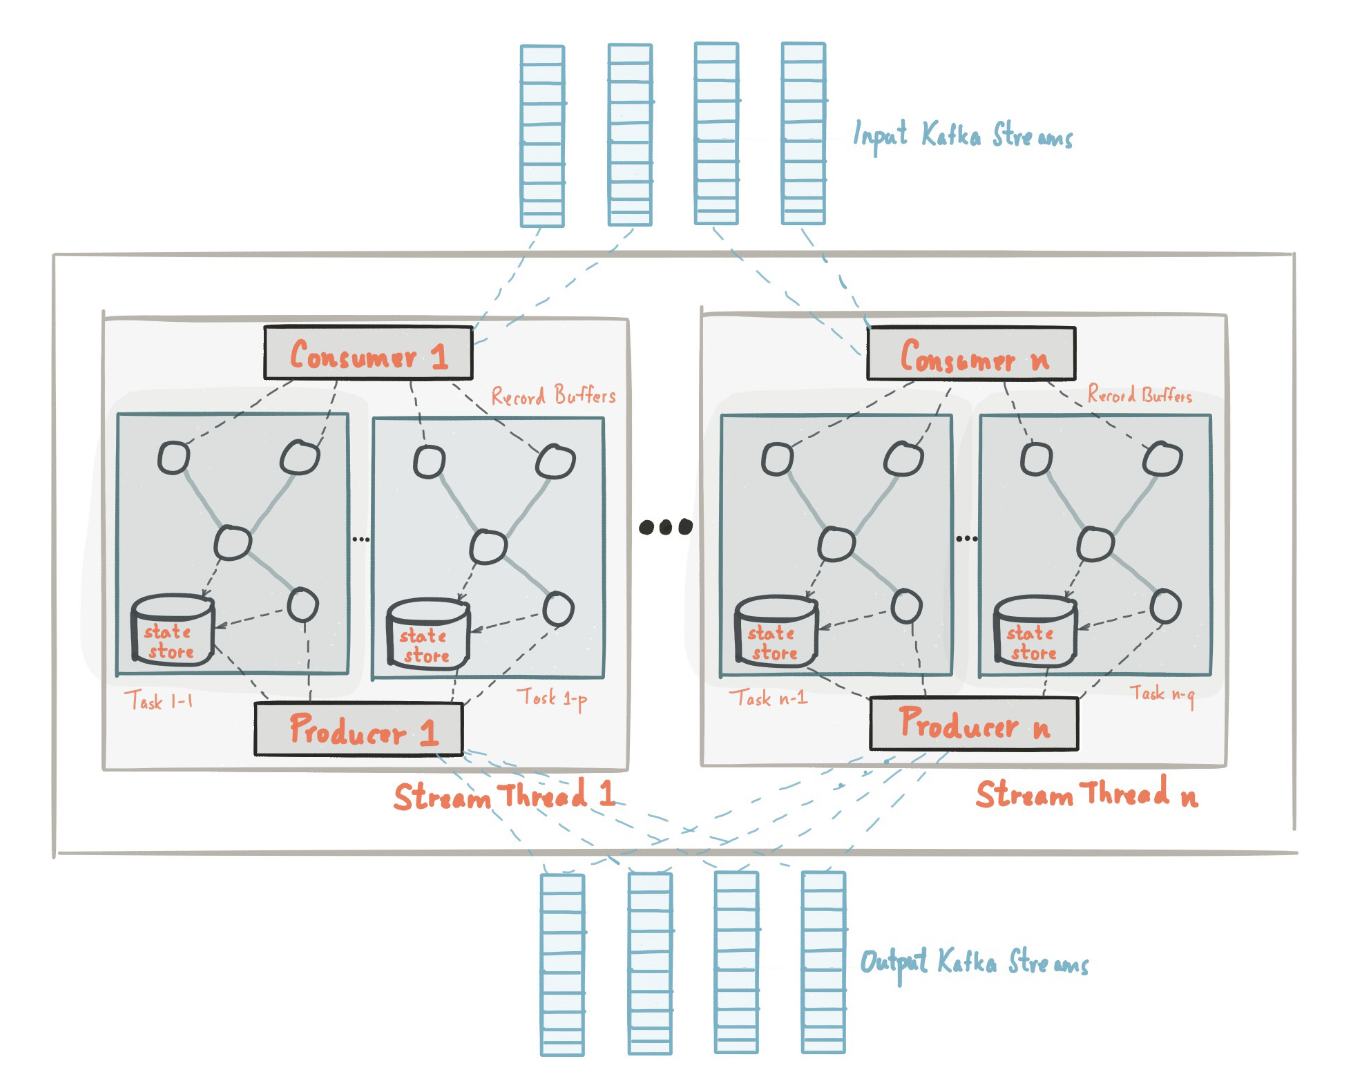
L’anatomia di un’applicazione che usa la libreria Kafka Streams. Fonte immagine: documentazione di Kafka.
La scelta tra ActiveMQ e Kafka dipende dalle tue esigenze e dai casi d’uso specifici. ActiveMQ è adatto agli scenari di messaggistica tradizionale, in particolare in contesti enterprise che richiedono conformità JMS e throughput inferiore. Al contrario, Kafka eccelle in ambienti ad alto throughput e scalabili, risultando ideale per l’elaborazione dati in tempo reale e lo streaming.
Per approfondire e scoprire di più sul data engineering, dai un’occhiata alle risorse qui sotto:
Scopri di più sul data streaming e su Apache Kafka con questi corsi!
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



