
Wat is Apache Kafka?
Apache Kafka is oorspronkelijk ontwikkeld door LinkedIn om de realtime datastromen van het bedrijf te verwerken en werd begin 2011 open-source gemaakt.
In 2012 werd Kafka bijgedragen aan de Apache Software Foundation (ASF), waar het een top-level project werd. Sindsdien wordt het onderhouden en ontwikkeld door de open-sourcecommunity onder toezicht van de Apache Software Foundation, met belangrijke bijdragen van organisaties zoals LinkedIn, Confluent en anderen.
Kafka is een gedistribueerd event-streaming platform dat is ontworpen voor messaging met hoge throughput, fouttolerantie en schaalbaarheid. Het is geschreven in Scala en Java, en de architectuur is geoptimaliseerd voor het verwerken van realtime datastromen, waardoor het geschikt is voor het bouwen van datapijplijnen en event-driven applicaties.
Kafka staat bekend om zijn vermogen om grote hoeveelheden data met lage latency te verwerken, met robuuste dataretentie en de mogelijkheid tot replay. Het uitgebreide ecosysteem omvat Kafka Connect en Kafka Streams voor integratie met andere datasystemen en het realtime verwerken van streams.
Features van Kafka
Dit zijn de meest opvallende features van Kafka:
- Hoge throughput en lage latency: Geoptimaliseerd voor verwerking met hoge throughput en lage latency, ideaal voor realtime applicaties.
- Schaalbaar en gedistribueerd: Kan horizontaal schalen door meer brokers aan het cluster toe te voegen, waardoor grote datavolumes verwerkt kunnen worden.
- Fouttolerantie en duurzaamheid: Borgt dataduurzaamheid via replicatie over meerdere nodes en biedt ingebouwde fouttolerantie.
- Event-streaming: Ondersteunt event-streaming en realtime dataverwerking, wat handig is voor logaggregatie, streamprocessing en dataintegratie.
- Replaybaarheid: Bewaart data gedurende een configureerbare periode, zodat consumers gebeurtenissen kunnen herhalen en opnieuw verwerken wanneer nodig.
- Ecosysteem: Biedt een robuust ecosysteem, waaronder Kafka Connect, Kafka Streams en integratie met talloze bigdata- en analysetools.
Use cases voor Kafka
Dit zijn de meest relevante en populaire use cases voor Apache Kafka:
- High-throughput streaming: Ideaal voor applicaties die grote hoeveelheden data in realtime moeten verwerken, zoals logaggregatie en event sourcing.
- Schaalbare microservices-architecturen: Geschikt voor microservices die schaalbare, fouttolerante en gedistribueerde messaging nodig hebben.
- Datapijplijn en analytics: Wordt vaak gebruikt voor het bouwen van realtime datapijplijnen en analyticsplatformen waar dataduurzaamheid en replaybaarheid cruciaal zijn.
Als je overweegt Kafka te gebruiken voor je realtime data of gewoon nieuwsgierig bent naar deze technologie, volg dan de cursus Introduction to Apache Kafka om snel bij te spijkeren!
ActiveMQ vs Kafka: belangrijkste verschillen
De juiste messagingplatform kiezen voor je applicatie is belangrijk om een efficiënte datastroom, schaalbaarheid en systeembetrouwbaarheid te garanderen.
Zoals we zagen, dienen zowel ActiveMQ als Apache Kafka als message brokers, maar ze richten zich op verschillende behoeften en use cases. Elk biedt een unieke architectuur, prestatiekenmerken en operationele features.
Laten we de belangrijkste verschillen tussen deze brokers per categorie doornemen:
Architectuur
ActiveMQ gebruikt een brokercentrische architectuur, waarbij berichten worden opgeslagen in een centrale broker die queues en topics beheert. Deze opzet steunt op berichtbevestigingen en persistente opslag om betrouwbare levering en duurzaamheid van berichten te waarborgen.
Daarentegen gebruikt Kafka een gedistribueerde logarchitectuur, waarbij data wordt gepartitioneerd en gerepliceerd over meerdere brokers in een cluster. Kafka’s ontwerp ontkoppelt producers en consumers, wat zorgt voor hoge schaalbaarheid en prestaties en het ideaal maakt voor het verwerken van grote datavolumes in gedistribueerde systemen.
Messagingmodel
ActiveMQ ondersteunt zowel point-to-point (queues) als publish-subscribe (topics) modellen en biedt zo flexibiliteit voor uiteenlopende messagingscenario’s met een sterke focus op leveringsgaranties.
Kafka werkt daarentegen vooral met een publish-subscribe-model op basis van gedistribueerde logs. Deze aanpak laat meerdere consumers onafhankelijk en in hun eigen tempo uit dezelfde partitie lezen, wat voordelig is voor applicaties die hoge throughput en gelijktijdige verwerking vereisen.
Prestaties en throughput
Qua prestaties en throughput is ActiveMQ geschikt voor use cases die gemiddelde throughput en lagere latency vereisen, maar de performance kan worden beïnvloed door de noodzaak van persistente messaging en complexe routering via een centrale broker. Dit kan de efficiëntie bij extreem hoge datavolumes beperken.
Kafka daarentegen is ontworpen voor hoge throughput en lage latency en kan miljoenen berichten per seconde verwerken. De architectuur is geoptimaliseerd voor realtime datastreaming, waardoor het een voorkeurskeuze is voor applicaties die continue, snelle dataverwerking vereisen, zoals logaggregatie en realtime analytics.
Schaalbaarheid
ActiveMQ kan schalen via clustering en een netwerk van brokers, maar dit kan complex zijn en vergt vaak zorgvuldige configuratie en beheer.
Kafka is daarentegen gebouwd met schaalbaarheid in gedachten en maakt eenvoudige horizontale schaalvergroting mogelijk door meer brokers aan het cluster toe te voegen. Kafka’s partitionerings- en replicatiestrategieën faciliteren efficiënte databeheer over een groot aantal nodes, zodat hogere loads met minimale configuratie-inspanning kunnen worden verwerkt.
Fouttolerantie en duurzaamheid
ActiveMQ gebruikt persistente opslagopties en brokerclustering met failovermechanismen om berichtenduurzaamheid te bieden en te zorgen dat het systeem kan herstellen van storingen zonder dataverlies.
Kafka biedt op zijn beurt robuuste fouttolerantie via datareplicatie over meerdere brokers in het cluster, wat zorgt voor hoge duurzaamheid, zelfs bij brokerstoringen. Kafka’s vermogen om berichten vanuit de logopslag te herhalen voegt een extra laag betrouwbaarheid toe, waardoor consumers data opnieuw kunnen verwerken wanneer nodig.
Ecosysteem en integratie
ActiveMQ is goed geschikt voor enterpriseapplicaties, met name waar JMS-conformiteit vereist is. Het ondersteunt diverse messagingprotocollen, waaronder AMQP, STOMP en MQTT, waardoor het een veelzijdige keuze is voor het verbinden van uiteenlopende systemen en applicaties.
Kafka heeft daarentegen een snel groeiend ecosysteem met tools zoals Kafka Connect voor integratie met diverse databronnen en -sinks, en Kafka Streams voor realtime dataverwerking. De integratiemogelijkheden strekken zich uit tot bigdataplatformen, clouddiensten en andere moderne technologieën, waardoor het een krachtige optie is voor het bouwen van schaalbare, realtime datapijplijnen en event-driven architecturen.
ActiveMQ vs Kafka: een samenvatting
De onderstaande tabel vat de verschillen tussen ActiveMQ en Kafka samen aan de hand van de eerder besproken categorieën:
|
Feature |
ActiveMQ |
Apache Kafka |
|
Architectuur |
Brokercentrisch |
Gedistribueerde log |
|
Messagingmodel |
Point-to-point, publish-subscribe |
Publish-subscribe, gedistribueerde logs |
|
Prestaties |
Gemiddelde throughput, lage latency |
Hoge throughput, lage latency |
|
Schaalbaarheid |
Complexe clustering via een netwerk van brokers |
Horizontaal schalen (makkelijk uit te breiden) |
|
Fouttolerantie |
Clustering, persistente opslag |
Replicatie, duurzame logopslag |
|
Duurzaamheid |
Berichtpersistente |
Datareplicatie, replaybaarheid |
|
Ecosysteem |
JMS-ondersteuning, meerdere protocollen |
Kafka Connect, Streams, bigdata-integratie |
Laten we nu de ideale use cases voor elk van deze brokers verkennen.
Wanneer gebruik je ActiveMQ
ActiveMQ is een robuuste optie voor uiteenlopende messagingscenario’s, vooral bij legacy-systemen, enterprisemessaging of specifieke compliance-eisen.
Hier volgt een gedetailleerdere kijk op de geschiktheid voor verschillende use cases:
Integratie met legacy-systemen
ActiveMQ is bijzonder geschikt voor integratie met legacy-systemen die afhankelijk zijn van de Java Message Service (JMS) API. Het implementeert de JMS-specificatie, wat het een ideale keuze maakt voor applicaties die moeten communiceren met oudere systemen die rond JMS-standaarden zijn ontworpen.
Daarnaast ondersteunt ActiveMQ point-to-point messaging (queues) en publish-subscribe messaging (topics), wat essentieel kan zijn om compatibiliteit te waarborgen met bestaande infrastructuur die op deze messagingsparadigma’s vertrouwt.
Enterprisemessaging
ActiveMQ biedt aanzienlijke voordelen in enterpriseomgevingen waar geavanceerde beveiligingsfuncties, compliance en flexibele deploymentopties belangrijk zijn.
Het biedt robuuste beveiligingsmechanismen die essentieel zijn om vertrouwelijkheid en integriteit van berichten te behouden. De conformiteit met JMS-standaarden zorgt voor naadloze integratie met andere enterprise-systemen die dezelfde standaarden hanteren.
Bovendien ondersteunt ActiveMQ verschillende deploymentopties, zoals standalone brokers, geclusterde configuraties en gekoppelde brokers, zodat organisaties het model kunnen kiezen dat het beste bij hun infrastructuur en operationele behoeften past.
Lagere throughputvereisten
ActiveMQ is een sterke kandidaat voor applicaties die geen extreem hoge throughput vereisen, maar wel betrouwbare messaging met lage latency nodig hebben. Het ontwerp is geschikt voor scenario’s met middelgrote berichtvolumes, en de focus op leveringsgaranties zorgt ervoor dat berichten betrouwbaar worden afgeleverd, zelfs in complexe omgevingen.
De persistentie- en bevestigingsmechanismen van ActiveMQ bieden de betrouwbaarheid die nodig is voor applicaties waar berichtintegriteit cruciaal is, maar waar het berichtenvolume beheersbaar blijft binnen de throughputcapaciteiten.
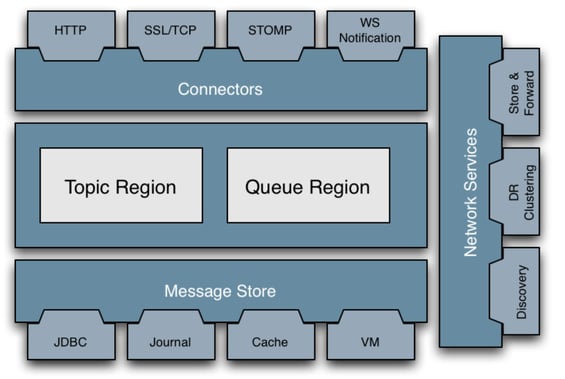
Hoofdcomponenten van ActiveMQ Classic. Beeldbron: ActiveMQ-documentatie.
Wanneer gebruik je Apache Kafka
Kafka is bijzonder geschikt voor scenario’s die hoge throughput, uitzonderlijke schaalbaarheid en geavanceerde dataverwerkingsmogelijkheden vereisen.
Hier volgt een gedetailleerde kijk op wanneer je Kafka inzet:
High-throughput streaming
Kafka is een topkeuze voor applicaties die realtime dataverwerking en hoge throughput vereisen. Het blinkt uit in logaggregatie- en event-sourcingscenario’s, waar enorme hoeveelheden data in realtime moeten worden verzameld, verwerkt en geanalyseerd.
De architectuur van Kafka is geoptimaliseerd om miljoenen berichten per seconde met lage latency te verwerken, wat het ideaal maakt voor streamingapplicaties die een continue datastroom en minimale vertraging vereisen.
Schaalbare microservices-architecturen
Kafka is zeer effectief ter ondersteuning van schaalbare microservices-architecturen. Het biedt een gedistribueerd, fouttolerant messagingsysteem dat past bij het dynamische en gedistribueerde karakter van microservices.
Dankzij de ontkoppeling van producers en consumers kunnen microservices efficiënt communiceren, zelfs naarmate het aantal services en de datavolumes groeien. De robuuste fouttolerantie zorgt ervoor dat berichten betrouwbaar worden afgeleverd en verwerkt, zelfs in complexe, gedistribueerde omgevingen.
Datapijplijn en analytics
Kafka springt eruit bij het bouwen van realtime datapijplijnen en analyticsplatformen dankzij robuuste dataduurzaamheid en replaybaarheid. De gedistribueerde logarchitectuur maakt betrouwbare dataopslag en -herwinning mogelijk, wat de bouw van geavanceerde pijplijnen ondersteunt die hoge datainname en -verwerking aankunnen.
De mogelijkheid om berichten uit de logs te bewaren en te herhalen is cruciaal voor analyticsplatforms die historische data verwerken en complexe analytische queries ondersteunen.
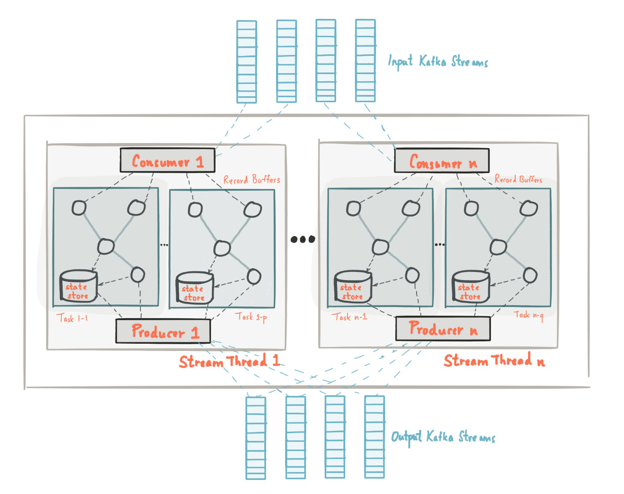
De anatomie van een applicatie die de Kafka Streams-bibliotheek gebruikt. Beeldbron: Kafka-documentatie.
Conclusie
De keuze tussen ActiveMQ en Kafka hangt af van je specifieke behoeften en use cases. ActiveMQ is goed geschikt voor traditionele messagingscenario’s, vooral in enterpriseomgevingen die JMS-conformiteit en lagere throughput vereisen. Kafka blinkt daarentegen uit in omgevingen met hoge throughput en schaalbaarheid, waardoor het ideaal is voor realtime dataverwerking en streaming.
Wil je verder lezen en meer ontdekken over data engineering? Bekijk dan de onderstaande resources:
FAQs
Wat zijn de belangrijkste verschillen tussen ActiveMQ en Kafka?
ActiveMQ staat bekend om zijn brokercentrische architectuur en ondersteuning voor JMS, terwijl Kafka een gedistribueerde logarchitectuur gebruikt die is ontworpen voor hoge throughput en realtime datastreaming.
Welk messagingplatform is beter voor applicaties met hoge throughput?
Kafka blinkt uit in scenario’s met hoge throughput dankzij de architectuur, die het mogelijk maakt om miljoenen berichten per seconde met lage latency te verwerken. Het is ideaal voor realtime dataverwerking en streamingapplicaties.
Hoe gaat ActiveMQ om met berichtenduurzaamheid en fouttolerantie?
ActiveMQ waarborgt berichtenduurzaamheid via persistente opslag en biedt fouttolerantie via brokerclustering en failovermechanismen. Deze opzet helpt om berichtintegriteit en systeembetrouwbaarheid te behouden.
Kan Kafka worden gebruikt om te integreren met legacy-systemen?
Kafka wordt over het algemeen gebruikt voor moderne, schaalbare architecturen en is mogelijk niet de beste keuze voor integratie met legacy-systemen. ActiveMQ, met JMS-conformiteit en ondersteuning voor diverse protocollen, is vaak geschikter voor integratie met legacy.
Wat zijn de belangrijkste factoren bij de keuze tussen ActiveMQ en Kafka?
Belangrijke factoren zijn het vereiste messagingmodel (point-to-point vs. publish-subscribe), throughputbehoeften, schaalbaarheidsvereisten en specifieke use cases, zoals realtime dataverwerking of enterprisemessaging.



Een message broker is serversoftware die communicatie mogelijk maakt tussen verschillende services, applicaties en componenten, vooral in gedistribueerde systemen. Het speelt een belangrijke rol bij het ondersteunen van asynchrone messaging, waardoor systemen losjes gekoppeld kunnen worden en onafhankelijk kunnen schalen.
Twee populaire keuzes op dit gebied zijn ActiveMQ en Apache Kafka.
In dit artikel vergelijken we ActiveMQ en Kafka grondig en lichten we hun features, architecturen, prestaties en use cases uit. Aan het einde heb je een beter beeld van welk platform het beste past bij jouw specifieke vereisten.
Wat is ActiveMQ?
ActiveMQ is oorspronkelijk ontwikkeld door LogicBlaze, een bedrijf dat zich richtte op open-source-integratie en messagingoplossingen. LogicBlaze droeg ActiveMQ in 2007 bij aan de Apache Software Foundation (ASF), waar het een Apache top-level project werd.
Sindsdien wordt ActiveMQ onderhouden en doorontwikkeld door de open-sourcecommunity onder toezicht van de Apache Software Foundation, met bijdragen van verschillende ontwikkelaars en organisaties wereldwijd.
Concreet is ActiveMQ een open-source message broker, geschreven in Java, die de Java Message Service (JMS) API implementeert, een standaard-API voor message-oriented middleware (MOM) zoals gedefinieerd door Oracle. De service staat bekend om zijn gebruiksgemak, uitgebreide documentatie en flexibiliteit in deployment, met ondersteuning voor clustering, failover en meerdere transportprotocollen.
Features van ActiveMQ
Dit zijn de belangrijkste features en eigenschappen van ActiveMQ:
Use cases voor ActiveMQ
Dit zijn de populairste use cases voor ActiveMQ: