
La missione di DataCamp è aiutare persone e aziende, in ogni fase del loro percorso, a diventare fluenti nei dati costruendo la piattaforma di formazione in data science più intelligente sul mercato.
Questo post vuole offrire più contesto su perché abbiamo fondato DataCamp a livello macro. Nella prima sezione parleremo del mercato della data science (talenti). La seconda parte copre i pilastri che sostengono la nostra visione per il futuro della formazione in data science. Infine, affrontiamo l’importanza della certificazione.
Il mercato
L’opportunità
Capire come analizzare i dati consente a persone e aziende di prendere decisioni migliori, creare servizi e prodotti migliori e nuovi, ecc. Crediamo che l’impatto che l’analisi dei dati e la data science avranno nei prossimi 20 anni sarà grande quanto l’impatto che l’ingegneria del software e l’informatica hanno avuto negli ultimi 20 anni. Il software sta divorando il mondo, ma la data science e l’AI si mangeranno l’ingegneria del software per cena!
Il gap di talenti
Per quanto sia entusiasmante, c’è un problema: Harvard Business Review e un rapporto McKinsey hanno acceso per prime i riflettori sulla carenza di data scientist. Oggi, le aziende in ogni singolo settore faticano infatti a trovare data scientist o persone con un livello adeguato di alfabetizzazione/fluenza sui dati. Le stime sulla carenza (attesa) di data scientist vanno da centinaia di migliaia a milioni nei più recenti studi sull’argomento.
Pur potendo discutere l’accuratezza di queste previsioni, una cosa è chiara: le istituzioni educative tradizionali non possono formare abbastanza persone nei prossimi decenni per colmare questo divario. Inoltre, una grande parte del mondo non ha accesso a una formazione di qualità in data science presso le istituzioni tradizionali perché spesso è (molto) costosa.
Di conseguenza, il potere della data science può essere sfruttato solo se troviamo modi per riqualificare la forza lavoro esistente a costi accessibili. Da un lato, ci si deve aspettare che un ampio gruppo di persone aggiorni le proprie competenze per avanzamento di carriera (e, in misura minore, per cambi di carriera); dall’altro, che le aziende riqualifichino porzioni significative della loro forza lavoro. Nota anche che il gruppo di persone che studia per avanzare nella carriera è più grande di quello di chi studia perché vuole cambiarla. Questa osservazione non è nuova. lynda.com e Pluralsight hanno dimostrato che puntare sulla formazione continua è una strategia vincente rispettivamente nei settori creativo e developer.
Infine, è importante riconoscere che il divario di competenze esiste su più livelli: va da chi lavora con i dati su base settimanale e si scontra con i limiti degli strumenti che usa (spesso Microsoft Excel), fino ad analisti e data scientist, manager e consulenti. Tutti questi gruppi hanno esigenze diverse, ma per tutti c’è carenza di persone con il giusto livello di alfabetizzazione/fluenza sui dati.
Per le ragioni sopra, crediamo che il mercato dell’educazione alla data literacy sia enorme e probabilmente più grande del mercato per l’insegnamento delle competenze base di coding. Due elementi sembrano confermare questa convinzione:
- Oltre il sessanta per cento dei nostri 1,7 milioni di studenti sono professionisti attivi in un’ampia gamma di aree (consulenza, finanza, sanità, ricerca, marketing, …) che ricoprono ruoli molto diversi. Puoi leggere alcune delle loro storie su DataCamp.
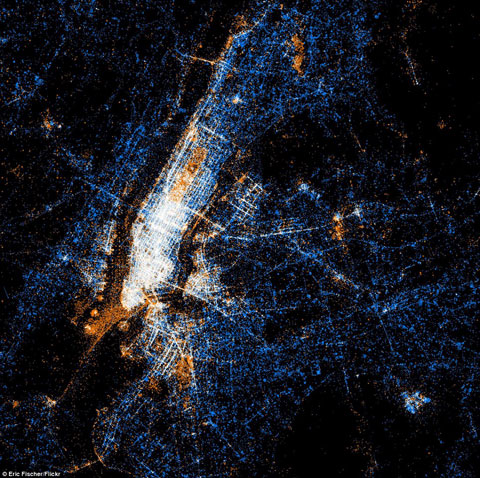
- Molte persone associano la data science al settore tecnologico e pensano quindi che San Francisco sia la Mecca della data science. Tuttavia, la data science non è affatto un’esclusiva di San Francisco. Se classifichi il traffico di apprendimento di DataCamp per città, San Francisco è solo al 24º posto, superata da 7 città in India e 4 negli Stati Uniti (New York City è la numero 1 negli USA). Il bisogno di data science è ovunque. ### Un passaggio all’open source Lo sviluppo software open source ha trasformato completamente la comunità dello sviluppo web e ora sta trasformando anche la comunità della statistica applicata e della data science. Mentre SAS e SPSS dominavano il mondo della statistica applicata non poi così tanto tempo fa, tecnologie open source come R e Python sembrano aver sostanzialmente preso il sopravvento. Tra l’altro, DataCamp ha anche reso open source alcuni corsi e tecnologie. È difficile mettere in dubbio la crescita dell’open source come livello fondante del futuro della data science. Questa è la ragione principale per cui al momento tutta la nostra formazione in data science è incentrata sull’open source. Inoltre, per sua stessa natura rende più facile costruire strumenti educativi interattivi sopra di esso. Concentrarci sull’open source ci permette anche di restituire valore alle comunità open source della data science. Forniamo flussi di ricavi scalabili ai contributor open source che creano corsi DataCamp tramite il nostro modello di royalty. Anche se l’open source rimarrà una parte importante del nostro curriculum negli anni a venire, alla fine vogliamo offrire ai nostri studenti formazione su ogni strumento e metodologia rilevante. Aspettati che in futuro inizieremo a sviluppare formazione anche per strumenti proprietari. ## Il futuro della formazione in data science Un focus verticale e la tecnologia permettono la migliore esperienza di apprendimento L’Università di Bologna, in Italia, è stata fondata nel 1088 ed è la più antica in Europa.
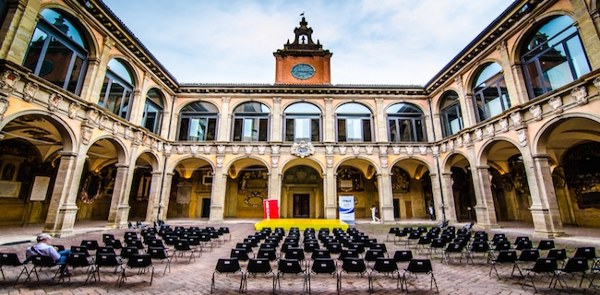
Storicamente, le istituzioni educative coprivano un’ampia gamma di argomenti (chiamiamolo focus orizzontale). Per esempio, la più antica università d’Europa insegna discipline che spaziano da storia, economia, psicologia, statistica, ecc. Il focus orizzontale aveva senso all’epoca per la combinazione di (i) economie di scala (su edifici, amministrazione studenti, attrazione dei professori più brillanti, valore del brand per la certificazione, ecc.) e (ii) portata geografica limitata dati gli alti costi di comunicazione e trasporto. Il focus orizzontale è stato il modello educativo dominante per secoli, ed è per questo che siamo ancora abituati a pensare alle istituzioni educative come orizzontalmente focalizzate.
I costi di trasporto e comunicazione e i costi fissi dei modelli educativi sono diminuiti in modo significativo negli ultimi decenni, grazie al progresso tecnologico. Quindi… come impatta questo il panorama educativo di oggi e di domani?
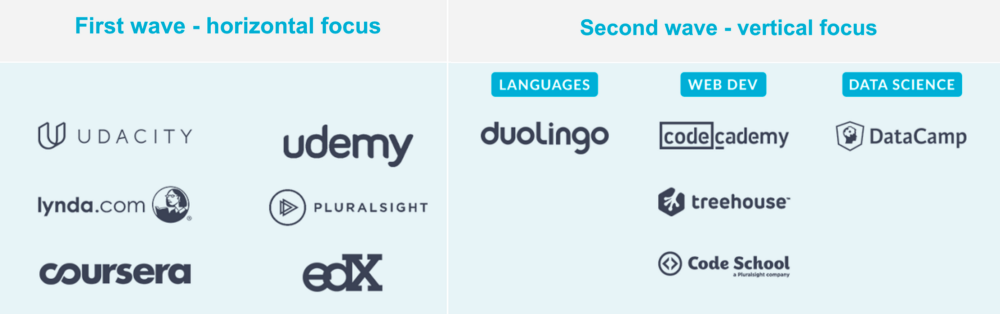
Se dai una vista d’insieme al mercato dell’educazione online degli ultimi tempi, la prima ondata di aziende ha perlopiù copiato l’approccio orizzontale del mondo fisico, mentre la seconda ondata è stata più tecnologica e verticale (cioè focalizzata su un’unica area di competenze). L’impatto positivo della prima ondata è stato — senza dubbio — enorme, perché è riuscita a rendere la formazione di qualità disponibile su larga scala. Detto ciò, non è andata molto oltre nello sfruttare la tecnologia per migliorare davvero l’esperienza di apprendimento ed è persino poco entusiasmante dal punto di vista tecnologico. Il loro focus orizzontale rende davvero difficile superare il consueto compromesso tra personalizzazione e scalabilità nell’educazione. Cosa intendo?
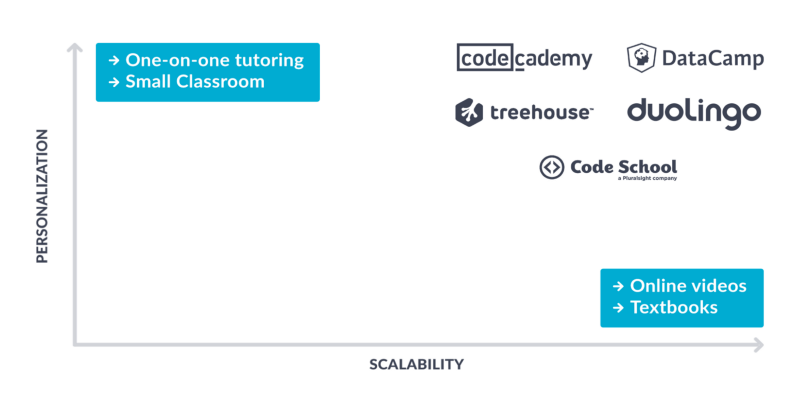
Le esperienze educative più personalizzate in passato erano molto difficili da scalare. Il tutoring uno-a-uno, le classi piccole, ecc. possono offrire un’ottima esperienza altamente personalizzata. Tuttavia, la mancanza di scalabilità rende queste opzioni tipicamente molto costose (e quindi disponibili solo a pochi fortunati). Dall’altro lato, esperienze molto scalabili come la formazione tramite video online e i manuali sono spesso accessibili, ma mancano di personalizzazione. L’assenza di personalizzazione spesso rende la formazione meno efficace e coinvolgente. I tassi di completamento relativamente bassi dei MOOC tradizionali sono un buon esempio di come un minor coinvolgimento impatti i risultati dell’apprendimento.
La tecnologia e un focus verticale ora ci permettono di superare il tipico compromesso tra scalabilità (e accessibilità) e personalizzazione costruendo esperienze di apprendimento personalizzate su larga scala. Permettono agli studenti di imparare facendo e di avvicinare l’esperienza di apprendimento il più possibile — nel nostro caso — al lavoro su progetti reali di data science. Molti dei nostri corsi hanno tassi di completamento superiori al 50%, il che indica che il coinvolgimento beneficia di questo approccio.
Una rete di istruttori esperti offre la migliore esperienza educativa
La prima ondata dell’educazione online soffre di scarsa personalizzazione, ma ha centrato un ingrediente chiave: ha fatto leva sull’esperienza e sulla conoscenza di alcune tra le persone più brillanti in ogni dominio.
La seconda ondata dell’educazione online sembra aver dimenticato il potere di coinvolgere partner esterni per costruire contenuti formativi. Al contrario, crediamo fortemente nell’importanza di creare una rete di istruttori esterni sia dall’industria sia dal mondo accademico. Per insegnare l’uso di strumenti open source, può essere l’autore del pacchetto; per argomenti più teorici, un professore molto rispettato; per quelli più applicati, un esperto del settore. I vantaggi di questo approccio sono:
- Lavorare con istruttori esterni ci permette di ampliare più velocemente la libreria di corsi, essenziale perché la data science è un campo in rapida evoluzione e i nostri studenti vogliono imparare le competenze più recenti subito.
- Avere una parte della libreria creata da esperti del settore garantisce che insegniamo competenze rilevanti per il mercato del lavoro.
- Avere una parte della libreria creata da accademici permette a DataCamp di costruire su ricerche (recenti), sulla loro reputazione e sulla loro esperienza didattica.
- Una parte dei nostri studenti è più motivata se il corso è tenuto da un vero esperto o da uno dei loro eroi dell’open source.
Valorizziamo profondamente le nostre collaborazioni nella creazione di corsi con aziende come Anaconda. Crediamo anche che riusciremo a costruire la migliore collezione di corsi di data science facendo leva su una rete di istruttori individuali oltre a queste partnership. Potresti chiederti: “perché non collaborare con le università per creare la libreria di corsi? o con gli editori di libri?” Ci sono molte ragioni per cui riteniamo che sarebbe subottimale. Anzitutto, trattare con i reparti legali di queste organizzazioni sarebbe più lento, e a noi il lento non piace. In secondo luogo, crediamo che il progresso tecnologico nelle piattaforme educative possa e debba potenziare il singolo creatore di contenuti. È successo nell’industria musicale, in parte nell’intrattenimento e ora sta avvenendo nell’educazione. Per chi è interessato: qui trovi l’elenco completo degli istruttori di DataCamp.
Certificazione del livello di competenza come meccanismo di matching
Per risolvere la carenza di persone con competenze sui dati, non basta formarle in modo accessibile e scalabile. Serve un meccanismo di matching efficiente per aiutare le persone a comunicare il proprio livello di competenza e per aiutare le organizzazioni a trovare persone con le skill di cui hanno bisogno (sia all’interno che all’esterno dell’azienda).
Per secoli, i titoli universitari sono stati il modo più comune per segnalare capacità e competenze ai potenziali datori di lavoro. Ci sono due ragioni fondamentali per cui è difficile credere che i titoli tradizionali saranno il principale meccanismo di segnalazione per la fluenza sui dati:
- Il numero di persone che acquisiranno competenze sui dati tramite l’istruzione tradizionale sarà una porzione relativamente piccola del totale di chi acquisirà queste competenze nel prossimo decennio. I nostri dati confermano questa ipotesi; di gran lunga il gruppo più numeroso di studenti ha tra i 25 e i 35 anni.
- La data science è agli inizi come disciplina e le competenze rilevanti cambiano ancora ogni anno. Serve quindi un meccanismo di segnalazione che evolva con il campo e che possa essere aggiornato in modo efficiente. Questo richiede anche apprendimento continuo, qualcosa che la maggior parte delle istituzioni tradizionali non è in grado di fornire. Le cose da imparare sono così tante che la data science è impossibile da padroneggiare all’università, anche dopo una laurea, un master o persino un dottorato. I master non ti faranno “masterizzare” la data science ;-).
Emergono due meccanismi alternativi di segnalazione:
- Certificati di completamento dei corsi offerti dalla maggior parte delle piattaforme di educazione online. Hanno certamente valore come segnale di motivazione. Tuttavia, sono piuttosto inefficaci per comunicare il livello di competenza perché: (i) spesso non sono progettati per misurarlo in modo rigoroso e (ii) pochissimi corsi hanno il volume necessario anche solo per sperare in un riconoscimento sul mercato.
- Meccanismi di certificazione che misurano il livello di competenza sono emersi in campi come il cloud computing come modo efficiente ed efficace per comunicare il livello di skill. La certificazione è ormai un modo comune per i professionisti IT di distinguersi, ma non si ferma qui. Duolingo ha lanciato di recente la sua versione del test TOEFL per la valutazione delle competenze linguistiche, e il GMAT è ampiamente accettato dalle business school da molto tempo. Nella data science, però, nessuno ha ancora creato un modo per valutare e certificare il livello di competenza di una persona. Vorremmo creare quel sistema di valutazione perché crediamo rappresenti un’enorme opportunità per permettere alle persone di comunicare meglio il proprio livello di skill e alle aziende di comprendere il livello di competenza sia della forza lavoro esistente sia dei candidati.
Conclusione
L’ubiquità dei dati crea enormi opportunità per persone e aziende di prendere decisioni migliori e guadagnare vantaggio. Tuttavia, l’ampliarsi del gap di talenti limita l’impatto positivo che l’analisi dei dati può avere sul mondo. Da un lato, le aziende non riescono a trovare i talenti di cui hanno bisogno; dall’altro, c’è un vasto gruppo di persone con accesso limitato a risorse educative di qualità (per prezzo e disponibilità).
Crediamo nell’educazione online come soluzione a questo problema. Più nello specifico, crediamo nel valore della personalizzazione per creare un’esperienza di apprendimento coinvolgente ed efficace. Inoltre, crediamo nella forza di una rete di istruttori esperti per creare quella formazione. Infine, crediamo che al mercato manchi un meccanismo di matching efficace.
In un post successivo, approfondiremo il piano di DataCamp.



